Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
Neste artigo, aprenda as etapas para definir um esquema para um índice de pesquisa e enviá-lo por push para um serviço de pesquisa. A criação de um índice estabelece as estruturas de dados físicos no seu serviço de pesquisa. Quando o índice existir, carregue-o como uma tarefa separada.
Pré-requisitos
Uma assinatura do Azure. Crie um gratuitamente.
Um serviço Pesquisa de IA do Azure, de qualquer região e nível, mas deve ser um nível faturável (Básico ou superior) para acesso baseado em funções.
Permissões para criar um índice: Função de Contribuidor de Serviço de Pesquisa ou uma chave API de administrador para autenticação baseada em chaves.
Um campo único nos seus dados de origem que pode ser usado como chave do documento no índice.
Uma compreensão do seu esquema de dados. Consulte a lista de verificação do esquema para orientações de concepção sobre como tornar campos pesquisáveis, recuperáveis, filtráveis, facetáveis e ordenáveis.
Criar um índice
Quando estiver pronto para criar o índice, use um cliente de pesquisa que possa enviar a solicitação. Você pode usar o portal do Azure ou APIs REST para desenvolvimento inicial e testes de prova de conceito, caso contrário, é comum usar os SDKs do Azure.
Durante o desenvolvimento, planeje reconstruções frequentes. Como as estruturas físicas são criadas no serviço, descartar e recriar índices é necessário para muitas modificações. Você pode considerar trabalhar com um subconjunto de seus dados para tornar as reconstruções mais rápidas.
O design de índices através do portal Azure impõe requisitos e regras de esquema para tipos de dados específicos, como a proibição de pesquisas em texto completo em campos numéricos.
Vá para o seu serviço de pesquisa no portal do Azure.
Verifique se há espaço. Os serviços de pesquisa estão sujeitos a um número máximo de índices, que varia consoante o escalão de preço. Certifique-se de que tem espaço para um segundo índice.
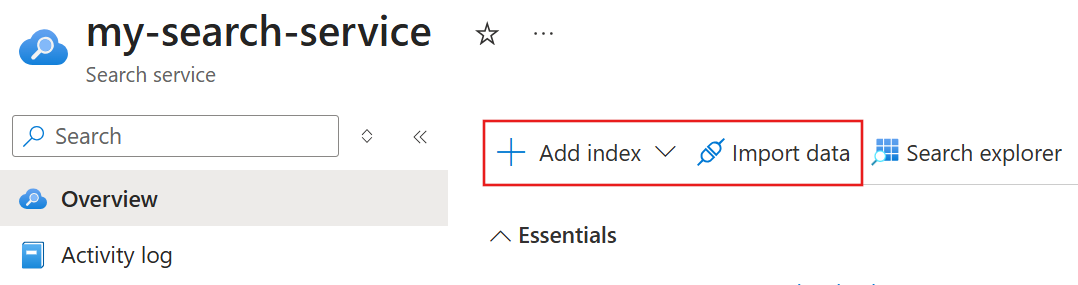
Na página de Visão Geral do serviço de pesquisa, escolha uma das seguintes opções:
- Adicionar índice: Um editor embutido para especificar um esquema de índice.
- Importar dados: Um assistente que cria uma fonte de dados, um indexador e um índice finalizado. O assistente também carrega os dados. Se não precisares do fluxo de trabalho de ponta a ponta, usa antes Adicionar Índice.
Gorjeta
Depois de criar um índice no portal Azure, pode copiar a representação JSON e adicioná-la ao código da sua aplicação.
Verificar criação de índice
Depois de criar um índice, verifique se existe listando os índices no seu serviço de pesquisa.
No portal Azure, aceda ao seu serviço de pesquisa.
No painel esquerdo, selecione Gerenciamento de pesquisa>Índices.
Confirme que o seu novo índice aparece na lista. Se não conseguir vê-lo, atualize a página.
Chaves do documento
A criação do índice de pesquisa tem dois requisitos: um índice deve ter um nome exclusivo no serviço de pesquisa e deve ter uma chave de documento. O atributo booleano key em um campo pode ser definido como true para indicar qual campo fornece a chave do documento.
Uma chave de documento é o identificador exclusivo de um documento de pesquisa e um documento de pesquisa é uma coleção de campos que descreve completamente algo. Por exemplo, se você estiver indexando um conjunto de dados de filmes, um documento de pesquisa conterá o título, o gênero e a duração de um único filme. Os nomes de filmes são exclusivos neste conjunto de dados, portanto, você pode usar o nome do filme como a chave do documento.
No Pesquisa de IA do Azure, uma chave de documento é uma cadeia de caracteres e deve ser originada de valores exclusivos na fonte de dados que está fornecendo o conteúdo a ser indexado. Como regra geral, um serviço de pesquisa não gera valores de chave, mas em alguns cenários (como o indexador de tabela do Azure) sintetiza valores existentes para criar uma chave exclusiva para os documentos que estão sendo indexados. Outro cenário é a indexação um-para-muitos para dados fragmentados ou particionados, caso em que as chaves de identificação do documento são geradas para cada fragmento.
Durante a indexação incremental, onde o conteúdo novo e atualizado é indexado, os documentos de entrada com novas chaves são adicionados, enquanto os documentos de entrada com chaves existentes são mesclados ou substituídos, dependendo se os campos de índice são nulos ou preenchidos.
Pontos importantes sobre chaves de documento incluem:
- O comprimento máximo dos valores em um campo de chave é de 1.024 caracteres.
- Exatamente um campo de nível superior em cada índice deve ser escolhido como o campo chave e deve ser do tipo
Edm.String. - O padrão do
keyatributo é false para campos simples e null para campos complexos.
Os campos-chave podem ser usados para pesquisar documentos diretamente e atualizar ou excluir documentos específicos. Os valores dos campos-chave são tratados com distinção entre maiúsculas e minúsculas ao pesquisar ou indexar documentos. Consulte GET Document (REST) e Index Documents (REST) para obter detalhes.
Lista de verificação do esquema
Utilize esta lista de verificação para ajudar nas decisões de design para o índice de pesquisa.
Veja as convenções de nomenclatura para que os nomes de índices e campos estejam em conformidade com as regras de nomenclatura.
Veja Tipos de dados suportados. O tipo de dados afeta a forma como o campo é utilizado. Por exemplo, o conteúdo numérico é filtrável, mas não pode ser pesquisado em texto completo. O tipo de dados mais comum é
Edm.Stringpara texto pesquisável, que é tokenizado e consultado com o motor de busca de texto completo. O tipo de dados mais comum para um campo vetorial é,Edm.Singlemas você também pode usar outros tipos.Forneça uma descrição do índice, máximo de 4.000 caracteres. Este texto legível por humanos é inestimável quando um sistema tem de aceder a vários índices e tomar uma decisão com base na descrição. Considere um servidor MCP (Model Context Protocol) que deve escolher o índice correto em tempo de execução. A decisão pode basear-se na descrição e não apenas no nome do índice.
Identifique uma chave de documento. Uma chave de documento é um requisito de índice. É um único campo de cadeia de caracteres preenchido a partir de um campo de dados de origem que contém valores exclusivos. Por exemplo, se estiver a indexar a partir do Armazenamento de Blobs, o caminho de armazenamento de metadados é utilizado geralmente como a chave do documento, porque identifica exclusivamente cada blob no contentor.
Identifique os campos na origem de dados que contribuem com conteúdo pesquisável no índice.
O conteúdo não vetorial pesquisável inclui cadeias de caracteres curtas ou longas que são consultadas usando o mecanismo de pesquisa de texto completo. Se o conteúdo for verboso (frases pequenas ou partes maiores), experimente diferentes analisadores para ver como o texto é atomizado.
O conteúdo vetorial pesquisável pode ser imagens ou texto (em qualquer idioma) que existe como uma representação matemática. Você pode usar tipos de dados estreitos ou compactação de vetor para tornar os campos vetoriais menores.
Os atributos definidos em campos, como
retrievableoufilterable, determinam os comportamentos de pesquisa e a representação física do índice no serviço de pesquisa. Determinar como os campos devem ser atribuídos é um processo iterativo para muitos desenvolvedores. Para acelerar as iterações, comece com dados de exemplo para que possa excluir e reconstruir facilmente.Identifique os campos de origem que podem ser utilizados como filtros. Conteúdo numérico e campos de texto curtos, particularmente aqueles com valores repetidos, são boas escolhas. Ao trabalhar com filtros, lembre-se do seguinte:
Os filtros podem ser usados em consultas vetoriais e não vetoriais, mas o filtro em si é aplicado a campos legíveis por humanos (não vetoriais) em seu índice.
Opcionalmente, os campos filtráveis podem ser utilizados na navegação por facetas.
Os campos filtráveis são retornados em ordem arbitrária e não passam por pontuação de relevância, portanto, considere torná-los classificáveis também.
Para campos vetoriais, especifique uma configuração de pesquisa vetorial e os algoritmos usados para criar caminhos de navegação e preencher o espaço de incorporação. Para obter mais informações, consulte Adicionar campos vetoriais.
Os campos vetoriais têm propriedades extras que os campos não vetoriais não têm, como quais algoritmos usar e compactação vetorial.
Os campos vetoriais omitem atributos que não são úteis em dados vetoriais, como classificação, filtragem e facetagem.
Para campos não vetoriais, determine se deseja usar o analisador padrão (
"analyzer": null) ou um analisador diferente. Os analisadores são utilizados para atomizar os campos de texto durante a indexação e a execução da consulta.Para cadeias multilíngues, considere um analisador de linguagem.
Para cadeias hifenizadas ou de carateres especiais, considere analisadores especializados. Um exemplo é a palavra-chave que trata todo o conteúdo de um campo como um único token. Esse comportamento é útil para dados como códigos postais, IDs e alguns nomes de produtos. Para obter mais informações, veja Pesquisa parcial de termos e padrões com carateres especiais.
Nota
A pesquisa em texto completo é realizada sobre termos que são tokenizados durante a indexação. Se suas consultas não retornarem os resultados esperados, teste a tokenização para verificar se a cadeia de caracteres que você está procurando realmente existe. Pode tentar diferentes analisadores em cadeias para ver como os tokens são produzidos para vários analisadores.
Configurar definições de campo
A coleção de campos define a estrutura de um documento de pesquisa. Todos os campos têm um nome, tipo de dados e atributos.
Definir um campo como pesquisável, filtrável, classificável ou facetable tem um efeito no tamanho do índice e no desempenho da consulta. Não defina esses atributos em campos que não devem ser referenciados em expressões de consulta.
Se um campo não estiver definido para ser pesquisável, filtrável, classificável ou facetável, o campo não poderá ser referenciado em nenhuma expressão de consulta. Isso é desejável para campos que não são usados em consultas, mas são necessários nos resultados da pesquisa.
As APIs REST têm atribuição padrão baseada nos tipos de dados, que também é usada pelo assistente de Importação de dados no portal Azure. Os SDKs do Azure não têm padrões, mas têm subclasses de campo que incorporam propriedades e comportamentos, como SearchableField para cadeias de caracteres e SimpleField para primitivos.
As atribuições de campo padrão para as APIs REST são resumidas na tabela a seguir.
| Tipo de dados | Pesquisável | Recuperável | Filtrável | Facetável | Ordenável | Armazenado |
|---|---|---|---|---|---|---|
Edm.String |
✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Collection(Edm.String) |
✅ | ✅ | ✅ | ✅ | ❌ | ✅ |
Edm.Boolean |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
Edm.Int32, Edm.Int64, Edm.Double |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
Edm.DateTimeOffset |
❌ | ✅ | ✅ | ✅ | ✅ | ✅ |
Edm.GeographyPoint |
✅ | ✅ | ✅ | ❌ | ✅ | ✅ |
Edm.ComplexType |
✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Collection(Edm.Single) e todos os outros tipos de campo vetorial |
✅ | ✅ ou ❌ | ❌ | ❌ | ❌ | ✅ |
Os campos de cadeia de caracteres também podem ser opcionalmente associados a analisadores e mapas de sinônimos. Os campos do tipo Edm.String filtráveis, classificáveis ou faceiros podem ter, no máximo, 32 kilobytes de comprimento. Isso ocorre porque os valores desses campos são tratados como um único termo de pesquisa e o comprimento máximo de um termo na Pesquisa do Azure AI é de 32 kilobytes. Se você precisar armazenar mais texto do que isso em um único campo de cadeia de caracteres, defina explicitamente filtrável, classificável e facetable como false na sua definição de índice.
Os campos vetoriais devem ser associados a dimensões e perfis vetoriais. A opção Retrievable está ativada por defeito se o campo vetorial for adicionado usando o assistente Importar dados no portal Azure. Se você usar a API REST, ela é falsa.
Os atributos de campo são descritos na tabela a seguir.
| Atributo | Descrição |
|---|---|
| nome | Necessário. Define-se o nome do campo, que deve ser exclusivo dentro da coleção de campos do índice ou campo pai. |
| tipo | Necessário. Define o tipo de dados para o campo. Os campos podem ser simples ou complexos. Os campos simples são de tipos primitivos, como Edm.String para texto ou Edm.Int32 para inteiros.
Os campos complexos podem ter subcampos que são, eles próprios, simples ou complexos. Isso permite que você modele objetos e matrizes de objetos, o que, por sua vez, permite que você carregue a maioria das estruturas de objeto JSON para seu índice. Consulte Tipos de dados suportados para obter a lista completa dos tipos suportados. |
| chave | Necessário. Defina esse atributo como true para designar que os valores de um campo identificam exclusivamente documentos no índice. Consulte Chaves de documento neste artigo para obter detalhes. |
| recuperável | Indica se o campo pode ser retornado em um resultado de pesquisa. Defina esse atributo como false se quiser usar um campo como filtro, classificação ou mecanismo de pontuação, mas não quiser que o campo fique visível para o usuário final. Esse atributo deve ser true para campos-chave e deve ser null para campos complexos. Este atributo pode ser alterado em campos existentes. A configuração recuperável como true não causa nenhum aumento nos requisitos de armazenamento de índice. O padrão é true para campos simples e null para campos complexos. |
| pesquisável | Indica se o campo pode ser pesquisado em texto completo e pode ser referenciado em consultas de pesquisa. Isso significa que ele passa por análise lexical, tal como segmentação de palavras durante a indexação. Se você definir um campo pesquisável para um valor como "Sunny day", internamente ele será normalizado nos tokens individuais "sunny" e "day". Isso permite pesquisas de texto completo para esses termos. Campos do tipo Edm.String ou Collection(Edm.String) são pesquisáveis por padrão. Esse atributo deve ser false para campos simples de outros tipos de dados sem cadeia de caracteres e deve ser null para campos complexos.
Um campo pesquisável consome espaço extra no seu índice, uma vez que o Pesquisa de IA do Azure processa o conteúdo desses campos e organiza-os em estruturas de dados auxiliares para pesquisa de desempenho. Se quiser economizar espaço no índice e não precisar de um campo para ser incluído nas pesquisas, defina pesquisável como false. Consulte Como funciona a pesquisa de texto completo na Pesquisa de IA do Azure para obter detalhes. |
| filtrável | Indica se o campo deve estar habilitado para ser referenciado em consultas $filter. Filtrável difere de pesquisável na forma como os strings são manipulados. Campos do tipo Edm.String ou Collection(Edm.String) que são filtráveis não passam por análise lexical, portanto, as comparações são apenas para correspondências exatas. Por exemplo, se você definir esse campo f como "Dia ensolarado", $filter=f eq 'sunny' não encontrará correspondências, mas $filter=f eq 'Sunny day' irá. Este atributo deve ser null para campos complexos. O padrão é true para campos simples e null para campos complexos. Para reduzir o tamanho do índice, defina esse atributo como false em campos nos quais você não estará filtrando. |
| ordenável | Indica se deve habilitar o campo para ser referenciado em expressões $orderby. Por padrão, o Pesquisa de IA do Azure classifica os resultados por pontuação, mas, em muitas experiências, os usuários querem classificar por campos nos documentos. Um campo simples só pode ser classificado se tiver um único valor (tem um único valor no âmbito do documento principal).
Campos de coleção simples não podem ser classificados, pois são de vários valores. Subcampos simples de coleções complexas também são multivalorados e, portanto, não podem ser classificados. Isso é verdade, quer seja um campo pai imediato ou um campo ancestral, que constitui a coleção complexa. Campos complexos não podem ser classificáveis e o atributo classificável deve ser null para esses campos. O padrão para classificável é true para campos simples de valor único, false para campos simples de vários valores e null para campos complexos. |
| classificável por facetas | Indica se o campo deve ser referenciado em consultas de facetas. Normalmente usado em uma apresentação de resultados de pesquisa que inclui contagem de visitas por categoria (por exemplo, pesquisar câmeras digitais e ver acessos por marca, por megapixels, por preço e assim por diante). Este atributo deve ser null para campos complexos. Campos do tipo Edm.GeographyPoint ou Collection(Edm.GeographyPoint) não podem ser usados para facetas. O padrão é true para todos os outros campos simples. Para reduzir o tamanho do índice, defina esse atributo como false em campos nos quais não aplicará facetas. |
| analisador | Define o analisador lexical para tokenizar cadeias de caracteres durante operações de indexação e consulta. Os valores válidos para essa propriedade incluem analisadores de linguagem, analisadores internos e analisadores personalizados. A predefinição é standard.lucene. Esse atributo só pode ser usado com campos de cadeia de caracteres pesquisáveis e não pode ser definido junto com searchAnalyzer ou indexAnalyzer. Uma vez que o analisador é escolhido e o campo é criado no índice, ele não pode ser alterado para o campo. Deve ser null para campos complexos. |
| analisador de pesquisa | Defina essa propriedade junto com o indexAnalyzer para especificar diferentes analisadores lexicais para indexação e consultas. Se você usar essa propriedade, defina o analyzer como null e verifique se indexAnalyzer está definido como um valor permitido. Os valores válidos para esta propriedade incluem analisadores internos e analisadores personalizados. Este atributo só pode ser usado com campos pesquisáveis. O analisador de pesquisa pode ser atualizado em um campo existente, uma vez que é usado apenas no momento da consulta. Deve ser null para campos complexos. |
| analizadorDeÍndices | Defina essa propriedade junto com searchAnalyzer para especificar diferentes analisadores lexicais para indexação e consultas. Se você usar essa propriedade, defina analyzer como null e certifique-se de que searchAnalyzer esteja definido como um valor permitido. Os valores válidos para esta propriedade incluem analisadores internos e analisadores personalizados. Este atributo só pode ser usado com campos pesquisáveis. Uma vez que o analisador de índice é escolhido, ele não pode ser alterado para o campo. Deve ser null para campos complexos. |
| mapas de sinônimos | Uma lista dos nomes dos mapas de sinónimos a associar a este campo. Este atributo só pode ser usado com campos pesquisáveis. Atualmente, apenas um mapa de sinônimo por campo é suportado. A atribuição de um mapa de sinônimo a um campo garante que os termos de consulta direcionados a esse campo sejam expandidos no momento da consulta usando as regras no mapa de sinônimos. Este atributo pode ser alterado em campos existentes. Deve ser null ou uma coleção vazia para campos complexos. |
| campos | Uma lista de subcampos, se este for um campo do tipo Edm.ComplexType ou Collection(Edm.ComplexType). Deve estar null ou vazio para campos simples. Consulte Como modelar tipos de dados complexos na Pesquisa de IA do Azure para obter mais informações sobre como e quando usar subcampos. |
Atualizações permitidas em índices existentes
Criar índice cria as estruturas de dados físicos (arquivos e índices invertidos) em seu serviço de pesquisa. Depois que o índice é criado, sua capacidade de efetuar alterações usando Criar ou Atualizar Índice depende se suas modificações invalidam essas estruturas físicas. A maioria dos atributos de campo não pode ser alterada depois que o campo é criado no índice.
Para minimizar a rotatividade no código do aplicativo, você pode criar um alias de índice que sirva como uma referência estável para o índice de pesquisa. Em vez de atualizar seu código com nomes de índice, você pode atualizar um alias de índice para apontar para versões de índice mais recentes.
Para minimizar a rotatividade no processo de design, a tabela a seguir descreve quais elementos são fixos e flexíveis no esquema. A alteração de um elemento fixo requer uma reconstrução do índice, enquanto os elementos flexíveis podem ser alterados a qualquer momento sem afetar a implementação física. Para obter mais informações, consulte Atualizar ou reconstruir um índice.
| Elemento | Pode ser atualizado? |
|---|---|
| Nome | Não |
| Chave | Não |
| Nomes e tipos de campos | Não |
| Atributos de campo (pesquisável, filtrável, facetável, classificável) | Não |
| Atributo de campo (recuperável) | Sim |
| Armazenado (aplica-se a vetores) | Não |
| Analisador | Você pode adicionar e modificar analisadores personalizados no índice. Em relação às atribuições do analisador em campos de cadeia de caracteres, pode apenas modificar searchAnalyzer. Todas as outras tarefas e modificações requerem uma nova compilação. |
| Perfis de pontuação | Sim, você pode criar e editar perfis de pontuação sem reconstruir. |
| Sugestões | Não |
| compartilhamento de recursos entre origens (CORS) | Sim |
| Encriptação | Sim, você pode atualizar todas as partes de uma definição de criptografia existente . |
| Mapas de sinónimos | Sim, você pode criar e editar mapas de sinônimos sem reconstruir. |
| Configuração semântica | Sim, você pode criar e editar configurações semânticas sem reconstruir. |
Definir corsOptions para consultas de origem cruzada
Os esquemas de índice incluem uma seção para a configuração corsOptions. Por padrão, o JavaScript do lado do cliente não pode chamar nenhuma API porque os navegadores impedem todas as solicitações de origem cruzada. Para permitir consultas entre origens até o índice, habilite o CORS (Cross-Origin Resource Sharing) definindo o atributo corsOptions . Por motivos de segurança, apenas as APIs de consulta suportam CORS.
"corsOptions": {
  "allowedOrigins": [
    "*"
  ],
  "maxAgeInSeconds": 300
As seguintes propriedades podem ser definidas para CORS:
allowedOrigins (obrigatório): Esta é uma lista de origens que têm acesso permitido ao seu índice. O código JavaScript servido a partir dessas origens tem permissão para consultar seu índice (supondo que o chamador forneça uma chave válida ou tenha permissões). Cada origem é tipicamente da forma
protocol://<fully-qualified-domain-name>:<port>, embora<port>muitas vezes seja omitida. Para obter mais informações, consulte Compartilhamento de recursos entre origens (Wikipedia).Se tu quiseres permitir o acesso a todas as origens, inclui
*como um único item no vetor allowedOrigins. Essa não é uma prática recomendada para serviços de pesquisa de produção, mas geralmente é útil para desenvolvimento e depuração.maxAgeInSeconds (opcional): Os navegadores usam este valor para determinar a duração (em segundos) para armazenar em cache as respostas preliminares do CORS. Este deve ser um número inteiro não negativo. Um período de cache mais longo oferece melhor desempenho, mas estende o tempo que uma política CORS precisa para entrar em vigor. Se esse valor não estiver definido, será usada uma duração padrão de cinco minutos.
Próximos passos
Use os links a seguir para saber mais sobre os recursos especializados que podem ser adicionados a um índice:
- Adicionar campos vetoriais e perfis vetoriais
- Adicionar perfis de pontuação
- Adicionar classificação semântica
- Adicionar sugestões
- Adicionar mapas de sinónimos
- Adicionar analisadores
- Adicionar encriptação
Use estes links para carregar ou atualizar um índice: