Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Nota
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Em Pesquisa de IA do Azure , você pode executar um indexador de várias maneiras:
- Execute imediatamente após a criação do indexador. Essa opção é o padrão, a menos que você crie o indexador em um estado desabilitado.
- Execute em um horário programado para invocar a execução em intervalos regulares. Se um indexador agendado parar de disparar, consulte perguntas frequentes sobre o comportamento de agendamento para as etapas de recuperação.
- Execute sob demanda, com ou sem uma redefinição.
Este artigo explica como executar indexadores sob demanda, com e sem uma redefinição. Ele também descreve a execução, a duração e a simultaneidade do indexador.
Como os indexadores se conectam aos recursos de Azure
Os indexadores são um dos poucos subsistemas que fazem chamadas de saída evidentes para outros recursos do Azure. Dependendo da fonte de dados externa, você pode usar chaves ou funções para autenticar a conexão.
Em termos de funções Azure, os indexadores não têm identidades separadas: uma conexão do mecanismo de pesquisa com outro recurso Azure usa o sistema ou a identidade gerenciada atribuída pelo usuário de um serviço de pesquisa, além de uma atribuição de função no recurso de Azure de destino. Se o indexador se conectar a um recurso de Azure em uma rede virtual, você deverá criar um link privado compartilhado para essa conexão.
Nota
Os indexadores operam com permissões de nível de serviço em vez de permissões de usuário. Um indexador pode gravar em qualquer índice no serviço de pesquisa, mesmo se você atribuiu funções para restringir o acesso a índices específicos. Para obter mais informações, consulte o escopo por índice e as operações do indexador.
Execução do indexador
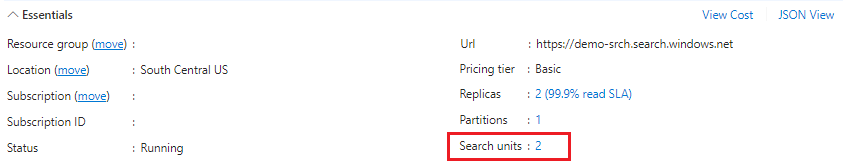
Um serviço de pesquisa executa um trabalho de indexador por unidade de pesquisa. Cada serviço de pesquisa começa com uma unidade de pesquisa, mas cada nova partição ou réplica aumenta as unidades de pesquisa do serviço. Você pode verificar a contagem de unidades de pesquisa na seção Essential do portal Azure da página Overview. Se você precisar de processamento simultâneo, verifique se suas unidades de pesquisa incluem réplicas suficientes. Os indexadores não são executados em segundo plano, portanto, você poderá experimentar mais limitação de consulta do que o normal se o serviço estiver sob pressão.
A captura de tela a seguir mostra o número de unidades de pesquisa, que determina quantos indexadores podem ser executados ao mesmo tempo.
Depois que a execução do indexador for iniciada, você não poderá pausar ou pará-la. A execução do indexador é interrompida quando não há mais documentos para carregar ou atualizar ou quando o limite máximo de tempo de execução é atingido.
Você pode executar vários indexadores ao mesmo tempo assumindo capacidade suficiente, mas cada indexador em si é de instância única. Iniciar uma nova instância enquanto o indexador já está em execução produz este erro: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Ambiente de execução do indexador
Um trabalho de indexador é executado em um ambiente de execução gerenciada. Atualmente, há dois ambientes:
Um ambiente de execução privada é executado em clusters de pesquisa específicos para seu serviço de pesquisa.
Um ambiente multilocatário tem processadores de conteúdo que Microsoft gerencia e protege sem custo adicional. Esse ambiente descarrega o processamento computacionalmente intensivo, de modo que os recursos específicos do serviço permaneçam disponíveis para operações de rotina. Sempre que possível, a maioria dos conjuntos de habilidades é executada no ambiente multilocatário. Esse ambiente é o padrão.
O processamento computacionalmente intensivo refere-se a conjuntos de habilidades em execução em processadores de conteúdo e trabalhos de indexador que processam um alto volume de documentos ou documentos de grande tamanho. A heurística e as informações do sistema determinam o processamento não referente ao conjunto de habilidades nos processadores de conteúdo multilocatário, não sob controle do cliente.
Você poderá impedir o uso do ambiente multilocatário em serviços Standard2 ou superior fixando um indexador e um processamento de conjunto de habilidades exclusivamente em seus clusters de pesquisa.
Defina o executionEnvironment parâmetro na definição do indexador para sempre executar um indexador no ambiente de execução privada.
Os firewalls de IP bloqueiam o ambiente multilocatário, portanto, se você tiver um firewall, crie uma regra que permita conexões de processador multilocatário.
Os limites do indexador variam para cada ambiente:
| Carga | Duração máxima | Tarefas máximas | Ambiente de execução |
|---|---|---|---|
| Execução privada | 24 horas | Um trabalho de indexador por unidade de pesquisa1. | A indexação não é executada em segundo plano. Em vez disso, o serviço de pesquisa equilibra todos os trabalhos de indexação em relação a consultas contínuas e ações de gerenciamento de objetos (como criar ou atualizar índices). Ao executar indexadores, você deve esperar ver alguma latência de consulta se os volumes de indexação forem grandes. |
| Multilocatário | 2 horas 2 | Indeterminado 3 | Como o cluster de processamento de conteúdo é multilocatário, o sistema adiciona processadores de conteúdo para atender à demanda. Se você enfrentar um atraso na execução sob demanda ou agendada, provavelmente é porque o sistema está adicionando processadores ou aguardando que um fique disponível. |
1 As unidades de pesquisa podem ser combinações flexíveis de partições e réplicas, mas os trabalhos do indexador não estão vinculados a uma ou outra. Em outras palavras, se você tiver 12 unidades, poderá ter 12 trabalhos de indexador em execução simultânea na execução privada, independentemente de como as unidades de pesquisa são implantadas.
2 Se forem necessárias mais de duas horas para processar todos os dados, habilite a detecção de alterações e agende o indexador a ser executado em intervalos de 5 minutos para retomar a indexação rapidamente se ele parar devido a um tempo limite. Consulte Indexação de um conjunto de dados grande para obter mais estratégias.
3 "Indeterminado" significa que o limite não é quantificado pelo número de trabalhos. Algumas cargas de trabalho, como o processamento de conjunto de habilidades, podem ser executadas em paralelo, o que pode resultar em muitos trabalhos, embora apenas um indexador esteja envolvido. Embora o ambiente não imponha restrições, os limites do indexador para seu serviço de pesquisa ainda se aplicam.
Executar sem redefinição
Uma operação Executar Indexador detecta e processa apenas o que precisa para sincronizar o índice de pesquisa com alterações na fonte de dados subjacente. A indexação incremental começa localizando uma marca d'água alta interna para identificar o último documento de pesquisa atualizado. Este documento se torna o ponto de partida para a execução do indexador em documentos novos e atualizados na fonte de dados.
A detecção de alterações é essencial para determinar o que há de novo ou atualizado na fonte de dados. Os indexadores usam os recursos de detecção de alterações da fonte de dados subjacente para determinar o que há de novo ou atualizado na fonte de dados.
O Armazenamento do Microsoft Azure possui detecção de alteração interna por meio de sua propriedade LastModified.
Outras fontes de dados, como SQL do Azure ou Azure Cosmos DB, exigem configuração para detecção de alterações antes que o indexador possa ler linhas novas e atualizadas.
Se o conteúdo subjacente estiver inalterado, uma operação de execução não terá efeito. Nesse caso, o histórico de execução do indexador indica 0\0 documentos processados.
Para reprocessar todos os documentos, você precisa redefinir o indexador.
Redefinir indexadores
Após a execução inicial, um indexador mantém o controle de quais documentos de pesquisa são indexados por meio de uma marca d'água alta interna. O marcador não é exposto, mas internamente o indexador sabe onde ele parou pela última vez.
Para reconstruir todo ou parte de um índice, use as APIs de redefinição disponíveis em níveis mais baixos da hierarquia de objetos:
- Redefinir Indexadores limpa a marca d'água alta e executa uma reindexação completa de todos os documentos.
- Os Indexadores ressincronizadores (versão prévia) executam um reindex parcial eficiente de todos os documentos.
- Redefinir Documentos (versão prévia) reindexa um documento específico ou uma lista de documentos.
- Redefinir habilidades (versão prévia) invoca o processamento de habilidades para uma habilidade específica.
Após a redefinição, siga com um comando Executar para reprocessar documentos novos e existentes. Não é possível remover documentos de pesquisa órfãos sem correspondência na fonte de dados usando redefinição e execução. Para excluir documentos específicos, consulte Excluir documentos em um índice de pesquisa ou Documentos – Índice.
Nota
As tabelas não podem estar vazias. Se você usar TRUNCATE TABLE para limpar linhas, uma redefinição e uma nova execução do indexador não removerão os documentos de pesquisa correspondentes. Para remover documentos de pesquisa órfãos, você deve indexá-los com uma ação de exclusão.
Como redefinir e executar indexadores
Redefinir limpa a marca d'água alta. Todos os documentos no índice de pesquisa são sinalizados para substituição completa, sem atualizações embutidas ou mesclagem em conteúdo existente. Para indexadores com um conjunto de habilidades e cache de enriquecimento (versão prévia), ao redefinir o índice, o conjunto de habilidades também é redefinido implicitamente.
O trabalho real ocorre quando você segue uma redefinição com um comando de Execução:
- Todos os novos documentos encontrados na fonte subjacente são adicionados ao índice de pesquisa.
- Todos os documentos que existem na fonte de dados e no índice de pesquisa são substituídos no índice de pesquisa.
- Qualquer conteúdo enriquecido criado a partir de conjuntos de habilidades é recriado. O cache de enriquecimento, se estiver habilitado, será atualizado.
Como observado anteriormente, a redefinição é uma operação passiva: você deve seguir com uma solicitação Executar para recompilar o índice.
As operações de redefinição/execução se aplicam a um índice de pesquisa ou a um repositório de conhecimento, a documentos ou projeções específicos e a enriquecimentos armazenados em cache se uma redefinição inclui explicitamente ou implicitamente habilidades.
A redefinição também se aplica às operações de criação e atualização. Ele não aciona a exclusão nem a remoção de documentos órfãos no índice de pesquisa. Para obter mais informações sobre como excluir documentos, consulte Documentos – Índice.
Você não pode desfazer uma operação de redefinição.
Acesse o serviço de pesquisa no Azure portal.
Na página Visão geral , selecione a guia Indexadores .
Selecione um indexador.
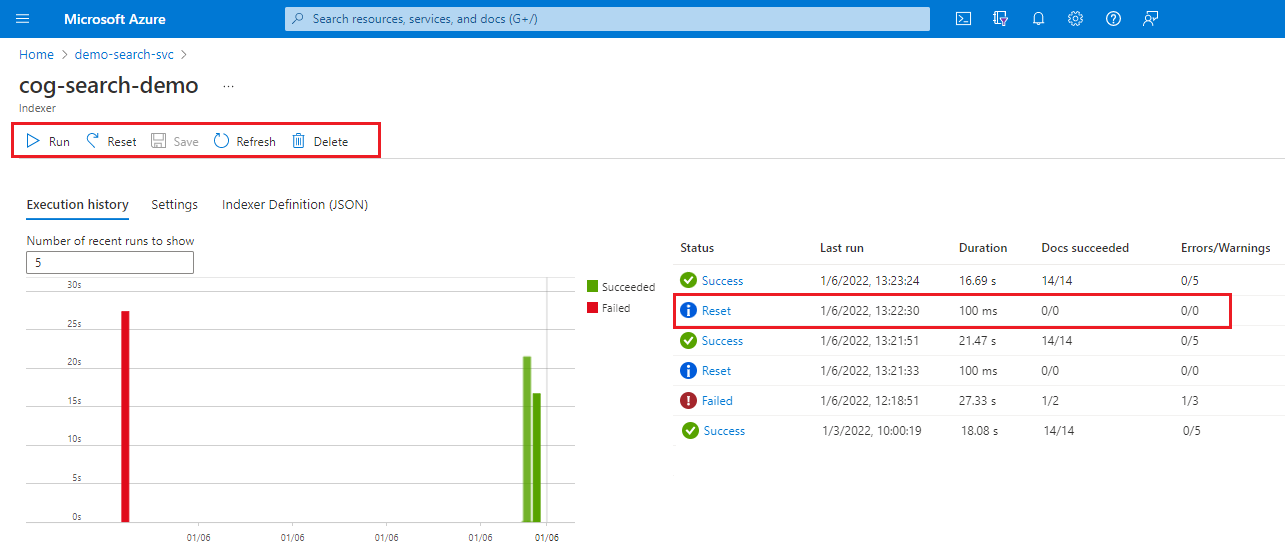
Selecione o comando Redefinir e selecione Sim para confirmar a ação.
Atualize a página para mostrar o status. Você pode selecionar o item para exibir seus detalhes.
Selecione Executar para iniciar o processamento do indexador ou aguarde a próxima execução agendada.
Como reconfigurar habilidades (prévia)
A solicitação de redefinição de habilidades processa, de forma seletiva, uma ou mais habilidades durante a próxima execução do indexador. Para indexadores com conjuntos de habilidades, redefinir habilidades individuais força o reprocessamento apenas dessa habilidade e de quaisquer habilidades downstream que dependam da sua saída. Se você habilitou o cache de enriquecimento, a solicitação também o atualizará.
Para indexadores que têm o cache habilitado, você pode solicitar explicitamente o processamento de atualizações de habilidades que o indexador não pode detectar. Por exemplo, se você fizer alterações externas, como revisões em uma habilidade personalizada, use essa API para executar novamente a habilidade. O processo atualiza as saídas, como um repositório de conhecimento ou índice de pesquisa, usando dados reutilizáveis do cache e novos conteúdos de acordo com a habilidade atualizada.
Use a API de versão prévia mais recente.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Você pode especificar habilidades individuais, conforme mostrado no exemplo anterior, mas se qualquer uma dessas habilidades exigir saída de habilidades não listadas (nº 2 a 4), o processo executará habilidades não listadas, a menos que o cache possa fornecer as informações necessárias. Para que essa condição seja verdadeira, os enriquecimentos armazenados em cache de habilidades #2 à #4 não devem depender da #1 (listada para redefinição).
Se você não especificar nenhuma habilidade, o processo executará todo o conjunto de habilidades e, se o cache estiver habilitado, também atualizará o cache.
Lembre-se de executar o Run Indexer para invocar o processamento real.
Como redefinir documentos (versão preliminar)
A API Indexadores – Redefinir Documentos (versão prévia) aceita uma lista de chaves de documento para que você possa atualizar documentos específicos. Se você especificar os parâmetros de redefinição, eles determinarão apenas o que é processado, independentemente de outras alterações nos dados subjacentes. Por exemplo, se 20 blobs foram adicionados ou atualizados desde a última execução do indexador, mas você só redefine um documento, o indexador processa apenas esse documento.
Por documento, o indexador atualiza todos os campos no documento de pesquisa com valores e metadados da fonte de dados. Você não pode escolher quais campos atualizar.
Se a fonte de dados for o Azure Data Lake Storage (ADLS) Gen2, e os blobs estiverem associados a metadados de permissão, o indexador ingerirá novamente essas permissões no índice de busca se as permissões forem alteradas nos dados subjacentes. Para obter mais informações, consulte Re-indexação do escopo ACL e RBAC com indexadores do ADLS Gen2.
Se você enriquecer o documento por meio de um conjunto de habilidades e ele tiver dados armazenados em cache, o indexador invocará o conjunto de habilidades apenas para os documentos especificados e atualizará o cache para os documentos reprocessados.
Quando você estiver testando essa API pela primeira vez, as SEGUINTEs APIs podem ajudá-lo a validar e testar os comportamentos. Use a API de versão prévia mais recente.
Chame o serviço Indexadores – Obter Status com uma API de versão preliminar para verificar o status da redefinição e o status da execução. Você pode encontrar informações sobre a solicitação de redefinição no final da resposta de status.
Acionar Indexadores – Redefinir Documentos usando uma versão prévia da API para especificar quais documentos devem ser processados.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
A API aceita dois tipos de identificadores de documento como entrada: chaves de documento que identificam documentos exclusivamente em um índice de pesquisa e identificadores de documentos da fonte de dados que identificam documentos exclusivamente em uma fonte de dados. O corpo deve conter uma lista de chaves de documento ou uma lista de identificadores de documentos de fonte de dados que o indexador procura na fonte de dados. A invocação da API adiciona as chaves do documento ou os identificadores de documento da fonte de dados para redefinição para metadados do indexador. Na próxima execução agendada ou sob demanda do indexador, o indexador processa apenas os documentos redefinidos.
Se você usar chaves de documento para redefinir documentos e suas chaves de documento forem referenciadas em um mapeamento de campo do indexador, o indexador usará o mapeamento de campo para localizar o campo apropriado na fonte de dados subjacente.
As chaves de documento fornecidas na solicitação são valores do índice de pesquisa, que podem ser diferentes dos campos correspondentes na fonte de dados. Se você não tiver certeza do valor da chave, envie uma consulta para retornar o valor. Você pode usar
selectpara retornar apenas o campo de chave do documento.Para blobs que o indexador analisa em vários documentos de pesquisa (quando
parsingModeestá definido como jsonLines ou jsonArrays, ou delimitedText), o indexador gera a chave do documento, e essa chave pode ser desconhecida para você. Nesse cenário, uma consulta para a chave do documento com o objetivo de retornar o valor correto.Se você quiser que o indexador pare de tentar processar a redefinição de documentos, defina
"documentKeys"ou"datasourceDocumentIds"para uma lista[]vazia. Esta ação resulta na retomada pelo indexador da indexação regular com base na marca d'água alta. Chaves de documento inválidas ou chaves de documento que não existem são ignoradas.
Chame o Run Indexer (qualquer versão da API) para processar os documentos especificados. O indexador indexa apenas esses documentos específicos.
Chame Executar Indexador pela segunda vez para processar na última marca d'água alta.
Chame Pesquisar Documentos para verificar se há valores atualizados e também para retornar chaves de documento caso você não tenha certeza do valor. Use
"select": "<field names>"se você quiser limitar quais campos aparecem na resposta.
Sobrescrever a lista de chaves do documento
Se você chamar a API Reset Documents várias vezes com chaves diferentes, as novas chaves serão adicionadas à lista de chaves de documento redefinidas. Se você chamar a API com o overwrite parâmetro definido como true, a lista atual será substituída pela nova:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Como ressincronizar indexadores (versão prévia)
O Resync Indexers é uma API REST de visualização que executa um reindex parcial de todos os documentos. Um indexador é considerado sincronizado com sua fonte de dados quando campos específicos de todos os documentos no índice de destino são consistentes com os dados na fonte de dados. Normalmente, um indexador obtém a sincronização após uma execução inicial bem-sucedida. Se você excluir um documento da fonte de dados, o indexador permanecerá sincronizado de acordo com essa definição. No entanto, durante a próxima execução do indexador, o documento correspondente no índice de destino será removido se o controle de exclusão estiver habilitado.
Se você modificar um documento na fonte de dados, o indexador ficará não sincronizado. Em geral, os mecanismos de controle de alterações ressincronizam o indexador durante a próxima execução. Por exemplo, no Armazenamento do Azure, modificar um blob atualiza a data/hora da última modificação, para que o indexador possa reindexá-lo na execução seguinte do indexador, porque a data/hora atualizada ultrapassa a marca d’água alta definida pela execução anterior.
Por outro lado, para determinadas fontes de dados, como o ADLS Gen2, alterar as ACLs (listas de controle de acesso) de um blob não altera a data da última modificação e, portanto, o rastreamento de alterações será ineficaz se as ACLs precisarem ser ingeridas. Consequentemente, o blob modificado não é reindexado na execução subsequente, pois apenas os documentos modificados após a última marca d'água alta são processados.
Embora tanto "reset" quanto "reset docs" possam resolver esse problema, "reset" pode ser demorado e ineficiente para grandes conjuntos de dados, e "reset docs" exige identificar a chave do documento do blob que você deseja atualizar.
Os indexadores ressincronizadores oferecem uma alternativa eficiente e conveniente. Basta colocar o indexador no modo ressincronizador e especificar o conteúdo a ser ressincronizado chamando a API de indexadores ressincronizadores. Na próxima execução, o indexador inspeciona apenas a parte relevante dos dados na origem e evita qualquer processamento desnecessário que não esteja relacionado aos dados especificados. Ele também consulta os documentos existentes no índice de destino e atualiza apenas os documentos que mostram discrepâncias entre a fonte de dados e o índice de destino. Após a execução de ressincronização, o indexador é sincronizado e revertido para o modo de execução regular do indexador para execuções subsequentes.
Como ressincronizar e executar indexadores
Chamar Indexadores – Ressincronizar com uma versão prévia da API para especificar qual conteúdo sincronizar novamente.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- O
optionscampo é necessário. Atualmente, a única opção com suporte épermissions. Ou seja, somente os campos de filtro de permissão no índice de destino são atualizados.
- O
Chame o Run Indexer (qualquer versão da API) para sincronizar novamente o indexador.
Chame Executar Indexador pela segunda vez para processar na última marca d'água alta.
Verificar o status de reinicialização "currentState"
Para verificar o status de redefinição e ver quais chaves de documento estão na fila para processamento, siga estas etapas:
Chame Get Indexer Status usando uma API de versão prévia.
A API de visualização retorna a
currentStateseção, encontrada no final da resposta."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Verifique o "modo":
Para Redefinir Habilidades, defina o "modo" como
indexingAllDocsporque possivelmente todos os documentos são afetados, em termos dos campos que o enriquecimento de IA preenche.Para indexadores ressincronizadores, defina "modo" como
indexingResync. O indexador verifica todos os documentos e se concentra nos dados interessados na fonte de dados e nos campos interessados no índice de destino.Para "Reset Documents", defina "mode" como
indexingResetDocs. O indexador mantém esse status até processar todas as chaves de documento fornecidas na chamada para redefinir documentos. Durante esse tempo, nenhum outro trabalho de indexador é executado enquanto a operação está em andamento. Localizar todos os documentos na lista de chaves do documento exige a quebra de cada documento para localizar e coincidir com a chave. Esse processo pode demorar um pouco se o conjunto de dados for grande. Se um contêiner de blob contiver centenas de blobs e os documentos que você deseja redefinir estiverem no final, o indexador não localizará os blobs correspondentes até que verifique todos os demais primeiro.Depois que o indexador reprocessar os documentos, execute Get Indexer Status novamente. O indexador retorna ao
indexingAllDocsmodo e processa documentos novos ou atualizados na próxima execução.
Verificar a cota de tempo de execução do indexador para os serviços de busca S3 HD e Serverless
Esta seção se aplica aos serviços de pesquisa standard 3 HD (alta densidade) e sem servidor. Para obter orientações sobre o comportamento da cota agregada e o planejamento, consulte Execução do indexador em Serverless e S3 HD (versão prévia).
Cada execução do indexador tem um máximo de duas horas. Em separado, todos os indexadores compartilham 24 horas cumulativas de tempo de execução por serviço em cada janela de 24 horas em UTC.
Para ajudá-lo a monitorar os tempos de execução do indexador em relação à janela de 24 horas, Obter Estatísticas de Serviço e Obter Status do Indexador agora retornará mais informações na resposta.
Acompanhar a cota cumulativa de tempos de execução
Acompanhe o uso cumulativo de runtime do indexador de um serviço de pesquisa e determine a quantidade de cota de runtime restante na janela atual de 24 horas.
Envie uma requisição GET para o endpoint do serviço de busca. Para obter ajuda com a configuração de um cliente REST e a obtenção de um token de acesso, consulte Conectar-se a um serviço de pesquisa.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
As respostas incluem indexersRuntime propriedades que mostram os horários de início e término da janela, segundos cumulativos usados por todos os indexadores e segundos restantes para o serviço.
Acompanhar a cota de runtime do indexador
Retorne as mesmas informações para um único indexador.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
As respostas incluem runtime propriedades que mostram os horários de início e término da janela, segundos usados pelo indexador e segundos restantes para todos os indexadores no serviço.
Próximas etapas
As APIs de redefinição são usadas para informar o escopo da próxima execução do indexador. Para o processamento real, você precisa invocar uma execução do indexador sob demanda ou permitir que um trabalho agendado conclua o trabalho. Após o término da execução, o indexador retorna ao processamento normal, seja de forma agendada ou sob demanda.
Depois de redefinir e executar novamente trabalhos do indexador, você pode monitorar o status do serviço de pesquisa ou obter informações detalhadas por meio do log de recursos.