Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Note
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Importante
Esses recursos e funcionalidades dão suporte a conexões com outros serviços de serviços Microsoft e de terceiros. O uso desses serviços está sujeito aos respectivos termos e pode resultar em processamento ou armazenamento de dados fora do limite de conformidade Azure, bem como dados que fluem para o limite de conformidade Azure.
É sua responsabilidade gerenciar se os seus dados serão transferidos para fora dos limites geográficos e de conformidade da sua organização, bem como quaisquer implicações relacionadas, e garantir que as permissões, os limites e as aprovações apropriados estejam devidamente estabelecidos.
Você é responsável por examinar e testar cuidadosamente os aplicativos que cria no contexto de seus casos de uso específicos e tomar todas as decisões e personalizações apropriadas. Isso inclui implementar suas próprias mitigações de IA responsáveis, como metaprompts, filtros de conteúdo ou outros sistemas de segurança, e garantir que seus aplicativos atendam aos padrões adequados de qualidade, confiabilidade, segurança e confiabilidade. Para obter mais informações, consulte a Pesquisa de IA do Azure Nota de Transparência.
O indexador de arquivos OneLake importa conteúdo e metadados de um lakehouse no Microsoft OneLake e torna o conteúdo pesquisável em Pesquisa de IA do Azure .
Para configurar e executar o indexador, você pode usar:
- API REST da Fonte de Dados com uma API REST do Indexador
- Um pacote SDK do Azure que fornece o recurso
- Assistente de importação de dados no portal do Azure.
Este artigo usa as APIs REST para ilustrar cada etapa.
Pré-requisitos
Um workspace do Fabric. Siga este tutorial para criar um workspace Fabric.
Um lakehouse em um workspace do Fabric. Siga esse tutorial para criar um lakehouse.
Dados textuais. Se você tiver dados binários, poderá usar a análise de imagem de enriquecimento de IA para extrair texto ou gerar descrições de imagens. O conteúdo do arquivo não pode exceder os limites do indexador para sua camada de serviço de pesquisa.
O processamento de arquivo de origem e o enriquecimento de IA têm limites separados. Uma habilidade downstream ou um serviço externo pode aceitar menos dados do que o indexador extrai, portanto, verifique o artigo de referência para cada habilidade em seu conjunto de habilidades.
Conteúdo não estruturado no local Arquivos do seu lakehouse. Você pode adicionar dados:
- Carregar diretamente em um lakehouse
- Use pipelines de dados de Microsoft Fabric
- Adicione atalhos de fontes de dados externas, como Amazon S3 ou Google Cloud Storage.
Um serviço Pesquisa de IA do Azure , tipo de preço básico ou superior, configurado para uma identidade gerenciada pelo sistema ou uma identidade gerenciada atribuída pelo usuário. O serviço Pesquisa de IA do Azure deve residir no mesmo locatário que o workspace Microsoft Fabric.
Atribuição da função de Administrador ou Colaborador no workspace do Microsoft Fabric onde o lakehouse está localizado. As etapas são descritas na seção Permissões de concessão deste artigo.
Permitir acesso aos dados do OneLake de aplicativos que estão fora do ambiente Fabric.
Um cliente REST para formular chamadas REST semelhantes às mostradas neste artigo.
Limitações
Atualmente, não há suporte para tipos de arquivo Parquet (incluindo Delta Parquet).
Não há suporte para exclusão de arquivo para atalhos do Amazon S3 e do Google Cloud Storage.
Esse indexador não dá suporte ao conteúdo do local da tabela do workspace do OneLake.
Esse indexador não dá suporte a consultas SQL. O
queryparâmetro na configuração da fonte de dados especifica apenas uma pasta ou atalho opcional para indexar.Não há suporte para ingerir arquivos do workspace My Workspace no OneLake, pois esse é um repositório pessoal por usuário.
A indexação de arquivos de Itens do Fabric com rótulos de confidencialidade, por exemplo, lakehouses, não é compatível. No entanto, quando os rótulos de confidencialidade são aplicados diretamente a documentos individuais, a ingestão de conteúdo protegido e rótulos associados é compatível. Nesses casos, Pesquisa de IA do Azure pode extrair e honrar rótulos de confidencialidade e conteúdo de documentos rotulados por meio de sua integração com o Purview (versão prévia).
As permissões baseadas em função no espaço de trabalho no Microsoft OneLake podem afetar o acesso do indexador aos arquivos. Certifique-se de que a entidade de serviço da Pesquisa de IA do Azure (identidade gerenciada) tenha permissões suficientes em relação aos arquivos que você pretende acessar no espaço de trabalho do Microsoft Fabric de destino.
Tarefas com suporte
Você pode usar esse indexador para as seguintes tarefas:
- Indexação de dados e indexação incremental: O indexador pode indexar arquivos e metadados associados de caminhos de dados dentro de um lakehouse. Ele detecta arquivos e metadados novos e atualizados por meio da detecção de alterações interna. Você pode configurar a atualização de dados em um agendamento ou sob demanda.
- Detecção de exclusão: O indexador pode detectar exclusões por meio de metadados personalizados para a maioria dos arquivos e atalhos. Isso requer a adição de metadados aos arquivos para indicar que eles foram "excluídos suavemente", permitindo sua remoção do índice de pesquisa. Atualmente, não é possível detectar exclusões no Google Cloud Storage ou em arquivos de atalho do Amazon S3 porque metadados personalizados não são compatíveis com essas fontes de dados.
- O enriquecimento de IA aplicado por meio de conjuntos de habilidades:Skillsets são totalmente compatíveis com o indexador de arquivos do OneLake. Isso inclui os principais recursos, como a vetorização integrada , que adiciona etapas de agrupamento de dados e inserção.
- Modos de análise: O indexador dá suporte a modos de análise JSON se você quiser analisar matrizes JSON ou linhas em documentos de pesquisa individuais. Ele também dá suporte ao modo de análise markdown.
- Compatibilidade com outros recursos: O indexador OneLake foi projetado para funcionar perfeitamente com outros recursos do indexador, como sessões de depuração, cache do indexador para enriquecimentos incrementais (versão prévia) e repositório de conhecimento.
Formatos de documento com suporte
O indexador de arquivos OneLake pode extrair texto dos seguintes formatos de documento:
- CSV (saiba mais em indexação de blobs CSV)
- EML
- EPUB
- GZ
- HTML
- JSON (consulte indexação de blobs JSON)
- KML (XML para representações geográficas)
- Markdown
- Microsoft Office formatos: DOCX/DOC/DOCM, XLSX/XLS/XLSM, PPTX/PPT/PPTM, MSG (emails Outlook), XML (2003 e 2006 WORD XML)
- Abrir formatos de documento: ODT, ODS, ODP
- Arquivos de texto sem formatação (consulte também Indexação de texto sem formatação)
- RTF
- XML
- ZIP
Atalhos com suporte
Os seguintes atalhos do OneLake são compatíveis com o indexador de arquivos OneLake:
Atalho onelake (um atalho para outra instância do OneLake)
Importante
O não cumprimento de qualquer um dos pré-requisitos ou a tentativa de realizar uma operação coberta pelas limitações documentadas causará erros ao listar itens no lakehouse.
Preparar dados para indexação
Antes de configurar a indexação, examine os dados de origem para determinar se você precisa fazer alterações em seus dados no lakehouse. Um indexador pode indexar o conteúdo de um contêiner (o lakehouse) por vez. Por padrão, o indexador processa todos os arquivos do lakehouse. Para processar arquivos de forma mais seletiva, considere as seguintes opções:
Coloque arquivos em uma pasta virtual. Uma definição de fonte de dados do indexador inclui um parâmetro de "consulta" que pode ser uma subpasta ou um atalho do lakehouse. Se esse valor for especificado, somente os arquivos na subpasta ou atalho dentro do lakehouse serão indexados.
Incluir ou excluir arquivos por tipo de arquivo. A lista de formatos de documento com suporte pode ajudá-lo a determinar quais arquivos excluir. Por exemplo, talvez você queira excluir arquivos de imagem ou áudio que não fornecem texto pesquisável. Essa funcionalidade é controlada por meio de configurações no indexador.
Incluir ou excluir arquivos arbitrários. Se você quiser ignorar um arquivo específico por qualquer motivo, poderá adicionar propriedades e valores de metadados aos arquivos em seu lakehouse. Quando um indexador encontra essa propriedade, ele ignora o arquivo ou seu conteúdo na execução de indexação.
A inclusão e a exclusão de arquivos são abordadas na etapa de configuração do indexador . Se você não definir critérios, o indexador relatará um arquivo inelegível como um erro e avançará. Se ocorrerem erros suficientes, o processamento poderá parar. Você pode especificar a tolerância a erros nas configurações do indexador.
Um indexador normalmente cria um documento de pesquisa por arquivo, em que o conteúdo de texto e os metadados são capturados como campos pesquisáveis em um índice. Se os arquivos forem arquivos inteiros, você poderá analisá-los em vários documentos de pesquisa. Por exemplo, você pode analisar linhas em um arquivo CSV para criar um documento de pesquisa por linha. Se você precisar dividir um único documento em passagens menores para vetorizar dados, considere usar a vetorização integrada.
Indexando metadados de arquivo
Metadados de arquivo também podem ser indexados e isso é útil se você achar que qualquer uma das propriedades de metadados padrão ou personalizadas é útil em filtros e consultas.
As propriedades de metadados especificadas pelo usuário são extraídas verbatim. Para receber os valores, você deve definir o campo no índice de pesquisa do tipo Edm.String, com o mesmo nome da chave de metadados do blob. Por exemplo, se um blob tiver uma chave de metadados Priority com valor High, você deverá definir um campo chamado Priority no índice de pesquisa e ele será preenchido com o valor High.
As propriedades de metadados de arquivo padrão podem ser extraídas em campos nomeados e digitados da mesma forma, conforme listado abaixo. O indexador de arquivos OneLake cria automaticamente mapeamentos de campo internos para essas propriedades de metadados, convertendo o nome hifenizado original ("metadata-storage-name") em um nome equivalente sublinhado ("metadata_storage_name").
Você ainda precisa adicionar os campos sublinhados à definição de índice, mas pode omitir mapeamentos de campo do indexador porque o indexador faz a associação automaticamente.
metadata_storage_name (
Edm.String) – o nome do arquivo. Por exemplo, se você tiver um arquivo /mydatalake/my-folder/subfolder/resume.pdf, o valor desse campo seráresume.pdf.metadata_storage_path (
Edm.String) – o URI completo do blob, incluindo a conta de armazenamento. Por exemplo,https://myaccount.blob.core.windows.net/my-container/my-folder/subfolder/resume.pdfmetadata_storage_content_type (
Edm.String) – tipo de conteúdo conforme especificado pelo código usado para carregar o blob. Por exemplo,application/octet-stream.metadata_storage_last_modified (
Edm.DateTimeOffset) – timestamp de última modificação para o blob. Pesquisa de IA do Azure usa esse carimbo de data/hora para identificar blobs alterados, para evitar a reindexação de tudo após a indexação inicial.metadata_storage_size (
Edm.Int64) – tamanho do blob em bytes.metadata_storage_content_md5 (
Edm.String) – hash MD5 do conteúdo do blob, se disponível.
Por fim, quaisquer propriedades de metadados específicas para o formato de documento dos arquivos que você está indexando também podem ser representadas no esquema de índice. Para obter mais informações sobre metadados específicos do conteúdo, consulte as propriedades de metadados de conteúdo.
É importante destacar que você não precisa definir campos para todas as propriedades acima no índice de pesquisa– basta capturar as propriedades necessárias para seu aplicativo.
Conceder permissões
O indexador OneLake usa autenticação de token e acesso baseado em função para conexões com o OneLake. As permissões são atribuídas no OneLake. Não há requisitos de permissão nos armazenamentos de dados físicos que fazem backup dos atalhos. Por exemplo, se você estiver indexando do AWS, não precisará conceder permissões de serviço de pesquisa no AWS.
A atribuição de função mínima para a identidade do serviço de pesquisa é de Colaborador.
Configure um sistema ou uma identidade gerenciada pelo usuário para seu serviço de Pesquisa de IA do Azure .
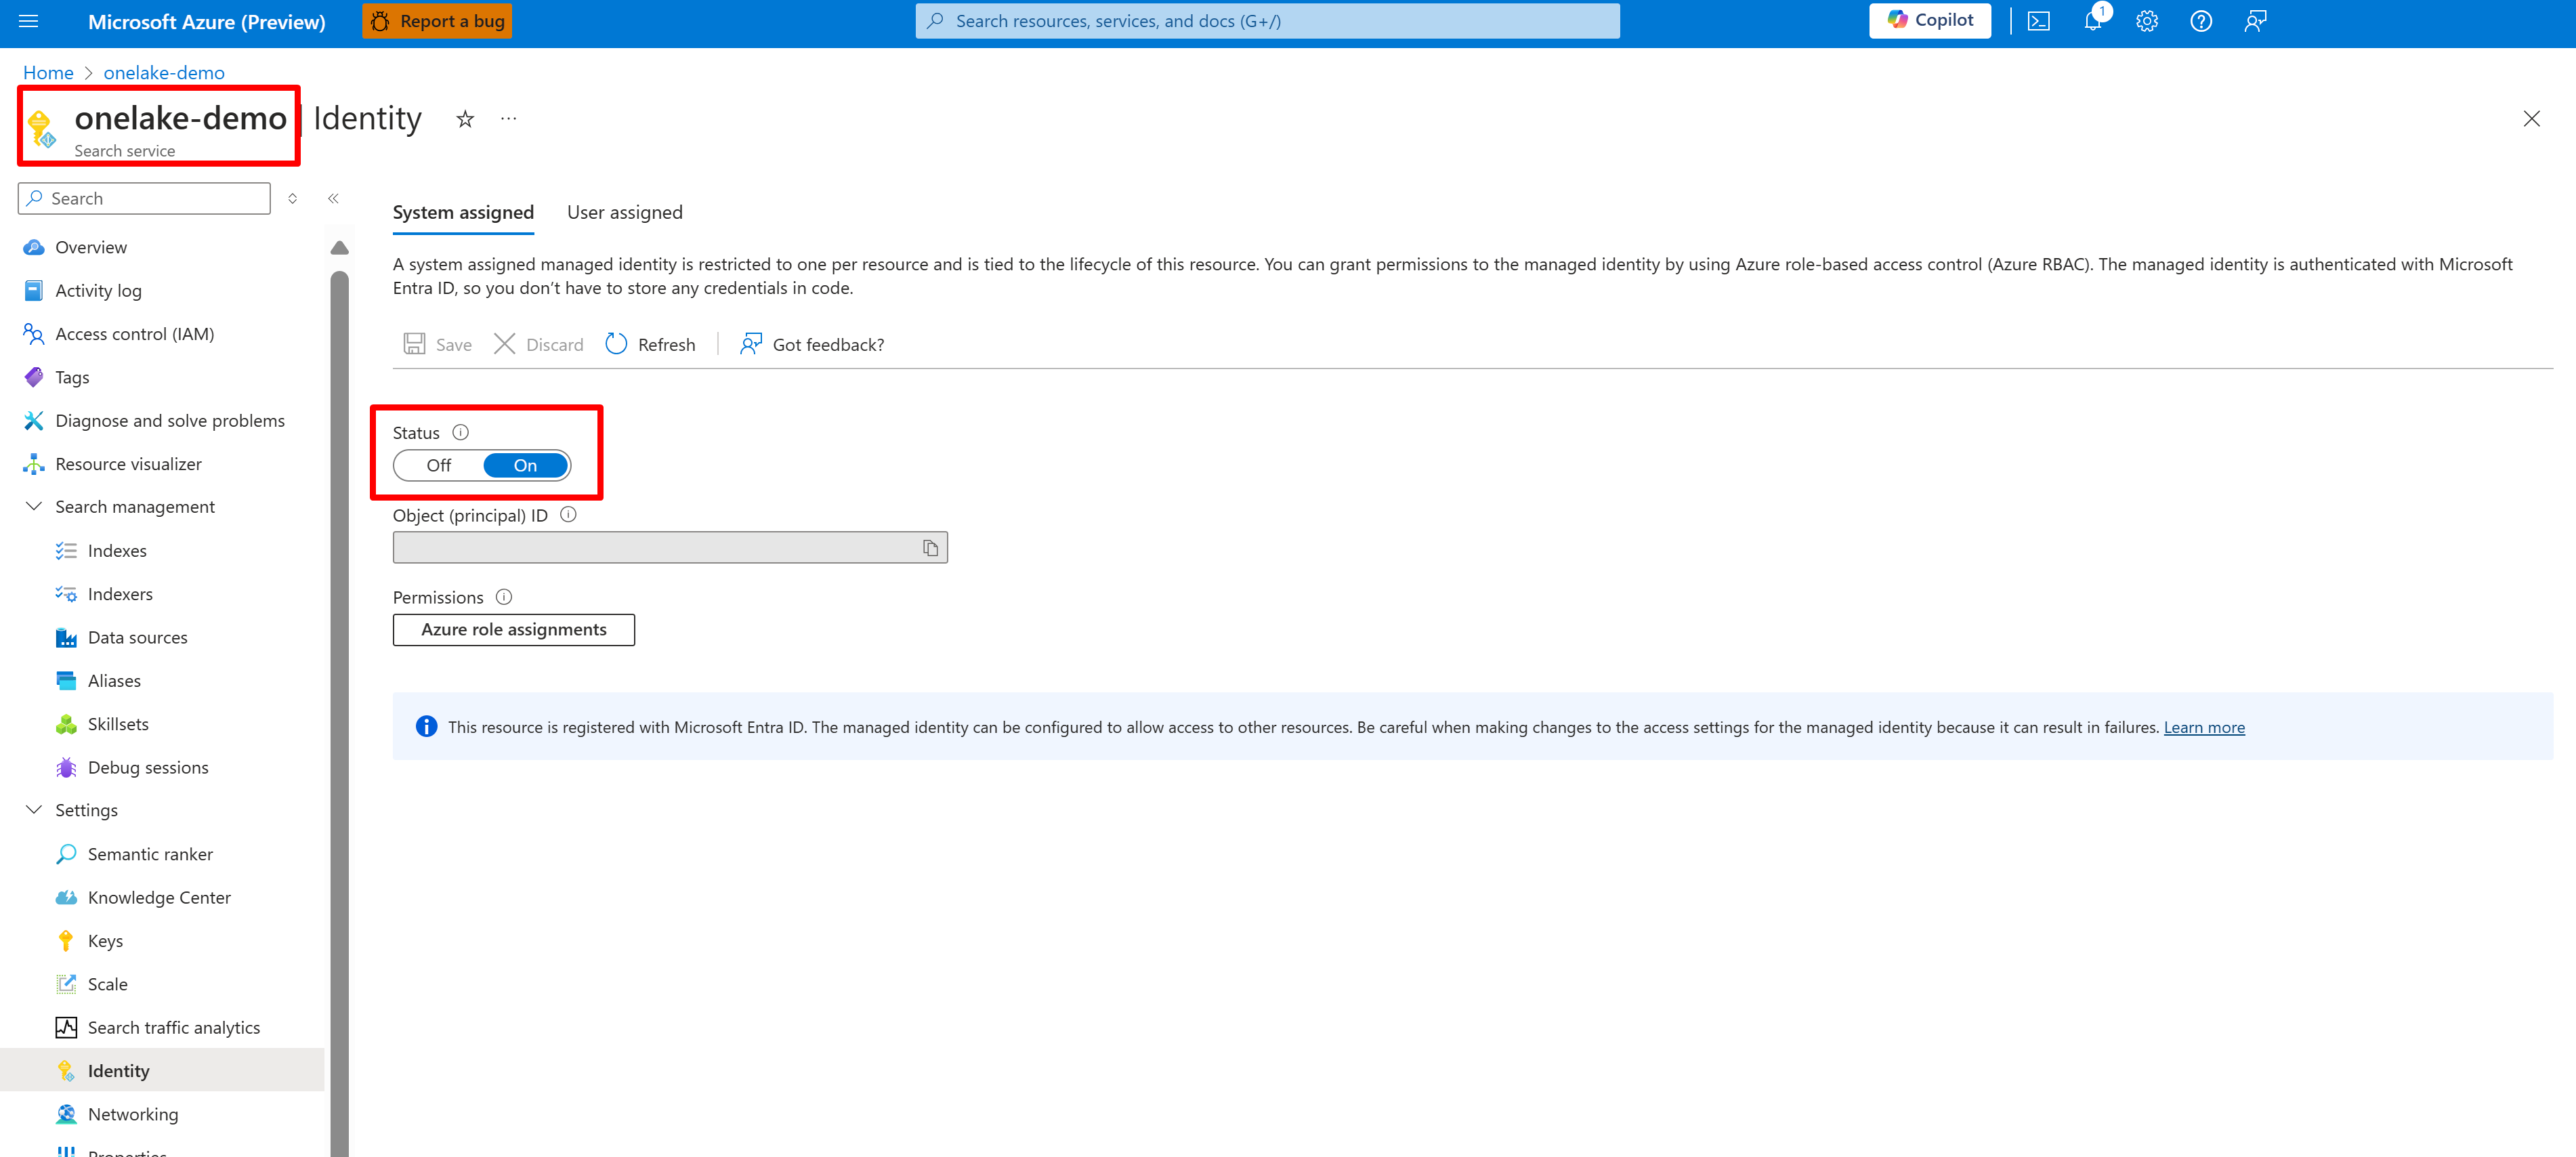
A captura de tela a seguir mostra uma identidade gerenciada pelo sistema para um serviço de pesquisa chamado "onelake-demo".
Esta captura de tela mostra uma identidade gerenciada pelo usuário para o mesmo serviço de pesquisa.

Conceda permissão para acesso do serviço de pesquisa ao workspace Fabric. O serviço de pesquisa faz a conexão em nome do indexador.
Se você usar uma identidade gerenciada atribuída pelo sistema, pesquise o nome do serviço Pesquisa de IA do Azure . Para obter uma identidade gerenciada atribuída pelo usuário, pesquise o nome do recurso de identidade.
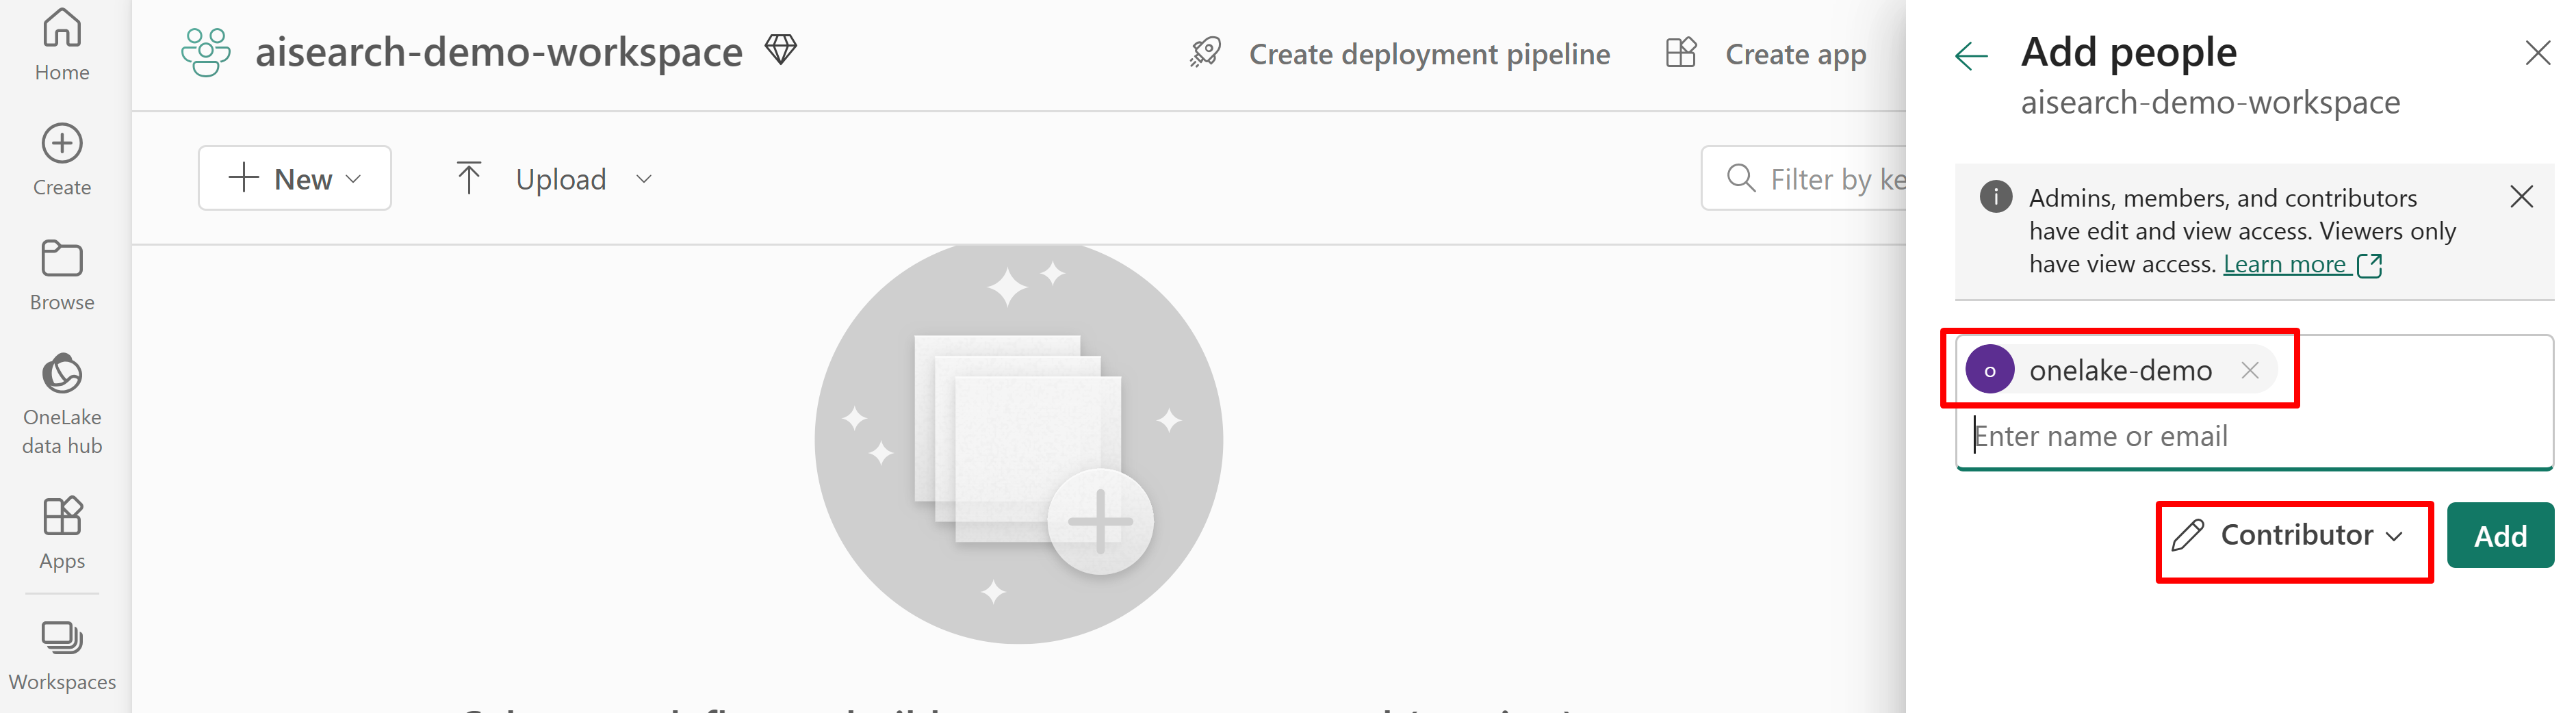
A captura de tela a seguir mostra uma atribuição da função de Contribuidor usando identidade gerenciada pelo sistema.
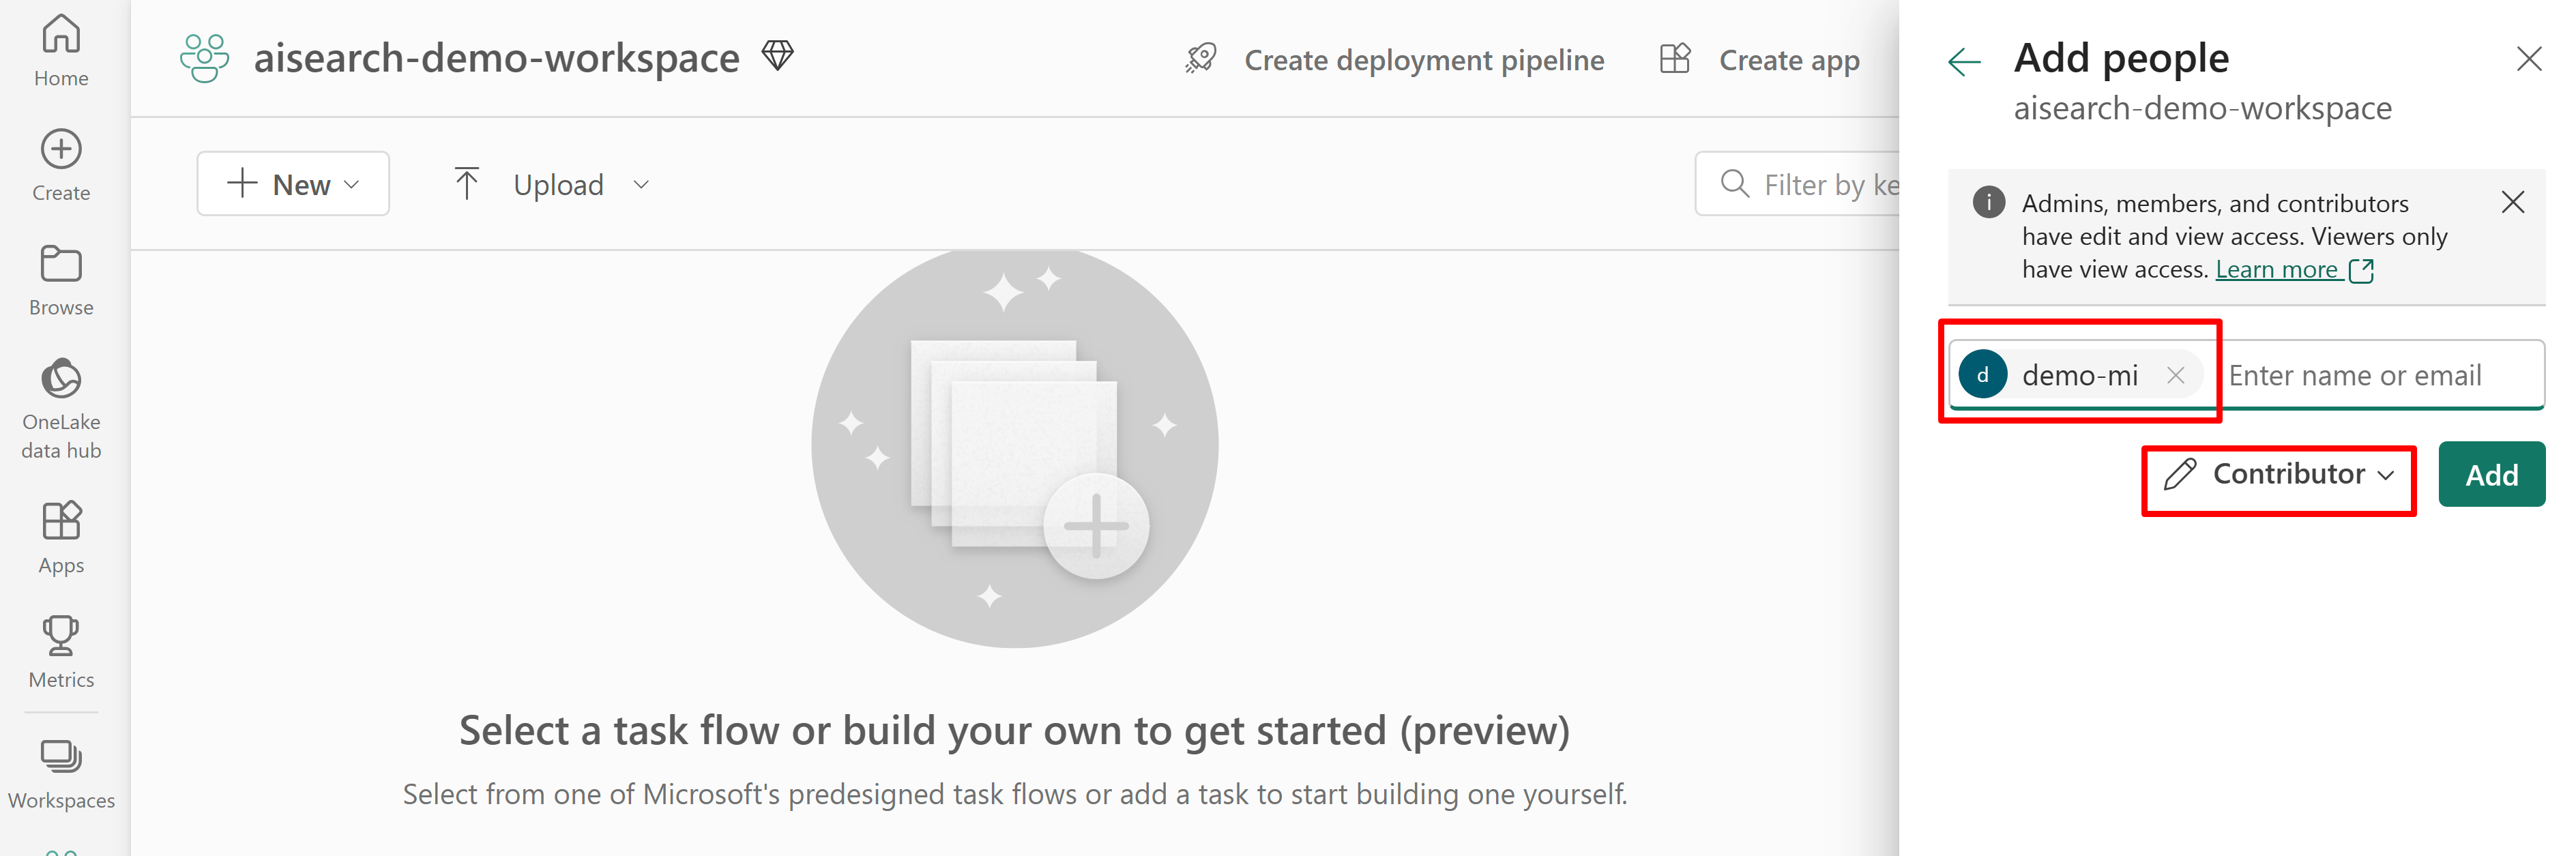
Esta captura de tela mostra a atribuição de uma função de Contribuinte usando uma identidade gerenciada atribuída pelo usuário.

Configurar um link privado compartilhado (necessário se estiver usando um link privado no nível do workspace do Fabric)
Se o workspace Fabric estiver protegido com um link privado, o Pesquisa de IA do Azure não conseguirá acessar seus dados do lakehouse pela internet pública, e você não poderá configurar o indexador ou suas dependências necessárias, como a fonte de dados. Para habilitar o acesso, você deve configurar um link privado compartilhado entre Pesquisa de IA do Azure e seu workspace Fabric.
Definir a fonte de dados
Uma fonte de dados é definida como um recurso independente para que possa ser usada por vários indexadores.
Use a API REST criar ou atualizar uma fonte de dados para definir sua definição. Estas são as etapas mais significativas da definição.
Definido
"type"como"onelake"(obrigatório).Obtenha o GUID do workspace do Microsoft Fabric e o GUID do lakehouse:
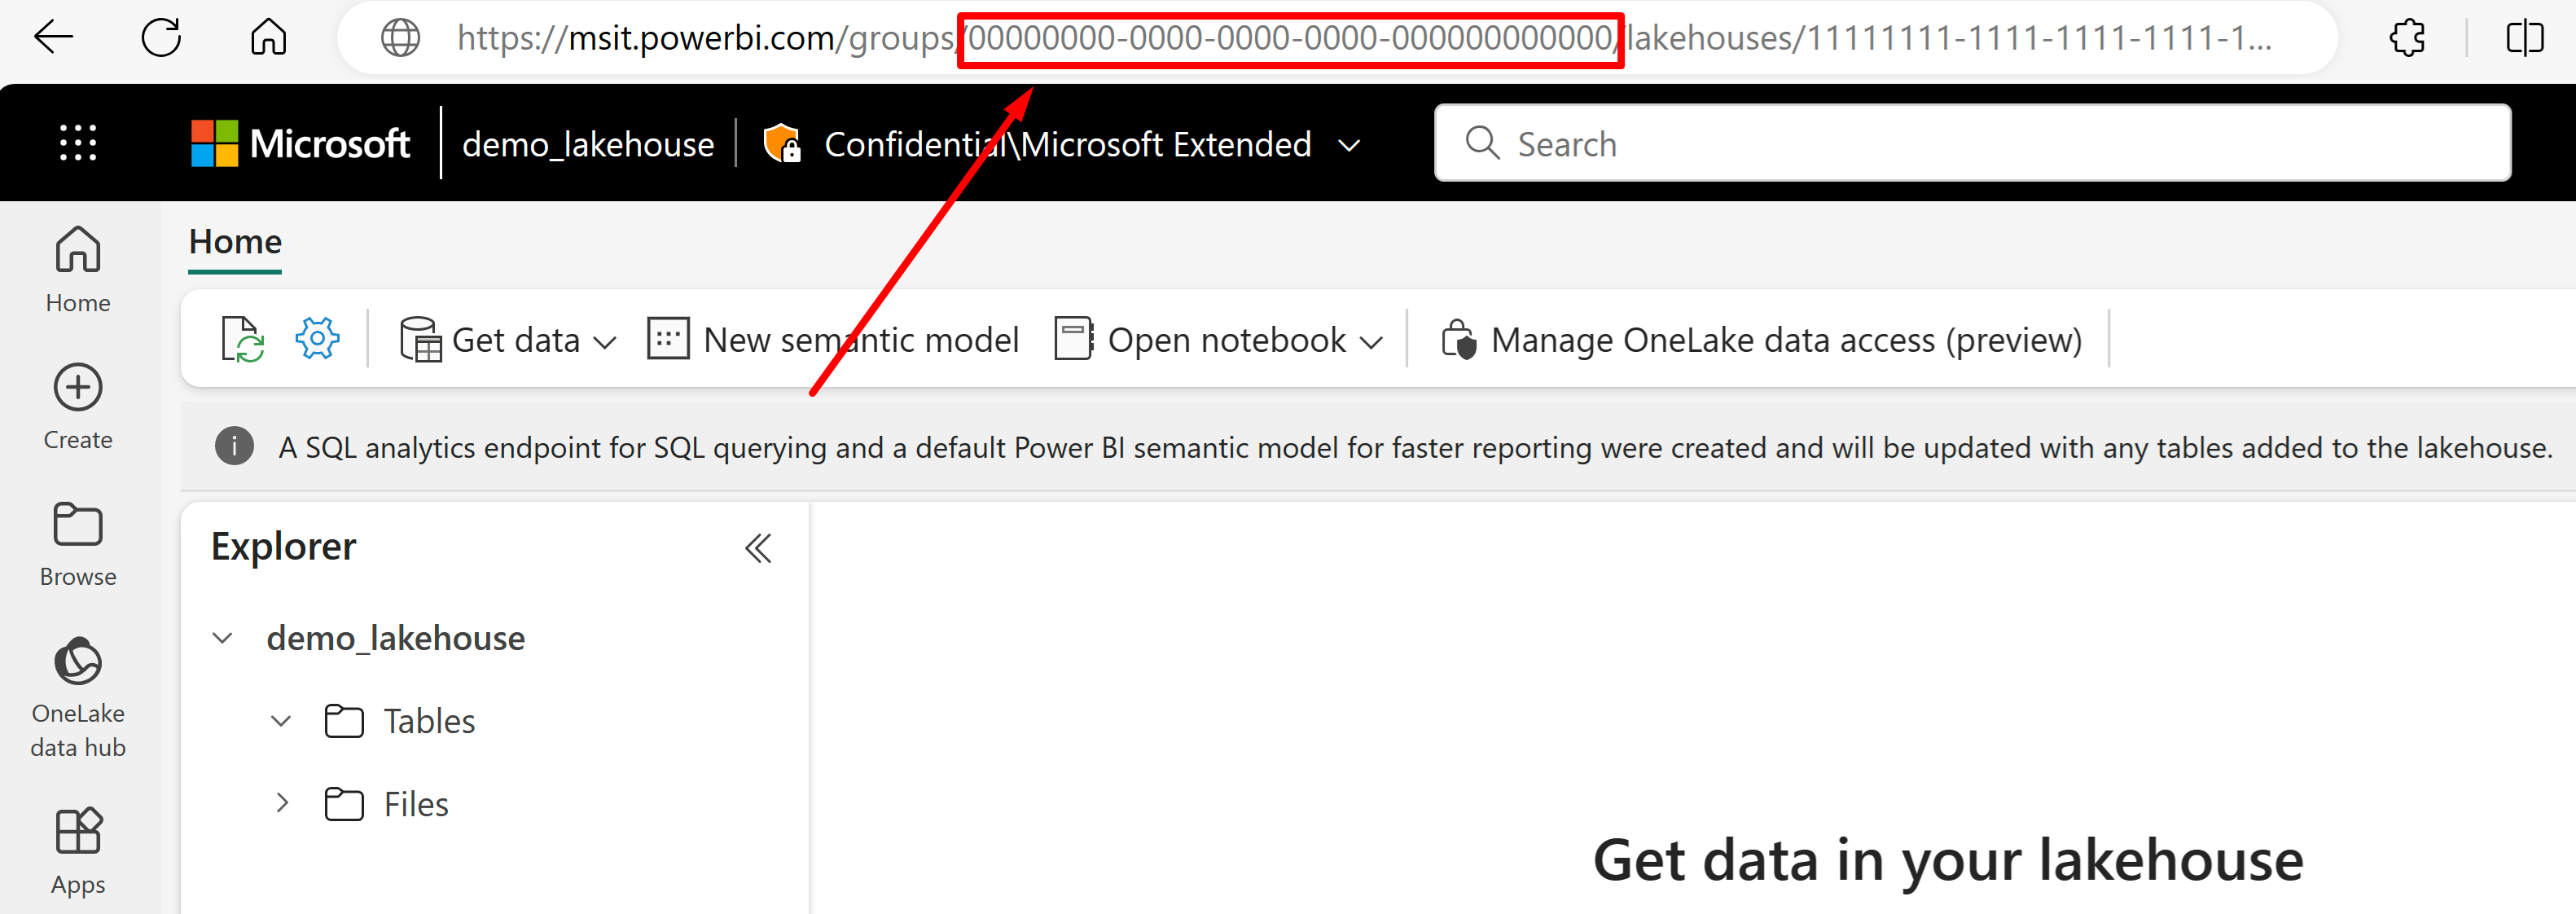
Em Power BI, abra o lakehouse a partir do qual você gostaria de importar dados. Observe o URL do lakehouse no navegador. Ele deve ser semelhante a este exemplo: "https://msit.powerbi.com/groups/00000000-0000-0000-0000-000000000000/lakehouses/11111111-1111-1111-1111-111111111111". A URL contém o GUID do workspace e o GUID do lakehouse. Se o workspace Fabric for protegido com um link privado, a URL começará com "https://{FabricWorkspaceGuid}.z{xy}.blob.fabric.microsoft.com".
Copie o GUID do espaço de trabalho, que está listado à direita da palavra "grupos" na URL. Neste exemplo, seria 000000000-0000-0000-0000-0000-000000000000000. No arquivo REST, crie uma variável de ambiente para
{FabricWorkspaceGuid}e defina-a para o GUID do workspace. Se o seu espaço de trabalho usar um link privado, o GUID do espaço de trabalho aparecerá em um local diferente no URL. Lembre-se de referenciar a parte correta da URL com base em sua configuração.
Copie o GUID da lakehouse, que está listado logo após "lakehouses" na URL. Neste exemplo, seria 11111111-1111-1111-1111-1111-1111111111111. No arquivo REST, crie uma variável de ambiente para
{LakehouseGuid}e defina-a para o GUID do lakehouse.
Defina
"credentials"para o GUID do workspace Microsoft Fabric substituindo{FabricWorkspaceGuid}pelo valor copiado na etapa anterior. Este é o OneLake a ser acessado com a identidade gerenciada que você configurará mais adiante neste guia."credentials": { "connectionString": "ResourceId={FabricWorkspaceGuid}" }

Para sua configuração com link privado compartilhado, configure as identidades gerenciadas usando a cadeia de conexão a seguir, que varia da configuração usando a comunicação pela Internet. Observe que não só a URL é diferente, mas também WorkspaceEndpoint é usada, em vez de ResourceId. Leve isso em consideração ao configurar a identidade gerenciada pelo sistema ou as configurações de identidade gerenciadas pelo usuário.
 "credentials": {
 "connectionString": "WorkspaceEndpoint=https://{FabricWorkspaceGuid}.z{xy}.blob.fabric.microsoft.com"
 }
Defina
"container.name"para o GUID do lakehouse, substituindo{LakehouseGuid}pelo valor copiado na etapa anterior. Use"query"para especificar opcionalmente uma subpasta ou atalho do lakehouse."container": { "name": "{LakehouseGuid}", "query": "{optionalLakehouseFolderOrShortcut}" }Defina o método de autenticação usando a identidade gerenciada atribuída pelo usuário ou vá para a próxima etapa para a identidade gerenciada pelo sistema.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "{userAssignedManagedIdentity}"
  }
}
O
userAssignedIdentityvalor pode ser encontrado acessando o{userAssignedManagedIdentity}recurso, em Propriedades e é chamadoId.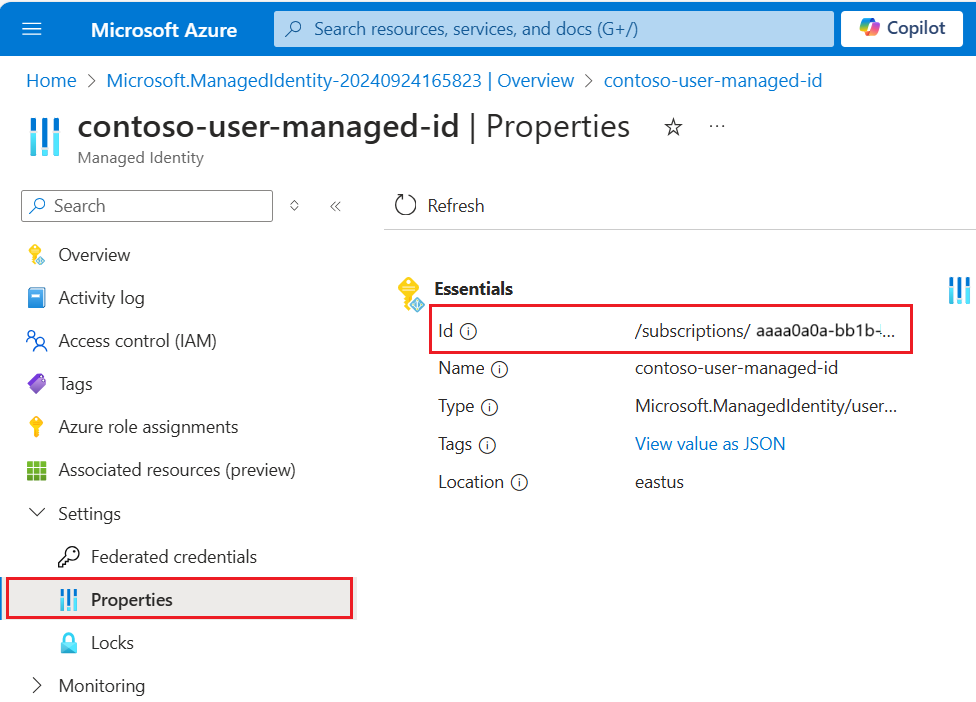
Exemplo:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  },
  "identity": {
    "@odata.type": "Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/333333-3333-3333-3333-33333333/resourcegroups/myresourcegroup/providers/Microsoft.ManagedIdentity/userAssignedIdentities/demo-mi"
  }
}
Opcionalmente, use uma identidade gerenciada atribuída pelo sistema. A "identidade" será removida da definição se estiver usando a identidade gerenciada atribuída pelo sistema.
{
  "name": "{dataSourceName}",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId={FabricWorkspaceGuid}"
  },
  "container": {
    "name": "{LakehouseGuid}",
    "query": "{optionalLakehouseFolderOrShortcut}"
  }
}
Exemplo:
{
  "name": "mydatasource",
  "description": "description",
  "type": "onelake",
  "credentials": {
    "connectionString": "ResourceId=a0a0a0a0-bbbb-cccc-dddd-e1e1e1e1e1e1"
  },
  "container": {
    "name": "11111111-1111-1111-1111-111111111111",
    "query": "folder_name"
  }
}
Detectar exclusões por meio de metadados personalizados
A definição da fonte de dados do indexador de arquivos OneLake pode incluir uma política de exclusão reversível se você quiser que o indexador exclua um documento de pesquisa quando o documento de origem for sinalizado para exclusão.
Para habilitar a exclusão automática de arquivo, use metadados personalizados para indicar se um documento de pesquisa deve ser removido do índice.
O fluxo de trabalho requer três ações separadas:
- "Exclusão suave" do arquivo no OneLake
- O indexador exclui o documento de pesquisa no índice
- "Exclusão irreversível" do arquivo no OneLake.
"Exclusão suave" informa ao indexador o que fazer (excluir o documento de pesquisa). Se você excluir o arquivo físico no OneLake primeiro, não haverá nada para o indexador ler e o documento de pesquisa correspondente no índice ficar órfão.
Há etapas a seguir no OneLake e no Pesquisa de IA do Azure , mas não há outras dependências de recurso.
No arquivo lakehouse, adicione um par de chave-valor de metadados personalizado ao arquivo para indicar que o arquivo está sinalizado para exclusão. Por exemplo, você pode nomear a propriedade "IsDeleted", definida como false. Quando você quiser excluir o arquivo, altere-o para true.
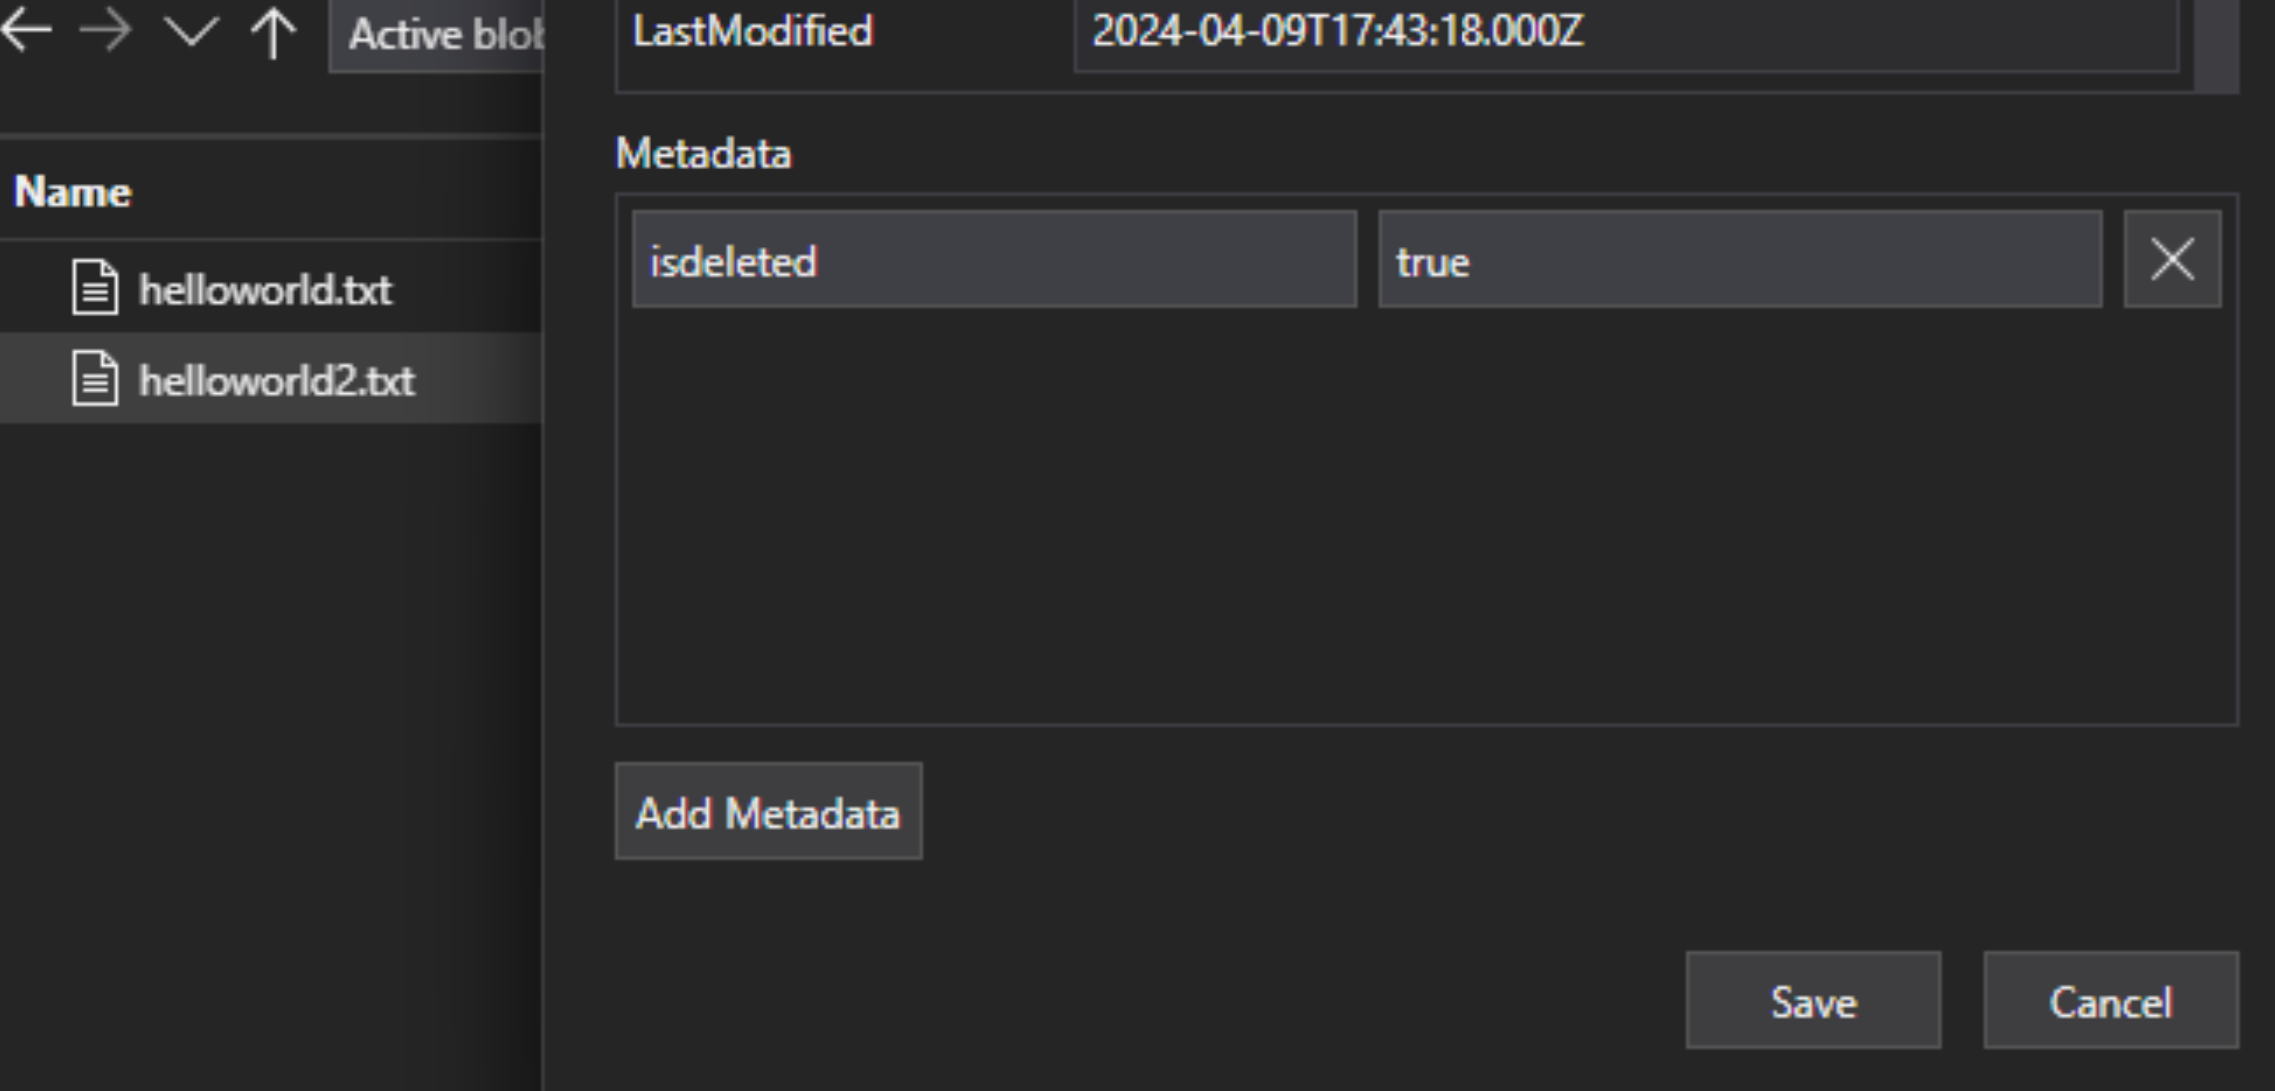
Em Pesquisa de IA do Azure , edite a definição da fonte de dados para incluir uma propriedade "dataDeletionDetectionPolicy". Por exemplo, a política a seguir considera um arquivo a ser excluído se ele tiver uma propriedade de metadados "IsDeleted" com o valor verdadeiro:
PUT https://[service name].search.windows.net/datasources/file-datasource?api-version=2026-04-01
{
    "name" : "onelake-datasource",
    "type" : "onelake",
     "credentials": {
        "connectionString": "ResourceId={FabricWorkspaceGuid}"
    },
    "container": {
        "name": "{LakehouseGuid}",
        "query": "{optionalLakehouseFolderOrShortcut}"
    },
    "dataDeletionDetectionPolicy" : {
        "@odata.type" :"#Microsoft.Azure.Search.SoftDeleteColumnDeletionDetectionPolicy",
        "softDeleteColumnName" : "IsDeleted",
        "softDeleteMarkerValue" : "true"
    }
}
Depois que o indexador for executado e excluir o documento do índice de pesquisa, você poderá então excluir o arquivo físico no lago de dados.
Alguns pontos-chave incluem:
Agendar uma execução de indexador ajuda a automatizar esse processo. Recomendamos agendamentos para todos os cenários de indexação incremental.
Se a política de detecção de exclusão não tiver sido definida na primeira execução do indexador, você deverá redefinir o indexador para que ele leia a configuração atualizada.
Lembre-se de que a detecção de exclusão não tem suporte para atalhos do Amazon S3 e do Google Cloud Storage devido à dependência de metadados personalizados.
Adicionar campos de pesquisa a um índice
Em um índice de pesquisa, adicione campos para aceitar o conteúdo e os metadados dos arquivos do data lake do OneLake.
Crie ou atualize um índice para definir campos de pesquisa que armazenam o conteúdo e os metadados do arquivo:
{
    "name" : "my-search-index",
    "fields": [
        { "name": "ID", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "content", "type": "Edm.String", "searchable": true, "filterable": false },
        { "name": "metadata_storage_name", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_size", "type": "Edm.Int64", "searchable": false, "filterable": true, "sortable": true  },
        { "name": "metadata_storage_content_type", "type": "Edm.String", "searchable": false, "filterable": true, "sortable": true }
    ]
}
Crie um campo de chave de documento ("chave": true). Para o conteúdo do arquivo, os melhores candidatos são propriedades de metadados.
metadata_storage_path(padrão) caminho completo para o objeto ou arquivo. O campo de chave ("ID" neste exemplo) é preenchido com valores de metadata_storage_path porque é o padrão.metadata_storage_name, utilizável somente se os nomes forem exclusivos. Se você quiser esse campo como chave, mova"key": truepara essa definição de campo.Uma propriedade de metadados personalizada que você adiciona aos seus arquivos. Essa opção requer que o processo de upload de arquivo adicione essa propriedade de metadados a todos os blobs. Como a chave é uma propriedade necessária, todos os arquivos que não têm um valor não são indexados. Se você usar uma propriedade de metadados personalizada como uma chave, evite fazer alterações nessa propriedade. Os indexadores adicionarão documentos duplicados para o mesmo arquivo se a propriedade de chave for alterada.
As propriedades de metadados geralmente incluem caracteres, como
/e-, que são inválidos para chaves de documento. Como o indexador tem uma propriedade "base64EncodeKeys" (true por padrão), ele codifica automaticamente a propriedade de metadados, sem a necessidade de configuração ou mapeamento de campo.Adicione um campo "conteúdo" para armazenar o texto extraído de cada arquivo por meio da propriedade "content" do arquivo. Você não precisa usar esse nome, mas fazer isso permite aproveitar os mapeamentos de campo implícitos.
Adicione campos para propriedades de metadados padrão. O indexador pode ler propriedades de metadados personalizadas, propriedades de metadados padrão e propriedades de metadados específicas do conteúdo .
Configurar e executar o indexador de arquivos Do OneLake
Depois que o índice e a fonte de dados forem criados, você estará pronto para criar o indexador. A configuração do indexador especifica as entradas, os parâmetros e as propriedades que controlam os comportamentos de tempo de execução. Você também pode especificar quais partes de um blob indexar.
Crie ou atualize um indexador dando-lhe um nome e fazendo referência à fonte de dados e ao índice de destino:
{
  "name" : "my-onelake-indexer",
  "dataSourceName" : "my-onelake-datasource",
  "targetIndexName" : "my-search-index",
  "parameters": {
      "batchSize": null,
      "maxFailedItems": null,
      "maxFailedItemsPerBatch": null,
      "base64EncodeKeys": null,
      "configuration": {
          "indexedFileNameExtensions" : ".pdf,.docx",
          "excludedFileNameExtensions" : ".png,.jpeg",
          "dataToExtract": "contentAndMetadata",
          "parsingMode": "default"
      }
  },
  "schedule" : { },
  "fieldMappings" : [ ]
}
Defina "batchSize" se o padrão (10 documentos) estiver subutilizando ou sobrecarregando os recursos disponíveis. Os tamanhos de lote padrão são específicos da fonte de dados. A indexação de arquivos define o tamanho do lote em 10 documentos em reconhecimento ao tamanho médio maior do documento.
Em "configuração", controle quais arquivos são indexados com base no tipo de arquivo ou deixe não especificado para recuperar todos os arquivos.
Para
"indexedFileNameExtensions", forneça uma lista de extensões de arquivo separadas por vírgula (com ponto inicial). Faça o mesmo para"excludedFileNameExtensions"para indicar quais extensões devem ser ignoradas. Se a mesma extensão estiver em ambas as listas, ela será excluída da indexação.Em "configuração", defina "dataToExtract" para controlar quais partes dos arquivos são indexadas:
"contentAndMetadata" é o padrão. Ele especifica que todos os metadados e conteúdo textual extraídos do arquivo são indexados.
"storageMetadata" especifica que somente as propriedades de arquivo padrão e os metadados especificados pelo usuário são indexados. Embora as propriedades estejam documentadas para Azure blobs, as propriedades do arquivo são as mesmas para o OneLake, exceto para os metadados relacionados à SAS.
"allMetadata" especifica que as propriedades de arquivo padrão e os metadados para tipos de conteúdo encontrados são extraídos do conteúdo do arquivo e indexados.
Em "configuração", defina "parsingMode" se os arquivos devem ser mapeados para vários documentos de pesquisa ou se eles consistem em texto sem formatação, documentos JSON ou arquivos CSV.
Especifique mapeamentos de campo se houver diferenças no nome ou tipo de campo ou se você precisar de várias versões de um campo de origem no índice de pesquisa.
Na indexação de arquivos, muitas vezes você pode omitir mapeamentos de campo porque o indexador tem suporte interno para mapear as propriedades de "conteúdo" e metadados para campos nomeados e digitados de forma semelhante em um índice. Para as propriedades de metadados, o indexador substitui automaticamente os hifens
-por sublinhados no índice de pesquisa.
Para obter mais informações sobre outras propriedades, crie um indexador. Para obter a lista completa de descrições de parâmetro, consulte Criar Indexador (REST) na API REST. Os parâmetros são os mesmos para Microsoft OneLake.
Por padrão, um indexador é executado automaticamente quando você o cria. Você pode alterar esse comportamento definindo "desabilitado" como true. Se você criar um indexador em um estado desabilitado, execute um indexador sob demanda quando estiver pronto para usá-lo ou coloque-o em um agendamento.
Verificar o status do indexador
Conheça várias abordagens para monitorar o status do indexador e o histórico de execução aqui.
Tratar erros
Os erros que normalmente ocorrem durante a indexação incluem tipos de conteúdo sem suporte, conteúdo ausente ou arquivos superdimensionados. Por padrão, o indexador de arquivos OneLake é interrompido assim que encontra um arquivo com um tipo de conteúdo sem suporte. No entanto, talvez você queira que a indexação prossiga mesmo se ocorrerem erros e, em seguida, depure documentos individuais mais tarde.
Erros transitórios são comuns para soluções que envolvem várias plataformas e produtos. No entanto, se você mantiver o indexador em um cronograma (por exemplo, a cada 5 minutos), o indexador deverá ser capaz de se recuperar desses erros na próxima execução.
Há cinco propriedades de indexador que controlam a resposta do indexador quando ocorrem erros.
{
  "parameters" : {
    "maxFailedItems" : 10,
    "maxFailedItemsPerBatch" : 10,
    "configuration" : {
        "failOnUnsupportedContentType" : false,
        "failOnUnprocessableDocument" : false,
        "indexStorageMetadataOnlyForOversizedDocuments": false
    }
  }
}
| Parâmetro | Valores válidos | Descrição |
|---|---|---|
| "maxFailedItems" | -1, nulo ou 0, inteiro positivo | Continue a indexação se ocorrerem erros em qualquer ponto de processamento, ao analisar blobs ou ao adicionar documentos a um índice. Defina essas propriedades como o número de falhas aceitáveis. Um valor de -1 permite o processamento, não importa quantos erros ocorram. Caso contrário, o valor será um inteiro positivo. |
| "maxFailedItemsPerBatch" | -1, nulo ou 0, inteiro positivo | O mesmo que acima, mas usado para indexação em lote. |
| "failOnUnsupportedContentType" | verdadeiro ou falso | Se o indexador não conseguir determinar o tipo de conteúdo, especifique se o trabalho deve continuar ou falhar. |
| "falhaEmDocumentoIrreprocessável" | verdadeiro ou falso | Caso o indexador não consiga processar um documento de um tipo de conteúdo que, de outra forma, teria suporte, especifique se o trabalho deve continuar ou falhar. |
| "indexStorageMetadataOnlyForOversizedDocuments" | verdadeiro ou falso | Blobs superdimensionados são tratados como erros por padrão. Se você definir esse parâmetro como true, o indexador tentará indexar seus metadados mesmo que o conteúdo não possa ser indexado. Para obter limites no tamanho do blob, consulte limites de serviço. |
Próximas etapas
Examine como o assistente de importação de dados funciona e experimente-o para este indexador. Você pode usar a vetorização integrada para agrupar e criar inserções para pesquisa vetor ou híbrida usando um esquema padrão.