Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Podczas tworzenia usługi Foundry IQ należy wybrać model cenowy i warstwę usług. Usługa Foundry IQ (Wyszukiwanie AI platformy Azure) oferuje dwa modele cenowe, z których każdy jest odpowiedni dla różnych wzorców obciążeń, ze skojarzonymi warstwami usług, które określają pojemność i funkcje:
| Model ustalania cen | Najlepsze dla | Jak są naliczane opłaty |
|---|---|---|
| Dedykowana | Stałe, przewidywalne, wysokie wykorzystanie obciążeń | Stała pojemność przy użyciu jednostek wyszukiwania (SU); stawka godzinowa zależna od wyboru warstwy usługi |
| Serverless | Sporadyczne, skokowe lub bardzo zmienne obciążenia | Rozliczane na podstawie użycia: mierzone za pomocą jednostek obliczeniowych (CUs) i indeksowanej pamięci masowej (GB/miesiąc) |
Uwaga
Jednostki wyszukiwania (SU) w modelu dedykowanym i jednostki obliczeniowe (CU) w modelu bezserwerowym to nie to samo i nie mogą być używane zamiennie. Nie używaj kalkulatorów cen opartych na jednostkach SU ani szacunków dla obciążeń bezserwerowych.
Oba modele zapewniają podstawowe funkcje wyszukiwania, ale obsługa sieci, sposób wykonywania i limity różnią się. Przejrzyj dostępność funkcji według warstwy i limity usług dla obciążenia.
Wybranie dedykowanego modelu cenowego wymaga oszacowania potrzeb związanych z obciążeniem, a następnie wybrania warstwy usługi z odpowiednią wstępnie aprowizowaną pojemnością.
Wybranie modelu cen bezserwerowego nie wymaga wybrania wstępnie aprowizowanej warstwy usługi, ale korzysta z cen opartych na użyciu, więc optymalizacja wydajności będzie bezpośrednio wpływać na koszty.
W przypadku prywatnego pozyskiwania danych postępuj zgodnie z wymaganiami dotyczącymi warstwy i konfiguracji specyficznymi dla źródła. Ogólne uprawnienia indeksatora nie oznaczają obsługi zarządzanego źródła wiedzy.
Model cen bezserwerowy
Ważna
Rozliczenia dla warstwy bezserwerowej rozpoczęły się 13 września 2026 r. Opłaty za użycie w dniu lub po tej dacie są wyświetlane na fakturze Azure. Opłaty za użycie nie są naliczane przed 13 września 2026 r.
Warstwa cenowa Bezserwerowa nie obsługuje migracji do innych warstw cenowych ani z nich.
Model cenowy Serverless to oferta rozliczana na podstawie zużycia, która automatycznie skaluje zasoby obliczeniowe i pamięć masową w zależności od obciążenia. Eliminuje to konieczność aprowizacji pojemności z góry, co pozwala płacić tylko za używane zasoby.
W przypadku korzystania z modelu bezserwerowego nie konfigurujesz replik, partycji ani jednostek wyszukiwania. Zamiast tego usługa dynamicznie zarządza pojemnością w odpowiedzi na wolumin zapytań, aktywność indeksowania i złożoność obciążenia.
Każda usługa bezserwerowa ma umowę o gwarantowanym poziomie usług odczytu/zapisu (SLA) przez cały okres istnienia.
Rozliczenia są oparte na dwóch podstawowych wymiarach:
- Użycie zasobów obliczeniowych: mierzone w jednostkach obliczeniowych na godzinę (CU/h) i naliczane opłaty na podstawie wykonanej pracy (zapytania, indeksowanie i inne operacje).
- Indeksowana pamięć masowa: opłata za GB miesięcznie na podstawie rozmiaru indeksów.
Usługa Serverless jest przeznaczona do obsługi obciążeń o zmiennym zapotrzebowaniu, w tym gwałtownych skoków ruchu i aplikacji wielodostępnych. Obsługuje on te same podstawowe funkcje wyszukiwania i interfejsy API co usługi dedykowane, dzięki czemu można tworzyć i uruchamiać aplikacje wyszukiwania bez ponownego pisania kodu.
Serverless nie obsługuje wykonywania prywatnego indeksatora ani wychodzących udostępnionych łączy prywatnych. Użyj konfiguracji granicy zabezpieczeń sieci dla obsługiwanych kontroli dostępu do publicznego punktu końcowego. Strefa ochronna nie tworzy łączności prywatnej. Obsługa przychodzącego prywatnego punktu końcowego jest oddzielną kwestią.
Aby dowiedzieć się więcej, zobacz Limity usług w usłudze Foundry IQ.
Jeśli jesteś dużym klientem, dużą firmą lub niezależnym dostawcą oprogramowania (ISV) z wymaganiami dotyczącymi obciążeń na dużą skalę, skontaktuj się z Microsoft przy użyciu formularza kontaktowego klienta usługi Serverless. Przykłady obejmują wielodzierżawne aplikacje SaaS i większe aplikacje, które osiągają limity usługi Serverless.
Dedykowany model cen
Dedykowany model cenowy to oferta oparta na przydzielonej pojemności, która zapewnia przewidywalną wydajność i koszty poprzez przypisanie stałej infrastruktury do Twojego obciążenia roboczego. Możesz skonfigurować pojemność z góry, umożliwiając usłudze obsługę spójnych żądań indeksowania i zapytań z gwarantowanymi zasobami.
W przypadku warstw dedykowanych jawnie konfigurujesz repliki, partycje i jednostki wyszukiwania (SU). Repliki zapewniają przepływność zapytań i wysoką dostępność, podczas gdy partycje definiują pojemność magazynu i indeksowania. Razem określają one łączną pojemność i charakterystykę wydajnościową usługi Foundry IQ.
Rozliczenia są oparte na:
- Warstwa cenowa usługi: wstępnie wybrana skonfigurowana pojemność.
- Jednostki wyszukiwania (SU): jednostka rozliczeniowa dla usług dedykowanych obliczana jako repliki × partycje. Płacisz stałą stawkę godzinową na podstawie liczby jednostek wyszukiwania i wybranej warstwy usługi.
Ten model jest przeznaczony dla obciążeń ze stałym, przewidywalnym zapotrzebowaniem, w którym ważne jest spójne działanie, małe opóźnienia i kontrolowane skalowanie.
W modelu cen dedykowanej wybrana warstwa usługi określa:
- Maksymalna liczba indeksów i innych obiektów dozwolonych w usłudze.
- Rozmiar i szybkość partycji (magazyn fizyczny).
- Rozliczana stawka jako koszt stały miesięczny, ale także koszt przyrostowy w przypadku dodawania pojemności.
- Charakterystykę obciążenia. Niektóre warstwy są zoptymalizowane pod kątem określonych obciążeń.
W niektórych przypadkach warstwa określa również dostępność funkcji Premium.
Opisy warstw
Najczęściej używane warstwy rozliczane to:
Basic obsługuje obciążenia produkcyjne i może spełniać wymagania umowy SLA z maksymalnie trzema replikami.
Warstwa Standardowa (S1, S2, S3) jest warstwą domyślną. Obsługuje ona skalowanie partycji i replik, umożliwiając większe obciążenia i lepszą wydajność.
Niektóre warstwy są przeznaczone dla niektórych typów pracy:
Standard 3 High Density (S3 HD) to tryb hostingu S3 zoptymalizowany pod kątem wielodzierżawności. Usługa S3 HD ma takie same opłaty za jednostkę co S3, ale obsługuje dużą liczbę mniejszych indeksów i używa sprzętu zoptymalizowanego pod kątem szybkich odczytów plików i scenariuszy magazynowania o wysokiej gęstości.
Warstwy zoptymalizowane pod kątem pamięci masowej (L1, L2) zapewniają niższy koszt pamięci masowej na TB i są przeznaczone dla dużych, rzadziej aktualizowanych indeksów. Te warstwy zwykle mają większe opóźnienie zapytań.
Dostępna jest również bezpłatna, ograniczona warstwa usługi Foundry IQ:
- Usługa Free tworzy ograniczoną usługę Foundry IQ dla małych projektów, takich jak samouczki i tworzenie. Zasoby są współdzielone między dzierżawami, a skalowanie nie jest obsługiwane. Niektóre funkcje w warstwie Premium są niedostępne, a usługa może zostać usunięta po okresach braku aktywności. Możesz mieć tylko jedną bezpłatną usługę Foundry IQ na subskrypcję Azure.
Stawki rozliczeniowe są widoczne w portalu Azure podczas tworzenia nowej usługi Foundry IQ na stronie Wybieranie warstwy cenowej.
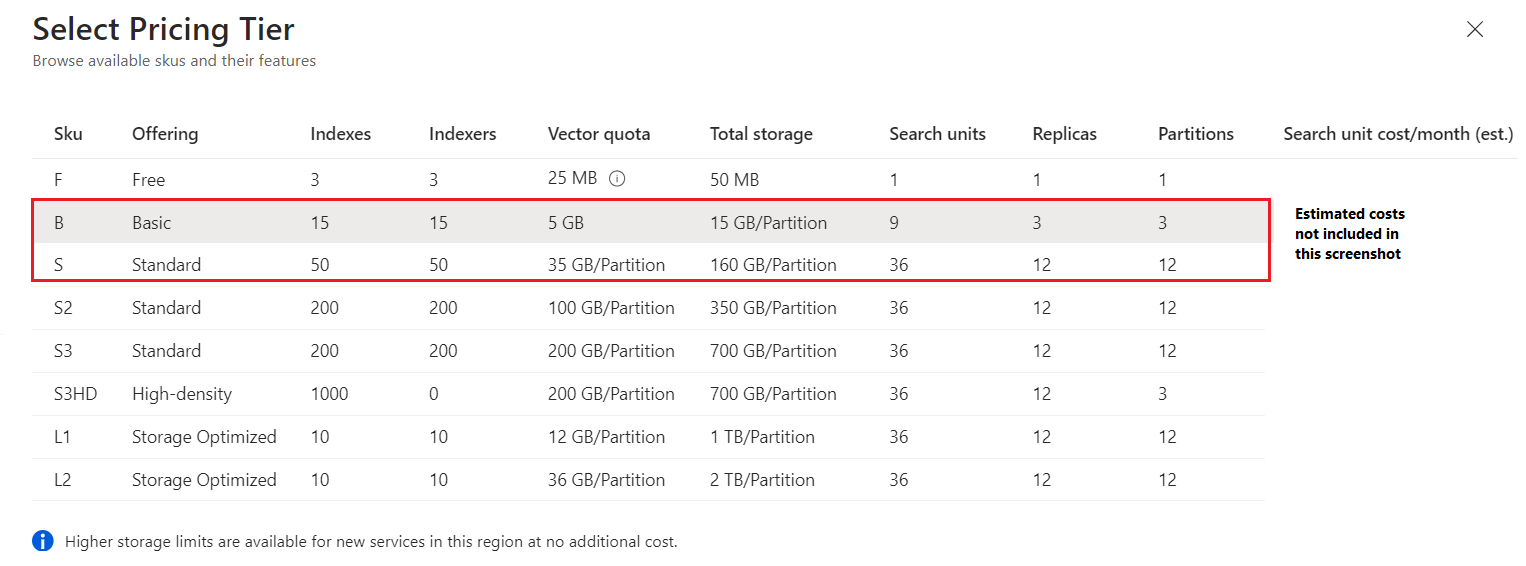
Możesz sprawdzić stronę z cennikiem, aby zobaczyć stawki regionalne.
Zapoznaj się z tematem Planowanie kosztów i zarządzanie kosztami , aby dowiedzieć się więcej na temat modelu cen dedykowanego i sposobu jego porównywania z modelem bezserwerowym.
Sprawdź Limity usługi w Foundry IQ, aby poznać limity pamięci masowej, obciążeń roboczych i liczby obiektów dla poszczególnych warstw.
Jak wybrać warstwę
W portalu Azure warstwy usług są określone w Wybierz warstwę cenową strony podczas tworzenia usługi.
W programie PowerShell lub interfejsie wiersza polecenia platformy Azure warstwa jest określana za pomocą parametru -Sku .
Dostępność regionów według warstwy
Lista regionów zawiera lokalizacje, w których usługa Foundry IQ jest dostępna. Niektóre regiony mogą mieć ograniczenia pojemności dla niektórych warstw usług, co uniemożliwia tworzenie nowych usług Foundry IQ w tych warstwach usług. Lista używa przypisów dolnych do wskazywania ograniczonych regionów i warstw.
Podczas tworzenia usługi Foundry IQ w portalu Azure niedostępne kombinacje regionów i warstw są automatycznie wykluczane.
Dostępność funkcji według warstwy
Większość funkcji jest dostępna we wszystkich warstwach. W niektórych przypadkach dostępność funkcji zależy od wybranej warstwy:
| Funkcja | Zagadnienia dotyczące warstw |
|---|---|
| indeksatory | Indeksatory w usługach S3 HD i bezserwerowych są ogólnie dostępne w 2026-10-01, ze wspólnym skumulowanym limitem czasu wykonywania. Indeksatory mają więcej ograniczeń w warstwie Bezpłatna. |
parametr konfiguracji indeksatora executionEnvironment |
Przypinanie prywatne wymaga kwalifikującej się usługi S2 lub nowszej dedykowanej, z wyłączeniem usługi S3 HD. S3 HD i Serverless korzystają wyłącznie z wykonywania wielodostępnego. Zobacz kwalifikowalność środowiska wykonawczego. |
| Wzbogacanie sztucznej inteligencji | Działa w warstwie Bezpłatna, ale nie jest zalecana w przypadku dużych obciążeń. |
| Tożsamości zarządzane lub zaufane na potrzeby dostępu wychodzącego (indeksatora) | Niedostępne w warstwie Bezpłatna. |
| Klucze szyfrowania zarządzane przez klienta | Niedostępne w warstwie Bezpłatna. |
| Dostęp do zapory IP | Niedostępne w warstwie Bezpłatna. |
| Prywatny punkt końcowy (integracja z Azure Private Link) | Prywatne punkty końcowe ruchu przychodzącego usługi Search nie są dostępne w warstwie Bezpłatna. Współdzielone prywatne linki wychodzące usługi Search nie są dostępne w warstwie Bezpłatna, S3 HD ani Bezserwerowa. Zwykły S3 różni się od S3 HD. Uprawnienia do zestawu umiejętności zależą również od obciążenia, regionu i daty utworzenia usługi; zobacz wymagania wstępne dotyczące udostępnionego łącza prywatnego. |
| Strefy dostępności | Niedostępne w warstwie Bezpłatna. |
| Reranker semantyczny | Działa w warstwie Bezpłatna, ale nie jest zalecana w przypadku dużych obciążeń. |
Funkcje intensywnie korzystające z zasobów mogą nie działać prawidłowo, chyba że zapewnisz jej wystarczającą pojemność. Na przykład wzbogacanie AI ma długotrwałe umiejętności, które mogą przekroczyć limit czasu usługi darmowej, chyba że zestaw danych jest mały.
Górne limity
Warstwy określają maksymalną przestrzeń magazynową usługi, a także maksymalną liczbę indeksów, indeksatorów, źródeł danych, zestawów umiejętności i map synonimów, które można utworzyć. Aby zapoznać się z pełnym podziałem wszystkich limitów, zobacz Limity usługi w usłudze Foundry IQ.
Rozmiar partycji i szybkość
Cennik warstwowy zawiera szczegółowe informacje o magazynie na partycję, które wahają się od 15 GB dla warstwy Podstawowej do 2 TB dla warstw zoptymalizowanych pod kątem magazynowania (L2). Inne cechy sprzętu, takie jak szybkość operacji, opóźnienia i szybkość transferu, nie są publikowane, ale warstwy przeznaczone dla określonych architektur rozwiązań są oparte na sprzęcie, który ma funkcje do obsługi tych scenariuszy. Aby uzyskać więcej informacji na temat partycji, zobacz Szacowanie pojemności i niezawodność oraz zarządzanie nią w artykule IQ usługi Foundry.
Uwaga
Partycje o większej pojemności stały się dostępne w wybranych regionach w kwietniu 2024 r. Druga fala partycji o wyższej pojemności została wydana w maju 2024 r. Jeśli masz starszą usługę IQ rozwiązania Foundry, możesz uaktualnić usługę , aby korzystać z większej pojemności przy użyciu tej samej stawki rozliczeniowej.
Stawki rozliczeniowe
Warstwy mają różne stawki rozliczeniowe, z wyższymi stawkami dla warstw, które działają na droższym sprzęcie lub oferują droższe funkcje. Stawkę rozliczeń warstwy można znaleźć na stronach cenowych Azure dla usługi Foundry IQ.
Po utworzeniu usługi stawka rozliczeniowa staje się zarówno stałym kosztem uruchamiania usługi przez całą dobę, jak i kosztem przyrostowym , jeśli zdecydujesz się dodać więcej pojemności.
W modelu dedykowanym rozliczanie opiera się na jednostkach wyszukiwania (SU), które łączą partycje (pamięć masowa) i repliki (wydajność obsługi zapytań).
- Usługa rozpoczyna się od jednej partycji i jednej repliki (jednej jednostki SU)
- Dodawanie partycji lub replik zwiększa koszty liniowo wraz z liczbą jednostek SU
Na przykład dodanie replik w celu zwiększenia dostępności lub przepływności zwiększa proporcjonalnie koszt miesięczny.
Aby uzyskać więcej informacji, zobacz Planowanie kosztów i zarządzanie nimi.
Przykład stawki rozliczeniowej
Poniższy przykład stanowi ilustrację. Załóżmy hipotetyczną stawkę rozliczeniową w wysokości 100 USD miesięcznie. Jeśli utrzymasz usługę Foundry IQ na początkowym poziomie pojemności jednej partycji i jednej repliki, możesz oczekiwać, że na koniec miesiąca zapłacisz 100 USD. Jeśli jednak dodasz dwie dodatkowe repliki, aby uzyskać wysoką dostępność, koszty miesięczne wzrosną do 300 USD (100 USD za pierwszą parę repliki-partycji, a następnie 200 USD za dwie repliki).
Zmiany poziomów
Uwaga
Istniejące usługi Foundry IQ można przełączać między warstwami Podstawowa i Standardowa (S1, S2 i S3). Bieżąca konfiguracja usługi nie może przekroczyć limitów warstwy docelowej, a region nie może mieć ograniczeń pojemności w warstwie docelowej. Aby uzyskać więcej informacji, zobacz Zmienianie warstwy cenowej.
Aby przełączyć się na inny poziom niż te wymienione wcześniej:
- Utwórz usługę Foundry IQ w nowej warstwie cenowej.
- Wdróż zawartość wyszukiwania w nowej usłudze. Postępuj zgodnie z tą listą kontrolną , aby upewnić się, że masz całą zawartość.
- Usuń starą usługę, gdy masz pewność, że nie jest już potrzebna.
W przypadku dużych indeksów, których nie chcesz ponownie kompilować od podstaw, użyj jednej z następujących przykładów kopii zapasowej i przywracania:
- Przykład tworzenia kopii zapasowej i przywracania (C#)
- Przykład tworzenia kopii zapasowej i przywracania (Python)
- Przykład tworzenia kopii zapasowej i przywracania dla bardzo dużych indeksów (Python)
Następne kroki
Najlepszym sposobem wyboru planu cenowego jest rozpoczęcie od najtańszego planu, a następnie pozwolenie, aby doświadczenie i testowanie kierowały decyzją o utrzymaniu usługi lub przejściu na wyższy plan.
W przypadku kolejnych kroków zalecamy utworzenie usługi Foundry IQ w warstwie, która może obsłużyć planowany zakres testów, a następnie zapoznanie się z następującymi wskazówkami dotyczącymi szacowania kosztów i pojemności: