Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Note
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Usługa Foundry IQ (Wyszukiwanie AI platformy Azure) oferuje opcje cenowe bezserwerowe i dedykowane przeznaczone dla różnych wzorców obciążeń:
Dedicated: stałe ceny mierzone w jednostkach wyszukiwania (SU). Wybierasz warstwę usługi, a opłata jest naliczana co godzinę na podstawie liczby przydzielonych jednostek.
Bezserwerowe: ceny oparte na użyciu mierzone według jednostek obliczeniowych na godzinę (CU/hr) i na GB/miesiąc dla indeksowanego magazynu.
Ważna
Rozliczenia dla warstwy bezserwerowej rozpoczęły się 13 września 2026 r. Opłaty za użycie w dniu lub po tej dacie są wyświetlane na fakturze Azure. Opłaty za użycie nie są naliczane przed 13 września 2026 r.
Warstwa Bezserwerowa nie obsługuje migracji do innych warstw cenowych ani z innych warstw cenowych.
Aby uzyskać więcej informacji na temat różnic w modelu cenowym i warstwie usług, zobacz Wybieranie modelu cenowego i warstwy usług.
Sposób określania kosztów w modelu bezserwerowym
Modele cenowe Dedykowane i Bezserwerowe uwzględniają pracę w usłudze IQ rozwiązania Foundry inaczej. Usługi dedykowane uruchamiają zapytania, indeksowanie i przetwarzanie wyników w ramach aprowizowanej pojemności, która została już zakupiona. Usługi bezserwerowe mierzą operacje obliczeniowe, pamięci i we/wy dysku, z których te operacje korzystają i konwertują to użycie na jednostki obliczeniowe (CU). W związku z tym optymalizacja wydajności bezpośrednio wpływa na koszt bezserwerowy.
Koszty bezserwerowe są powiązane z wykonywaniem obciążenia:
- Zapytania i indeksowanie zużywają obliczenia mierzone w jednostkach obliczeniowych na godzinę (CU/h).
- Aktywne indeksy zużywają moc obliczeniową w zależności od stopnia wykorzystania zasobów i tego, jak długo pozostają aktywne.
- Indeks pozostaje aktywny przez 10 minut po ostatnim żądaniu zapytania lub indeksowania, zanim przejdzie on jako nieaktywny.
- Nieaktywne indeksy nie mają minimalnej ani zarezerwowanej opłaty za zasoby obliczeniowe. Użycie zasobów obliczeniowych dla nieaktywnych indeksów jest skalowane do zera. Nie ma minimalnej opłaty za zasoby obliczeniowe, gdy indeks jest nieaktywny.
- Opłaty za pamięć masową są naliczane oddzielnie na podstawie rozmiaru indeksu na dysku i obowiązują niezależnie od tego, czy indeks jest używany.
- Wyszukiwanie agentowe zużywa zasoby obliczeniowe na potrzeby zapytań wyszukiwania i orkiestracji wykonywanej wewnątrz usługi IQ rozwiązania Foundry.
Opłaty za przechowywanie przestają być naliczane dopiero po usunięciu indeksu.
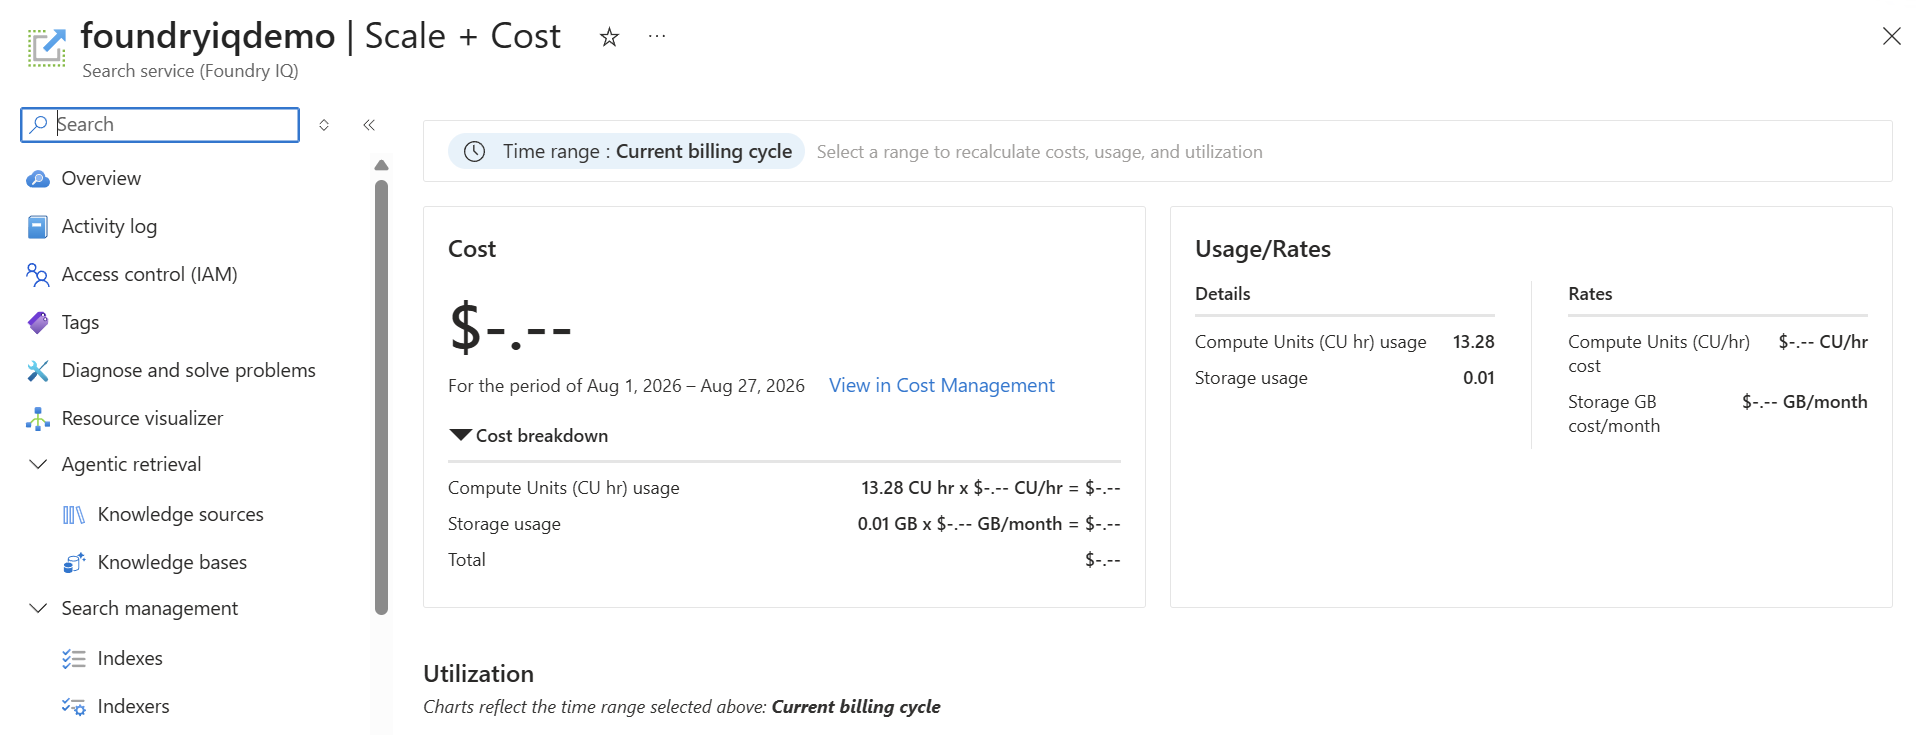
Aby wyświetlić podział kosztów i stawki użycia dla bieżącego cyklu rozliczeniowego, wyświetl kartę Skala i koszt w portalu Azure.
Jak rozmiar indeksu wpływa na użycie zasobów obliczeniowych
Chociaż indeks jest aktywny, funkcja IQ usługi Foundry ocenia dwa skończone zasoby w celu określenia użycia zasobów obliczeniowych:
- Całkowity rozmiar indeksu: ilość miejsca zajmowana przez indeks na dysku, w tym tekst, metadane i wektory.
- Rozmiar indeksu wektorowego: pamięć używana przez indeks wektorowy. Pamięć jest bardziej zasobochłonna niż dysk, dlatego rozmiar indeksu wektorowego ma większą wagę przy przeliczaniu na jednostki CU.
Foundry IQ nie dodaje do siebie dwóch wynikowych wartości CU. Użycie zasobów obliczeniowych zależy od tego, która kwota jest wyższa. Na przykład rozmiar indeksu wektorowego może określać użycie obliczeniowe nawet wtedy, gdy całkowity rozmiar indeksu na dysku jest stosunkowo mały.
Aby zmniejszyć użycie zasobów obliczeniowych aktywnego indeksu, zidentyfikuj, który zasób generuje wyższą kwotę cu. Następnie zmniejsz całkowity rozmiar indeksu, rozmiar indeksu wektorowego lub oba te elementy. Indeksowany magazyn pozostaje oddzielną opłatą za GB/miesiąc.
Model cen bezserwerowy jest najbardziej opłacalny w przypadku obciążeń ze zmiennymi, sporadycznymi lub nieprzewidywalnymi ruchem, gdzie aprowizowana pojemność byłaby niedostatecznie wykorzystywana.
Ważna
Opłaty za bezserwerowe jednostki CU obejmują pracę wykonywaną w usłudze Foundry IQ, w tym zapytania, indeksowanie, przetwarzanie wyników i orkiestrację agentowego pobierania. Wywołania modelu i inne zadania wykonywane poza usługą IQ rozwiązania Foundry nadal korzystają z istniejących mierników rozliczeniowych. Przykłady obejmują klasyfikację semantyczną, ponowne zapisywanie zapytań agentów, wyodrębnianie obrazów i wykonywanie umiejętności.
Omówienie jednostek obliczeniowych (CU)
Jednostka obliczeniowa (CU) reprezentuje mierzone zasoby systemowe wymagane do wykonywania operacji wyszukiwania i indeksowania w modelu bezserwerowym. Koszt CU zależy głównie od wykorzystania procesora CPU, pamięci i operacji wejścia/wyjścia, a w drugiej kolejności od rozmiaru indeksu i rozmiaru ładunku dokumentu, przy czym użycie jest rozliczane w jednostkach Compute Unit na godzinę (CU/h).
Obliczanie skalowania kosztów za pomocą:
- Złożoność zapytań
- Rozmiar indeksu (GB) i struktura
- Rozmiar ładunku dokumentu (KB)
- Liczba pól i pobranych wyników
Różne operacje mają różne profile kosztów:
- Odczyt: niski koszt. Pobieranie pojedynczego dokumentu według jego identyfikatora jest najbardziej wydajną operacją.
- Wyszukiwanie słów kluczowych: niski koszt. Wyszukiwanie tekstu używa odwróconych indeksów, które są zoptymalizowane pod kątem szybkości i niskiego użycia zasobów obliczeniowych.
- Wyszukiwanie wektorów: wysoki koszt. Zapytania wektorowe są kosztowne obliczeniowo, ponieważ wymagają obliczeń podobieństwa w wielowymiarowych osadzaniach. W porównaniu z wyszukiwaniem słów kluczowych zużywają znacznie więcej zasobów obliczeniowych.
- Wyszukiwanie hybrydowe: łączy koszt wyszukiwania słów kluczowych i wyszukiwania wektorowego, ponieważ oba potoki są uruchamiane dla każdego zapytania, oraz niewielkie dodatkowe obciążenie związane z Reciprocal Rank Fusion (RRF) w celu scalenia wyników.
Monitorowanie użycia zasobów obliczeniowych
Gdy obsługiwane żądanie synchroniczne zwraca nagłówek odpowiedzi x-ms-azs-compute-units-consumed, wartość oznacza wykorzystanie zasobów przez żądanie w godzinach jednostki obliczeniowej (CU-hours). Użyj tych wartości, aby porównać operacje i zoptymalizować wzorce zapytań.
Odpowiedź na asynchroniczne uruchomienie indeksatora potwierdza akceptację, a nie zakończenie. Nagłówek odpowiedzi nie raportuje pełnego zużycia jednostek CU przez wykonanie w tle. Aby zapoznać się z monitorowaniem indeksatora, zobacz Monitorowanie obliczeń indeksatora. Aby uzyskać ogólne opcje monitorowania, zobacz Monitor Foundry IQ.
-
Nagłówek:
x-ms-azs-compute-units-consumed: <value> - Wartość: liczba godzin CU zużytych przez żądanie, wyświetlana z dokładnością do dziewięciu miejsc po przecinku.
Example:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 0.000066667
W tym przykładzie żądanie zużywało 0,00006666667 CU-hours. Tej wartości można użyć do identyfikowania operacji o wysokim koszcie i porównywania względnego kosztu różnych wzorców zapytań.
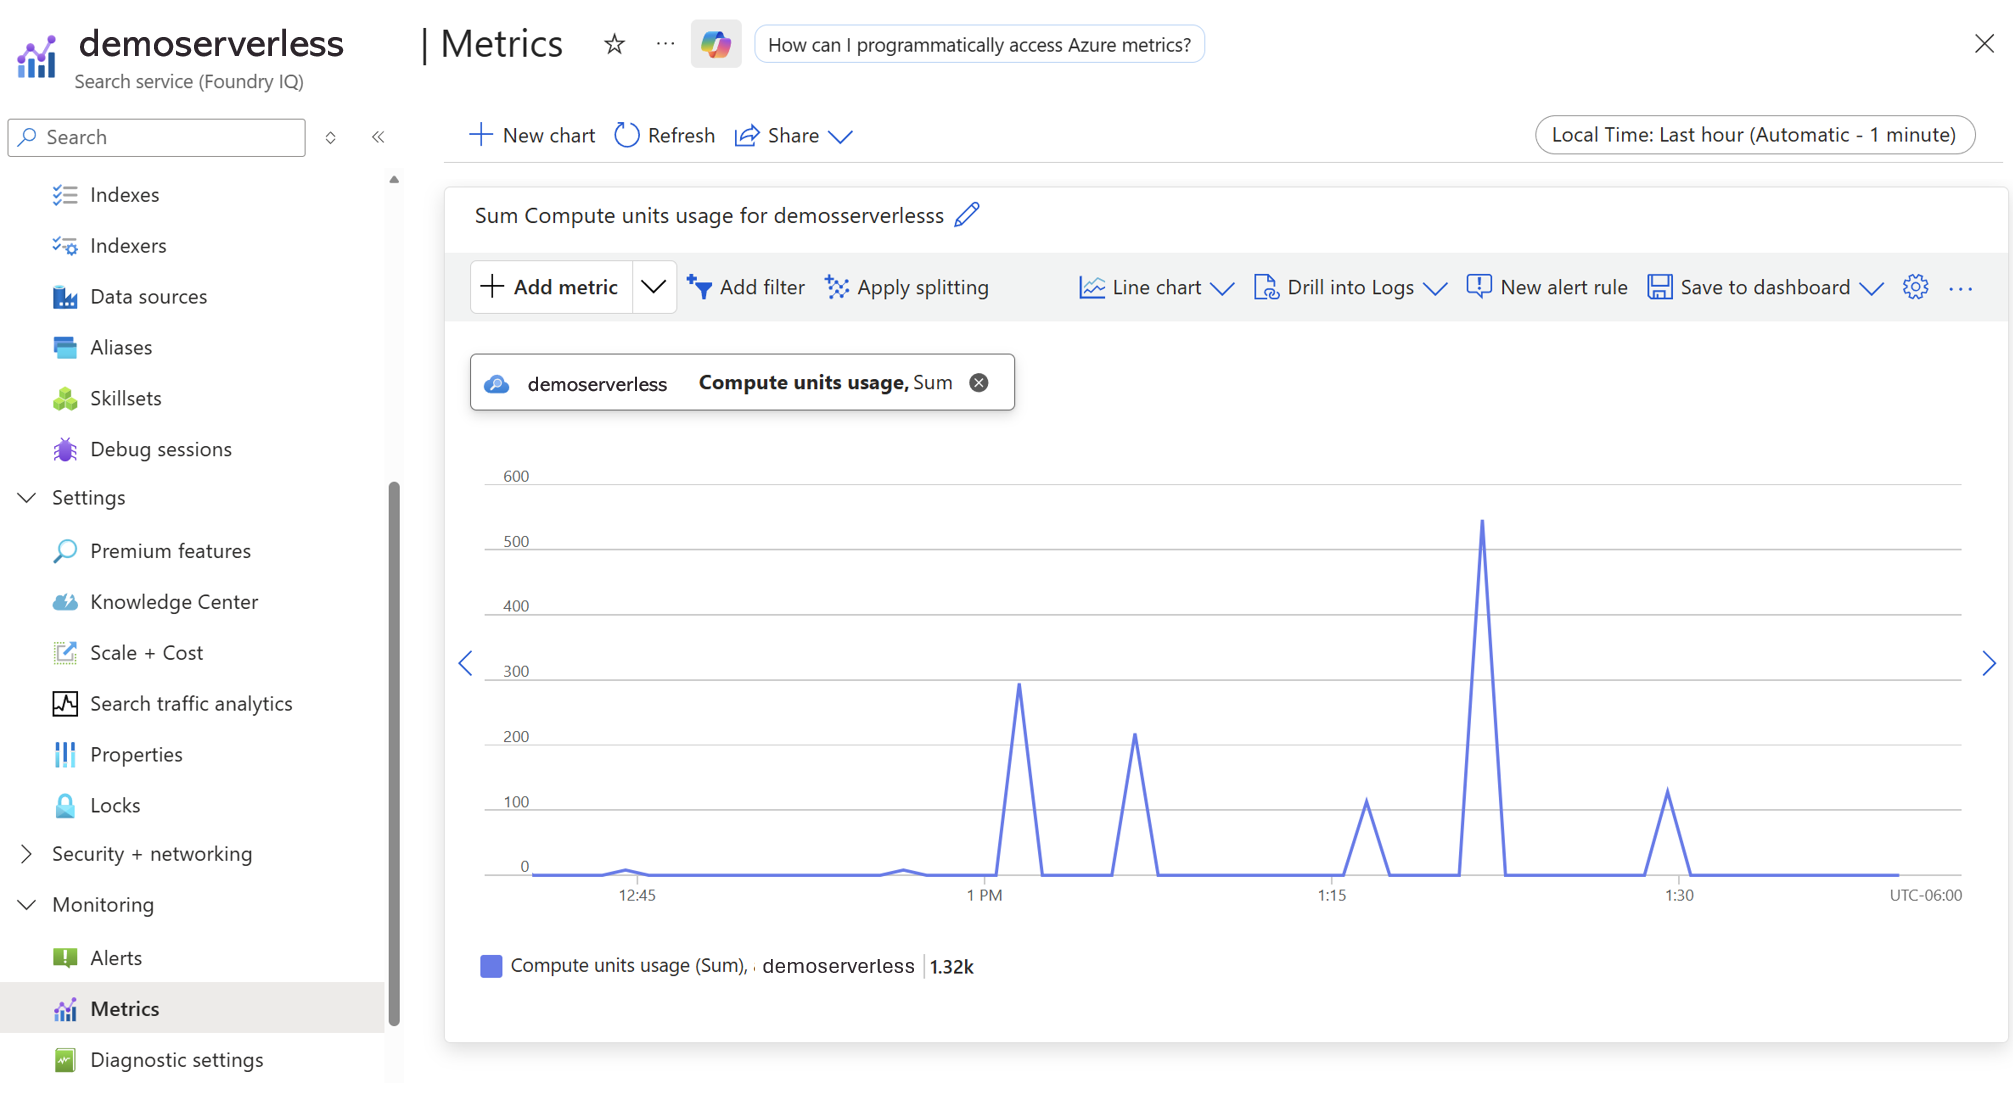
Aby przejrzeć historyczne użycie zasobów obliczeniowych dla bezserwerowej usługi Foundry IQ, użyj metryk Azure Monitor w Azure Portal:
- Przejdź do usługi Foundry IQ.
- Wybierz pozycję Metryki.
- Wybierz + Dodaj metrykę.
- Z listy metryk wybierz pozycję Użycie jednostek obliczeniowych.
- Użyj wykresu, aby przeanalizować trendy użycia i zidentyfikować okresy zwiększonego użycia zasobów obliczeniowych.
Monitorowanie zagregowanego użycia pomaga zrozumieć ogólne koszty usług i zidentyfikować obciążenia, które zużywają najwięcej zasobów obliczeniowych. Opisy dostępnych metryk monitorowania można znaleźć w temacie Monitoring Data Reference (Dokumentacja danych monitorowania). Za pomocą dzienników usługi Azure Monitor można śledzić łączne użycie CU w czasie i korelować je z wolumenem zapytań i zmianami obciążenia.
Konfigurowanie alertów dotyczących użycia zasobów obliczeniowych
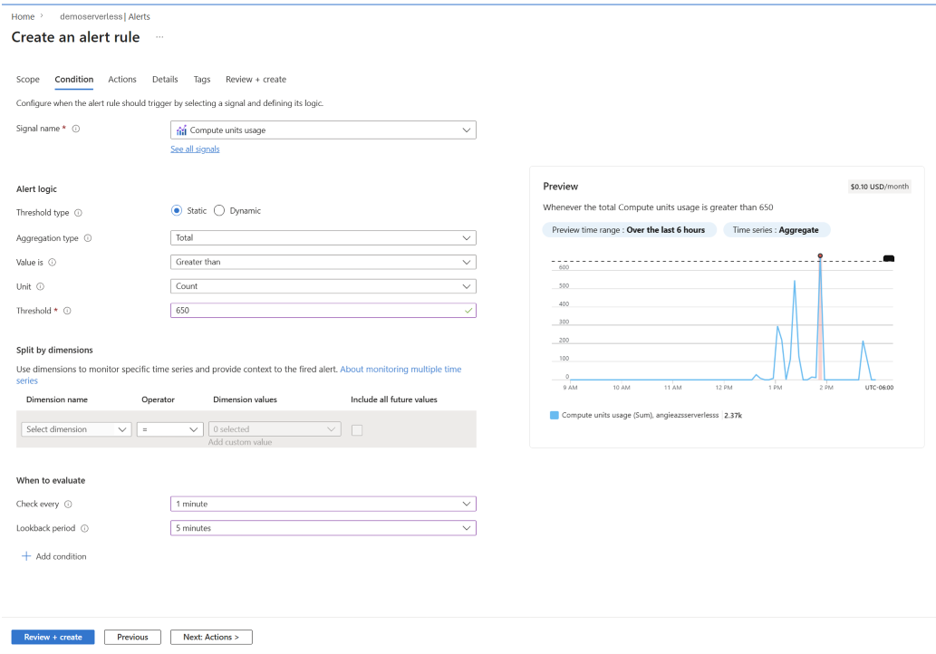
Regułę alertu można utworzyć, aby otrzymywać powiadomienia, gdy użycie zasobów obliczeniowych osiągnie określony próg w portalu Azure.
- Przejdź do pozycji Alerty w usłudze Foundry IQ.
- Wybierz + Utwórz regułę alertu.
- W sekcji Warunek wybierz Użycie jednostek obliczeniowych jako sygnał.
- Zdefiniuj logikę alertu. Na przykład wyzwalacz, gdy łączne użycie jest większe niż określona wartość.
- Skonfiguruj Akcje, takie jak powiadomienia e-mail, SMS lub webhook.
- Wykonaj pozostałe kroki i wybierz pozycję Przejrzyj i utwórz.
Alerty pomagają aktywnie reagować na nieoczekiwane wzrosty użycia i zarządzać kosztami.
Szacowanie kosztów bezserwerowych
Kalkulator cen platformy Azure i wskazówki dotyczące planowania pojemności opartego na jednostkach wyszukiwania (SU) nie mają zastosowania do usług korzystających z bezserwerowego modelu cenowego.
Aby oszacować koszty bezserwerowe:
- Przykładowe dane reprezentatywne dla indeksu.
- Uruchamianie typowych obciążeń indeksowania i wykonywania zapytań.
- Zarejestruj wartość zwróconą
x-ms-azs-compute-units-consumeddla każdej operacji. - Użyj metryk usługi Azure Monitor, aby mierzyć łączne użycie w czasie.
- Ekstrapoluj koszty na podstawie oczekiwanego ruchu produkcyjnego.
Użyj karty Skala i koszt w portalu Azure, aby wyświetlić bieżące użycie i szacować koszty.
Ponieważ to samo żądanie wykonywane względem tych samych danych zwykle generuje podobne zużycie zasobów obliczeniowych, reprezentatywne obciążenia mogą zapewnić niezawodną podstawę do szacowania kosztów.
Użycie bezserwerowe jest mierzone w sposób ciągły i agregowany na potrzeby rozliczeń. Użycie zasobów obliczeniowych jest śledzone przez całą minutę i emitowane tylko wtedy, gdy są używane zasoby obliczeniowe.
Podczas szacowania kosztów użyj wartości opłat za żądania, aby zrozumieć koszt poszczególnych operacji, oraz metryk usługi Azure Monitor, aby zrozumieć ogólne wzorce korzystania z usługi.
Użyj obu źródeł danych razem, aby zrozumieć koszty: dane dotyczące opłat za żądanie ułatwiają ocenę poszczególnych operacji, a metryki Azure Monitor pomagają zrozumieć zagregowane użycie usług w czasie. Aby uzyskać pełny obraz kosztów, należy również uwzględnić funkcje rozliczane oddzielnie od jednostek obliczeniowych.
Rozliczenia są oparte na agregowanym użyciu obliczeniowym, a nie na pojedynczych żądaniach. Użycie jest mierzone w interwałach jednominutowych. Te interwały gromadzą się w ciągu godziny w celu określenia rozliczanej ilości CU/godzinę. Wewnętrznie wykorzystanie jest agregowane z milijednostek obliczeniowych (mCU) do jednostek obliczeniowych (CU) i przeliczane na wykorzystanie godzinowe raportowane do celów rozliczeniowych.
Różne operacje zużywają różne ilości zasobów obliczeniowych. Ogólnie rzecz biorąc:
- Wyszukiwanie słów kluczowych zwykle używa najmniejszych zasobów obliczeniowych.
- Wyszukiwania wektorowe zwykle używają większej liczby zasobów obliczeniowych niż wyszukiwania słów kluczowych.
- Wyszukiwania hybrydowe łączą wykonywanie wyszukiwania słów kluczowych i wektorów, więc zwykle używają większej ilości zasobów obliczeniowych niż każda z technik.
Rzeczywiste użycie zasobów obliczeniowych zależy od czynników, takich jak złożoność zapytania, rozmiar indeksu, ilość danych, konfiguracja wektora i liczba zwracanych wyników. Monitorowanie opłat za żądanie i agregowanie metryk użycia może pomóc zidentyfikować możliwości optymalizacji i lepiej przewidzieć koszty produkcji.
Obniżanie kosztów obliczeń dzięki optymalizacji
Wydajne zapytania i projektowanie indeksów zmniejszają zużycie zasobów obliczeniowych i obniżają koszty.
Optymalizowanie schematu
Schemat indeksu określa bazowe koszty zasobów obliczeniowych i magazynu:
- Ogranicz atrybuty pól: włącz tylko atrybuty (z możliwością wyszukiwania, filtrowania, aspektów, sortowania), jeśli jest to wymagane. Każdy atrybut zwiększa rozmiar indeksu i koszt indeksowania.
- Spłaszcz typy złożone: Mapuj zagnieżdżone struktury JSON na proste pola lub kolekcje tam, gdzie to możliwe.
-
Ustaw wartość retrievable=false dla pól tylko do filtrowania lub sortowania: jeśli pole jest używane do filtrowania lub sortowania, ale nie musi być zwracane w wynikach, zachowaj indeksowanie i ustaw je
retrievable=false, aby zmniejszyć koszt magazynowania na dysku i na GB/miesiąc. - Używaj pól tylko do pobierania, jeśli jest to możliwe: na przykład pola używane tylko do wyświetlania (np. adresy URL obrazów) nie powinny być przeszukiwalne.
- Zmniejsz wymiary wektorów: o wyższych wymiarach zwiększają koszty magazynowania i zapytań. W razie potrzeby używaj mniejszych modeli osadzania lub kwantyzacji.
- Zminimalizuj rozmiar danych dokumentu przed indeksowaniem: większe dokumenty kosztują więcej do indeksowania. Usuń niepotrzebne pola, przycinaj długi tekst i usuwaj kod HTML przed wysłaniem dokumentów do indeksu.
Optymalizowanie żądań indeksowania
Sposób wysyłania danych do indeksu wpływa zarówno na koszt, jak i przepływność:
Używaj większych partii, jeśli to możliwe: indeksowanie wsadowe zmniejsza obciążenie na żądanie przez amortyzację kosztów sieci i przetwarzania na większą liczbę dokumentów. Ogólnie rzecz biorąc, wsady obejmujące do ok. 1000 dokumentów lub ok. 16 MB są bardziej efektywne pod względem wykorzystania CU niż wiele małych żądań. Jednak optymalny rozmiar partii zależy od obciążenia. Przetestuj, aby zrównoważyć przepływność, opóźnienia i niezawodność.
Indeksuj tylko nowe lub zmienione dane: unikaj pełnego ponownego indeksowania, jeśli to możliwe. Wysyłanie tylko nowych dokumentów i aktualizacji zmniejsza liczbę przetwarzanych dokumentów, obniża koszty obliczeń i zwiększa szybkość importowania.
Pomiń wyodrębnianie obrazów, chyba że jest to potrzebne: wyodrębnianie obrazów dodaje dodatkową pracę przetwarzania i może stać się oddzielnym czynnikiem kosztowym. Włącz go tylko dla dokumentów lub przepływów pracy, które rzeczywiście potrzebują zawartości obrazu.
Uwzględnij wzrost rozmiaru indeksu: jeśli to możliwe, utwórz mniejsze indeksy. Wraz ze wzrostem indeksowania koszty indeksowania rosną, ponieważ więcej danych musi być przechowywanych i utrzymywanych, a operacje wymagają większej ilości zasobów obliczeniowych. W przypadku bardzo dużych zestawów danych rozważ partycjonowanie danych w wielu indeksach, aby ułatwić zarządzanie wydajnością i kosztami. Chociaż koszty rosną wraz z rozmiarem indeksu, wzrost jest podlinijny. Większe indeksy kosztują więcej operacji, ale nie proporcjonalnie więcej.
Aby uzyskać więcej wskazówek, zobacz Porady dotyczące lepszej wydajności w usłudze Foundry IQ.
Optymalizowanie operacji indeksatora
Kwalifikujące się płatne usługi bezserwerowe wiążą się ze zużyciem jednostek obliczeniowych na potrzeby wykonywania indeksatora. Ta opłata za wykonanie nie ma zastosowania do dedykowanych usług, w tym S3 HD, ani do bezpłatnych usług. Odpowiednie opłaty za pojemność, pamięć masową i usługi zewnętrzne pozostają oddzielne.
Wykonywanie indeksatora ma trzy profile obciążeń:
| Profil obciążenia | Główne czynniki wpływające na użycie |
|---|---|
| Pusty lub przebieg wykrywania zmian | Niewielka minimalna ilość zasobów obliczeniowych jest używana nawet wtedy, gdy nie są indeksowane żadne nowe dokumenty. Powtarzające się puste przebiegi nie muszą być kosztowne. |
| Źródło zorientowane wierszowo | Użycie skaluje się głównie wraz z liczbą przetworzonych rekordów, takich jak wiersze z Azure SQL Database lub dokumenty z Azure Cosmos DB. |
| Źródło zorientowane na dokument | Użycie zależy od odczytanych bajtów plików źródłowych i liczby wykonań umiejętności wzbogacania. Przykłady obejmują Azure Blob Storage i Azure Data Lake Storage Gen2. |
Są to czynniki wpływające na łączne użycie Compute Unit, a nie oddzielne publiczne mierniki dla przebiegów, rekordów, bajtów i umiejętności wzbogacania. Podczas wybierania źródła należy użyć wymagań dotyczących obsługi poszczególnych łączników.
Umiejętności pomocnicze do łączenia, dzielenia, kształtowania, warunkowania i wyodrębniania dokumentów nie wliczają się do składnika użycia obliczeniowego indeksatora opartego na umiejętnościach. To wykluczenie nie oznacza, że cały potok jest bezpłatny. Przetwarzanie źródła, operacje indeksowania, wyodrębnianie obrazów i wywołania modelu zewnętrznego lub usługi mogą nadal podlegać odpowiednim opłatom. Zobacz Opłaty za wykonywanie indeksatora.
Aby zmniejszyć użycie zasobów obliczeniowych indeksatora:
Użyj wykrywania zmian i indeksowania przyrostowego: przetwarzaj tylko nowe lub zmienione dane zamiast wielokrotnego indeksowania pełnego źródła danych.
Unikaj niepotrzebnych resetów: resetowanie może powtarzać wyodrębnianie i wzbogacanie na niezmienionej zawartości.
Dostosuj harmonogramy indeksatora: wybierz harmonogram spełniający wymagania dotyczące aktualności danych. Użyj telemetrii jednostki obliczeniowej, aby ocenić wpływ częstotliwości harmonogramu.
Zmniejsz niepotrzebną zawartość dokumentu: usuń zawartość, która nie musi być indeksowana, i wyklucz pliki lub typy plików, które nie są wymagane.
Starannie określ zakres umiejętności wzbogacania: uruchamiaj umiejętności tylko w polach i dokumentach, które wymagają wzbogacania, i unikaj generowania danych wyjściowych, które nie są używane w dalszym przetwarzaniu. Płatne umiejętności mogą wiązać się z oddzielnymi opłatami transakcyjnymi.
Monitorowanie nieudanych i powtarzających się uruchomień: indeksator może korzystać z zasobów obliczeniowych na potrzeby pracy wykonanej przed wystąpieniem awarii. Przejrzyj historię wykonywania i użycie jednostek obliczeniowych, aby zidentyfikować cykliczne błędy i wzorce ponawiania prób.
Przesunięcie harmonogramów może zmniejszyć nakładające się zapotrzebowanie i rozłożyć wykorzystanie czasu wykonywania, ale samo w sobie nie zmniejsza całkowitej pracy ani nie zwiększa łącznego limitu czasu wykonywania.
Monitorowanie obliczeń indeksatora
Użyj metryki Użycie jednostek obliczeniowych (AggregateComputeUnits), aby obserwować zagregowane zużycie usługi. Koreluj zmiany w tym samym zakresie czasu z historią wykonywania indeksatora, harmonogramami, przetworzonymi elementami, woluminem plików źródłowych i zmianami zestawu umiejętności. Inne operacje usługi również przyczyniają się do łącznego użycia, więc wzrost podczas uruchomienia nie jest dokładną alokacją dla poszczególnych indeksatorów.
Zachowaj oddzielne metryki monitorowania:
| Surface | Co ci to mówi |
|---|---|
| Stan indeksatora i statystyki usługi | Wyniki uruchomienia i sekundy limitu czasu działania w zgłoszonym 24-godzinnym oknie UTC. Te sekundy nie są jednostkami obliczeniowymi. |
| Metryka użycia jednostek obliczeniowych | Zagregowane użycie diagnostyczne wyrażone w milijednostkach obliczeniowych (mCU). Zobacz dokumentację danych monitorowania. |
| Zarządzanie kosztami i rejestry rozliczeń | Odpowiednie rozliczane użycie i koszty dla wybranego okresu rozliczeniowego. Użyj monitorowania kosztów i bieżącego cennika wyszukiwania, zamiast traktować wykres metryki jako fakturę. |
Aby oszacować koszt, uruchom reprezentatywne obciążenie, zarejestruj jego wolumen danych źródłowych, wzbogacanie, częstotliwość wykonywania i zaobserwowane łączne użycie i porównaj je z punktem odniesienia, który uwzględnia inną aktywność. Zastosuj bieżące ceny do odpowiednich ilości użycia. Nie wyprowadzaj rozliczanych jednostek obliczeniowych na podstawie czasu wykonywania mierzonego zegarem ściennym ani nie zakładaj dokładnej konwersji z metryki diagnostycznej na opłatę.
Optymalizowanie zapytań
Projektowanie zapytań jest podstawowym czynnikiem zmiennego kosztu:
Użyj
$selectpolecenia, aby ograniczyć zwracane pola: zmniejsza to rozmiar danych i zasoby obliczeniowe wymagane do serializacji.GET /docs?search=test&$select=id,title,urlUżyj
searchFields, aby ograniczyć, gdzie jest przeszukiwany tekst: ogranicz dopasowywanie w czasie wykonywania zapytania do pól, które mają znaczenie dla danego scenariusza. Każde dodatkowe pole z możliwością przeszukiwania zwiększa nakład pracy związany z wykonywaniem zapytań i może zwiększyć CU/h.Wybieraj dokładne dopasowanie lub proste zapytania słów kluczowych: rozmyte zapytania, zapytania z wieloznacznikami, zapytania wyrażeń regularnych i zapytania prefiksowe mogą wymuszać szerokie skanowanie indeksu i zużywać znacznie więcej CU/h. Używaj ich tylko wtedy, gdy potrzebujesz częściowego zachowania dopasowania i wybierz dokładne dopasowanie lub prostsze zapytania kluczowe wszędzie tam, gdzie to możliwe.
Użyj odwołań zamiast wyszukiwań, jeśli to możliwe: pobieranie dokumentu według identyfikatora jest bardziej wydajne niż uruchamianie zapytania wyszukiwania. Jeśli znasz identyfikator dokumentu, użyj wyszukiwania zamiast zapytania wyszukiwania. Wyszukiwania są bardziej wydajne, ponieważ pobierają dokument bezpośrednio według klucza, podczas gdy zapytania wyszukiwania wywołują pełny potok zapytania (analizowanie, przechodzenie indeksu, ocenianie i klasyfikowanie), co zwiększa koszt obliczeń.
Unikaj głębokiego stronicowania (
$skip): Duże$skipwartości zwiększają obliczenia, ponieważ aparat musi przetwarzać, oceniać i klasyfikować wyniki poprzedzające żądaną stronę. Na przykład$skip=5000wymaga, aby silnik przetworzył co najmniej 5,000 wyników, które nie zostają zwrócone. Ten wybór zużywa dodatkowe jednostki obliczeniowe (CU) i może zwiększyć koszty. Zamiast tego użyj filtrów, aby zawęzić wynikseti$top, a tym samym ograniczyć liczbę zwracanych wyników. Odpowiedni rozmiar$topaplikacji lub interfejsu użytkownika. Chociaż$topnie zmienia liczby zgodnych dokumentów, mniejsza wartość zmniejsza liczbę wyników, które muszą być zbierane, sortowane i serializowane. Żądaj tylko tyle wyników, ile wymaga aplikacja, i unikaj wzorców stronicowania, które wymagają od aparatu przetwarzania dużej liczby nieużywanych wyników.Zminimalizuj liczbę faset i ich zakres: żądaj tylko faset wyświetlanych w interfejsie użytkownika i utrzymuj wartość każdej fasety
countna możliwie niskim poziomie. Aspekty wymagają agregacji poszczególnych zapytań, a wysokie liczby zwiększają koszt obliczeń.Użyj
search.indo filtrowania: podczas filtrowania według listy identyfikatorów lub wartości użyj funkcjisearch.inzamiast wielu warunkówor(na przykładid eq '1' or id eq '2'). Takie podejście jest bardziej wydajne i zmniejsza obciążenie obliczeniowe. Należy również unikać oznaczania pól o wysokiej kardynalności (czyli takich, które mają dużą liczbę unikatowych wartości, na przykład unikatowe identyfikatory lub opisy w postaci wolnego tekstu) jako filtrowalnych lub fasetowych, chyba że jest to wymagane, ponieważ zwiększa to rozmiar indeksu i koszt wykonywania zapytań.
Optymalizowanie żądań administracyjnych
Oprócz operacji wykonywania zapytań i indeksowania usługa Foundry IQ obejmuje operacje administracyjne na poziomie obiektu i na poziomie usługi (takie jak pobieranie schematów indeksów lub statystyk usługi). Te żądania mają płaski koszt za żądanie. Chociaż każde żądanie ma niski koszt, powtarzające się lub niepotrzebne wywołania mogą z czasem się kumulować i zwiększać całkowite zużycie zasobów obliczeniowych.
- Unikaj nadmiernych żądań administracyjnych: Buforuj metadane, takie jak schematy indeksów, po stronie klienta zamiast pobierać je wielokrotnie. Na przykład pobieranie schematu indeksu przed każdą operacją zapisu wprowadza niepotrzebne koszty. W modelu bezserwerowym ten wzorzec bezpośrednio zwiększa opłaty za obliczenia, natomiast w przypadku usług dedykowanych wpływ jest często ukryty przez stałe rozliczenia godzinowe.
Optymalizowanie kosztów wektorów
Obciążenia wektorowe są zazwyczaj składnikiem o najwyższym koszcie w wyszukiwaniu modelu cen bezserwerowego, ponieważ mają wpływ zarówno na jednostki obliczeniowe (zapytania i indeksowanie), jak i magazyn (rozmiar wektora na dysku). Aby zmniejszyć koszty, zoptymalizuj zarówno sposób przechowywania wektorów, jak i sposób wykonywania zapytań.
Optymalizowanie magazynu i schematu wektorów
Pola wektorowe mogą znacznie zwiększyć rozmiar indeksu i koszt indeksowania. Użyj następujących technik, aby zmniejszyć obciążenie magazynu:
Użyj kompresji, aby zmniejszyć rozmiar wektora: Zastosuj kwantyzację, aby zmniejszyć zużycie pamięci masowej przy minimalnym wpływie na istotność. Na przykład kwantyzacja skalarna może zmniejszyć magazyn wektorów o maksymalnie 4× przy minimalnym wpływie na jakość wyszukiwania.
Wyłącz przechowywanie wektorów, gdy nie jest potrzebne: ustaw wartość stored=false na polach wektorowych, jeśli potrzebujesz wektorów tylko do wyszukiwania, a nie do pobierania. Pozwala to uniknąć przechowywania oryginalnych wektorów w indeksie, co zmniejsza koszty magazynowania bez wpływu na zachowanie zapytań.
Używaj mniejszych wymiarów osadzania, jeśli to możliwe: wektory o wyższych wymiarach zwiększają zarówno koszt magazynowania, jak i zapytania. W przypadku obciążeń niekrytycznych użyj mniejszych modeli osadzania (na przykład 384 lub 768 wymiarów zamiast 1536), aby zmniejszyć koszty.
Optymalizowanie wykonywania zapytań wektorów
Zapytania wektorowe intensywnie korzystają z obliczeń, ponieważ wymagają obliczeń podobieństwa w strukturach danych o wysokim wymiarach.
Stosuj wyszukiwanie hybrydowe wybiórczo: zapytania hybrydowe uruchamiają zarówno wyszukiwanie słów kluczowych, jak i wektorowe. Używaj tylko wtedy, gdy jest to konieczne dla istotności.
Obniż maxTextRecallSize dla zapytań hybrydowych: Ustawienie
hybridSearch.maxTextRecallSizesteruje liczbą wyników sklasyfikowanych przez BM25 przekazywanych do Reciprocal Rank Fusion. Wartość domyślna to 1000 (zakres od 1 do 10 000). Zużycie zasobów obliczeniowych rośnie w przybliżeniu liniowo wraz z tą wartością, więc jej obniżenie jest jednym z najprostszych sposobów zmniejszenia kosztów w przypadku obciążeń hybrydowych.Wartości około 500 często znacząco zmniejszają zapotrzebowanie na moc obliczeniową przy niewielkim spadku trafności.
Obniżenie tej wartości może spowodować utratę dopasowań słów kluczowych, których nie wychwytuje wyszukiwanie wektorowe, takich jak dokładne terminy, identyfikatory i akronimy.
Steruj liczbą kandydatów oddzielnie za pomocą parametru k w każdym zapytaniu wektorowym.
Przetestuj reprezentatywne zapytania i porównaj istotność, opóźnienie oraz nagłówek
x-ms-azs-compute-units-consumedprzed ostatecznym wybraniem wartości.Zastosuj filtry przed zapytaniami wektorowymi: Zawęź zestaw kandydatów przed wyszukiwaniem wektorowym, aby zmniejszyć ilość przetworzonych danych. Zobacz Jak filtrowanie działa w zapytaniach wektorowych.
Obniżanie kosztów dzięki zminimalizowaniu użycia
Opłaty za model bezserwerowy są naliczane tylko za zużyte zasoby. Jeśli nie ma żadnych żądań, użycie zasobów obliczeniowych spada odpowiednio.
Aby zminimalizować koszty użycia:
- Uruchamiaj zapytania tylko wtedy, gdy jest to konieczne.
- Unikaj nadmiarowych lub zbyt często występujących żądań.
- Monitoruj użycie i dostrajaj obciążenia na podstawie zapotrzebowania.
Tip
To samo zapytanie może charakteryzować się różnymi opóźnieniami i profilami zużycia CU w zależności od tego, czy usługa jest rozgrzana, czy zimna. Po upływie okresu bez ruchu odczytu lub zapisu użycie zasobów obliczeniowych w modelu cen bezserwerowym spadnie do zera. Następne żądanie może mieć większe opóźnienie i zużywać więcej jednostek CU, gdy ścieżki danych się rozgrzewają. Większe indeksy zwykle potrzebują więcej czasu na rozgrzanie niż mniejsze, więc efekty zimnego startu są często bardziej zauważalne w większych usługach.
Optymalizowanie kosztów magazynowania
Opłata za przechowywanie jest naliczana za każdy GB/miesiąc na podstawie rozmiaru indeksu na dysku, który może przekraczać rozmiar danych źródłowych. Aby zmniejszyć koszty magazynowania:
- Usuń nieużywane indeksy.
- Zminimalizuj przechowywane pola.
- Projektuj schematy z uwzględnieniem nakładu pracy magazynu.
- Używaj mechanizmów sugestii wybiórczo, ponieważ mogą one znacznie zwiększyć zajętość pamięci.
Aby uzyskać informacje o technikach specyficznych dla wektorów (kompresja, oczyszczanie i ustawienia magazynu), zobacz Optymalizowanie pod kątem magazynu i przetwarzania wektorów.
Aby uzyskać więcej wskazówek dotyczących kompromisów między wydajnością przechowywania danych i zapytań, zobacz Porady dotyczące lepszej wydajności w usłudze Foundry IQ.