Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Foundry IQ (Wyszukiwanie AI platformy Azure) udostępnia bezpośrednie interfejsy API indeksowania i zapytań, a także interfejsy API wyższego poziomu dla źródeł wiedzy i baz wiedzy do zarządzanego pobierania. Użyj portalu Azure, interfejsów API REST lub Azure SDKs, aby skonfigurować te możliwości lub połączyć agentów z bazami wiedzy w portalu Microsoft Foundry.
Ważne
Funkcje lub możliwości oznaczone (wersja zapoznawcza) w tym artykule znajdują się w publicznej wersji zapoznawczej i podlegają dodatkowym warunkom użytkowania Microsoft Azure w wersji zapoznawczej. Aby uzyskać warunki wersji zapoznawczej specyficzne dla usługi Foundry IQ (Wyszukiwanie AI platformy Azure), zobacz Funkcjonalność w wersji zapoznawczej.
W usłudze Foundry IQ (Wyszukiwanie AI platformy Azure) można użyć wyrażenia filtru, aby dodać kryteria uwzględniania lub wykluczania do zapytania wektorowego. Można również określić tryb filtrowania, który stosuje filtr:
- Przed wykonaniem zapytania, znanym jako wstępne filtrowanie.
- Po wykonaniu zapytania, znanego jako postfiltrowanie.
- Po zidentyfikowaniu globalnych najlepszych
kwyników, nazywanych ścisłym filtrowaniem postfiltrowania (wersja zapoznawcza).
W tym artykule użyto architektury REST na potrzeby ilustracji. Przykłady kodu w innych językach i kompleksowe rozwiązania, które obejmują zapytania wektorowe, zobacz repozytorium azure-search-vector-samples GitHub.
W portalu Azure można również użyć narzędzia Search Explorer, aby wyszukiwać treści wektorowe. W widoku JSON można dodawać filtry i określać tryb filtrowania.
Jak działa filtrowanie w zapytaniach wektorowych
Usługa Foundry IQ używa algorytmu hierarchicznego nawigowalnego małego świata (HNSW) do wyszukiwania przybliżonego najbliższego sąsiada (ANN), przechowując wykresy HNSW w wielu fragmentach indeksu. Każdy fragment zawiera część całego indeksu.
Filtry mają zastosowanie do filterable pól niewektorowych, ciągów lub liczb do uwzględnienia lub wykluczenia dokumentów wyszukiwania na podstawie kryteriów filtru. Same pola wektorowe nie są filtrowalne, ale można użyć filtrów w innych polach w tym samym indeksie, aby zawęzić dokumenty rozważane do wyszukiwania wektorowego. Jeśli indeks nie ma odpowiednich pól tekstowych lub liczbowych, sprawdź metadane dokumentu, które mogą ułatwić filtrowanie, takie jak LastModified lub CreatedBy właściwości.
Parametr vectorFilterMode określa, gdzie operacje filtrowania są stosowane na etapach wyszukiwania, co wpływa na sposób filtrowania wyników do podzestawu elementów (takich jak kategoria, tag lub inne atrybuty) i ma wpływ na opóźnienie, kompletność i przepływność. Istnieją trzy tryby:
preFilterstosuje filtr podczas przeszukiwania HNSW na każdym shardzie. Ten tryb maksymalizuje wykrywalność, ale może przemierzać większą część grafu, zwiększając użycie procesora i latencję przy wysoce selektywnych filtrach.postFilteruruchamia przechodzenie HNSW i filtrowanie na każdym fragmencie niezależnie, wyznacza część wspólną wyników na poziomie fragmentu, a następnie agreguje topkz każdego fragmentu do globalnego topk. Ten tryb może tworzyć wyniki fałszywie negatywne dla wysoce selektywnych filtrów lub małych wartościk.strictPostFilter(wersja zapoznawcza) znajduje niefiltrowane globalne najlepsze wynikikprzed zastosowaniem filtru. Ten tryb ma największe ryzyko zwracania wyników fałszywie ujemnych dla wysoce selektywnych filtrów i małychkwartości.
Aby uzyskać więcej informacji na temat tych trybów, zobacz Ustawianie trybu filtrowania.
Definiowanie filtru
Filtry określają zakres zapytań wektorowych i są definiowane przy użyciu funkcji Documents - Search Post (REST API). Jeśli nie chcesz używać funkcji w wersji zapoznawczej, użyj najnowszej stabilnej wersji interfejsów API REST usługi wyszukiwania , aby sformułować żądanie.
Ten interfejs API REST zapewnia:
-
filterdla kryteriów filtrowania. -
Użyj
vectorFilterMode, aby określić, kiedy filtr jest stosowany podczas zapytania wektorowego. Aby uzyskać informacje o obsługiwanych trybach, zobacz Ustawianie trybu filtrowania.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
W tym przykładzie wektor osadzania jest przeznaczony dla contentVector pola, a kryteria filtrowania mają zastosowanie do categorypola tekstowego z możliwością filtrowania.
preFilter Ponieważ jest używany tryb, filtr jest stosowany przed uruchomieniem zapytania przez aparat wyszukiwania, więc podczas wyszukiwania wektorowego są uwzględniane tylko dokumenty w Databases kategorii.
Ustawianie trybu filtrowania
Parametr vectorFilterMode określa, kiedy i jak filtr jest stosowany względem wykonywania zapytania wektorowego. Możesz użyć następujących trybów:
-
preFilter(zalecane) postFilter-
strictPostFilter(wersja zapoznawcza)
Uwaga
preFilter to wartość domyślna dla indeksów utworzonych po około 15 października 2023 r. W przypadku indeksów utworzonych przed tą datą postFilter jest wartością domyślną. Aby użyć preFilter i innych zaawansowanych funkcji wektorów, takich jak kompresja wektorów, należy ponownie utworzyć indeks.
Zgodność można przetestować, wysyłając zapytanie wektorowe przy użyciu "vectorFilterMode": "preFilter" w wersji interfejsu API REST lub nowszej 2023-10-01-preview. Jeśli zapytanie zakończy się niepowodzeniem, indeks nie obsługuje preFilterelementu .
Filtrowanie wstępne stosuje filtry przed wykonaniem zapytania, co zmniejsza zestaw kandydatów dla algorytmu wyszukiwania wektorowego. Wyniki top-k są następnie wybierane z tego filtrowanego zestawu.
W zapytaniu wektorowym tryb domyślny to preFilter, ponieważ preferuje on kompletność i jakość ponad opóźnienia.
Jak działa ten tryb
Dla każdego fragmentu zastosuj predykat filtru podczas przechodzenia HNSW, rozwijając graf do momentu
kznalezienia kandydatów.Wygeneruj wstępnie przefiltrowane czołowe wyniki lokalne na każdy fragment.
Zagreguj przefiltrowane wyniki do globalnego zestawu wyników najwyższego
kpoziomu.
Efekt tego trybu
Przechodzenie rozszerza powierzchnię wyszukiwania, aby znaleźć więcej filtrowanych kandydatów, zwłaszcza jeśli filtr jest selektywny. Daje to najbardziej podobnek wyniki we wszystkich fragmentach. Każdy fragment identyfikuje k wyniki spełniające predykat filtru.
Wstępne filtrowanie gwarantuje, że wyniki k są zwracane, jeśli istnieją w indeksie. W przypadku wysoce selektywnych filtrów może to spowodować przejście znacznej części grafu, zwiększenie kosztów obliczeń i opóźnień przy jednoczesnym zmniejszeniu przepływności. Jeśli filtr jest wysoce selektywny (ma bardzo mało dopasowań), rozważ użycie metody exhaustive: true w celu przeprowadzenia wyczerpującego wyszukiwania.
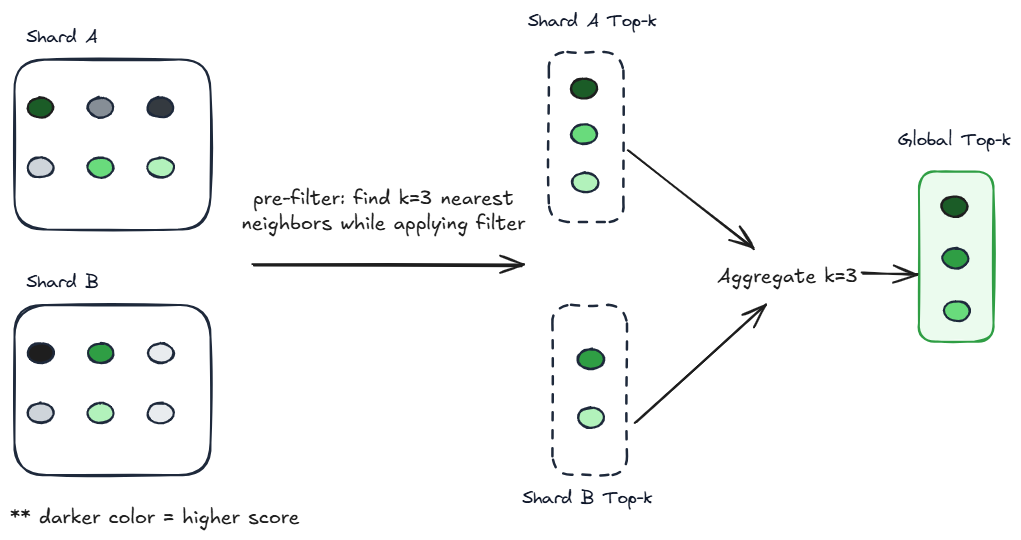
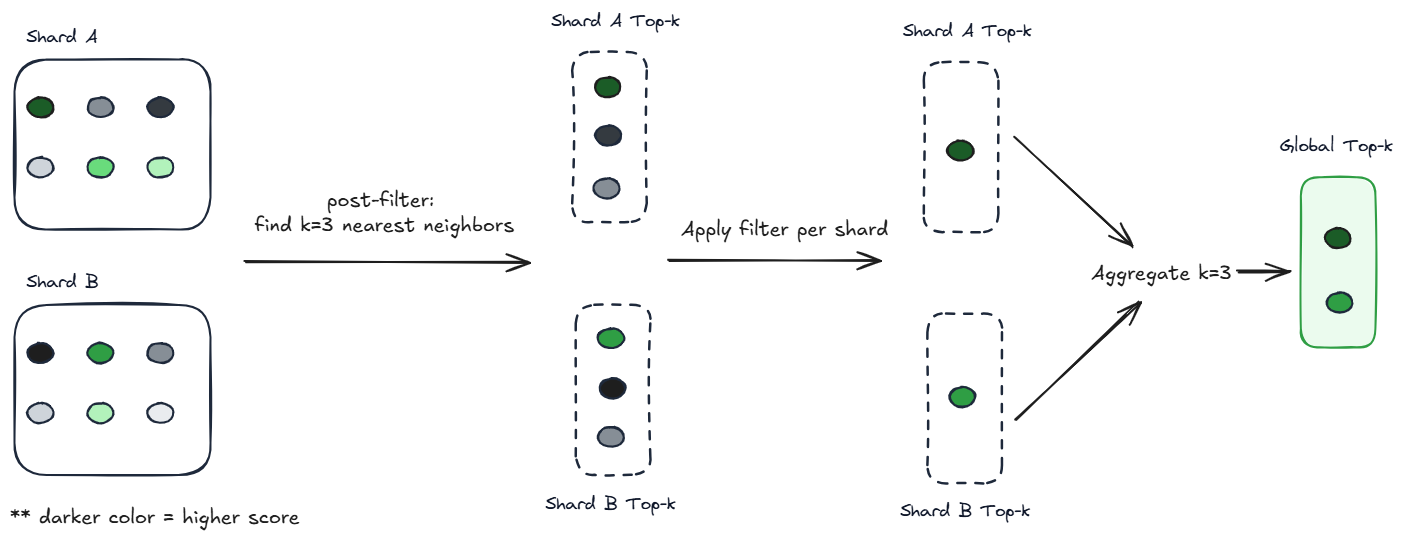
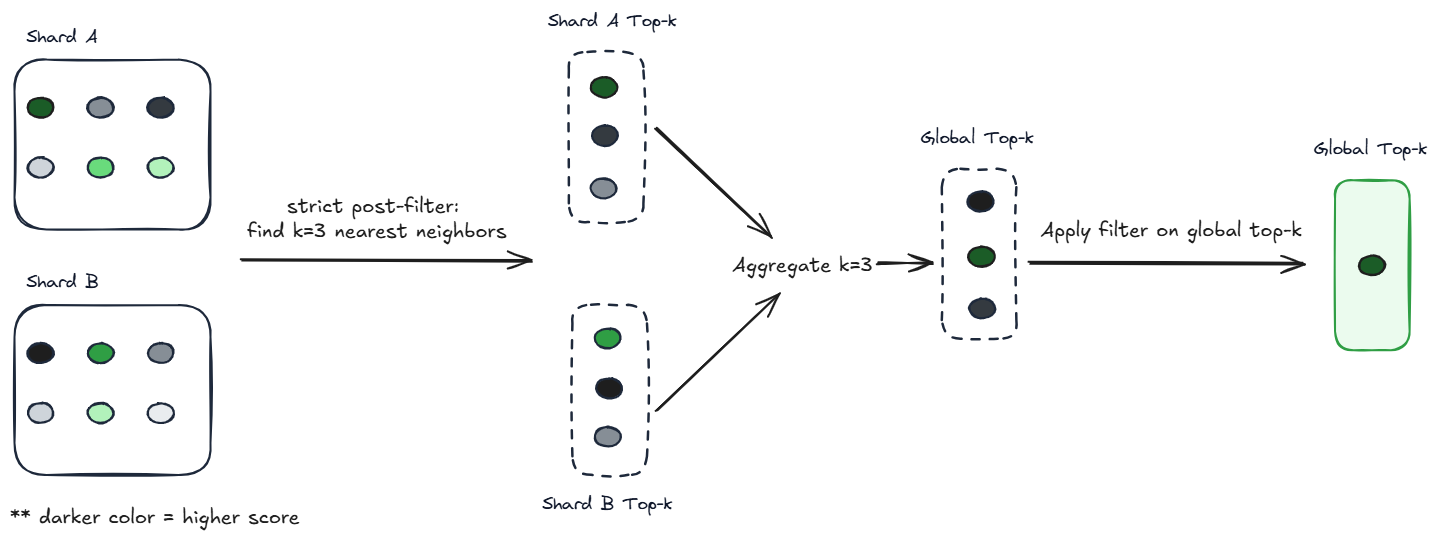
Tabela porównania
| Tryb | Przywołanie (przefiltrowane wyniki) | Koszt obliczeniowy | Ryzyko fałszywych negatywów | Kiedy należy używać |
|---|---|---|---|---|
preFilter |
Bardzo wysoki | Wyższa (zwiększa się wraz z selektywnością filtru i złożonością) | Brak ryzyka |
Zalecana wartość domyślna dla wszystkich scenariuszy, szczególnie gdy pełność wyszukiwania ma krytyczne znaczenie (wrażliwe domeny wyszukiwania), w przypadku korzystania z filtrów selektywnych lub przy użyciu małych k. |
postFilter |
Średnia do wysoka (zmniejsza się wraz ze wzrostem selektywności filtru) | Podobnie jak w przypadku niefiltrowanych, zwiększa się wraz ze złożonością filtru. | Umiarkowane (może przegapić dopasowania na fragment) | Opcja dla filtrów, które nie są zbyt selektywne oraz dla bardziej złożonych zapytańk. |
strictPostFilter |
Najniższy (szybciej zmniejsza się przy użyciu selektora filtru) | Podobne do niefiltrowanych | Najwyższy (może zwracać zero wyników dla filtrów selektywnych lub małych k) |
Opcja dla aplikacji wyszukiwania fasetowego, w których wyświetlenie większej liczby wyników po zastosowaniu filtru ma większy wpływ na doświadczenie użytkownika niż ryzyko fałszywych wyników negatywnych. Nie używaj z małym k. |
Testowanie porównawcze wstępnego filtrowania i zafiltrowania końcowego
Ważne
Ta sekcja dotyczy filtrowania wstępnego i postfiltrowania, a nie ściśle po filtrowaniu.
Aby zrozumieć warunki, w których jeden tryb filtrowania działa lepiej niż drugi, przeprowadziliśmy serię testów w celu oceny wyników zapytań w przypadku małych, średnich i dużych indeksów.
- Mały (100 000 dokumentów, indeks 2,5 GB, 1536 wymiarów)
- Średni (1 milion dokumentów, indeks 25 GB, 1536 wymiarów)
- Duży (1 miliard dokumentów, indeks 1,9 TB, 96 wymiarów)
W przypadku małych i średnich obciążeń użyliśmy usługi Standard 2 (S2) z jedną partycją i jedną repliką. W przypadku dużego obciążenia użyliśmy usługi Standard 3 (S3) z 12 partycjami i jedną repliką.
Indeksy miały identyczną konstrukcję: jedno pole klucza, jedno pole wektorowe, jedno pole tekstowe i jedno pole filtrowalne liczbowo. Indeks jest definiowany przy użyciu składni 2023-11-01.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
W zapytaniach użyliśmy identycznego filtru dla operacji filtrowania wstępnego i postfiltru. Użyliśmy prostego filtru, aby upewnić się, że zmiany wydajności były spowodowane trybem filtrowania, a nie złożonością filtrowania.
Wyniki były mierzone w zapytaniach na sekundę (QPS).
Wnioski
Filtrowanie wstępne jest prawie zawsze wolniejsze niż filtrowanie końcowe, z wyjątkiem małych indeksów, w których wydajność jest podobna.
W przypadku większych zestawów danych filtrowanie wstępne jest wielokrotnie wolniejsze.
Dlaczego filtrowanie wstępne jest domyślne, jeśli jest prawie zawsze wolniejsze? Wstępne filtrowanie gwarantuje, że
kwyniki są zwracane, jeśli istnieją w indeksie, gdzie priorytet sprzyja kompletności i precyzji nad szybkością.Użyj filtrowania końcowego, jeśli:
Preferencja szybkości nad wyborem (post-filtrowanie może zwracać mniej niż
kwyników).Używaj filtrów, które nie są nadmiernie selektywne.
Posiadanie indeksów o wystarczających rozmiarach, aby wydajność filtrowania wstępnego stała się niedopuszczalna.
Szczegóły
Biorąc pod uwagę zestaw danych z 100 000 wektorów o wymiarach 1536:
Podczas filtrowania ponad 30% zestawu danych porównywano filtrowanie wstępne i filtrowanie postfiltrujące.
Podczas filtrowania mniejszego niż 0,1% zestawu danych filtrowanie wstępne było o około 50% wolniejsze niż filtrowanie postfiltrujące.
Biorąc pod uwagę zestaw danych z 1 milionami wektorów o wymiarach 1536:
Podczas filtrowania ponad 30% zestawu danych wstępne filtrowanie było o około 30% wolniejsze.
Podczas filtrowania mniejszego niż 2% zestawu danych wstępne filtrowanie było o siedem razy wolniejsze.
Biorąc pod uwagę zestaw danych z 1 miliardami wektorów o wymiarach 96:
Podczas filtrowania ponad 5% zestawu danych filtrowanie wstępne było o około 50% wolniejsze.
Podczas filtrowania mniejszego niż 10% zestawu danych filtrowanie wstępne było około siedmiu razy wolniejsze.
Na poniższym wykresie przedstawiono wstępne filtrowanie względne QPS obliczone jako wstępne filtrowanie QPS podzielone przez QPS postfilter.
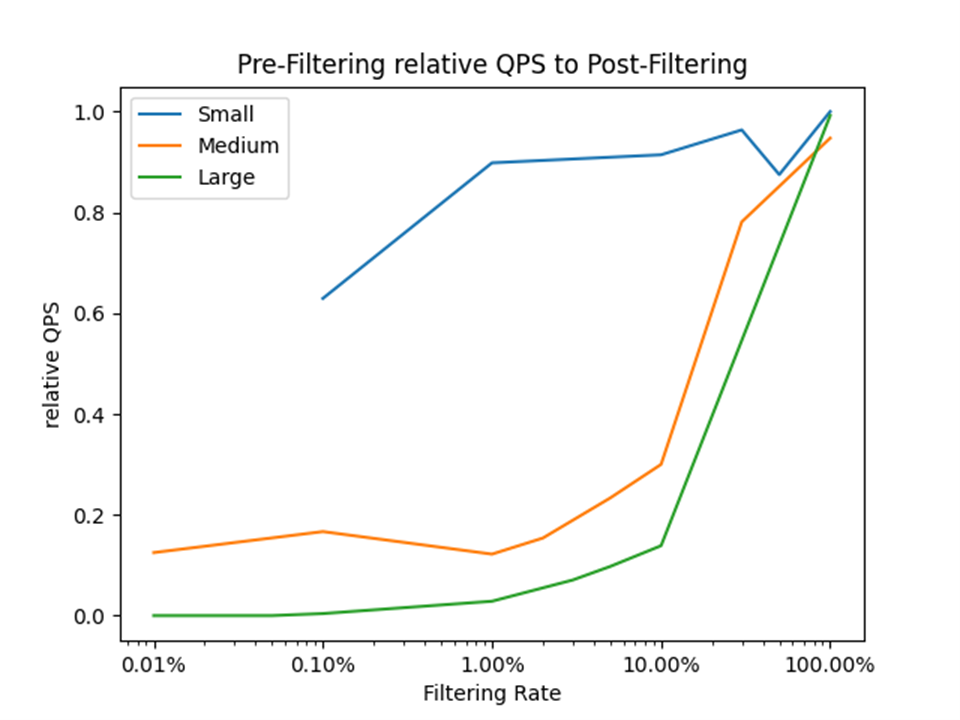
Oś pionowa reprezentuje względną wydajność filtrowania wstępnego w porównaniu do filtrowania postfiltrującego, wyrażonego jako stosunek QPS (zapytania na sekundę). Na przykład:
- Wartość
0.0oznacza, że filtrowanie wstępne jest dwa razy wolniejsze niż filtrowanie końcowe. - Wartość
0.5oznacza, że filtrowanie wstępne wynosi 50% wolniej. - Wartość
1.0oznacza, że filtrowanie wstępne i filtrowanie po są równoważne.
Oś pozioma reprezentuje współczynnik filtrowania lub procent dokumentów kandydatów po zastosowaniu filtru. Na przykład współczynnik 1.00% oznacza, że kryteria filtrowania wybrały jeden procent korpusu wyszukiwania.