Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Note
Azure AI Zoeken is beschikbaar via de Azure-portal, REST API's en Azure-SDK's. Het vormt ook een basis voor Foundry IQ, de beheerde kennislaag die bedrijfsinhoud transformeert in herbruikbare, machtigingsbewuste knowledge bases voor agents in de Microsoft Foundry-portal.
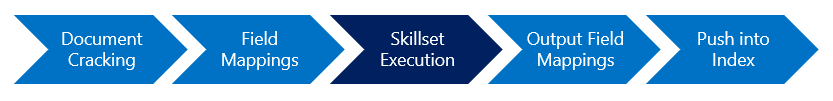
Een vaardighedenset definieert bewerkingen die vector- en tekstuele inhoud en structuur genereren op basis van documenten die afbeeldingen of onbewerkte inhoud bevatten. Voorbeelden zijn het segmenteren van vaardigheden, het insluiten van vaardigheden (vectorisatie), het verbaliseren van afbeeldingen en andere processen zoals optische tekenherkenning (OCR) voor afbeeldingen, entiteitsherkenning voor niet-gedifferentieerde tekst en tekstomzetting. Een vaardighedenset wordt uitgevoerd nadat onbewerkte inhoud is geëxtraheerd uit een externe gegevensbron en nadat veldtoewijzingen zijn verwerkt.
In dit artikel wordt uitgelegd hoe u een vaardighedenset maakt met REST API's, maar dezelfde concepten en stappen zijn van toepassing op andere programmeertalen.
Regels voor de definitie van vaardighedenset zijn onder andere:
- Moet een unieke naam hebben binnen de verzameling skillsets. Een skillset is een resource op het hoogste niveau die door elke indexer kan worden gebruikt.
- Moet ten minste één vaardigheid hebben. Drie tot vijf vaardigheden zijn typisch. Het maximum is 30.
- Een vaardighedenset kan vaardigheden van hetzelfde type herhalen. Een vaardighedenset kan bijvoorbeeld meerdere Shaper-vaardigheden hebben.
- Een vaardighedenpakket biedt ondersteuning voor ketenbewerkingen, lussen en vertakkingen.
Koppel een vaardighedenset aan een indexeerfunctie. Als u de vaardighedenset wilt gebruiken, verwijst u ernaar in een indexeerfunctie en voert u vervolgens de indexeerfunctie uit om gegevens te importeren, vaardighedenverwerking aan te roepen en uitvoer naar een index te verzenden. Een vaardighedenset is een resource op hoog niveau, maar is alleen operationeel tijdens indexerverwerking. Als een resource op hoog niveau kunt u ernaar verwijzen in meerdere indexeerfuncties.
Tip
Schakel verrijkingscaching (preview) in om de inhoud die u al hebt verwerkt, opnieuw te gebruiken en de ontwikkelingskosten te verlagen.
Een definitie van een vaardighedenset toevoegen
Wanneer u een vaardighedenset maakt, voegt u deze toe aan uw zoekservice. Wanneer u een vaardighedenset bijwerkt, overschrijft u een bestaande vaardighedenset volledig met de inhoud van de payload van de aanvraag. Als u een vaardighedenset wilt bijwerken, haalt u de definitie van de vaardighedenset op met behulp van GET, wijzigt u deze en werkt u deze vervolgens bij met behulp van PUT.
Note
GET- en LIST-antwoorden maskeren aangepaste web-API-URI-geheimen en HTTP-headerwaarden. Als u geheimen wilt behouden bij het bijwerken van dezelfde vaardighedenset en hetzelfde eindpunt, dient u de geretourneerde placeholders opnieuw in.
Als alternatief stelt u het geheel uri en elke bewaarde headerwaarde in op <unchanged>. Voor vervangende secrets, HTTP 400-fouten en overeenkomende regels voor query's raadpleegt u updates voor URI-redaction en behoud van inloggegevens.
Begin met de basisstructuur. In de CREATE Skillset REST API maakt u de hoofdtekst van de aanvraag in JSON. Het bevat de volgende secties:
{
   "name":"skillset-template",
   "description":"A description makes the skillset self-documenting (comments aren't allowed in JSON itself)",
   "skills":[

   ],
   "cognitiveServices":{
      "@odata.type":"#Microsoft.Azure.Search.CognitiveServicesByKey",
      "description":"A Microsoft Foundry resource in the same region as Azure AI Search",
      "key":"<Your-Microsoft-Foundry-Resource-Key>"
   },
   "knowledgeStore":{
      "storageConnectionString":"<Your-Azure-Storage-Connection-String>",
      "projections":[
         {
            "tables":[ ],
            "objects":[ ],
            "files":[ ]
         }
      ]
    },
    "encryptionKey":{ }
}
Na de naam en beschrijving heeft een vaardighedenset vier hoofdeigenschappen:
skillsarray, een ongeordende verzameling vaardigheden. Vaardigheden zijn zelfstandig of gekoppeld via invoer-uitvoerkoppelingen, waarbij de uitvoer van de ene transformatie invoer aan een andere wordt. Vaardigheden kunnen utilitar zijn (zoals het splitsen van tekst), transformationeel (op basis van AI van Azure OpenAI of Foundry Tools) of aangepaste vaardigheden die u opgeeft. In de volgende sectie vindt u een voorbeeld van een vaardighedenmatrix.cognitiveServiceswordt gebruikt voor factureerbare vaardigheden die Foundry Tools-API's aanroepen. Verwijder deze sectie als u geen factureerbare vaardigheden of Custom Entity Lookup gebruikt. Als u dat wel bent, voegt u een Foundry-resource toe.knowledgeStore(optioneel) geeft een Azure Storage-account en instellingen op voor het projecteren van vaardighedensetuitvoer in tabellen, blobs en bestanden in Azure Storage. Verwijder deze sectie als u deze niet nodig hebt. Geef anders een kennisarchief op.encryptionKey(optioneel) geeft een Azure Key Vault en door de klant beheerde sleutels op die worden gebruikt voor het versleutelen van gevoelige inhoud (beschrijvingen, verbindingsreeks s, sleutels) in een definitie van een vaardighedenset. Verwijder deze eigenschap als u geen door de klant beheerde versleuteling gebruikt.
Vaardigheden toevoegen
In de definitie van de vaardighedenset geeft de vaardighedenmatrix aan welke vaardigheden moeten worden uitgevoerd. Drie tot vijf vaardigheden zijn gebruikelijk, maar u kunt zoveel vaardigheden toevoegen als nodig is, afhankelijk van servicelimieten.
Het eindresultaat van een verrijkingspijplijn is tekstuele inhoud in een zoekindex of een kennisarchief. Daarom maken de meeste vaardigheden tekst op basis van afbeeldingen (OCR-tekst, bijschriften, tags) of analyseert u bestaande tekst om nieuwe informatie te maken (entiteiten, sleuteltermen, sentiment). Vaardigheden die onafhankelijk werken, worden parallel verwerkt. Vaardigheden die afhankelijk zijn van elkaar geven de uitvoer van één vaardigheid (zoals sleuteltermen) op als invoer van een tweede vaardigheid (zoals tekstomzetting). De zoekservice bepaalt de volgorde van de uitvoering van vaardigheden en de uitvoeringsomgeving.
Alle vaardigheden hebben een type, context, invoer en uitvoer. Een vaardigheid kan eventueel een naam en beschrijving hebben. In het volgende voorbeeld ziet u twee niet-gerelateerde ingebouwde vaardigheden , zodat u de basisstructuur kunt vergelijken.
"skills": [
    {
        "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
        "name": "#1",
        "description": "This skill detects organizations in the source content",
        "context": "/document",
        "categories": [
            "Organization"
        ],
        "inputs": [
            {
                "name": "text",
                "source": "/document/content"
            }
        ],
        "outputs": [
            {
                "name": "organizations",
                "targetName": "orgs"
            }
        ]
    },
    {
        "name": "#2",
        "description": "This skill detects corporate logos in the source files",
        "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
        "context": "/document/normalized_images/*",
        "visualFeatures": [
            "brands"
        ],
        "inputs": [
            {
                "name": "image",
                "source": "/document/normalized_images/*"
            }
        ],
        "outputs": [
            {
                "name": "brands"
            }
        ]
    }
]
Elke vaardigheid is uniek in termen van de invoerwaarden en de parameters die nodig zijn. Referentiedocumentatie over vaardigheden beschrijft alle parameters en eigenschappen van een bepaalde vaardigheid. Hoewel er verschillen zijn, delen de meeste vaardigheden een gemeenschappelijke basis en volgen ze een vergelijkbaar patroon.
Note
U kunt complexe vaardigheden bouwen met loops en branches met behulp van de Conditionele cognitieve vaardigheid om de expressies te creëren. De syntaxis is gebaseerd op de JSON Pointer-pad notatie, met enkele wijzigingen om knooppunten in de verrijkingsstructuur te identificeren. Een "/" doorkruist een niveau lager in de structuur en "*" fungeert als een operator voor elke operator in de context. Veel voorbeelden in dit artikel illustreren de syntaxis.
Vaardigheidscontext instellen
Elke vaardigheid heeft een contexteigenschap die bepaalt op welk niveau bewerkingen plaatsvinden. Als de context eigenschap niet expliciet is ingesteld, is "/document"de standaardwaarde , waarbij de context het hele document is (de vaardigheid wordt eenmaal per document aangeroepen).
"skills":[
  {
    "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
    "context": "/document",
    "inputs": [],
    "outputs": []
  },
  {
      "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
      "context": "/document/normalized_images/*",
      "visualFeatures": [],
      "inputs": [],
      "outputs": []
  }
]
Stel de context eigenschap in op een van de volgende voorbeelden:
| Contextvoorbeeld | Description |
|---|---|
context: /document |
(Standaard) Invoer en uitvoer bevinden zich op documentniveau. |
context: /document/pages/* |
Sommige vaardigheden, zoals sentimentanalyse, presteren beter dan kleinere stukken tekst. Als u een groot inhoudsveld splitst in pagina's of zinnen, moet de context over elk onderdeel worden verdeeld. |
context: /document/normalized_images/* |
Voor afbeeldingsinhoud is er voor elke afbeelding in het bovenliggende document één invoer en één uitvoer. |
Context bepaalt ook waar uitvoer wordt geproduceerd in de verrijkingsstructuur. De vaardigheid Entiteitsherkenning retourneert bijvoorbeeld een eigenschap met de naam organizations, vastgelegd als orgs. Als de context is "/document", wordt een organizations knooppunt toegevoegd als een onderliggend element van "/document". Als u vervolgens naar dit knooppunt wilt verwijzen in downstream vaardigheden, is het pad "/document/orgs".
Invoer definiëren
Vaardigheden lezen van en schrijven naar een verrijkt document. Invoer van vaardigheden geeft de oorsprong van de binnenkomende gegevens op. Dit is vaak het hoofdknooppunt van het verrijkte document. Voor blobs is een typische input voor vaardigheden de inhoudseigenschap van het document.
Referentiedocumentatie voor vaardigheden voor elke vaardigheid beschrijft de invoer die deze kan gebruiken. Elke invoer heeft een name aanduiding voor een specifieke invoer en een source invoer die de locatie van de gegevens in het verrijkte document aangeeft. Het volgende voorbeeld is afkomstig van de vaardigheid Entiteitsherkenning:
"inputs": [
    {
        "name": "text",
        "source": "/document/content"
    },
    {
        "name": "languageCode",
        "source": "/document/language"
    }
]
Een vaardigheid kan meerdere invoer hebben. Dit
nameis de specifieke invoer. Voor Entiteitsherkenning zijn de specifieke invoer tekst en languageCode.De
sourceeigenschap geeft aan welk veld of welke rij de inhoud bevat die moet worden verwerkt. Voor op tekst gebaseerde vaardigheden is de bron een veld in het document of de rij die tekst biedt. Voor vaardigheden op basis van afbeeldingen is het knooppunt dat de invoer levert genormaliseerde afbeeldingen.Bronvoorbeeld Description source:/documentVoor een gegevensset in tabelvorm komt een document overeen met een rij. source:/document/contentVoor blobs is de bron meestal de inhoudseigenschap van de blob. source:/document/some-named-fieldVoor op tekst gebaseerde vaardigheden, zoals entiteitsherkenning of sleuteltermextractie, moet de oorsprong een veld zijn dat voldoende tekst bevat die moet worden geanalyseerd, zoals een beschrijving of samenvatting. source:/document/normalized_images/*Voor afbeeldingsinhoud is de bron een afbeelding die is genormaliseerd tijdens het kraken van documenten.
Als de vaardigheid over een matrix wordt herhaald, moeten zowel de context als de invoerbron de juiste posities bevatten /* . Zie De context van vaardigheden en de invoeraantekeningstaal voor meer informatie over de volledige syntaxis.
Uitvoer definiëren
Elke vaardigheid is ontworpen om specifieke soorten uitvoer te genereren, waarnaar de skillset bij naam verwijst. Een vaardigheidsuitvoer heeft een name en een targetName dat optioneel is.
In de referentiedocumentatie voor elke vaardigheid wordt beschreven welke uitvoerwaarden deze kan produceren. Het volgende voorbeeld is afkomstig van de vaardigheid Entiteitsherkenning:
"outputs": [
    {
        "name": "persons",
        "targetName": "people"
    },
    {
        "name": "organizations",
        "targetName": "orgs"
    },
    {
        "name": "locations",
        "targetName": "places"
    }
]
Vaardigheden kunnen meerdere uitvoer hebben. De
nameeigenschap identificeert een specifieke uitvoer. Voor entiteitsherkenning kan de uitvoer bijvoorbeeld personen, locaties, organisaties zijn.De
targetNameeigenschap geeft de naam op die dit knooppunt moet hebben in het verrijkte document. Deze eigenschap is nuttig als de uitvoer van vaardigheden dezelfde naam heeft. Als u meerdere vaardigheden hebt die dezelfde uitvoer retourneren, gebruikt utargetNamevoor naamontdubbeling in verrijkingsknooppuntpaden. Als u de doelnaam niet opgeeft, wordt de naameigenschap gebruikt voor beide.
Sommige situaties vragen om afzonderlijk naar elk element van een matrix te verwijzen. Stel dat u elk element van "/document/orgs" afzonderlijk aan een andere vaardigheid wilt doorgeven. Voeg hiervoor een sterretje toe aan het pad: "/document/orgs/*".
Uitvoer van een vaardigheid wordt naar het verrijkte document geschreven als een nieuw knooppunt in de verrijkingsboom. Het kan een eenvoudige waarde zijn, zoals een gevoelsscore of taalcode. Het kan ook een verzameling zijn, zoals een lijst met organisaties, personen of locaties. Vaardigheidsuitvoer kan ook een complexe structuur zijn, zoals bij de Shaper-vaardigheid. De invoer van de vaardigheid bepaalt de samenstelling van de vorm, maar de uitvoer is het benoemde object, dat kan worden verwezen in een zoekindex, een kennisopslagprojectie of een andere vaardigheid op naam.
Een aangepaste vaardigheid toevoegen
Deze sectie bevat een voorbeeld van een aangepaste vaardigheid. De URI verwijst naar een Azure-functie, die op zijn beurt het model of de transformatie aanroept die u opgeeft. Zie Een aangepaste vaardigheid toevoegen aan een Azure AI Zoeken-verrijkingspijplijn voor meer informatie.
Hoewel met de aangepaste vaardigheid code wordt uitgevoerd die zich buiten de pijplijn bevindt, is het in een vaardighedenmatrix gewoon een andere vaardigheid. Net als de ingebouwde vaardigheden heeft het een type, context, invoer en uitvoer. Het leest en schrijft ook naar een verrijkingsboom, net zoals de ingebouwde vaardigheden. Merk op dat het context-veld is ingesteld op "/document/orgs/*" met een sterretje, wat betekent dat de verrijkingsstap wordt aangeroepen voor elke organisatie onder "/document/orgs".
Uitvoer, zoals de beschrijving van het bedrijf in dit voorbeeld, wordt gegenereerd voor elke organisatie die wordt geïdentificeerd. Wanneer u verwijst naar het knooppunt in een downstreamstap (bijvoorbeeld bij extractie van sleuteltermen), gebruikt u het pad "/document/orgs/*/companyDescription" om dit te doen.
{
  "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
  "description": "This skill calls an Azure function, which in turn calls custom code",
  "uri": "https://indexer-e2e-webskill.azurewebsites.net/api/InvokeCode?code=<YOUR-FUNCTION-KEY>",
  "httpHeaders": {
      "Ocp-Apim-Subscription-Key": "<YOUR-APIM-KEY>"
  },
  "context": "/document/orgs/*",
  "inputs": [
    {
      "name": "query",
      "source": "/document/orgs/*"
    }
  ],
  "outputs": [
    {
      "name": "description",
      "targetName": "companyDescription"
    }
  ]
}
Uitvoer verzenden naar een bestemming
Hoewel u eventueel uitvoer van vaardigheden voor hergebruik in de cache kunt opslaan, is het meestal tijdelijk en bestaat deze alleen terwijl de uitvoering van vaardigheden wordt uitgevoerd.
Als u uitvoer naar een veld in een zoekindex wilt verzenden, maakt u een toewijzing van uitvoervelden in een indexeerfunctie.
Als u uitvoer naar een kennisarchief wilt verzenden, maakt u een projectie.
Als u uitvoer naar een downstream-vaardigheid wilt verzenden, verwijst u naar de uitvoer op basis van de naam van het knooppunt, zoals
"/document/organization", in de invoerbroneigenschap van de downstream-vaardigheid. Zie Verwijzing naar een aantekening voor voorbeelden.
Tips voor een eerste vaardighedenset
Probeer de wizard Gegevens importeren.
De wizard automatiseert verschillende stappen die de eerste keer lastig kunnen zijn. Hiermee definieert u de vaardighedenset, index en indexeerfunctie, inclusief veldtoewijzingen en uitvoerveldtoewijzingen. Het definieert ook projecties in een kennisarchief als u er een gebruikt. Voor sommige vaardigheden, zoals OCR of afbeeldingsanalyse, voegt de wizard hulpprogrammavaardigheden toe waarmee de afbeelding en tekstinhoud die tijdens het kraken van documenten zijn gescheiden, worden samengevoegd.
Nadat de wizard is uitgevoerd, kunt u elk object openen in Azure Portal om de JSON-definitie ervan weer te geven.
Probeer Debugsessies uit om de uitvoering van een vaardigheidsset uit te voeren op een doeldocument en inspecteer het verrijkte document dat door de vaardigheidsset wordt gemaakt. U kunt de invoer- en uitvoerinstellingen en -waarden weergeven en wijzigen. Deze zelfstudie is een goede plek om te beginnen: Zelfstudie: Fouten opsporen in een vaardighedenset met behulp van foutopsporingssessies.
Volgende stap
Context- en invoerbronvelden zijn paden naar knooppunten in een verrijkingsstructuur. Als volgende stap leert u meer over de padsyntaxis voor knooppunten in een verrijkingsstructuur.