Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Opmerking
Azure AI Zoeken is beschikbaar via de Azure-portal, REST API's en Azure-SDK's. Het vormt ook een basis voor Foundry IQ, de beheerde kennislaag die bedrijfsinhoud transformeert in herbruikbare, machtigingsbewuste knowledge bases voor agents in de Microsoft Foundry-portal.
In Azure AI Zoeken kunt u een indexeerfunctie op verschillende manieren uitvoeren:
- Direct uitvoeren bij het maken van de indexeerfunctie. Deze optie is de standaardinstelling, tenzij u de indexeerfunctie in een uitgeschakelde status maakt.
- Voer volgens een schema uit om de uitvoering regelmatig aan te roepen. Als een geplande indexeerfunctie stopt met activeren, raadpleegt u veelgestelde vragen over planningsgedrag voor herstelstappen.
- Op aanvraag uitvoeren, met of zonder opnieuw instellen.
In dit artikel wordt uitgelegd hoe u indexeerfuncties op aanvraag uitvoert, met en zonder opnieuw instellen. Ook worden de uitvoering, duur en gelijktijdigheid van de indexeerfunctie beschreven.
Hoe indexeerfuncties verbinding maken met Azure resources
Indexeerfuncties zijn een van de weinige subsystemen die uitgaande aanroepen naar andere Azure resources maken. Afhankelijk van de externe gegevensbron kunt u sleutels of rollen gebruiken om de verbinding te verifiëren.
In termen van Azure rollen hebben indexeerfuncties geen afzonderlijke identiteiten: een verbinding van de zoekmachine naar een andere Azure resource maakt gebruik van de door het systeem of de gebruiker toegewezen beheerde identiteit van een zoekservice, plus een roltoewijzing op de doel-Azure resource. Als de indexeerfunctie verbinding maakt met een Azure-resource in een virtueel netwerk, moet u een shared private link maken voor die verbinding.
Opmerking
Indexeerfuncties werken met machtigingen op serviceniveau in plaats van gebruikersmachtigingen. Een indexeerfunctie kan schrijven naar elke index in de zoekservice, zelfs als u rollen hebt toegewezen om de toegang tot specifieke indexen te beperken. Zie Bewerkingen per indexbereik en indexeerfunctie voor meer informatie.
Uitvoering van indexeerfunctie
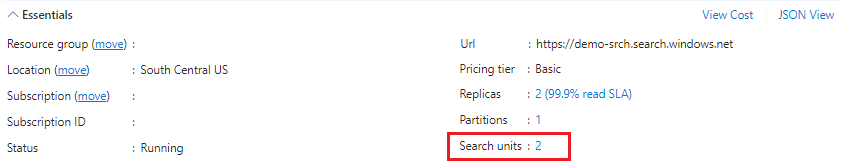
Een zoekservice voert één indexeertaak per zoekeenheid uit. Elke zoekservice begint met één zoekeenheid, maar elke nieuwe partitie of replica verhoogt de zoekeenheden van uw service. U kunt het aantal zoekeenheden controleren in de sectie Essential van de Azure-portal van de pagina Overview. Als u gelijktijdige verwerking nodig hebt, moet u ervoor zorgen dat uw zoekeenheden voldoende replica's bevatten. Indexers worden niet op de achtergrond uitgevoerd, dus mogelijk ervaart u meer beperkingen op aanvragen dan normaal als de service onder druk staat.
In de volgende schermopname ziet u het aantal zoekeenheden, waarmee wordt bepaald hoeveel indexeerfuncties tegelijk kunnen worden uitgevoerd.
Zodra de uitvoering van de indexeerfunctie is gestart, kunt u deze niet onderbreken of stoppen. De uitvoering van de indexeerfunctie stopt wanneer er geen documenten meer zijn om te laden of te vernieuwen, of wanneer de maximale uitvoeringstijdslimiet is bereikt.
U kunt meerdere indexeerfuncties tegelijk uitvoeren, ervan uitgaande dat er voldoende capaciteit is, maar elke indexeerfunctie zelf is één exemplaar. Als u een nieuw exemplaar start terwijl de indexeerfunctie al in uitvoering is, wordt deze fout gegenereerd: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Uitvoeringsomgeving voor indexeerfunctie
Een indexeertaak wordt uitgevoerd in een beheerde uitvoeringsomgeving. Er zijn momenteel twee omgevingen:
Een privé-uitvoeringsomgeving wordt uitgevoerd op zoekclusters die specifiek zijn voor uw zoekservice.
Een multitenant-omgeving heeft inhoudsprocessors die door Microsoft zonder extra kosten worden beheerd en beveiligd. Deze omgeving verplaatst rekenintensieve verwerking, zodat servicespecifieke middelen beschikbaar blijven voor routinetaken. Waar mogelijk worden de meeste vaardigheden uitgevoerd in de multitenant-omgeving. Deze omgeving is de standaardomgeving.
Rekenintensieve verwerking verwijst naar vaardighedensets die worden uitgevoerd op inhoudsprocessors en indexeerfuncties die een groot aantal documenten of documenten van grote grootte verwerken. Heuristieken en systeeminformatie bepalen de verwerking van niet-vaardighedensets op de multitenant-inhoudsprocessors en staat niet onder controle van de klant.
U kunt het gebruik van de omgeving met meerdere tenants voor Standard2 of hoger voorkomen door een indexeerfunctie en vaardighedenset uitsluitend vast te maken aan uw zoekclusters.
Stel de executionEnvironment parameter in de definitie van de indexeerfunctie in om altijd een indexeerfunctie uit te voeren in de privé-uitvoeringsomgeving.
IP-firewalls blokkeren de omgeving met meerdere tenants, dus als u een firewall hebt, maakt u een regel waarmee multitenantprocessorverbindingen zijn toegestaan.
De limieten voor indexeerfuncties variëren voor elke omgeving:
| Werklast | Maximumduur | Maximum aantal taken | Uitvoeringsomgeving |
|---|---|---|---|
| Privé-uitvoering | 24 uur | Eén indexeertaak per zoekeenheid1. | Indexering wordt niet op de achtergrond uitgevoerd. In plaats daarvan worden met de zoekservice alle indexeringstaken in balans met lopende query's en objectbeheeracties (zoals het maken of bijwerken van indexen). Bij het uitvoeren van indexeerfuncties zou u een querylatentie moeten zien als het indexeren van volumes groot is. |
| Multitenant | 2 uur 2 | Onbepaald 3 | Omdat het cluster voor inhoudsverwerking multitenant is, voegt het systeem inhoudsverwerkers toe om aan de vraag te voldoen. Als u een vertraging ondervindt in on-demand of geplande uitvoering, komt dit waarschijnlijk doordat het systeem processors toevoegt of wacht tot er een beschikbaar is. |
1 Zoekeenheden kunnen flexibele combinaties van partities en replica's zijn, maar indexeertaken zijn niet gekoppeld aan een of meer. Met andere woorden, als u 12 eenheden hebt, kunt u 12 indexeerfuncties tegelijk uitvoeren in privé-uitvoering, ongeacht hoe de zoekeenheden worden geïmplementeerd.
2 Als er meer dan twee uur nodig zijn om alle gegevens te verwerken, schakelt u wijzigingsdetectie in en plant u de indexeerfunctie met intervallen van vijf minuten om de indexering snel te hervatten als deze stopt vanwege een time-out. Zie Indexering van een grote gegevensset voor meer strategieën.
3 "Onbepaald" betekent dat de limiet niet wordt gekwantificeerd door het aantal taken. Sommige werkbelastingen, zoals het verwerken van vaardighedensets, kunnen parallel worden uitgevoerd, wat kan leiden tot veel taken, ook al is er slechts één indexeerfunctie betrokken. Hoewel de omgeving geen beperkingen oplegt, zijn er nog steeds indexeerlimieten voor uw zoekservice van toepassing.
Uitvoeren zonder opnieuw instellen
Een Run Indexer-bewerking detecteert en verwerkt alleen wat er nodig is om de zoekindex te synchroniseren met wijzigingen in de onderliggende gegevensbron. Incrementele indexering begint met het lokaliseren van een intern hoogwatermerk om het meest recent bijgewerkte zoekdocument te vinden. Dit document wordt het startpunt voor het uitvoeren van indexeerfuncties voor nieuwe en bijgewerkte documenten in de gegevensbron.
Wijzigingsdetectie is essentieel voor het bepalen wat er nieuw of bijgewerkt is in de gegevensbron. Indexeerfuncties gebruiken de mogelijkheden voor wijzigingsdetectie van de onderliggende gegevensbron om te bepalen wat er nieuw of bijgewerkt is in de gegevensbron.
Azure Storage heeft ingebouwde wijzigingsdetectie via de eigenschap LastModified.
Andere gegevensbronnen, zoals Azure SQL of Azure Cosmos DB, vereisen configuratie voor wijzigingsdetectie voordat de indexeerfunctie nieuwe en bijgewerkte rijen kan lezen.
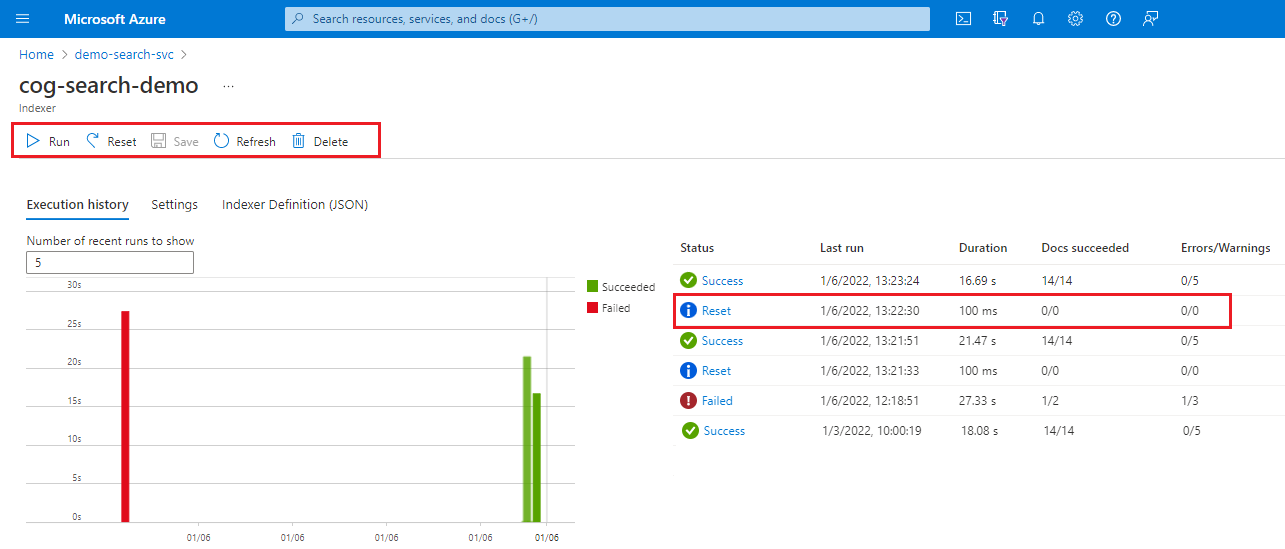
Als de onderliggende inhoud ongewijzigd is, heeft een uitvoeringsbewerking geen effect. In dit geval geeft 0\0 de uitvoeringsgeschiedenis van de indexeerfunctie documenten aan die zijn verwerkt.
Als u alle documenten opnieuw wilt verwerken, moet u de indexeerfunctie opnieuw instellen.
Indexeerfuncties opnieuw instellen
Na de eerste uitvoering houdt een indexeerfunctie bij welke zoekdocumenten worden geïndexeerd via een interne hoogwatermarkering. De markering wordt niet weergegeven, maar intern weet de indexeerfunctie waar deze voor het laatst is gestopt.
Als u alle of een deel van een index opnieuw wilt opbouwen, gebruikt u Reset-API's die beschikbaar zijn op afnemende niveaus in de objecthiërarchie:
- Indexeerders opnieuw instellen wist de high-water mark en voert een volledige herindexering van alle documenten uit.
- Indexeerfuncties opnieuw synchroniseren (preview) voert een efficiënte gedeeltelijke herindexering van alle documenten uit.
- Documenten opnieuw instellen (preview) indexeert een specifiek document of een specifieke lijst met documenten.
- Reset Skills (preview) roept vaardigheidsverwerking aan voor een specifieke vaardigheid.
Volg na het opnieuw instellen de opdracht Uitvoeren om nieuwe en bestaande documenten opnieuw te verwerken. U kunt verweesde zoekdocumenten die geen tegenhanger hebben in de gegevensbron niet verwijderen via opnieuw instellen en uitvoeren. Als u specifieke documenten wilt verwijderen, raadpleegt u Documenten verwijderen in een zoekindex of Documenten - Index.
Opmerking
Tabellen kunnen niet leeg zijn. Als u TRUNCATE TABLE gebruikt om rijen te wissen, worden de bijbehorende zoekdocumenten niet verwijderd als u de indexer opnieuw instelt en opnieuw uitvoert. Als u zwevende zoekdocumenten wilt verwijderen, moet u deze indexeren met een verwijderactie.
Indexeerfuncties opnieuw instellen en uitvoeren
Opnieuw instellen wist het hoogwatermerk. Alle documenten in de zoekindex worden gemarkeerd voor volledig overschrijven, zonder inline-updates of samenvoeging in bestaande inhoud. Voor indexeerders met een skillset en verrijkingscaching (preview-versie) wordt bij het opnieuw instellen van de index ook impliciet de skillset opnieuw ingesteld.
De werkelijke hoeveelheid werk vindt plaats wanneer u een reset volgt met de opdracht Uitvoeren:
- Alle nieuwe documenten die de onderliggende bron hebben gevonden, worden toegevoegd aan de zoekindex.
- Alle documenten in zowel de gegevensbron als de zoekindex worden overschreven in de zoekindex.
- Verrijkte inhoud die is gemaakt op basis van vaardighedensets, wordt opnieuw opgebouwd. De verrijkingscache, als deze is ingeschakeld, wordt vernieuwd.
Zoals eerder vermeld, is opnieuw instellen een passieve bewerking: u moet een Run-aanvraag volgen om de index opnieuw te bouwen.
Reset-/uitvoeringsbewerkingen zijn van toepassing op een zoekindex of een kennisarchief, op specifieke documenten of projecties en op verrijkingen in de cache als een reset expliciet of impliciet vaardigheden bevat.
Opnieuw instellen is ook van toepassing op het maken en bijwerken van bewerkingen. Het activeert geen verwijdering of opschonen van zwevende documenten in de zoekindex. Zie Documenten - Index voor meer informatie over het verwijderen van documenten.
U kunt een resetbewerking niet ongedaan maken.
Ga naar uw zoekservice in de Azure portal.
Selecteer op de pagina Overzicht het tabblad Indexeerfuncties .
Selecteer een indexeerfunctie.
Selecteer de opdracht Opnieuw instellen en selecteer vervolgens Ja om de actie te bevestigen.
Vernieuw de pagina om de status weer te geven. U kunt het item selecteren om de details ervan weer te geven.
Selecteer Uitvoeren om de verwerking van de indexeerfunctie te starten of wacht op de volgende geplande uitvoering.
Vaardigheden opnieuw instellen (preview)
De aanvraag Vaardigheden opnieuw instellen verwerkt selectief een of meer vaardigheden tijdens de volgende uitvoering van de indexeerfunctie. Voor indexeerfuncties met vaardighedensets kunt u afzonderlijke vaardigheden opnieuw instellen om alleen die vaardigheid opnieuw te verwerken en eventuele downstreamvaardigheden die afhankelijk zijn van de uitvoer. Als u de verrijkingscache hebt ingeschakeld, wordt de aanvraag ook vernieuwd.
Voor indexeerfuncties waarvoor caching is ingeschakeld, kunt u expliciet verwerking aanvragen voor vaardigheidsupdates die de indexeerfunctie niet kan detecteren. Als u bijvoorbeeld externe wijzigingen aanbrengt, zoals revisies in een aangepaste vaardigheid, gebruikt u deze API om de vaardigheid opnieuw uit te voeren. Het proces vernieuwt uitvoer, zoals een kennisarchief of zoekindex, met behulp van herbruikbare gegevens uit de cache en nieuwe inhoud volgens de bijgewerkte vaardigheid.
Gebruik de nieuwste preview-API.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
U kunt afzonderlijke vaardigheden opgeven, zoals wordt weergegeven in het vorige voorbeeld, maar als een van deze vaardigheden uitvoer vereist van niet-vermelde vaardigheden (#2 tot en met #4), worden niet-vermelde vaardigheden uitgevoerd, tenzij de cache de benodigde informatie kan verstrekken. Om deze voorwaarde waar te maken, mogen verrijkingen in de cache voor vaardigheden #2 tot en met #4 niet afhankelijk zijn van #1 (vermeld voor opnieuw instellen).
Als u geen vaardigheden opgeeft, voert het proces de hele vaardighedenset uit en vernieuwt de cache ook als caching is ingeschakeld.
Vergeet niet om op te volgen met Run Indexer om de werkelijke verwerking aan te roepen.
Documenten opnieuw instellen (preview)
De Indexeerfuncties - Docs opnieuw instellen (preview) API accepteert een lijst met documentsleutels, zodat u specifieke documenten kunt vernieuwen. Als u de parameters voor opnieuw instellen opgeeft, bepalen ze alleen wat wordt verwerkt, ongeacht andere wijzigingen in de onderliggende gegevens. Als er bijvoorbeeld 20 blobs zijn toegevoegd of bijgewerkt sinds de laatste uitvoering van de indexeerfunctie, maar u slechts één document opnieuw instelt, verwerkt de indexeerfunctie alleen dat document.
Per document vernieuwt de indexeerfunctie alle velden in het zoekdocument met waarden en metagegevens uit de gegevensbron. U kunt niet kiezen welke velden u wilt vernieuwen.
Als de gegevensbron is Azure Data Lake Storage (ADLS) Gen2 en de blobs zijn gekoppeld aan metagegevens van machtigingen, neemt de indexeerfunctie deze machtigingen opnieuw op in de zoekindex als machtigingen in de onderliggende gegevens worden gewijzigd. Zie ACL- en RBAC-bereik opnieuw indexeren met ADLS Gen2-indexeerfuncties voor meer informatie.
Als u het document verrijkt via een vaardighedenset en gegevens in de cache heeft, roept de indexeerfunctie de vaardighedenset voor alleen de opgegeven documenten aan en werkt de cache voor de opnieuw verwerkte documenten bij.
Wanneer u deze API voor het eerst test, kunnen de volgende API's u helpen het gedrag te valideren en te testen. Gebruik de nieuwste preview-API.
Roep Indexeerders - Haal de status op door een preview-API-versie te gebruiken om de resetstatus en uitvoeringsstatus te controleren. U vindt informatie over de aanvraag voor opnieuw instellen aan het einde van het statusantwoord.
Indexeerfuncties aanroepen: stel Docs opnieuw in met een preview-API-versie om op te geven welke documenten moeten worden verwerkt.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
De API accepteert twee typen document-id's als invoer: documentsleutels die documenten uniek identificeren in een zoekindex en document-id's voor gegevensbronnen waarmee documenten in een gegevensbron uniek worden geïdentificeerd. De hoofdtekst moet een lijst met documentsleutels of een lijst met document-id's van de gegevensbron bevatten waarnaar de indexeerfunctie zoekt in de gegevensbron. Als u de API aanroept, worden de documentsleutels of document-id's van de gegevensbron toegevoegd om de metagegevens van de indexeerfunctie opnieuw in te stellen. Bij de volgende geplande of on-demand uitvoering van de indexer verwerkt de indexer alleen de opnieuw ingestelde documenten.
Als u documentsleutels gebruikt om documenten te resetten en uw documentsleutels worden vermeld in een map voor indexervelden, gebruikt de indexeerder veldmapping om het juiste veld in de onderliggende gegevensbron te vinden.
De documentsleutels die u in de aanvraag opgeeft, zijn waarden uit de zoekindex, die kunnen afwijken van de bijbehorende velden in de gegevensbron. Als u niet zeker weet wat de sleutelwaarde is, stuurt u een query om de waarde te retourneren. U kunt
selectgebruiken om alleen het documentsleutelveld te retourneren.Voor blobs die de indexer opsplitst in meerdere zoekdocumenten (waarbij
parsingModeis ingesteld op jsonLines of jsonArrays of delimitedText), genereert de indexer de documentsleutel en bent u mogelijk onbekend voor de indexer. In dit scenario retourneert een query voor de documentsleutel de juiste waarde.Als u wilt dat de indexer stopt met het verwerken van documenten die opnieuw moeten worden ingesteld, stelt u
"documentKeys"of"datasourceDocumentIds"in op een lege lijst[]. Deze actie zorgt ervoor dat de indexer de reguliere indexering hervat op basis van de high water mark. Ongeldige documentsleutels of documentsleutels die niet bestaan, worden genegeerd.
Roep Run Indexer (elke API-versie) aan om de documenten te verwerken die u hebt opgegeven. De indexeerfunctie indexeert alleen die specifieke documenten.
Roep Run Indexer een tweede keer aan om te verwerken vanaf de laatste bovengrens.
Roep Zoekdocumenten aan om te controleren op bijgewerkte waarden en om documentsleutels te retourneren als u niet zeker weet wat de waarde is. Gebruik
"select": "<field names>"deze optie als u wilt beperken welke velden in het antwoord worden weergegeven.
De lijst met documentsleutels overschrijven
Als u de API Documenten opnieuw instellen meerdere keren aanroept met verschillende sleutels, worden de nieuwe sleutels toegevoegd aan de lijst met documentsleutels die opnieuw worden ingesteld. Als u de API aanroept met de overwrite parameter die is ingesteld op true, wordt de huidige lijst vervangen door de nieuwe:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Indexeerfuncties opnieuw synchroniseren (preview)
Opnieuw Synchroniseren van Indexers is een voorproef-REST API die een gedeeltelijke herindexering van alle documenten uitvoert. Een indexeerfunctie wordt beschouwd als gesynchroniseerd met de gegevensbron wanneer specifieke velden van alle documenten in de doelindex consistent zijn met de gegevens in de gegevensbron. Normaal gesproken bereikt een indexeerfunctie synchronisatie na een geslaagde eerste uitvoering. Als u een document uit de gegevensbron verwijdert, blijft de indexeerfunctie gesynchroniseerd volgens deze definitie. Tijdens de volgende uitvoering van de indexeerfunctie wordt het bijbehorende document in de doelindex echter verwijderd als bijhouden van verwijderen is ingeschakeld.
Als u een document in de gegevensbron wijzigt, wordt de indexeerfunctie niet gesynchroniseerd. Over het algemeen worden de indexeerfunctie tijdens de volgende uitvoering opnieuw gesynchroniseerd met mechanismen voor het bijhouden van wijzigingen. Als u bijvoorbeeld in Azure Storage een blob wijzigt, wordt de laatste wijzigingstijd bijgewerkt, zodat de indexeerfunctie deze opnieuw kan indexeren in de volgende indexeerfunctie, omdat de bijgewerkte tijd de bovengrens overschrijdt die is ingesteld door de vorige uitvoering.
In tegenstelling tot bepaalde gegevensbronnen zoals ADLS Gen2, verandert het wijzigen van de toegangsbeheerlijsten (ACL's) van een blob de laatste wijzigingstijd niet, zodat het bijhouden van wijzigingen ineffectief is als ACL's moeten worden opgenomen. De gewijzigde blob wordt daarom niet opnieuw geïndexeerd in de volgende uitvoering, omdat alleen documenten die zijn gewijzigd na het laatste hoogwatermerk worden verwerkt.
Tijdens het gebruik van 'opnieuw instellen' of 'documenten opnieuw instellen' kan dit probleem worden opgelost, kan 'opnieuw instellen' tijdrovend en inefficiënt zijn voor grote gegevenssets, en 'documenten opnieuw instellen' vereist het identificeren van de documentsleutel van de blob die u wilt bijwerken.
Resynchroon indexeerfuncties biedt een efficiënt en handig alternatief. U plaatst de indexeerfunctie in de modus voor opnieuw synchroniseren en geeft de inhoud op die opnieuw moet worden gesynchroniseerd door de API voor opnieuw synchroniseren aan te roepen. In de volgende uitvoering inspecteert de indexeerfunctie alleen het relevante gedeelte van de gegevens in de bron en voorkomt onnodige verwerking die niet is gerelateerd aan de opgegeven gegevens. Ook worden de bestaande documenten in de doelindex opgevraagd en worden alleen de documenten bijgewerkt die verschillen tussen de gegevensbron en de doelindex tonen. Nadat de hersynchronisatie is uitgevoerd, wordt de indexeerder gesynchroniseerd en keert deze terug naar de normale uitvoeringsmodus voor volgende uitvoeringen.
Indexeerfuncties opnieuw synchroniseren en uitvoeren
Indexeerfuncties aanroepen: hersynchronisatie met een preview-API-versie om op te geven welke inhoud opnieuw moet worden gesynchroniseerd.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- Het
optionsveld is vereist. Momenteel ispermissionsde enige ondersteunde optie. Dat wil gezegd, alleen machtigingsfiltervelden in de doelindex worden bijgewerkt.
- Het
Roep Run Indexer (elke API-versie) aan om de indexeerfunctie opnieuw te synchroniseren.
Roep Run Indexer een tweede keer aan om te verwerken vanaf de laatste bovengrens.
Status 'currentState' opnieuw instellen controleren
Voer de volgende stappen uit om de status van het opnieuw instellen te controleren en te zien welke documentsleutels in de wachtrij staan voor verwerking:
Indexeerstatus ophalen aanroepen met behulp van een preview-API.
De preview-API retourneert de
currentStatesectie aan het einde van het antwoord."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Controleer de 'modus':
Voor Reset Skills stelt u 'modus' in op
indexingAllDocs, omdat mogelijk alle documenten worden beïnvloed wat betreft de velden die door AI-verrijking worden ingevuld.Als u indexeerfuncties opnieuw wilt synchroniseren, stelt u de modus in op
indexingResync. De indexeerfunctie controleert alle documenten en richt zich op geïnteresseerde gegevens in de gegevensbron en geïnteresseerde velden in de doelindex.Als u documenten opnieuw wilt instellen, stelt u de modus in op
indexingResetDocs. De indexeerfunctie behoudt deze status totdat alle documentsleutels die zijn opgegeven in de aanroep voor het opnieuw instellen van documenten, zijn verwerkt. Tijdens deze periode worden er geen andere indexeertaken uitgevoerd zolang de bewerking wordt uitgevoerd. Om alle documenten in de lijst met documentsleutels te vinden, moet elk document worden ontleed om de sleutel te lokaliseren en te matchen. Dit proces kan even duren als de gegevensset groot is. Als een blobcontainer honderden blobs bevat en de documenten die u opnieuw wilt instellen, aan het einde staan, vindt de indexeerfunctie de overeenkomende blobs pas nadat alle andere blobs zijn gecontroleerd.Nadat de indexer de documenten opnieuw heeft verwerkt, voert u Get Indexer Status opnieuw uit. De indexeerfunctie keert terug naar de
indexingAllDocsmodus en verwerkt nieuwe of bijgewerkte documenten tijdens de volgende uitvoering.
Controleer het runtimequotum van de indexeerfunctie voor S3 HD en serverloze zoekservices
Deze sectie is van toepassing op Standard 3 High Density (S3 HD) en serverloze zoekservices. Zie Uitvoering van de indexeerfunctie op Serverless en S3 HD (preview) voor richtlijnen over het gedrag van geaggregeerde quota en planning.
Elke indexeerfunctieuitvoering heeft een maximum van twee uur. Los daarvan delen alle indexeerders per service 24 uur aan cumulatieve uitvoeringstijd binnen elke UTC-periode van 24 uur.
Om u te helpen de looptijden van de indexeerfunctie binnen het 24-uurs venster te bewaken, geven Service Statistics ophalen en Indexer Status ophalen nu meer gedetailleerde informatie in de respons terug.
Cumulatief runtimequotum bijhouden
Houd het cumulatieve runtimegebruik van de indexeerfunctie van een zoekservice bij en bepaal hoeveel runtimequotum er nog is binnen het huidige 24-uursvenster.
Verzend een GET-aanvraag naar het eindpunt van de zoekservice. Zie Verbinding maken met een zoekservice voor hulp bij het instellen van een REST-client en het ophalen van een toegangstoken.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Antwoorden bevatten indexersRuntime eigenschappen die de begin- en eindtijden van het venster weergeven, cumulatieve seconden die door alle indexeerfuncties worden gebruikt en seconden die resteren voor de service.
Looptijdquotum van indexeerder monitoren
Dezelfde informatie retourneren voor één indexeerfunctie.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Antwoorden bevatten runtime eigenschappen die de begin- en eindtijden van het venster weergeven, seconden die door de indexeerfunctie worden gebruikt en seconden die resteren voor alle indexeerfuncties in de service.
Volgende stappen
Reset-API's worden gebruikt om het bereik van de volgende uitvoering van de indexeerfunctie te informeren. Voor de werkelijke verwerking moet u een indexeerfunctie op aanvraag aanroepen of een geplande taak toestaan om het werk te voltooien. Nadat de uitvoering is voltooid, keert de indexeerfunctie terug naar de normale verwerking, ongeacht of dit volgens een schema of op aanvraag wordt verwerkt.
Nadat u indexeertaken opnieuw hebt ingesteld en opnieuw hebt uitgevoerd, kunt u de status van de zoekservice controleren of gedetailleerde informatie verkrijgen via resourcelogboekregistratie.