참고
Azure AI 검색 Azure 포털, REST API 및 Azure SDK 통해 사용할 수 있습니다. 또한 엔터프라이즈 콘텐츠를 Microsoft Foundry 포털의 에이전트에 대해 재사용 가능한 사용 권한 인식 기술 자료로 변환하는 관리되는 기술 계층인 Foundry IQ를 뒷받침합니다.
Azure AI 검색에 vector 인덱스가 있는 경우, 이 문서에서는 다음과 같은 방법을 설명합니다.
이 문서에서는 그림에 REST를 사용합니다. 기본 워크플로를 이해한 후에는 벡터 쿼리를 포함하는 엔드투엔드 솔루션을 제공하는 azure-search-vector-samples 리포지토리의 Azure SDK 코드 샘플을 계속 진행합니다.
Azure 포털에서 Search Explorer 사용할 수도 있습니다.
필수 구성 요소
모든 지역의 모든 계층에서 사용할 수 있는 Azure AI 검색 서비스.
벡터 인덱스입니다. 인덱스에서
vectorSearch섹션의 존재 여부를 확인하십시오.필요에 따라 쿼리 중에 기본 제공 텍스트-벡터 변환 또는 이미지-벡터 변환을 위해 인덱스에 벡터 라이저를 추가 합니다.
이러한 예제를 직접 실행하고 싶다면 Visual Studio Code와 함께 REST 클라이언트 및 샘플 데이터를 사용하세요. REST 클라이언트를 시작하려면 빠른 시작: REST를 사용한 전체 텍스트 검색을 참조하세요.
쿼리 문자열 입력을 벡터로 변환
벡터 필드를 쿼리하려면 쿼리 자체가 벡터여야 합니다.
사용자의 텍스트 쿼리 문자열을 벡터 표현으로 변환하는 한 가지 방법은 애플리케이션 코드에 포함 라이브러리 또는 API를 호출하는 것입니다. 항상 원본 문서에 포함을 생성하는 데 사용되는 것과 동일한 포함 모델을 사용하는 것이 가장 좋습니다. embeddings를 생성하는 방법을 보여 주는 코드 샘플을 azure-search-vector-samples 리포지토리에서 찾을 수 있습니다.
두 번째 방법은 이제 일반적으로 사용 가능하게 된 통합 벡터화를 사용하여 Azure AI 검색가 쿼리 벡터화 입력 및 출력을 처리하도록 하는 것입니다.
다음은 Azure OpenAI 포함 모델의 배포에 제출된 쿼리 문자열의 REST API 예제입니다.
POST https://{{openai-service-name}}.openai.azure.com/openai/deployments/{{openai-deployment-name}}/embeddings?api-version={{openai-api-version}}
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "input": "what azure services support generative AI'"
}
배포된 모델에 대한 성공적인 호출에 대한 예상 응답은 202입니다.
embedding 응답 본문의 필드는 쿼리 문자열input의 벡터 표현입니다. 테스트를 위해 다음 몇 섹션에 표시된 구문을 사용하여 배열 embedding 값을 vectorQueries.vector 쿼리 요청에 복사합니다.
배포된 모델에 대한 이 POST 호출에 대한 실제 응답에는 1,536개의 포함 항목이 포함됩니다. 가독성을 위해 이 예제에서는 처음 몇 개의 벡터만 보여 줍니다.
{
    "object": "list",
    "data": [
        {
            "object": "embedding",
            "index": 0,
            "embedding": [
                -0.009171937,
                0.018715322,
                ...
                -0.0016804502
            ]
        }
    ],
    "model": "ada",
    "usage": {
        "prompt_tokens": 7,
        "total_tokens": 7
    }
}
이 방법에서 애플리케이션 코드는 모델에 연결하고, 포함을 생성하고, 응답을 처리합니다.
벡터 쿼리 요청
이 섹션에서는 벡터 쿼리의 기본 구조를 보여줍니다. Azure 포털, REST API 또는 Azure SDK 사용하여 벡터 쿼리를 작성할 수 있습니다.
2023-07-01-preview에서 마이그레이션하는 경우 주요 변경 내용이 있습니다. 자세한 내용은 최신 REST API로 업그레이드를 참조하세요.
안정적인 버전은 다음을 지원합니다.
-
vectorQueries는 벡터 검색의 구문입니다. -
vectorQueries.kind을 (는) 입력이 벡터 배열인 경우vector로, 문자열이며 벡터라이저를 가진 경우text로 설정합니다. -
vectorQueries.vector는 쿼리(텍스트 또는 이미지의 벡터 표현)입니다. -
vectorQueries.exhaustive(선택 사항) 필드가 HNSW용으로 인덱싱된 경우에도 쿼리 시간에 전체 KNN을 호출합니다. -
vectorQueries.fields(선택 사항) 쿼리 실행을 위한 특정 필드를 대상으로 합니다(쿼리당 최대 10개). -
vectorQueries.weight(선택 사항)은 검색 작업에 포함된 각 벡터 쿼리의 상대적 가중치를 지정합니다. 자세한 내용은 벡터 가중치를 참조하세요. -
vectorQueries.k는 반환할 일치 항목의 수입니다.
다음 예제에서 벡터는 이 문자열의 표현입니다. "what Azure services support full text search". 쿼리는 contentVector 필드를 대상으로 하고 k 결과를 반환합니다. 실제 벡터에는 가독성을 위해 이 예제에서 잘리는 1,536개의 포함 항목이 있습니다.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector",
            "weight": 0.5,
            "k": 5
        }
    ]
}
벡터 쿼리 응답
Azure AI 검색 쿼리 응답은 기본적으로 모든 retrievable 필드로 구성됩니다. 다만, retrievable 문에서 특정 select 필드만 지정해 검색 결과를 그 일부로 제한하는 경우가 흔합니다.
벡터 쿼리에서 응답에서 필드를 벡터해야 하는지 여부를 신중하게 고려합니다. 벡터 필드는 사람이 읽을 수 없으므로 웹 페이지에 응답을 푸시하는 경우 결과를 나타내는 비벡터 필드를 선택해야 합니다. 예를 들어 쿼리가 contentVector에 대해 실행된다면, 대신 content를 반환할 수 있습니다.
결과에 벡터 필드를 원하는 경우 응답 구조의 예는 다음과 같습니다.
contentVector 가독성을 위해 이 예제에서 잘려진 embeddings의 문자열 배열입니다. 검색 점수는 관련성을 나타냅니다. 다른 비벡터 필드는 컨텍스트에 포함됩니다.
{
    "@odata.count": 3,
    "value": [
        {
            "@search.score": 0.80025613,
            "title": "Azure Search",
            "category": "AI + Machine Learning",
            "contentVector": [
                -0.0018343845,
                0.017952163,
                0.0025753193,
                ...
            ]
        },
        {
            "@search.score": 0.78856903,
            "title": "Azure Application Insights",
            "category": "Management + Governance",
            "contentVector": [
                -0.016821077,
                0.0037742127,
                0.016136652,
                ...
            ]
        },
        {
            "@search.score": 0.78650564,
            "title": "Azure Media Services",
            "category": "Media",
            "contentVector": [
                -0.025449317,
                0.0038463024,
                -0.02488436,
                ...
            ]
        }
    ]
}
핵심 사항:
k는 반환되는 가장 가까운 인접 결과 수를 결정합니다(이 경우 3개). 벡터 쿼리는 일부 문서의 유사성이 좋지 않더라도 적어도k문서가 있다고 가정하여 항상 결과를 반환k합니다. 이는 알고리즘이 쿼리 벡터에 대해 임의의k개의 최근접 이웃을 탐색하기 때문입니다.벡터 검색 알고리즘
@search.score은 결정한다.검색 결과의 필드는
retrievable필드 모두 또는select절 내의 필드입니다. 벡터 쿼리를 실행하는 동안 벡터 데이터에서만 일치가 이루어집니다. 그러나 응답에는 인덱스 내의 모든retrievable필드가 포함될 수 있습니다. 벡터 필드 결과를 디코딩할 수 있는 기능이 없으므로 비벡터 텍스트 필드를 포함하면 사람이 읽을 수 있는 값에 유용합니다.
여러 벡터 필드
속성을 여러 벡터 필드로 설정할 vectorQueries.fields 수 있습니다. 벡터 쿼리는 목록에 제공하는 fields 각 벡터 필드에 대해 실행됩니다. 최대 10개 필드를 지정할 수 있습니다.
여러 벡터 필드를 쿼리할 때 각 벡터 필드에 동일한 포함 모델의 포함 항목이 포함되어 있는지 확인합니다. 쿼리는 동일한 포함 모델에서도 생성되어야 합니다.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector, titleVector",
            "k": 5
        }
    ]
}
여러 벡터 쿼리
다중 쿼리 벡터 검색은 검색 인덱스의 여러 벡터 필드에 여러 쿼리를 보냅니다. 이 유형의 쿼리는 일반적으로 동일한 모델이 텍스트와 이미지를 모두 벡터화할 수 있는 다중 모달 검색을 위한 CLIP 과 같은 모델에서 사용됩니다.
다음 쿼리 예제에서는 둘 다 myImageVectormyTextVector 에서 유사성을 찾고 각각 병렬로 실행되는 두 개의 쿼리 포함을 보냅니다. 이 쿼리의 결과는 RRF( 상호 순위 융합 )를 사용하여 점수가 매겨집니다.
-
vectorQueries는 벡터 쿼리의 배열을 제공합니다. -
vector에는 검색 인덱스의 이미지 벡터 및 텍스트 벡터가 포함됩니다. 각 인스턴스는 별도의 쿼리입니다. -
fields는 대상으로 지정할 벡터 필드를 지정합니다. -
k는 결과에 포함할 가장 가까운 인접 항목의 수입니다.
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "fields": "myimagevector",
            "k": 5
        },
        {
            "kind": "vector"
            "vector": [
                -0.002222222,
                0.018708462,
                -0.013770515,
            . . .
            ],
            "fields": "mytextvector",
            "k": 5
        }
    ]
}
검색 인덱스는 이미지를 저장할 수 없습니다. 인덱스가 이미지 파일에 대한 필드를 포함하고 있다고 가정하면 검색 결과에는 텍스트와 이미지의 조합이 포함됩니다.
통합 벡터화를 사용하여 쿼리
이 섹션에서는 텍스트 또는 이미지 쿼리를 벡터로 변환하기 위해 통합된 벡터화를 호출하는 벡터 쿼리 를 보여줍니다. 이 기능에 대한 안정적인 2026-04-01 REST API, 검색 탐색기 또는 최신 Azure SDK 패키지를 사용하는 것이 좋습니다.
필수 구성 요소는 벡터라이저가 구성되고 벡터 필드에 할당된 검색 인덱스입니다. 벡터라이저는 쿼리 시간에 사용되는 포함 모델에 대한 연결 정보를 제공합니다.
검색 탐색기는 쿼리 시 통합 벡터화를 지원합니다. 인덱스에 벡터 필드가 있고 벡터라이저가 있는 경우 기본 제공 텍스트-벡터 변환을 사용할 수 있습니다.
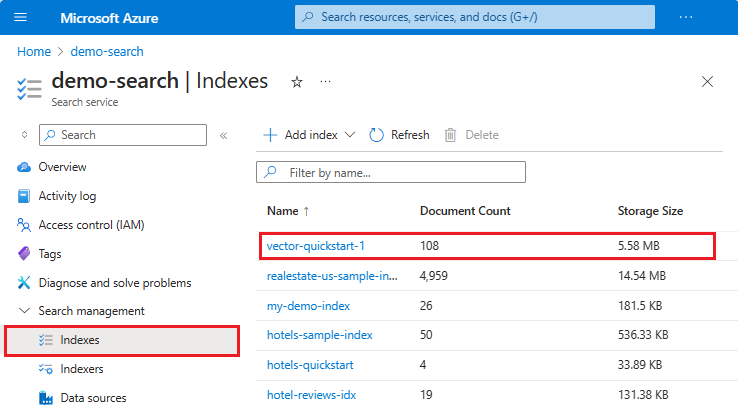
Azure 포털 검색 서비스로 이동합니다.
왼쪽 메뉴에서 검색 관리>인덱스를 선택한 다음, 인덱스를 선택합니다.
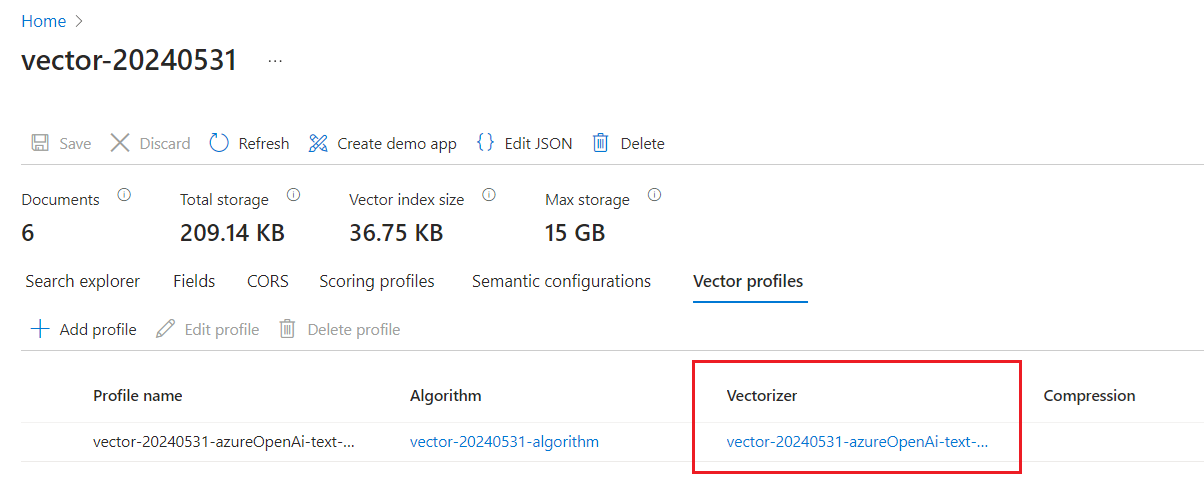
벡터 프로필 탭을 선택하여 벡터라이저가 있는지 확인합니다.
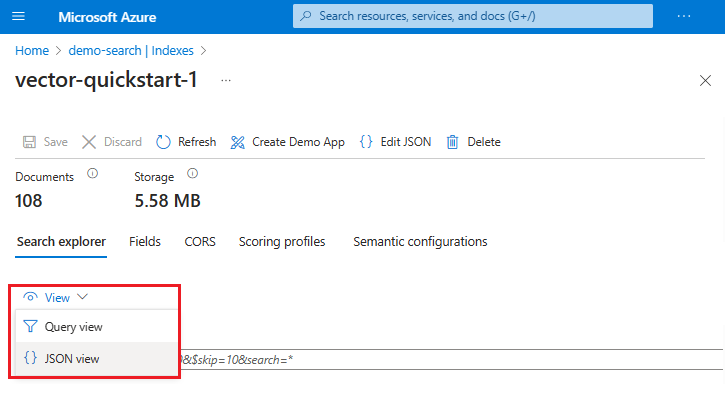
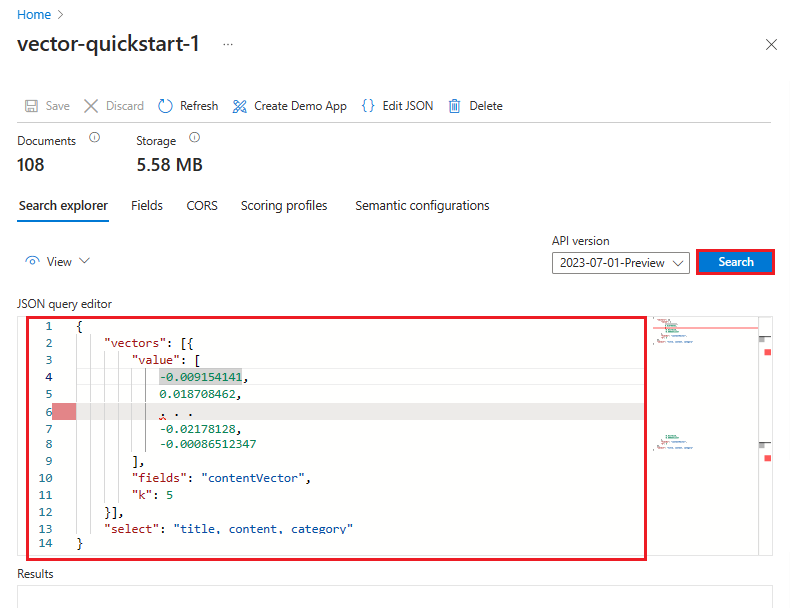
검색 탐색기 탭을 선택합니다. 기본 쿼리 뷰를 사용하여 검색 창에 텍스트 문자열을 입력할 수 있습니다. 기본 제공 벡터라이저는 문자열을 벡터로 변환하고, 검색을 수행하고, 결과를 반환합니다.
또는JSON 보기 보기를> 선택하여 쿼리를 보거나 수정할 수 있습니다. 벡터가 있는 경우 검색 탐색기는 자동으로 벡터 쿼리를 설정합니다. JSON 보기를 사용하여 검색 및 응답에서 사용할 필드를 선택하고, 필터를 추가하고, 하이브리드 쿼리와 같은 고급 쿼리를 생성할 수 있습니다. JSON 예제를 보려면 이 섹션에서 REST API 탭을 선택합니다.
벡터 쿼리 응답의 순위가 지정된 결과 수
벡터 쿼리는 결과에 반환되는 일치 항목 수를 결정하는 매개 변수를 지정 k 합니다. 검색 엔진은 항상 일치 항목 수를 반환 k 합니다. 인덱스의 문서 수보다 큰 경우 k 문서 수가 반환할 수 있는 항목의 상한을 결정합니다.
전체 텍스트 검색에 익숙한 경우 인덱스가 용어 또는 구를 포함하지 않는 경우 0개의 결과를 예상해야 합니다. 그러나 벡터 검색에서 검색 작업은 가장 가까운 인접 항목을 식별하고 가장 가까운 인접 항목이 유사하지 않더라도 항상 결과를 반환 k 합니다. 특히 프롬프트를 사용하여 경계를 설정하지 않는 경우 무의미하거나 토픽이 아닌 쿼리에 대한 결과를 얻을 수 있습니다. 관련성이 낮은 결과는 유사성 점수가 더 좋지만 더 가까운 항목이 없으면 여전히 "가장 가까운" 벡터입니다. 따라서 의미 있는 결과가 없더라도 응답은 k 결과를 반환할 수 있지만, 각 결과의 유사성 점수가 낮게 나타날 것입니다.
전체 텍스트 검색을 포함하는 하이브리드 접근 방식은 이 문제를 완화할 수 있습니다. 또 다른 해결 방법은 쿼리가 순수 단일 벡터 쿼리인 경우에만 검색 점수에 대한 최소 임계값을 설정하는 것입니다. 하이브리드 쿼리는 RRF 범위가 훨씬 작고 휘발성이 높기 때문에 최소 임계값에 도움이 되지 않습니다.
결과 수에 영향을 주는 쿼리 매개 변수는 다음과 같습니다.
-
"k": n벡터 전용 쿼리에 대한 결과입니다. -
"top": n매개 변수를 포함하는 하이브리드 쿼리에 대한 결과입니다search.
둘 다 k와 top는 선택 사항입니다. 지정되지 않은 경우 응답의 기본 결과 수는 50입니다. 기본값을 변경하거나 더 많은 결과를 페이지로 넘길 수 있도록 top 및 skip을 설정할 수 있습니다.
벡터 쿼리에 사용되는 순위 알고리즘
결과의 순위는 다음 중 하나를 통해 계산됩니다.
- 유사성 메트릭입니다.
- 여러 검색 결과 집합이 있는 경우 RRF입니다.
유사성 메트릭
벡터 전용 쿼리의 인덱 vectorSearch 스 섹션에 지정된 유사성 메트릭입니다. 유효한 값은 cosine, euclidean및 dotProduct.
Azure OpenAI 포함 모델은 코사인 유사성을 사용하므로 Azure OpenAI 포함 모델을 사용하는 경우 cosine 권장되는 메트릭입니다. 지원되는 기타 순위 메트릭에는 euclidean 및 dotProduct이 포함됩니다.
RRF
쿼리가 여러 벡터 필드를 대상으로 하거나, 여러 벡터 쿼리를 병렬로 실행하거나, 의미 체계 순위가 있거나 없는 벡터 및 전체 텍스트 검색의 하이브리드인 경우 여러 집합이 만들어집니다.
쿼리를 실행하는 동안 벡터 쿼리는 하나의 내부 벡터 인덱스만 대상으로 지정할 수 있습니다. 여러 벡터 필드 및 여러 벡터 쿼리의 경우 검색 엔진은 각 필드의 각 벡터 인덱스를 대상으로 하는 여러 쿼리를 생성합니다. 출력은 RRF를 사용하여 융합되는 각 쿼리에 대한 순위가 매겨진 결과 집합입니다. 자세한 내용은 상호 순위 Fusion을 사용한 관련성 점수를 참조하세요.
벡터 가중치
쿼리 매개 변수를 weight 추가하여 검색 작업에 포함된 각 벡터 쿼리의 상대적 가중치를 지정합니다. 이 값은 동일한 요청의 두 개 이상의 벡터 쿼리 또는 하이브리드 쿼리의 벡터 부분에서 생성된 여러 순위 목록의 결과를 결합할 때 사용됩니다.
기본값은 1.0이며 값은 0보다 큰 양수여야 합니다.
가중치는 각 문서의 RRF 점수를 계산할 때 사용됩니다. 계산은 해당 결과 집합 내 문서의 순위 점수에 weight 값을 곱한 결과입니다.
다음 예제는 두 개의 벡터 쿼리 문자열과 하나의 텍스트 문자열이 있는 하이브리드 쿼리입니다. 가중치는 벡터 쿼리에 할당됩니다. 첫 번째 쿼리는 가중치의 0.5 또는 절반이므로 요청의 중요성이 줄어듭니다. 두 번째 벡터 쿼리는 두 배 더 중요합니다.
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-04-01

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my_first_vector_field",
          "k": 10,
          "weight": 0.5
        },
        {
          "kind": "vector",
          "vector": [4.0, 5.0, 6.0],
          "fields": "my_second_vector_field",
          "k": 10,
          "weight": 2.0
        }
      ],
      "search": "hello world"
    }
벡터 가중치는 벡터에만 적용됩니다. 이 예제 "hello world"의 텍스트 쿼리는 암시적 중립 가중치가 1.0입니다. 그러나 하이브리드 쿼리에서는 maxTextRecallSize를 설정하여 텍스트 필드의 중요도를 늘리거나 줄일 수 있습니다.
낮은 점수 매기기 결과를 제외하도록 임계값 설정(미리 보기)
최근접 이웃 검색은 항상 요청된 k개의 이웃을 반환하므로, 검색 결과의 k 개수 요구사항을 충족하는 과정에서 점수가 낮은 일치 항목이 포함될 수 있습니다. 점수가 낮은 검색 결과를 제외하려면 최소 점수에 따라 결과를 필터링하는 쿼리 매개 변수를 추가할 threshold 수 있습니다. 필터링은 다른 회수 집합의 결과를 융합 하기 전에 발생합니다.
이 매개 변수는 미리 보기 상태입니다. 최신 미리 보기 버전의 문서 - 검색 게시물 (REST API)을 사용하는 것이 좋습니다.
이 예제에서는 점수가 0.8보다 낮은 모든 일치 항목이 벡터 검색 결과에서 제외됩니다. 결과 수가 k보다 적어져도 제외됩니다.
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-08-01-preview
    Content-Type: application/json
    api-key: [admin key]

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my-cosine-field",
          "threshold": {
            "kind": "vectorSimilarity",
            "value": 0.8
          }
        }
      ]
    }
다음 단계
다음 단계로 Python, C# 또는 JavaScript 벡터 쿼리 코드 예제를 검토합니다.