참고
Azure AI 검색 Azure 포털, REST API 및 Azure SDK 통해 사용할 수 있습니다. 또한 엔터프라이즈 콘텐츠를 Microsoft Foundry 포털의 에이전트에 대해 재사용 가능한 사용 권한 인식 기술 자료로 변환하는 관리되는 기술 계층인 Foundry IQ를 뒷받침합니다.
Azure AI 검색의 시맨틱 랭커는 Microsoft의 언어 이해 모델을 사용하여 검색 결과를 재정렬하여 검색 관련성을 크게 향상시키는 기능입니다. 시맨틱 랭커는 에이전트 검색에 내장되어 있습니다. 이 문서는 의미 체계 순위자의 동작과 이점을 이해하는 데 도움이 되는 개략적인 소개입니다.
의미 체계 순위는 사용량으로 청구되는 프리미엄 기능이지만 무료 계층에 대한 서비스 제한 에 따라 무료로 사용할 수 있습니다. 백그라운드에서 이 문서를 사용하는 것이 좋지만, 시작하려면 다음 단계를 따르세요.
의미 체계 순위란?
의미 체계 순위는 텍스트 기반 쿼리, 벡터 쿼리의 텍스트 부분 및 하이브리드 쿼리에 대한 초기 BM25 순위 또는 RRF 순위 검색 결과의 품질을 향상시키는 쿼리 쪽 기능의 컬렉션입니다. 의미 체계 순위는 세 가지 방법으로 쿼리 실행 파이프라인을 확장합니다.
먼저 BM25 또는 RRF(상호 순위 퓨전)를 사용하여 점수가 매겨진 초기 결과 집합보다 항상 보조 순위를 추가합니다. 이 보조 순위는 Microsoft Bing에서 조정한 다국어 딥 러닝 모델을 사용하여 가장 의미론적으로 관련성이 높은 결과를 승격합니다.
둘째, 캡션을 반환하고 필요에 따라 응답에서 답변을 추출하여 검색 페이지에서 렌더링하여 사용자의 검색 환경을 개선할 수 있습니다.
셋째, 쿼리 다시 쓰기를 사용하도록 설정하면 초기 쿼리 문자열을 의미상 유사한 여러 쿼리 문자열로 확장합니다.
보조 순위 및 "답변"은 쿼리 응답에 적용됩니다. 쿼리 다시 쓰기는 쿼리 요청의 일부입니다.
의미 체계 순위에는 다음과 같은 기능이 있습니다.
| 능력 | 설명 |
|---|---|
| L2 순위 | 쿼리의 컨텍스트 또는 의미 체계 의미를 사용하여 사전 순위가 지정된 결과에 대한 새 관련성 점수를 계산합니다. |
| 의미 체계 캡션 및 강조 표시 | 콘텐츠를 가장 잘 요약하는 필드에서 축자 문장과 구를 추출하고, 쉽게 스캔할 수 있도록 주요 구절을 강조 표시합니다. 결과를 요약하는 캡션은 개별 콘텐츠 필드가 검색 결과 페이지에 비해 너무 조밀한 경우에 유용합니다. 강조 표시된 텍스트는 가장 관련성이 높은 용어와 구를 높이므로 사용자가 일치 항목이 관련성이 있는 것으로 간주되는 이유를 빠르게 확인할 수 있습니다. |
| 의미론 답변 | 의미 체계 쿼리에서 반환된 선택적 및 추가 하위 구조입니다. 질문처럼 보이는 쿼리에 대한 직접적인 대답을 제공합니다. 문서에 답변의 특징이 있는 텍스트가 있어야 합니다. |
| 쿼리 다시 쓰기(미리 보기) | 텍스트 쿼리나 벡터 쿼리의 텍스트 요소를 활용하여, 의미 랭커는 최대 10개의 쿼리 변형을 생성할 수 있습니다. 이 과정에서 오타나 맞춤법 오류를 수정하거나, 생성된 동의어를 사용하여 쿼리를 재구성할 수 있습니다. 다시 작성된 쿼리는 검색 엔진에서 실행됩니다. 결과는 BM25 또는 RRF 채점을 사용하여 채점된 다음 의미 체계 순위에 의해 다시 점수가 매겨집니다. |
의미 체계 순위의 작동 방식
의미 체계 랭커는 쿼리와 결과를 가져온 후, Microsoft가 호스팅하는 언어 인식 모델로 보냅니다. 더 나은 일치 결과를 검색합니다.
다음 그림에서는 개념을 설명합니다. "capital"이라는 용어를 고려합니다. 컨텍스트가 금융, 법률, 지리 또는 문법인지에 따라 다른 의미가 있습니다. 언어 이해를 통해 의미 체계 순위는 컨텍스트를 검색하고 쿼리 의도에 맞는 결과를 승격합니다.
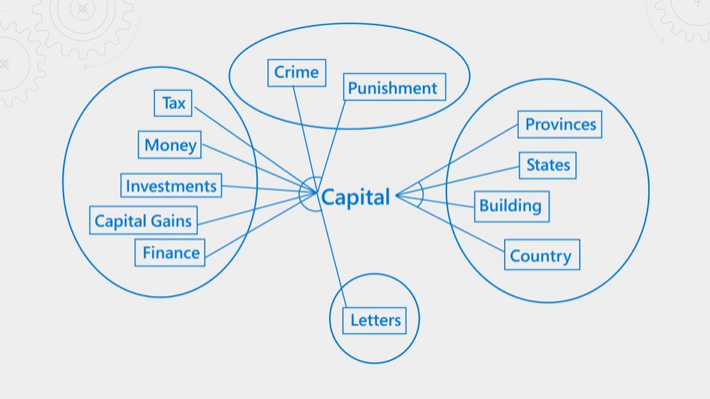
의미 체계 순위는 많은 리소스와 시간을 사용합니다. 쿼리 작업의 예상 대기 시간 내에 처리를 완료하기 위해 시스템은 의미 체계 순위에 대한 입력을 통합하고 줄입니다. 이 방법은 재랜킹 단계를 가능한 한 빨리 완료하는 데 도움이 됩니다.
의미 체계 순위에는 다음 세 단계가 있습니다.
- 입력 수집 및 요약
- 의미 체계 순위표를 사용하여 결과 점수 매기기
- 다시 점수 매겨진 결과, 캡션 및 답변 출력
시스템에서 입력을 수집하고 요약하는 방법
의미 체계 순위에서 쿼리 하위 시스템은 검색 결과를 요약 및 순위 모델에 대한 입력으로 전달합니다. 순위 모델에는 입력 크기 제약 조건이 있고 처리 집약적이므로 효율적인 처리를 위해 검색 결과의 크기를 조정하고 구조화(요약)해야 합니다.
의미 체계 순위는 텍스트 쿼리의 BM25 순위 결과 또는 벡터 또는 하이브리드 쿼리의 RRF 순위 결과로 시작합니다. 텍스트만 사용하는 재순위 책정 작업입니다. 결과에 50개 이상의 결과가 포함되더라도 상위 50개 결과만 의미 체계 순위로 진행됩니다. 일반적으로 의미 체계 순위는 정보 및 설명 필드를 사용합니다.
검색 결과의 각 문서에 대해 요약 모델은 토큰이 약 10자인 최대 2,000개의 토큰을 허용합니다. 모델은 의미 체계 구성에 나열된 "title", "keywords" 및 "content" 필드의 입력을 어셈블합니다.
시스템은 전체 길이가 요약 단계의 입력 요구 사항을 충족하도록 너무 긴 문자열을 트리밍합니다. 이 트리밍 연습은 우선 순위에 따라 의미 체계 구성에 필드를 추가하는 것이 중요한 이유입니다. 텍스트가 많은 필드가 있는 매우 큰 문서가 있는 경우 시스템은 최대 제한 이후의 모든 항목을 무시합니다.
의미 영역 토큰 제한 제목 토큰 128개 키워드 토큰 128개 콘텐츠 나머지 토큰 요약 출력은 각 필드의 가장 관련성이 큰 정보로 구성된 각 문서에 대한 요약 문자열입니다. 시스템은 점수 매기기를 위해 순위에 요약 문자열을 보내고, 기계에서 캡션 및 답변에 대한 이해 모델을 읽습니다.
2024년 11월 현재 의미 체계 순위에 전달된 생성된 각 요약 문자열의 최대 길이는 2,048개 토큰입니다. 이전에는 256개의 토큰이었습니다.
결과 점수 매기기 방법
시스템은 캡션과 2,048 토큰 길이를 채우는 요약 문자열의 다른 콘텐츠를 기반으로 결과에 점수를 매깁니다.
시스템은 제공하는 쿼리를 기준으로 개념적 및 의미 체계적 관련성에 대한 캡션을 평가합니다.
시스템은 지정된 쿼리에 대한 문서의 의미 체계 관련성에 따라 각 문서에 @search.rerankerScore 를 할당합니다. 점수 범위는 4에서 0(높음에서 낮음까지)입니다. 점수가 높을수록 관련성이 높습니다.
평점 의미 4.0 이 문서는 관련성이 높고 질문에 완전히 답변하지만, 이 구절에는 질문과 관련이 없는 추가 텍스트가 포함될 수 있습니다. 3.0 문서는 관련이 있지만 완료할 수 있는 세부 정보가 부족합니다. 2.0 문서는 질문에 부분적으로 또는 일부 측면에서만 대답하여 다소 관련이 있습니다. 1.0 이 문서는 질문과 관련이 있으며, 그 중 일부만 답변합니다. 0.0 문서는 관련이 없습니다. 시스템은 점수를 기준으로 내림차순으로 일치 항목을 나열하고 쿼리 응답 페이로드에 포함합니다. 페이로드에는 답변, 일반 텍스트 및 강조 표시된 캡션, 검색 가능으로 표시되거나 select 절에 지정된 필드가 포함됩니다.
참고
지정된 쿼리의 경우 @search.rerankerScore 배포는 인프라 수준의 조건으로 인해 약간의 변화를 나타낼 수 있습니다. 순위 모델 업데이트는 배포에도 영향을 줄 수 있습니다. 이러한 이유로 최소 임계값에 대한 사용자 지정 코드를 작성하거나 벡터 및 하이브리드 쿼리에 대한 임계값 속성을 설정하는 경우 제한을 너무 세분화하지 마세요.
의미 순위 결정자의 출력
각 요약 문자열에서 컴퓨터 읽기 이해 모델은 가장 대표적인 구절을 찾습니다.
출력은 다음과 같습니다.
문서에 대한 의미 체계 캡션 입니다. 각 캡션은 일반 텍스트 버전 및 강조 표시 버전에서 사용할 수 있으며 문서당 200단어 미만인 경우가 많습니다.
당신이 매개 변수를 지정했다고 가정하고, 쿼리가 질문으로 제기되었으며, 긴 문자열에서 그 질문에 대한 가능성이 높은 답을 제공하는 구절이 발견되었을 때의 선택적 의미적 답변입니다.
캡션과 정답은 항상 인덱스의 원문 텍스트를 그대로 사용합니다. 이 워크플로에는 새 콘텐츠를 만들거나 작성하는 생성 AI 모델이 없습니다.
의미 체계 기능 및 제한 사항
의미론적 순위 지정자가 수행할 수 있는 작업:
원래 쿼리의 의도에 의미상 더 가까운 일치 항목을 우선적으로 처리합니다.
캡션 및 답변으로 사용할 문자열을 찾습니다. 응답은 검색 결과 페이지에서 렌더링할 수 있는 캡션 및 답변을 반환합니다.
의미 체계 순위가 수행할 수 없는 작업은 전체 모음에 대해 쿼리를 다시 실행하여 의미 체계적으로 관련된 결과를 찾는 것입니다. 의미 체계 순위는 기본 순위 알고리즘에서 채점된 상위 50개 결과로 구성된 기존 결과 집합을 다시 표시합니다. 또한 의미적 순위 지정 기능은 새 정보 또는 문자열을 생성할 수 없습니다. 언어 모델은 콘텐츠에서 캡션과 대답을 축자로 추출하므로 결과에 답변과 유사한 텍스트가 포함되지 않으면 해당 텍스트가 생성되지 않습니다.
의미 체계 순위가 모든 시나리오에서 도움이 되는 것은 아니지만 특정 콘텐츠는 해당 기능을 통해 상당한 이점을 얻을 수 있습니다. 의미 체계 순위의 언어 모델은 정보가 풍부하고 산문으로 구조화된 검색 가능한 콘텐츠에서 가장 적합합니다. 기술 자료, 온라인 설명서 또는 설명이 포함된 문서는 의미 체계 순위 기능에서 가장 많은 이익을 얻습니다.
기본 기술은 Bing 및 Microsoft Research를 기반으로 하며 추가 기능으로 Azure AI 검색 인프라에 통합됩니다. 의미 체계 순위를 지원하는 연구 및 AI 투자에 대한 자세한 내용은 Bing의 AI가 Azure AI 검색 구동하는 방법(Microsoft 연구 블로그) 참조하세요.
다음 비디오에서는 기능에 대한 개요를 제공합니다.
시맨틱 랭커가 동의어 맵을 사용하는 방법
검색 인덱 스의 필드에 연결된 동의어 맵 에 대한 지원을 사용하도록 설정하고 의미 체계 순위 구성에 해당 필드를 포함하는 경우 의미 체계 순위는 재전송 프로세스 중에 구성된 동의어를 자동으로 적용합니다.
가용성 및 가격 책정
의미 체계 순위는 일부 지역에서 사용할 수 있습니다. 독립 실행형 기능 또는 에이전트 검색의 기본 제공 구성 요소로 사용할 수 있습니다. 각 기능은 독립적으로 청구됩니다.
의미 체계 순위는 기본으로 무료 플랜을 제공하며, 이 플랜에는 월별 무료 요청 한도가 포함됩니다. 무료 한도를 모두 사용한 뒤에는 종량제 기반의 표준 요금제를 이용할 수 있습니다. 자세한 내용은 의미 순위 지정 요금제 사용 또는 비활성화를 참조하세요.
쿼리 요청에 queryType=semantic 포함되고 검색 문자열이 비어 있지 않을 때 의미 체계 순위에 대한 요금이 발생합니다(예: search=pet friendly hotels in New York). 검색 문자열이 비어 있는 경우(search=*) queryType이 의미 체계로 설정된 경우에도 요금이 청구되지 않습니다.
시작하는 방법
(선택 사항) 무료 월별 할당량을 초과하는 사용량에 대한 표준 청구 계획으로 전환 합니다.
(선택 사항) 의미 체계 답변을 반환합니다.