참고
Azure AI 검색 Azure 포털, REST API 및 Azure SDK 통해 사용할 수 있습니다. 또한 엔터프라이즈 콘텐츠를 Microsoft Foundry 포털의 에이전트에 대해 재사용 가능한 사용 권한 인식 기술 자료로 변환하는 관리되는 기술 계층인 Foundry IQ를 뒷받침합니다.
이 문서에서는 증분 인덱싱을 통해 스키마 변경 또는 콘텐츠 변경으로 Azure AI 검색 기존 인덱스를 업데이트하는 방법을 설명합니다.
팁
문서를 즉시 업데이트하려면 콘텐츠 업데이트로 건너뜁니다. 스키마 변경 내용은 인덱스 스키마 업데이트를 참조하세요.
필수 구성 요소
Azure AI 검색 서비스(모든 계층). 서비스를 만들거나기존 서비스를 찾으세요.
인덱스를 업데이트하거나 다시 빌드할 수 있는 권한:
- 키 기반 인증: 검색 서비스에 대한 관리자 API 키 입니다.
- 역할 기반 인증: 문서 업데이트에 대한 검색 인덱스 데이터 기여자 역할 또는 스키마 변경에 대한 Search Service 기여자 입니다.
SDK 개발의 경우 Azure Search 클라이언트 라이브러리를 설치합니다.
- Python: azure-search-documents
- .NET: Azure. Search.Documents
- JavaScript: @azure/search-documents
- Java: azure-search-documents
팁
활성 개발 중에는 인덱스 디자인을 반복할 때 인덱스를 삭제하고 다시 작성하는 것이 일반적입니다. 다시 인덱싱이 더 빠르게 진행되도록 작은 대표적인 데이터 샘플로 작업합니다. 프로덕션 스키마 변경의 경우 새 인덱스를 함께 만들고 테스트한 다음 인 덱스 별칭을 사용하여 애플리케이션 코드를 변경하지 않고 인덱스를 교환합니다.
콘텐츠 업데이트
원본 데이터의 변경 내용에 대해 인덱스를 증분 인덱싱 및 동기화하는 것은 대부분의 검색 애플리케이션에서 기본 사항입니다. 이 섹션에서는 REST API를 통해 검색 인덱스의 콘텐츠를 추가, 제거 또는 덮어쓰는 워크플로에 대해 설명하지만 Azure SDK 동일한 기능을 제공합니다.
요청 본문에는 인덱싱할 문서가 하나 이상 포함되어 있습니다. 요청 내에서 인덱스 내의 각 문서는 다음과 같습니다.
- 고유한 대/소문자를 구분하는 키로 식별됩니다.
- "upload", "delete", "merge" 또는 "mergeOrUpload" 작업과 연결됩니다.
- 추가하거나 업데이트하는 각 필드에 대한 이름/값 쌍 집합으로 채워집니다.
{
  "value": [
    {
      "@search.action": "upload (default) | merge | mergeOrUpload | delete",
      "key_field_name": "unique_key_of_document", (key/value pair for key field from index schema)
      "field_name": field_value (name/value pairs matching index schema)
        ...
    },
    ...
  ]
}
참조:문서 - 인덱스
먼저 Documents - 인덱스(REST) 또는 Azure SDK 해당하는 API와 같은 문서를 로드하는 데 API를 사용합니다. 인덱싱 기술에 대한 자세한 내용은 문서 로드를 참조하세요.
대규모 업데이트의 경우 일괄 처리(일괄 처리당 최대 1,000개 문서 또는 일괄 처리당 약 16MB,어느 제한이 먼저 오는지)를 권장하며 인덱싱 성능을 크게 향상시킵니다.
API에
@search.action대한 매개 변수를 설정하여 기존 문서에 미치는 영향을 확인합니다. 증분 업데이트(가장 일반적인 경우),mergeOrUpload문서를 제거하거나delete기존 문서에 대한 부분 필드 업데이트에 사용합니다merge.액션 효과 삭제 인덱스에서 전체 문서를 제거합니다. 개별 필드를 제거하려면 병합을 대신 사용하고 해당 필드를 null로 설정합니다. 삭제된 문서 및 필드는 인덱스의 공간을 즉시 확보하지 않습니다. 몇 분마다 백그라운드 프로세스는 물리적 삭제를 수행합니다. Azure 포털 또는 API를 사용하여 인덱스 통계를 반환하든 관계없이 삭제가 Azure 포털 및 API를 통해 반영되기까지 약간의 지연이 예상될 수 있습니다. 자세한 내용은 검색 인덱스에서 문서 삭제를 참조하세요. 병합 기존 문서를 업데이트하되, 문서를 찾을 수 없는 경우 작업이 실패합니다. 병합은 기존 값을 대체합니다. 따라서 형식 Collection(Edm.String)필드와 같이 여러 값이 포함된 컬렉션 필드를 확인해야 합니다. 예를 들어 필드가tags값["budget"]으로 시작하고 병합["economy", "pool"]을 실행하는 경우 필드의tags최종 값은 다음과 같습니다["economy", "pool"].["budget", "economy", "pool"]이 아닙니다.
동일한 동작이 복잡한 컬렉션에 적용됩니다. 문서에[{ "Type": "Budget Room", "BaseRate": 75.0 }]값을 가진 Rooms라는 복합 컬렉션 필드가 포함되어 있고,[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]값을 이용해 병합을 실행하면 Rooms 필드의 최종 값은[{ "Type": "Standard Room" }, { "Type": "Budget Room", "BaseRate": 60.5 }]가 됩니다. 새 값과 기존 값을 추가하거나 병합하지 않습니다.mergeOrUpload 문서가 있는 경우 병합처럼 동작하고 문서가 새 문서인 경우 업로드합니다. 이는 증분 업데이트에 대한 가장 일반적인 작업입니다. 업로드 새 문서일 경우 삽입되고, 기존 문서일 경우 업데이트되거나 대체되는 "upsert"와 유사합니다. 인덱스에 필요한 값이 문서에 없으면 문서 필드의 값이 null로 설정됩니다.
쿼리는 인덱싱하는 동안 계속 실행되지만 기존 필드를 업데이트하거나 제거하는 경우 혼합된 결과와 더 높은 제한 발생률을 예상할 수 있습니다.
참고
요청 본문의 작업이 먼저 실행되는 순서 지정 보장은 없습니다. 단일 요청 본문에서 동일한 문서와 연결된 여러 "병합" 작업을 사용하지 않는 것이 좋습니다. 동일한 문서에 여러 "병합" 작업이 필요한 경우 검색 인덱스의 문서를 업데이트하기 전에 병합 클라이언트 쪽을 수행합니다.
응답
성공적인 응답을 위해 상태 코드 200이 반환됩니다. 즉, 모든 항목이 지속적으로 저장되고 인덱싱되기 시작합니다. 인덱싱은 백그라운드에서 실행되며 인덱싱 작업이 완료된 후 몇 초 후에 새 문서(즉, 쿼리 가능하고 검색 가능)를 사용할 수 있습니다. 특정 지연은 서비스의 부하에 따라 달라집니다.
성공적인 인덱싱은 모든 항목에 대해 true로 설정되는 상태 속성뿐만 statusCode 아니라 새로 업로드된 문서의 경우 201 또는 200(병합되거나 삭제된 문서의 경우)으로 설정되는 속성으로 표시됩니다.
{
  "value": [
    {
      "key": "unique_key_of_new_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 201
    },
    {
      "key": "unique_key_of_merged_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    },
    {
      "key": "unique_key_of_deleted_document",
      "status": true,
      "errorMessage": null,
      "statusCode": 200
    }
  ]
}
하나 이상의 항목이 성공적으로 인덱싱되지 않은 경우 상태 코드 207이 반환됩니다. 인덱싱되지 않은 항목에는 상태 필드가 false로 설정됩니다. 및 errorMessage 속성은 statusCode 인덱싱 오류의 원인을 나타냅니다.
{
  "value": [
    {
      "key": "unique_key_of_document_1",
      "status": false,
      "errorMessage": "The search service is too busy to process this document. Please try again later.",
      "statusCode": 503
    },
    {
      "key": "unique_key_of_document_2",
      "status": false,
      "errorMessage": "Document not found.",
      "statusCode": 404
    },
    {
      "key": "unique_key_of_document_3",
      "status": false,
      "errorMessage": "Index is temporarily unavailable because it was updated with the 'allowIndexDowntime' flag set to 'true'. Please try again later.",
      "statusCode": 422
    }
  ]
}
이 속성은 errorMessage 가능한 경우 인덱싱 오류의 원인을 나타냅니다.
다음 표에서는 응답에서 반환할 수 있는 다양한 문서별 상태 코드를 설명합니다. 일부 상태 코드는 요청 자체의 문제를 나타내고 다른 코드는 임시 오류 조건을 나타냅니다. 후자는 지연 후 다시 시도해야 합니다.
| 상태 코드 | 의미 | 다시 시도 가능 | 노트 |
|---|---|---|---|
| 200 | 문서가 성공적으로 수정되거나 삭제되었습니다. | n/a | 삭제 작업은 idempotent입니다. 즉, 문서 키가 인덱스 안에 없더라도 해당 키를 사용하여 삭제 작업을 시도하면 200 상태 코드가 생성됩니다. |
| 201 | 문서가 성공적으로 생성되었습니다. | n/a | |
| 400 | 문서에 인덱싱되지 않는 오류가 발생했습니다. | 아니요 | 응답의 오류 메시지는 문서에 무엇이 잘못되어 있는지를 나타냅니다. |
| 404 | 지정된 키가 인덱스 안에 없기 때문에 문서를 병합할 수 없습니다. | 아니요 | 새 문서를 생성하므로 업로드 중에는 이 오류가 발생하지 않으며, idempotent 특성 덕분에 삭제 작업에서도 오류가 발생하지 않습니다. |
| 409 | 문서 인덱싱을 시도할 때 버전 충돌이 감지되었습니다. | 예 | 이 문제는 동일한 문서를 두 번 이상 동시에 인덱싱하려고 할 때 발생할 수 있습니다. |
| 422 | 인덱스가 'allowIndexDowntime' 플래그를 'true'로 설정하여 업데이트되었기 때문에 일시적으로 사용할 수 없습니다. | 예 | |
| 429 | 요청이 너무 많음 | 예 | 인덱싱 중에 이 오류 코드가 표시되면 일반적으로 스토리지가 부족하다는 의미입니다. 스토리지 한도에 가까워지면 일부 문서를 삭제할 때까지 서비스를 추가하거나 업데이트할 수 없는 상태가 될 수 있습니다. 자세한 내용은 더 많은 스토리지를 원하는 경우 용량 계획 및 관리를 참조하거나 문서를 삭제하여 공간을 확보하세요. |
| 503 | 부하가 많기 때문에 검색 서비스를 일시적으로 사용할 수 없습니다. | 예 | 이 경우 다시 시도하기 전에 코드가 대기해야 하며, 그렇지 않으면 서비스의 사용 불가가 지속될 위험이 있습니다. |
클라이언트 코드에서 207 응답이 자주 발생하는 경우 한 가지 가능한 이유는 시스템이 로드 중이기 때문입니다. statusCode 속성을 503으로 설정했는지 확인할 수 있습니다. statusCode가 503인 경우 인덱싱 요청을 제한하는 것이 좋습니다. 그렇지 않으면 인덱싱 트래픽이 가라앉지 않으면 시스템에서 503 오류가 있는 모든 요청을 거부하기 시작할 수 있습니다.
상태 코드 429는 인덱스당 문서 수에 대한 할당량을 초과했음을 나타냅니다. 더 높은 용량 제한을 위해 업그레이드하거나 새 인덱스를 만들어야 합니다.
참고
표준 시간대 정보가 포함된 DateTimeOffset 값을 인덱스에 업로드하면 Azure AI 검색 이러한 값을 UTC로 정규화합니다. 예를 들어 2024-01-13T14:03:00-08:00은 2024-01-13T22:03:00Z로 저장됩니다. 표준 시간대 정보를 저장해야 하는 경우 이 데이터 요소의 인덱스 열에 추가 열을 추가합니다.
증분 인덱싱 방법 안내
인덱서는 증분 인덱싱을 자동화합니다. 인덱서가 사용 가능하고 데이터 원본이 변경 내용 추적을 지원하는 경우 반복 일정에 따라 인덱서를 실행하여 외부 데이터와 동기화되도록 검색 가능한 콘텐츠를 추가, 업데이트 또는 덮어쓸 수 있습니다.
푸시 API를 통해 직접 인덱스 호출을 만드는 경우,
mergeOrUpload을 검색 작업으로 사용하십시오.페이로드에는 추가, 업데이트 또는 삭제하려는 모든 문서의 키 또는 식별자가 포함되어야 합니다.
인덱스가 벡터 필드를 포함하고 속성을 false로 설정한
stored경우 값이 변경되지 않더라도 부분 문서 업데이트에 벡터를 제공해야 합니다. false로 설정stored하면 다시 인덱싱 작업에서 벡터가 삭제되는 부작용이 있습니다. 문서 페이로드에 벡터를 제공하면 이러한 일이 발생하지 않습니다.단순 필드 및 하위 필드의 내용을 복합 형식으로 업데이트하려면 변경하려는 필드만 나열합니다. 예를 들어 설명 필드만 업데이트해야 하는 경우 페이로드는 문서 키와 수정된 설명으로 구성되어야 합니다. 다른 필드를 생략하면 기존 값이 유지됩니다.
인라인 변경 내용을 문자열 컬렉션에 병합하려면 전체 값을 제공합니다. 이전 섹션의
tags필드 예제를 기억하세요. 새 값은 전체 필드의 이전 값을 덮어쓰며 필드 내용 내에 병합이 없습니다.
다음은 이러한 팁을 보여주는 REST API 예제 입니다.
### Get Stay-Kay City Hotel by ID
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}

### Change the description, city, and tags for Stay-Kay City Hotel
POST {{baseUrl}}/indexes/hotels-vector-quickstart/docs/search.index?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  api-key: {{apiKey}}

    {
        "value": [
            {
            "@search.action": "mergeOrUpload",
            "HotelId": "1",
            "Description": "I'm overwriting the description for Stay-Kay City Hotel.",
            "Tags": ["my old item", "my new item"],
            "Address": {
                "City": "Gotham City"
                }
            }
        ]
    }

### Retrieve the same document, confirm the overwrites and retention of all other values
GET  {{baseUrl}}/indexes/hotels-vector-quickstart/docs('1')?api-version=2026-04-01  HTTP/1.1
    Content-Type: application/json
    api-key: {{apiKey}}
SDK 예제
다음 예제에서는 Azure SDK 사용하여 문서를 업데이트하는 방법을 보여 줍니다.
from azure.core.credentials import AzureKeyCredential
from azure.search.documents import SearchClient

# Set up the client
service_name = "<your-search-service-name>"
index_name = "hotels-sample"
api_key = "<your-admin-api-key>"

endpoint = f"https://{service_name}.search.windows.net"
credential = AzureKeyCredential(api_key)
client = SearchClient(endpoint=endpoint, index_name=index_name, credential=credential)

# Update documents using merge_or_upload
documents = [
    {
        "HotelId": "1",
        "Description": "Updated description for the hotel.",
        "Tags": ["updated", "renovated"]
    }
]

result = client.merge_or_upload_documents(documents=documents)
print(f"Updated {len(result)} document(s)")
인덱스 스키마 업데이트
인덱스 스키마는 검색 서비스에서 만든 물리적 데이터 구조를 정의하므로 전체 다시 빌드를 수행하지 않고 수행할 수 있는 스키마 변경은 많지 않습니다.
다시 빌드하지 않은 업데이트
다음 목록에서는 기존 인덱스에 원활하게 도입할 수 있는 스키마 변경 내용을 열거합니다. 일반적으로 목록에는 쿼리 실행 중에 사용되는 새 필드와 기능이 포함됩니다.
- 인덱스 설명 추가
- 새 필드 추가
-
retrievable기존 필드에 특성 설정 - 기존
searchAnalyzer가 있는 필드의indexAnalyzer업데이트 - 인덱스(새 필드에 적용할 수 있는)에 새 분석기 정의 추가
- 점수 매기기 프로필 추가, 업데이트 또는 삭제
- 동의어 맵 추가, 업데이트 또는 삭제
- 의미 체계 구성 추가, 업데이트 또는 삭제
- CORS 설정 추가, 업데이트 또는 삭제
작업의 순서는 다음과 같습니다.
이전 목록의 업데이트로 스키마를 수정합니다.
검색 서비스에서 인덱스 스키마를 업데이트합니다.
새 필드를 추가한 경우 수정된 스키마와 일치하도록 인덱스 콘텐츠를 업데이트합니다. 다른 모든 변경 내용의 경우 기존 인덱싱된 콘텐츠는 as-is사용됩니다.
새 필드를 포함하도록 인덱스 스키마를 업데이트하면 인덱스 내의 기존 문서에 해당 필드의 null 값이 제공됩니다. 다음 인덱싱 작업에서 외부 원본 데이터의 값은 Azure AI 검색 의해 추가된 null을 대체합니다.
업데이트 중에는 쿼리 중단이 없어야 하지만 업데이트가 적용되면 쿼리 결과가 달라집니다.
다시 빌드가 필요한 업데이트
일부 수정에는 인덱스 삭제 및 다시 작성이 필요하며 현재 인덱스를 새 인덱스로 바꿔야 합니다.
| 액션 | 설명 |
|---|---|
| 필드 삭제 | 필드의 모든 추적을 물리적으로 제거하려면 인덱스를 다시 작성해야 합니다. 즉시 다시 빌드가 실용적이지 않은 경우 애플리케이션 코드를 수정하여 사용되지 않는 필드에서 액세스를 리디렉션하거나 searchFields를 사용하고 쿼리 매개 변수를 선택하여 검색 및 반환되는 필드를 선택할 수 있습니다. 실제로 필드 정의 및 콘텐츠는 해당 필드를 생략하는 스키마를 적용할 때 다음 다시 작성될 때까지 인덱스에 남아 있습니다. |
| 필드 정의 변경 | 필드 이름, 데이터 형식 또는 특정 인덱스 특성 (검색 가능, 필터링 가능, 정렬 가능, 패싯 가능)을 수정하려면 전체 다시 작성이 필요합니다. |
| 필드에 분석기 할당 | 분석기는 인덱스에 정의되고 필드에 할당된 다음 인덱싱 중에 호출되어 토큰을 만드는 방법을 알려줍니다. 언제든지 인덱스로 새 분석기 정의를 추가할 수 있지만 필드를 만들 때만 분석기를 할당 할 수 있습니다. 이는 분석기 및 indexAnalyzer 속성 모두에 해당합니다. searchAnalyzer 속성은 예외입니다(이 속성을 기존 필드에 할당할 수 있음). |
| 인덱스에서 분석기 정의 업데이트 또는 삭제 | 전체 인덱스가 다시 작성되지 않는 한 인덱스의 기존 분석기 구성(분석기, 토큰 변환기, 토큰 필터 또는 문자 필터)을 삭제하거나 변경할 수 없습니다. |
| 제안기에서 필드 추가 | 필드가 이미 있고 Suggesters 구문에 추가하려는 경우 인덱스를 다시 빌드합니다. |
| 서비스 또는 계층 업그레이드 | 더 많은 용량이 필요한 경우 서비스를 업그레이드 하거나 더 높은 가격 책정 계층으로 전환할 수 있는지 확인합니다. 그렇지 않은 경우 새 서비스를 만들고 인덱스를 처음부터 다시 작성해야 합니다. 이 프로세스를 자동화하기 위해 일련의 JSON 파일에 인덱스를 백업하는 코드 샘플을 사용할 수 있습니다. 그런 다음 지정한 검색 서비스에서 인덱스 다시 만들 수 있습니다. |
작업의 순서는 다음과 같습니다.
인덱스 정의를 나중에 참조하거나 새 버전의 기준으로 사용해야 하는 경우에 대비하여 가져옵니다.
백업 및 복원 솔루션을 사용하여 인덱스 콘텐츠의 복사본을 유지하는 것이 좋습니다. C# 및 Python 솔루션이 있습니다. 최신 버전이므로 Python 버전을 사용하는 것이 좋습니다.
검색 서비스에 용량이 있는 경우 새 인덱을 만들고 테스트하는 동안 기존 인덱스만 유지합니다.
기존 인덱스 삭제 인덱스를 대상으로 하는 쿼리는 즉시 삭제됩니다. 인덱스 삭제는 되돌릴 수 없으며 필드 컬렉션 및 기타 구문에 대한 물리적 스토리지가 삭제됩니다.
요청 본문에 변경되거나 수정된 필드 정의 및 구성이 포함된 수정된 인덱스를 게시합니다.
외부 소스에서 문서를 인덱스로 로드하십시오. 문서는 새 스키마의 필드 정의 및 구성을 사용하여 인덱싱됩니다.
인덱스를 만들면 검색 가능한 각 필드에 대해 반전된 인덱스가 생성되고 각 벡터 필드에 대해 생성된 벡터 인덱스가 있는 인덱스 스키마의 각 필드에 실제 스토리지가 할당됩니다. 검색할 수 없는 필드는 필터나 식에는 사용할 수 있지만, 역색인이 없어 전체 텍스트 검색이나 퍼지 검색은 지원하지 않습니다. 인덱스 다시 작성 시 이러한 반전된 인덱스 및 벡터 인덱스는 제공한 인덱스 스키마에 따라 삭제되고 다시 만들어집니다.
애플리케이션 코드 중단을 최소화하려면 인덱스 별칭을 만드는 것이 좋습니다. 애플리케이션 코드는 별칭을 참조하지만 별칭이 가리키는 인덱스의 이름을 업데이트할 수 있습니다.
인덱스 설명 추가
인덱스에는 description 시스템에서 여러 인덱스에 액세스하고 설명에 따라 결정을 내릴 때 지정하고 사용할 수 있는 속성이 있습니다. 런타임에 올바른 인덱스 선택해야 하는 MCP(모델 컨텍스트 프로토콜) 서버를 고려합니다. 결정은 인덱스 이름만 사용하는 것이 아니라 설명에 따라 결정될 수 있습니다.
인덱스 설명은 스키마 업데이트이며 전체 인덱스를 다시 작성하지 않고도 추가할 수 있습니다.
- 문자열 길이는 최대 4,000자입니다.
- 콘텐츠는 유니코드에서 사람이 읽을 수 있어야 합니다. 사용 사례에 따라 사용할 언어가 결정됩니다.
Azure 포털, 안정적인 최신 REST API 또는 기능을 제공하는 Azure SDK 패키지를 통해 인덱스 설명을 추가할 수 있습니다.
Azure 포털은 최신 미리 보기 API를 지원합니다.
Azure 포털 검색 서비스로 이동합니다.
검색 관리>인덱스 아래에서 인덱스를 선택합니다.
JSON 편집을 선택합니다.
삽입
"description"한 다음 설명을 입력합니다. 값은 4,000자 미만이어야 하며 유니코드여야 합니다.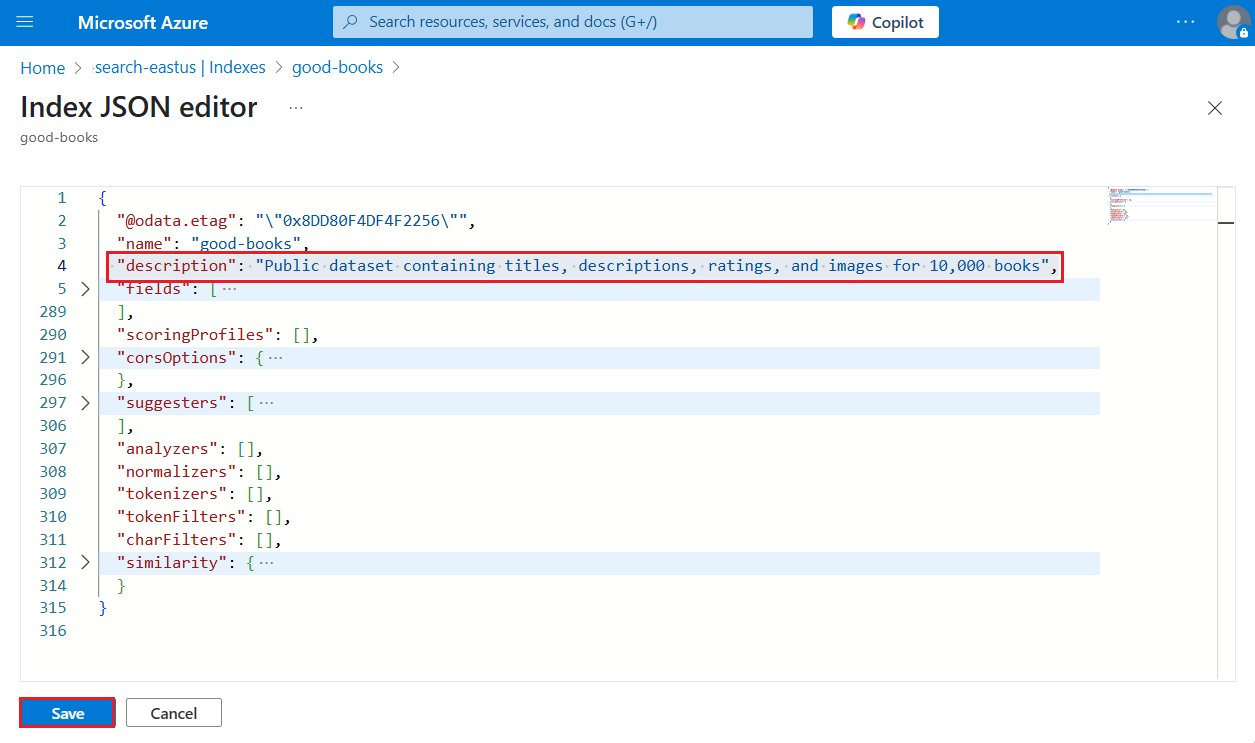
인덱스 저장
워크로드 분산
인덱싱은 백그라운드에서 실행되지 않지만 검색 서비스는 진행 중인 쿼리와 인덱싱 작업의 균형을 조정합니다. 인덱싱하는 동안 Azure 포털에서 쿼리 요청을 모니터링하여 쿼리가 적시에 완료되는지 확인할 수 있습니다.
인덱싱 워크로드에서 허용되지 않는 수준의 쿼리 대기 시간을 도입하는 경우 성능 분석을 수행하고 잠재적인 완화를 위해 이러한 성능 팁을 검토합니다.
업데이트 확인
첫 번째 문서가 로드되는 즉시 인덱스 쿼리를 시작할 수 있습니다. 문서의 ID를 알고 있는 경우 조회 문서 REST API 는 특정 문서를 반환합니다. 더 광범위한 테스트를 위해 인덱스가 완전히 로드될 때까지 기다린 다음 쿼리를 사용하여 예상되는 컨텍스트를 확인해야 합니다.
검색 탐색기 또는 REST 클라이언트를 사용하여 업데이트된 콘텐츠를 확인할 수 있습니다.
필드를 추가하거나 이름을 바꾼 경우 select 를 사용하여 해당 필드를 반환합니다.
"search": "*",
"select": "document-id, my-new-field, some-old-field",
"count": true
Azure 포털은 인덱스 크기 및 벡터 인덱스 크기를 제공합니다. 인덱스 업데이트 후 이러한 값을 확인할 수 있지만, 서비스에서 변경 내용을 처리하고 포털 새로 고침 속도를 고려할 때 약간의 지연이 예상되며 몇 분 정도가 될 수 있습니다.
재색인 문제 해결하기
다음 표에서는 인덱스를 업데이트하거나 다시 작성할 때 발생하는 일반적인 문제와 이를 해결하는 방법을 나열합니다.
| 문제 | 원인 | 해상도 |
|---|---|---|
| 결과가 혼합된 207개 응답 | 일부 문서는 성공했고 다른 문서는 실패했습니다. | 응답의 각 문서에 대해 statusCode을 확인합니다. 503이면 요청을 제한하고 재시도하세요. |
| 409 버전 충돌 | 동일한 문서에 대한 동시 업데이트입니다. | 동일한 문서에 대한 업데이트를 직렬화하거나 지수 백오프를 사용하여 재시도를 구현합니다. |
| 429 요청이 너무 많음 | 스토리지 할당량이 초과되었거나 동시 요청이 너무 많습니다. | 여유 공간으로 문서를 삭제하거나 더 많은 용량을 위해 서비스 계층을 업그레이드합니다. |
| 503 서비스를 사용할 수 없음 | 부하가 많은 서비스입니다. | 기하급수적 백오프를 사용하여 기다렸다가 다시 시도합니다. 일괄 처리 크기를 줄이는 것이 좋습니다. |
| 삭제 후 변경되지 않은 문서 수 | 삭제는 비동기적입니다. | 백그라운드 프로세스가 실제 삭제를 완료할 때까지 2-3분 동안 기다립니다. |
| 새 필드가 null을 반환합니다. | 스키마에 추가되었지만 문서가 다시 인덱싱되지 않은 필드입니다. | 인덱서를 실행하거나 업데이트된 문서를 푸시하여 새 필드를 채웁다. |
| 스키마 변경이 거부됨 | 호환되지 않는 변경 시도(이름 바꾸기, 형식 변경). | 인덱스 삭제 및 다시 작성 인덱스 별칭을 사용하여 가동 중지 시간을 최소화합니다. |