Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Annotazioni
Azure AI Search è disponibile tramite il portale di Azure, le API REST e Azure SDK. È inoltre alla base di Foundry IQ, il livello di conoscenza gestito che trasforma il contenuto aziendale in knowledge base riutilizzabili e con riconoscimento delle autorizzazioni per gli agenti nel portale di Microsoft Foundry.
Azure AI Search supporta due modelli di prezzi, ognuno progettato per modelli di carico di lavoro diversi:
Dedicato: prezzi fissi calcolati in base alle Search Unit (SU). Selezioni un livello di servizio e ti viene addebitato un importo su base oraria in base alle unità di provisioning.
Serverless (anteprima): prezzi basati sul consumo misurati dalle unità di calcolo all'ora (CU/hr) e per GB/mese per l'archiviazione indicizzata.
Importante
Il livello serverless per sviluppatori è attualmente in anteprima. Questa anteprima viene fornita senza un contratto di servizio e non è consigliata per i carichi di lavoro di produzione. Alcune funzionalità potrebbero non essere supportate o potrebbero avere funzionalità limitate. Per ulteriori informazioni, vedere Condizioni supplementari per l'uso delle versioni di anteprima di Microsoft Azure.
La fatturazione per il piano Serverless Developer è iniziata il 13 settembre 2026. Addebiti per l'utilizzo su o dopo tale data vengono visualizzati nella fattura Azure. Non ti verrà addebitato alcun costo per l'utilizzo prima del 13 settembre 2026.
Il livello Developer serverless non supporta la migrazione verso o da altri livelli tariffari e alcune funzionalità disponibili in altri livelli non sono disponibili durante l'anteprima pubblica. I limiti del servizio, le funzionalità supportate e i dettagli dei prezzi possono cambiare prima della disponibilità generale.
Durante l'anteprima, il modello di determinazione prezzi serverless è supportato solo in aree specifiche.
Per altre informazioni sul modello tariffario e sulle differenze del livello di servizio, vedere Scegliere un modello tariffario e un livello di servizio.
Come viene determinato il costo nel modello serverless
I modelli tariffari Dedicated e Serverless conteggiano in modo diverso il lavoro eseguito all'interno del servizio di ricerca. I servizi dedicati eseguono query, indicizzazione ed elaborazione dei risultati sulla capacità già acquistata di cui è stato effettuato il provisioning. I servizi serverless misurano le operazioni di I/O di calcolo, memoria e disco che queste operazioni usano e convertono tale utilizzo in unità di calcolo (CU). Di conseguenza, l'ottimizzazione delle prestazioni influisce direttamente sul costo serverless.
I costi serverless sono legati all'esecuzione del carico di lavoro:
- Le query e l'indicizzazione usano il calcolo, misurate in unità di calcolo all'ora (CU/h).
- Gli indici attivi utilizzano il calcolo in base all'utilizzo delle risorse e alla durata della loro attività.
- Un indice rimane attivo per 10 minuti dopo l'ultima query o la richiesta di indicizzazione prima che diventi inattiva.
- Gli indici inattivi non prevedono costi di calcolo minimi o riservati. L'utilizzo di calcolo per gli indici inattivi viene ridimensionato su zero. Non è previsto alcun addebito minimo di calcolo quando un indice è inattivo.
- L'archiviazione viene fatturata separatamente in base alle dimensioni dell'indice sul disco e continua se è in uso o meno un indice.
- Il recupero agentico richiede risorse di calcolo per le query di ricerca e per l'orchestrazione eseguite all'interno del servizio di ricerca.
Gli addebiti per l'archiviazione si arrestano solo quando si elimina l'indice.
Per visualizzare la suddivisione dei costi e le tariffe di utilizzo per il ciclo di fatturazione corrente, visualizzare la scheda Scalabilità e costi nel portale di Azure.
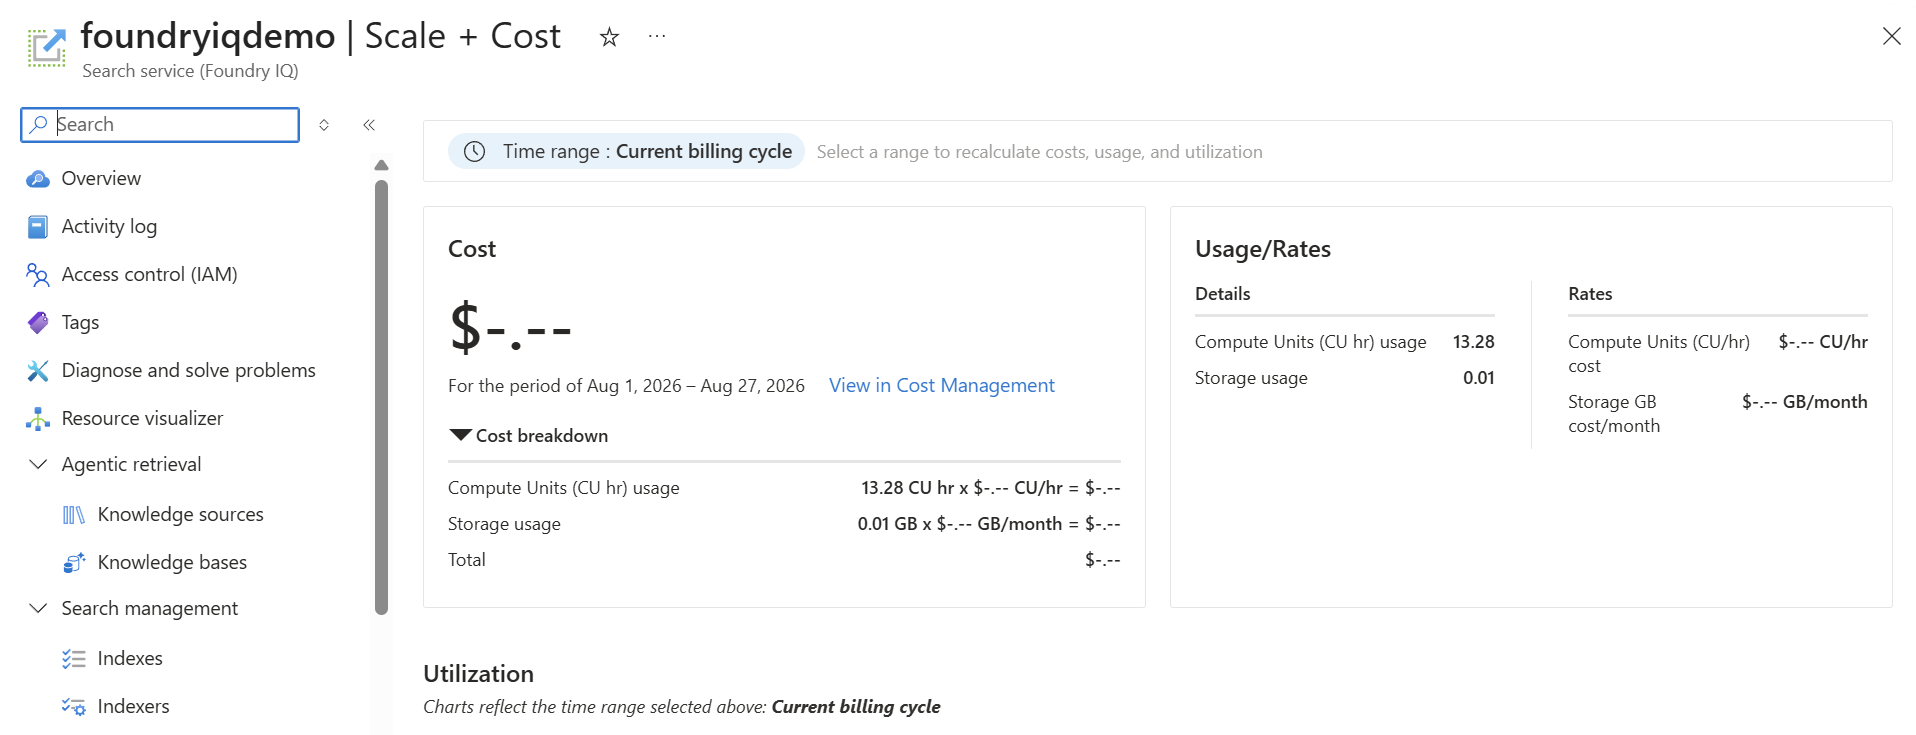
Impatto delle dimensioni dell'indice sull'utilizzo del calcolo
Mentre un indice è attivo, Azure AI Search valuta due risorse finite per determinarne l'utilizzo di calcolo:
- Dimensioni totali dell'indice: spazio totale occupato dall'indice su disco, inclusi testo, metadati e vettori.
- Dimensioni dell'indice vettoriale: memoria usata dall'indice vettoriale. La memoria richiede più risorse del disco, quindi la dimensione dell'indice vettoriale ha un peso maggiore quando viene convertita in CU.
Azure AI Search non somma i due importi CU risultanti. L'utilizzo delle risorse di calcolo si basa su qualsiasi quantità sia superiore. Ad esempio, le dimensioni dell'indice vettoriale possono determinare l'utilizzo del calcolo anche quando le dimensioni totali dell'indice sul disco sono relativamente piccole.
Per ridurre l'utilizzo di calcolo dell'indice attivo, identificare la risorsa che produce la quantità cu più elevata. Ridurre quindi le dimensioni totali dell'indice, le dimensioni dell'indice vettoriale o entrambe. L'archiviazione indicizzata rimane un addebito separato per GB/mese.
Il modello tariffario serverless è il più conveniente per i carichi di lavoro con traffico variabile, intermittente o imprevedibile, per i quali la capacità preallocata risulterebbe sottoutilizzata.
Importante
Gli addebiti per le CU serverless coprono le attività svolte all'interno del servizio di ricerca, incluse query, indicizzazione, elaborazione dei risultati e orchestrazione del recupero tramite agenti. Le chiamate modello e le altre attività eseguite al di fuori del servizio di ricerca continuano a utilizzare i misuratori di fatturazione esistenti. Tra gli esempi figurano il ranking semantico, la riscrittura agentica delle query, l'estrazione delle immagini e l'esecuzione delle skill.
Informazioni sulle unità di calcolo (CU)
Un'unità di calcolo (CU) rappresenta le risorse di sistema misurate necessarie per eseguire operazioni di ricerca e indicizzazione nel modello serverless. Il costo della CU dipende principalmente dall'utilizzo di CPU, memoria e I/O e, in misura secondaria, dalla dimensione dell'indice e del payload del documento, con l'utilizzo fatturato in Compute Unit per ora (CU/h).
Il costo di calcolo varia in base a:
- Complessità della query
- Dimensioni e struttura dell'indice (GB)
- Dimensione del payload del documento (KB)
- Numero di campi e risultati recuperati
Diverse operazioni hanno profili di costo diversi:
- Ricerca: basso costo. Il recupero di un singolo documento in base al relativo ID è l'operazione più efficiente.
- Ricerca di parole chiave: basso costo. La ricerca di testo usa indici invertiti, ottimizzati per la velocità e l'utilizzo di calcolo ridotto.
- Ricerca vettoriale: costo elevato. Le query vettoriali sono dispendiose dal livello di calcolo perché richiedono calcoli di somiglianza tra incorporamenti di dimensioni elevate. Rispetto alla ricerca di parole chiave, utilizzano molto più calcolo.
- Ricerca ibrida: combina i costi della ricerca per parole chiave e della ricerca vettoriale, poiché entrambe le pipeline vengono eseguite per ogni query, oltre a un piccolo sovraccarico per la Reciprocal Rank Fusion (RRF) necessaria a unire i risultati.
Monitorare l'utilizzo del calcolo
Il monitoraggio del consumo di calcolo consente di identificare operazioni costose, ottimizzare i modelli di query e stimare i costi. Il costo unità di calcolo (CU) di ogni richiesta viene restituito nell'intestazione x-ms-azs-compute-units-consumed della risposta HTTP come numero a virgola mobile. Utilizza questa intestazione per individuare le operazioni più dispendiose e ottimizzare gli schemi di query. È possibile tenere traccia del costo cu di ogni richiesta esaminando le intestazioni di risposta HTTP e gli eventi dell'operazione in Monitoraggio di Azure. Per altre indicazioni sui tipi di dati di monitoraggio disponibili e sui metodi per l'analisi dei dati, vedere Monitorare Azure AI Search.
-
Intestazione:
x-ms-azs-compute-units-consumed: <value> - Valore: Un numero a virgola mobile che rappresenta le CU consumate.
Esempio:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
In questo esempio la richiesta ha utilizzato 12.45 unità di calcolo. È possibile usare questo valore per identificare le operazioni a costi elevati e confrontare il costo relativo di modelli di query diversi.
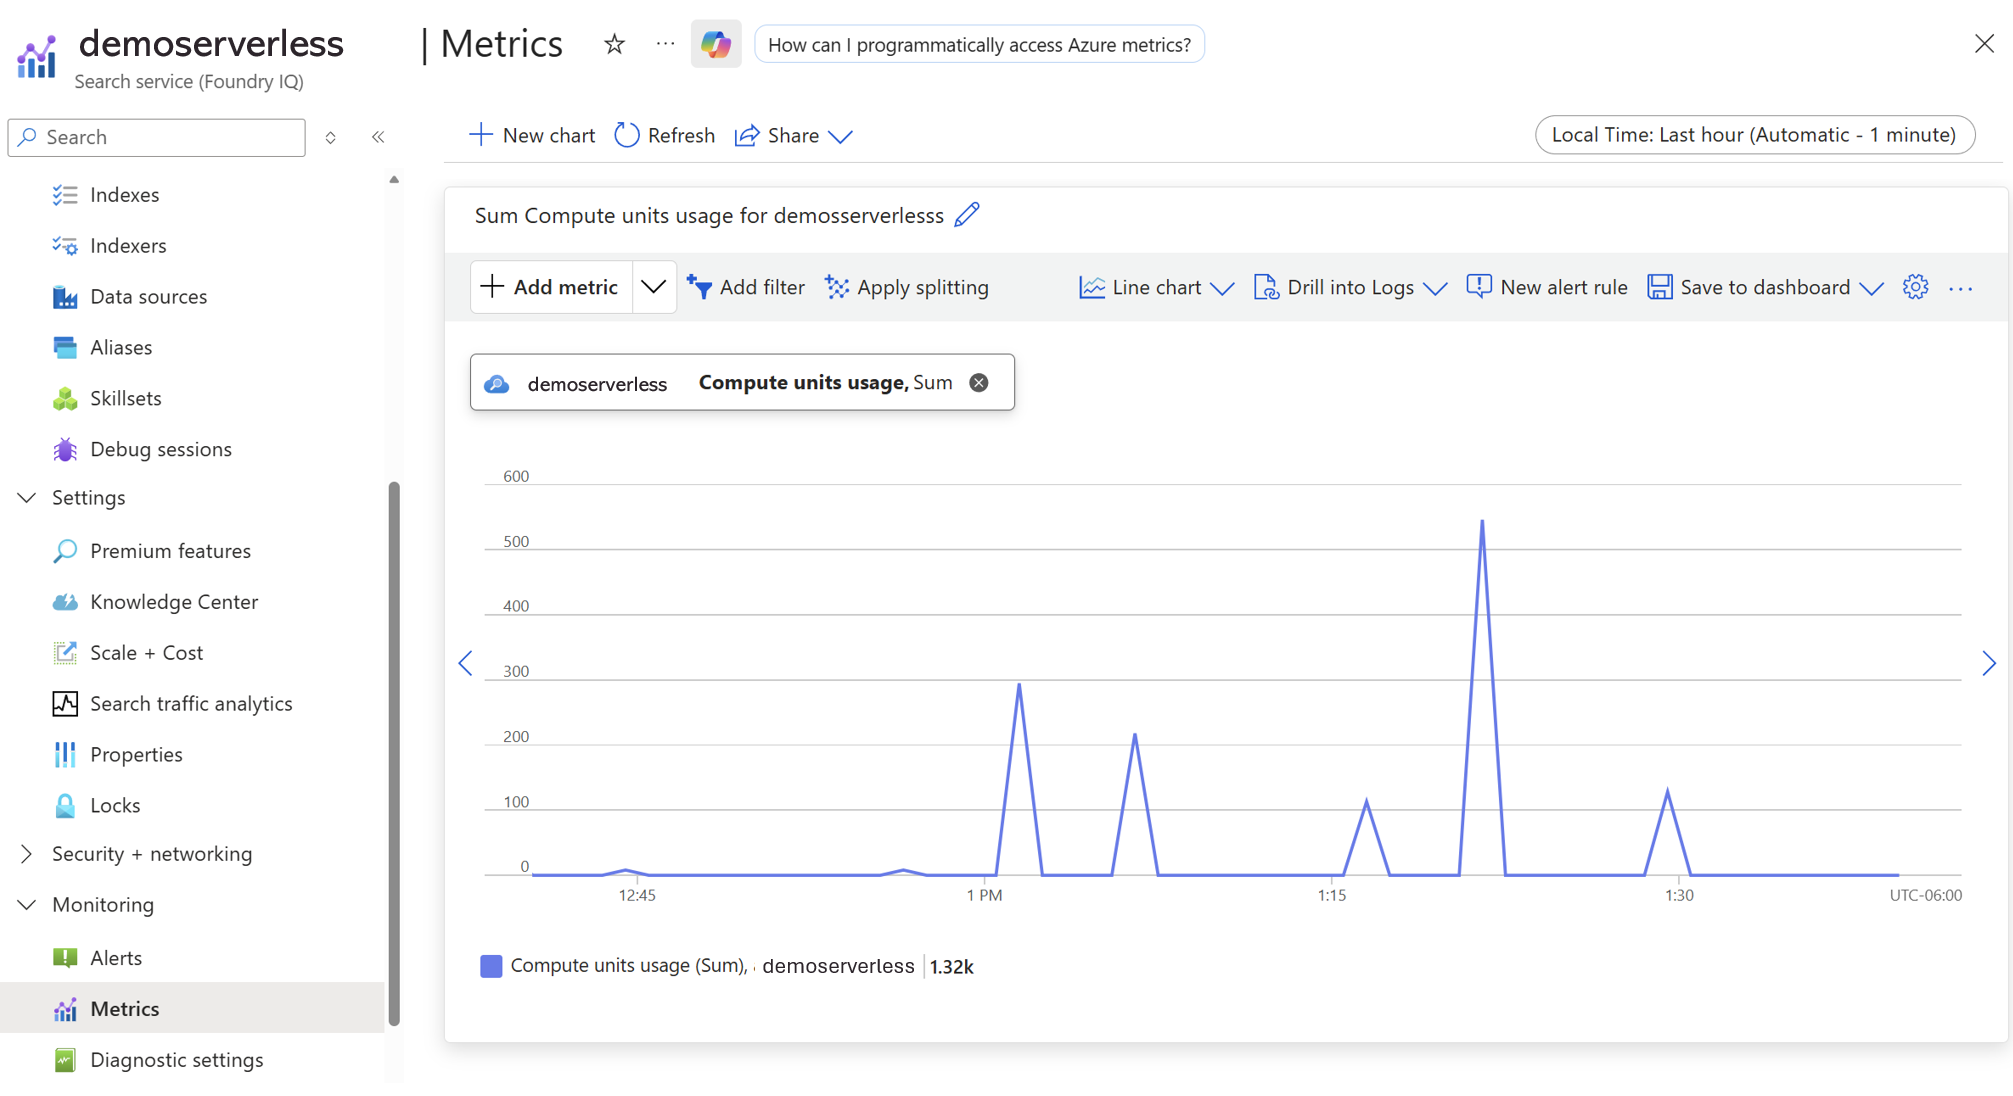
Per esaminare il consumo di calcolo cronologico per un servizio di ricerca serverless, usare le metriche di Monitoraggio di Azure nel portale di Azure:
- Passare al servizio di ricerca.
- Selezionare Metriche.
- Selezionare + Aggiungi metrica.
- Nell'elenco delle metriche selezionare Utilizzo unità di calcolo.
- Usare il grafico per analizzare le tendenze di utilizzo e identificare i periodi di aumento del consumo di calcolo.
Il monitoraggio dell'utilizzo aggregato consente di comprendere i costi complessivi del servizio e identificare i carichi di lavoro che usano la maggior parte delle risorse di calcolo. Per le descrizioni delle metriche di monitoraggio disponibili, vedere Informazioni di riferimento sul monitoraggio dei dati. È possibile usare i log Monitoraggio di Azure per tenere traccia dell'utilizzo aggregato del CU nel tempo e correlarlo con le modifiche al volume di query e al carico di lavoro.
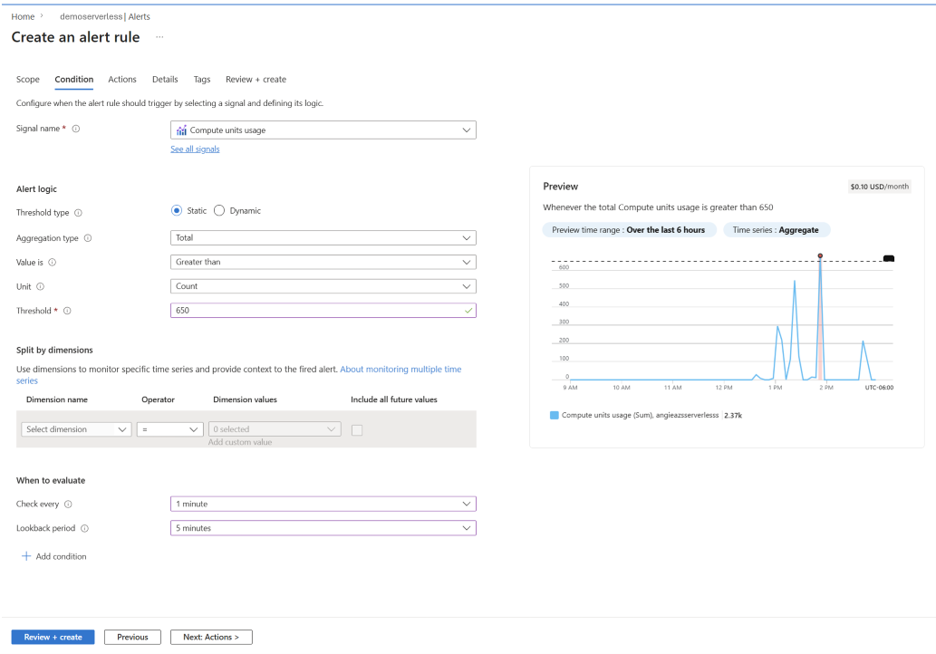
Configurare gli avvisi per l'utilizzo del calcolo
È possibile creare una regola di avviso per ricevere una notifica quando il consumo di calcolo raggiunge una soglia specificata nel portale di Azure.
- Passare a Avvisi nel servizio di ricerca.
- Selezionare + Crea regola di avviso.
- In Condizione scegliere Utilizzo unità di calcolo come segnale.
- Definire la logica di avviso. Ad esempio, attivare quando l'utilizzo totale è maggiore di un valore specificato.
- Configurare azioni, ad esempio notifiche tramite posta elettronica, SMS o webhook.
- Completare i passaggi rimanenti e selezionare Rivedi e crea.
Gli avvisi consentono di rispondere in modo proattivo ai picchi di utilizzo imprevisti e di gestire i costi.
Stimare i costi serverless
Il calcolatore prezzi di Azure e le linee guida per la pianificazione della capacità basata sulle unità di ricerca (SU) non si applicano ai servizi che usano il modello tariffario serverless.
Per stimare i costi serverless:
- Dati di esempio rappresentativi dell'indice.
- Eseguire carichi di lavoro tipici di indicizzazione ed esecuzione di query.
- Registrare il
x-ms-azs-compute-units-consumedvalore restituito per ogni operazione. - Usare Monitoraggio di Azure metriche per misurare l'utilizzo aggregato nel tempo.
- Estrapolare i costi in base al traffico di produzione previsto.
Usare la scheda Scale + Cost nel portale di Azure per visualizzare l'utilizzo corrente e stimare i costi.
Poiché la stessa richiesta eseguita sugli stessi dati in genere produce un consumo di calcolo simile, i carichi di lavoro rappresentativi possono fornire una base affidabile per la stima dei costi.
L'utilizzo serverless viene misurato continuamente e aggregato ai fini della fatturazione. Il consumo di calcolo viene monitorato per ogni minuto ed emesso solo quando vengono usate le risorse di calcolo.
Quando si stimano i costi, usare i valori di addebito delle richieste per comprendere il costo delle singole operazioni e le metriche di Monitoraggio di Azure per comprendere i modelli generali di consumo dei servizi.
Usare entrambe le origini dati insieme per comprendere i costi: i dati a addebito per richiesta consentono di valutare le singole operazioni, mentre le metriche Monitoraggio di Azure consentono di comprendere l'utilizzo aggregato del servizio nel tempo. Per un quadro dei costi completo, tenere conto anche delle funzionalità fatturate separatamente dalle unità di calcolo.
La fatturazione si basa sull'utilizzo di calcolo aggregato anziché sulle singole richieste. L'utilizzo viene misurato in intervalli di un minuto e arrotondato al più vicino 0,25 CU al minuto. Questi intervalli di utilizzo di un minuto si accumulano nel corso di un'ora per determinare l'importo di CU/ora fatturabile. Internamente, l'uso viene aggregato dalle milli-compute unit (mCU) alle compute unit (CU) e convertito nell'uso orario riportato ai fini della fatturazione.
Le diverse operazioni utilizzano quantità diverse di calcolo. In generale:
- Le ricerche con parole chiave usano in genere le risorse di calcolo meno sufficienti.
- Le ricerche vettoriali usano in genere più risorse di calcolo rispetto alle ricerche con parole chiave.
- Le ricerche ibride combinano le parole chiave e l'esecuzione della ricerca vettoriale, quindi in genere usano più risorse di calcolo rispetto a entrambe le tecniche da sole.
Il consumo di calcolo effettivo dipende da fattori quali complessità delle query, dimensioni dell'indice, volume di dati, configurazione vettoriale e numero di risultati restituiti. Il monitoraggio degli addebiti delle richieste e delle metriche di utilizzo aggregate consente di identificare le opportunità di ottimizzazione e prevedere meglio i costi di produzione.
Ridurre i costi di calcolo tramite l'ottimizzazione
Le query efficienti e la progettazione degli indici riducono il consumo di calcolo e riducono i costi.
Ottimizza il tuo schema
Lo schema dell'indice determina i costi di calcolo e archiviazione di base:
- Limita gli attributi del campo: abilita solo gli attributi (ricercabile, filtrabile, visobile, ordinabile) quando necessario. Ogni attributo aumenta le dimensioni dell'indice e i costi di indicizzazione.
- Semplificare i tipi complessi: Ove possibile, mappare le strutture JSON annidate a campi o raccolte semplici.
-
Impostare retrievable=false per i campi solo filtro o di ordinamento: se viene usato un campo per il filtro o l'ordinamento, ma non è necessario restituirlo nei risultati, mantenerlo indicizzato e impostato
retrievable=falseper ridurre i costi di archiviazione su disco e per GB/mese. - Usare campi di solo recupero quando possibile: ad esempio, i campi usati solo per la visualizzazione (ad esempio gli URL di immagine) non devono essere ricercabili.
- Riduci le dimensioni del vettore: i vettori a dimensionalità più elevata aumentano il costo di archiviazione e delle query. Usare modelli di incorporamento più piccoli o quantizzazione quando appropriato.
- Ridurre al minimo le dimensioni del payload del documento prima dell'indicizzazione: i documenti più grandi costano di più per l'indicizzazione. Rimuovi i campi non necessari, accorcia il testo lungo e rimuovi il codice HTML prima di inviare i documenti all'indice.
Ottimizzare le richieste di indicizzazione
La modalità di invio dei dati all'indice influisce sia sul costo che sulla velocità effettiva:
Usare batch di dimensioni maggiori quando possibile: l'indicizzazione batch riduce il sovraccarico per richiesta ammortizzando i costi di rete ed elaborazione in più documenti. In generale, i batch di massimo ~1.000 documenti o ~16 MB sono più efficienti in termini di CU rispetto a molte richieste piccole. Tuttavia, le dimensioni ottimali del batch dipendono dal carico di lavoro. Testare per bilanciare velocità effettiva, latenza e affidabilità.
Indicizzare solo dati nuovi o modificati: evitare la reindicizzazione completa quando possibile. L'invio solo di aggiunte e aggiornamenti riduce il numero di documenti elaborati, riducendo i costi di calcolo e migliorando la velocità di inserimento.
Ignorare l'estrazione di immagini a meno che non sia necessaria: l'estrazione di immagini aggiunge un lavoro di elaborazione aggiuntivo e può diventare un driver di costo separato. Attivarlo solo per i documenti o i flussi di lavoro che necessitano effettivamente del contenuto dell'immagine.
Tenere conto della crescita delle dimensioni dell'indice: laddove possibile, creare indici più piccoli. Man mano che un indice aumenta, l'indicizzazione dei costi aumenta perché è necessario archiviare e gestire più dati e le operazioni richiedono più calcolo. Per set di dati di dimensioni molto grandi, prendere in considerazione il partizionamento dei dati tra più indici per gestire prestazioni e costi. Sebbene i costi aumentino all'aumentare della dimensione dell'indice, l'aumento è sublineare. Gli indici più grandi costano di più per operazione, ma non proporzionalmente più.
Per altre indicazioni, vedere Tips for better performance in Azure AI Search.
Ottimizzare le operazioni dell'indicizzatore
L'utilizzo delle risorse di calcolo dell'indicizzatore serverless dipende dal lavoro eseguito a ogni esecuzione dell'indicizzatore. Per le origini basate su righe, utilizzare il numero di documenti elaborati come indicatore del volume del carico di lavoro. Per le origini basate su file, ad esempio Archiviazione BLOB di Azure e Azure Data Lake Storage Gen2, monitorare la quantità di dati di origine elaborati. L'utilizzo effettivo del calcolo dipende anche dai payload dei documenti, dalla struttura dell'indice, dall'arricchimento e da altre elaborazioni eseguite durante l'esecuzione.
Per ridurre l'utilizzo del calcolo dell'indicizzatore:
Usare il rilevamento delle modifiche e l'indicizzazione incrementale: elaborare solo dati nuovi o modificati anziché indicizzare ripetutamente l'origine dati completa.
Dimensiona correttamente le pianificazioni dell'indicizzatore: scegli una pianificazione che soddisfi i requisiti di freschezza dei dati. Usare i dati di telemetria delle unità di calcolo per valutare l'effetto della frequenza di pianificazione.
Ridurre il contenuto del documento non necessario: rimuovere il contenuto che non deve essere indicizzato ed escludere file o tipi di file non necessari.
Definire l'ambito delle competenze di arricchimento con attenzione: eseguire competenze solo su campi e documenti che richiedono l'arricchimento ed evitare di generare output non usati a valle. Le competenze fatturabili possono comportare addebiti distinti per le transazioni.
Monitorare le esecuzioni non riuscite e ripetute: un indicizzatore può consumare risorse di calcolo per il lavoro già completato prima che si verifichi un errore. Esaminare la cronologia di esecuzione e l'utilizzo delle unità di calcolo per identificare gli errori ricorrenti e i modelli di ripetizione dei tentativi.
Ottimizza le tue query
La progettazione delle query è il principale fattore del costo variabile:
Usare
$selectper limitare i campi restituiti: in questo modo si riducono le dimensioni del payload e il calcolo necessari per la serializzazione.GET /docs?search=test&$select=id,title,urlUtilizzare
searchFieldsper limitare i campi in cui viene cercato il testo: limita la corrispondenza in fase di query ai campi rilevanti per lo scenario. Ogni ulteriore campo ricercabile aumenta il carico di lavoro delle query e può aumentare i CU/h.Preferisci la corrispondenza esatta o semplici ricerche per parola chiave: Le query fuzzy, con caratteri jolly, con espressioni regolari e con prefissi possono comportare scansioni estese degli indici e consumare una quantità significativamente maggiore di CU/h. Usarli solo quando è necessario un comportamento di corrispondenza parziale e scegliere la corrispondenza esatta o le query di parole chiave più semplici laddove possibile.
Usa le ricerche per chiave anziché le ricerche generiche quando possibile: recuperare un documento tramite ID è più efficiente che eseguire una query di ricerca. Se conosci l'ID del documento, utilizza una ricerca per riferimento anziché una query di ricerca. Le ricerche sono più efficienti perché recuperano un documento direttamente in base alla chiave, mentre le query di ricerca richiamano la pipeline di query completa (analisi, attraversamento dell'indice, punteggio e classificazione) che aumenta il costo di calcolo.
Evitare il paging profondo (
$skip): i valori di grandi dimensioni$skipaumentano il calcolo perché il motore deve elaborare, assegnare punteggi e classificare i risultati che precedono la pagina richiesta. Ad esempio,$skip=5000richiede al motore di elaborare almeno 5.000 risultati che non vengono restituiti. Questa scelta usa unità di calcolo aggiuntive (CU) e può aumentare i costi. Usare invece i filtri per restringere il risultatosete$toplimitare il numero di risultati restituiti. Dimensionare correttamente$topper l'applicazione o l'interfaccia utente. Anche se$topnon cambia il numero di documenti corrispondenti con punteggio, un valore minore riduce il numero di risultati che devono essere raccolti, ordinati e serializzati. Richiedere solo il maggior numero di risultati necessari per l'applicazione ed evitare modelli di paging che richiedono al motore di elaborare un numero elevato di risultati inutilizzati.Riduci al minimo il numero di faccette e il loro ambito: richiedi solo le faccette visualizzate nella tua interfaccia utente e mantieni il valore di ogni faccetta
countil più basso possibile. Le facette richiedono aggregazioni per ogni query e un numero elevato di record aumenta i costi di elaborazione.Usare
search.inper il filtro: quando si filtra in base a un elenco di ID o valori, usare lasearch.infunzione anziché piùorcondizioni (ad esempio,id eq '1' or id eq '2'). Questo approccio è più efficiente e riduce il sovraccarico di calcolo. È inoltre consigliabile evitare di contrassegnare campi con cardinalità elevata (quelli con un numero elevato di valori univoci, ad esempio ID univoci o descrizioni di testo libero) come filtrabili o visualizzabili a meno che non sia necessario, in quanto aumenta le dimensioni dell'indice e il costo della query.
Ottimizzare le richieste amministrative
Oltre alle operazioni di query e indicizzazione, Azure AI Search include operazioni amministrative a livello di oggetto e a livello di servizio, ad esempio il recupero di schemi di indice o statistiche del servizio. Queste richieste hanno un costo flat per richiesta. Anche se ogni richiesta è economica, le chiamate ripetute o non necessarie possono accumularsi nel tempo e aumentare l'utilizzo complessivo del calcolo.
- Evitare richieste amministrative eccessive: memorizzare nella cache i metadati, ad esempio gli schemi di indice, sul lato client anziché recuperarli ripetutamente. Ad esempio, il recupero dello schema dell'indice prima che ogni operazione di scrittura introduca costi non necessari. Nel modello serverless questo modello aumenta direttamente i costi di calcolo, mentre nei servizi dedicati l'impatto è spesso nascosto dalla fatturazione oraria fissa.
Ottimizzare i costi dei vettori
I carichi di lavoro vettoriali sono in genere il componente a costo più elevato nella ricerca del modello di determinazione prezzi serverless perché influiscono sia sulle unità di calcolo (query che sull'indicizzazione) che sull'archiviazione (dimensioni vettoriali su disco). Per ridurre i costi, ottimizzare sia la modalità di archiviazione dei vettori che la modalità di query.
Ottimizzare l'archiviazione vettoriale e lo schema
I campi vettoriali possono aumentare significativamente le dimensioni dell'indice e i costi di indicizzazione. Usare le tecniche seguenti per ridurre il sovraccarico di archiviazione:
Usare la compressione per ridurre le dimensioni del vettore: applicare la quantizzazione per ridurre il footprint di archiviazione con un impatto minimo sulla pertinenza. Ad esempio, la quantizzazione scalare può ridurre l'archiviazione vettoriale fino a 4× con un impatto minimo sulla qualità della ricerca.
Disabilitare l'archiviazione per i vettori quando non è necessario: impostare stored=false nei campi vettoriali se sono necessari solo vettori per la ricerca, non per il recupero. In questo modo si evita di archiviare i vettori originali nell'indice, riducendo i costi di archiviazione senza influire sul comportamento delle query.
Usare dimensioni di incorporamento più piccole quando possibile: i vettori dimensionali superiori aumentano sia il costo di archiviazione che quello delle query. Per i carichi di lavoro non critici, usare modelli di incorporamento più piccoli (ad esempio, 384 o 768 dimensioni anziché 1536) per ridurre i costi.
Ottimizzare l'esecuzione di query vettoriali
Le query vettoriali sono a elevato utilizzo di calcolo perché richiedono calcoli di somiglianza su strutture di dati di dimensioni elevate.
Usare la ricerca ibrida in modo selettivo: le query ibride eseguono sia la parola chiave che il recupero vettoriale. Usare solo quando necessario per pertinenza.
Riduci maxTextRecallSize per le query ibride: L'impostazione
hybridSearch.maxTextRecallSizecontrolla quanti risultati classificati con BM25 confluiscono in Reciprocal Rank Fusion. Il valore predefinito è 1.000 (intervallo compreso tra 1 e 10.000). Il consumo di calcolo viene ridimensionato approssimativamente in modo lineare con questo valore, quindi riducendolo è una delle leve di costo più dirette per i carichi di lavoro ibridi.Valori intorno a 500 spesso riducono significativamente il carico computazionale, con una perdita minima di rilevanza.
Scendere ulteriormente può far perdere corrispondenze per parole chiave che la ricerca vettoriale non individua, ad esempio termini esatti, ID e acronimi.
Controlla i vettori candidati separatamente impostando k per ciascuna query vettoriale.
Prova query rappresentative e confronta la rilevanza, la latenza e l’intestazione
x-ms-azs-compute-units-consumedprima di stabilire un valore.Applicare filtri prima delle query vettoriali: restringere il set candidato prima della ricerca vettoriale per ridurre la quantità di dati elaborati. Vedere Funzionamento del filtro nelle query vettoriali.
Ridurre i costi riducendo al minimo l'utilizzo
Il modello serverless addebita solo le risorse utilizzate. Quando non sono presenti richieste, l'utilizzo del calcolo diminuisce di conseguenza.
Per ridurre al minimo i costi di utilizzo:
- Eseguire query solo quando necessario.
- Evitare richieste ridondanti o eccessivamente frequenti.
- Monitorare l'utilizzo e ottimizzare i carichi di lavoro in base alla richiesta.
Tip
La stessa query può presentare profili di latenza e CU diversi a seconda che il servizio sia "caldo" o "freddo". Dopo un periodo senza traffico di lettura o scrittura, l'utilizzo delle risorse di calcolo nel modello di determinazione prezzi serverless scende a zero. La richiesta successiva potrebbe presentare una latenza maggiore e consumare più unità di calcolo (CU) durante la fase di riscaldamento dei percorsi dati. Gli indici di dimensioni maggiori in genere richiedono più tempo rispetto agli indici più piccoli, quindi gli effetti di avvio a freddo sono spesso più evidenti nei servizi più grandi.
Ottimizzare i costi di archiviazione
L'archiviazione viene fatturata per GB/mese in base alle dimensioni dell'indice su disco, che possono superare le dimensioni dei dati non elaborate. Per ridurre i costi di archiviazione:
- Rimuovere gli indici inutilizzati.
- Ridurre al minimo i campi archiviati.
- Progettare schemi tenendo conto dell'overhead di archiviazione.
- Usare i suggerimenti in modo selettivo perché possono aumentare notevolmente le dimensioni di archiviazione.
Per tecniche specifiche del vettore (compressione, eliminazione e impostazioni di archiviazione), vedere Ottimizzare l'archiviazione e l'elaborazione vettoriali.
Per altre indicazioni sui compromessi delle prestazioni di archiviazione e query, vedere Tips per ottenere prestazioni migliori in Azure AI Search.