Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Nota
Azure AI Search è disponibile tramite il portale di Azure, le API REST e Azure SDK. È inoltre alla base di Foundry IQ, il livello di conoscenza gestito che trasforma il contenuto aziendale in knowledge base riutilizzabili e con riconoscimento delle autorizzazioni per gli agenti nel portale di Microsoft Foundry.
In Azure AI Search è possibile eseguire un indicizzatore in diversi modi:
- Eseguire immediatamente al momento della creazione dell'indicizzatore. Questa opzione è l'impostazione predefinita, a meno che non si crei l'indicizzatore in uno stato disabilitato.
- Eseguire in base a una pianificazione per richiamare l'esecuzione a intervalli regolari. Se un indicizzatore pianificato smette di attivare, vedere Domande frequenti sul comportamento di pianificazione per i passaggi di ripristino.
- Eseguire su richiesta, con o senza reimpostazione.
Questo articolo illustra come eseguire indicizzatori su richiesta, con e senza reimpostazione. Descrive anche l'esecuzione, la durata e la concorrenza dell'indicizzatore.
Modalità di connessione degli indicizzatori alle risorse Azure
Gli indicizzatori sono uno dei pochi sottosistemi che effettuano chiamate in uscita ad altre risorse di Azure. A seconda dell'origine dati esterna, è possibile usare chiavi o ruoli per autenticare la connessione.
In termini di ruoli Azure, gli indicizzatori non hanno identità separate: una connessione dal motore di ricerca a un'altra risorsa Azure usa l'identità gestita assegnata dal sistema o dall'utente di un servizio di ricerca, oltre a un'assegnazione di ruolo nella risorsa di destinazione Azure. Se l'indicizzatore si connette a una risorsa Azure in una rete virtuale, è opportuno creare un collegamento privato condiviso shared private link per tale connessione.
Nota
Gli indicizzatori operano con autorizzazioni a livello di servizio anziché con autorizzazioni utente. Un indicizzatore può scrivere in qualsiasi indice nel servizio di ricerca, anche se sono stati assegnati ruoli per limitare l'accesso a indici specifici. Per altre informazioni, vedere Operazioni relative all'ambito per indice e all'indicizzatore.
Esecuzione dell'indicizzatore
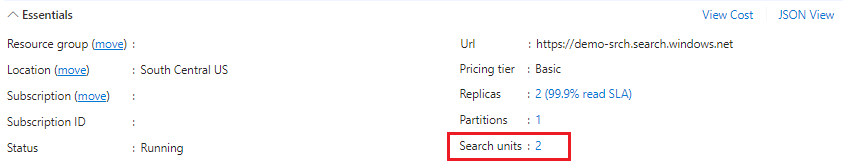
Un servizio di ricerca esegue un processo indicizzatore per ogni unità di ricerca. Ogni servizio di ricerca inizia con un'unità di ricerca, ma ogni nuova partizione o replica aumenta le unità di ricerca del servizio. È possibile controllare il numero di unità di ricerca nella sezione Essential del portale di Azure della pagina Overview. Se è necessaria un'elaborazione simultanea, assicurarsi che le unità di ricerca includano repliche sufficienti. Gli indicizzatori non vengono eseguiti in background, quindi è possibile riscontrare più limitazioni delle query rispetto al solito se il servizio è sotto pressione.
Lo screenshot seguente mostra il numero di unità di ricerca, che determina il numero di indicizzatori che possono essere eseguiti contemporaneamente.
Una volta avviata l'esecuzione dell'indicizzatore, non è possibile sospendere o arrestarla. L'esecuzione dell'indicizzatore si arresta quando non sono più presenti documenti da caricare o aggiornare o quando viene raggiunto il limite massimo di tempo di esecuzione .
È possibile eseguire più indicizzatori contemporaneamente presupponendo capacità sufficiente, ma ogni indicizzatore è a istanza singola. L'avvio di una nuova istanza mentre l'indicizzatore è già in esecuzione genera questo errore: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Ambiente di esecuzione dell'indicizzatore
Un lavoro dell'indicizzatore viene eseguito in un ambiente di esecuzione gestito. Attualmente sono disponibili due ambienti:
Un ambiente di esecuzione privato viene eseguito nei cluster di ricerca specifici del servizio di ricerca.
Un ambiente multi-tenant include processori di contenuto che Microsoft gestisce e protegge senza costi aggiuntivi. Questo ambiente scarica l'elaborazione ad alta intensità di calcolo, così che le risorse specifiche del servizio rimangano disponibili per le operazioni di routine. Quando possibile, la maggior parte delle competenze viene eseguita nell'ambiente multitenant. Questo ambiente è l'impostazione predefinita.
L'elaborazione a elevato utilizzo di calcolo si riferisce a set di competenze in esecuzione su processori di contenuto e processi indicizzatore che elaborano un volume elevato di documenti o documenti di grandi dimensioni. Le euristiche e le informazioni di sistema determinano l'elaborazione non relativa al set di competenze nei processori di contenuti multi-tenant e non sono sotto il controllo del cliente.
È possibile impedire l'utilizzo dell'ambiente multi-tenant nei servizi Standard2 o superiori aggiungendo un indicizzatore e l'elaborazione del set di competenze esclusivamente ai cluster di ricerca.
Impostare il executionEnvironment parametro nella definizione dell'indicizzatore per eseguire sempre un indicizzatore nell'ambiente di esecuzione privato.
I firewall IP bloccano l'ambiente multi-tenant, quindi, se si dispone di un firewall, creare una regola che consenta le connessioni del processore multi-tenant.
I limiti dell'indicizzatore variano per ogni ambiente:
| Carico | Durata massima | Numero massimo di lavori | Ambiente di esecuzione |
|---|---|---|---|
| Esecuzione privata | 24 ore | Un job di indicizzazione per l'unità di ricerca1. | L'indicizzazione non viene eseguita in background. Il servizio di ricerca bilancia invece tutti i processi di indicizzazione rispetto alle query in corso e alle azioni di gestione degli oggetti, ad esempio la creazione o l'aggiornamento di indici. Quando si eseguono indicizzatori, ci si aspetta di vedere una latenza di query se i volumi di indicizzazione sono grandi. |
| Multitenant | 2 ore 2 | Indeterminato 3 | Poiché il cluster di elaborazione del contenuto è multi-tenant, il sistema aggiunge processori di contenuto per soddisfare la domanda. Se si verifica un ritardo nell'esecuzione su richiesta o pianificata, è probabile che il sistema stia aggiungendo processori o aspettando che uno diventi disponibile. |
1 Le unità di ricerca possono essere combinazioni flessibili di partizioni e repliche, ma i processi dell'indicizzatore non sono associati a uno o all'altro. In altre parole, se si dispone di 12 unità, è possibile avere 12 processi indicizzatore in esecuzione simultaneamente nell'esecuzione privata, indipendentemente dalla modalità di distribuzione delle unità di ricerca.
2 Se sono necessarie più di due ore per elaborare tutti i dati, abilitare il rilevamento delle modifiche e pianificare l'esecuzione dell'indicizzatore a intervalli di 5 minuti per riprendere rapidamente l'indicizzazione se si arresta a causa di un timeout. Per altre strategie, vedere Indicizzazione di un set di dati di grandi dimensioni .
3 "Indeterminate" indica che il limite non è quantificato in base al numero di lavori. Alcuni carichi di lavoro, ad esempio l'elaborazione del set di competenze, possono essere eseguiti in parallelo, il che potrebbe comportare molti processi anche se è coinvolto un solo indicizzatore. Anche se l'ambiente non impone vincoli, i limiti dell'indicizzatore per il servizio di ricerca vengono ancora applicati.
Esecuzione senza reimpostazione
Un'operazione Esegui indicizzatore rileva ed elabora solo ciò che deve sincronizzare l'indice di ricerca con le modifiche nell'origine dati sottostante. L'indicizzazione incrementale inizia individuando un valore soglia interno per trovare il documento di ricerca aggiornato più di recente. Questo documento diventa il punto di partenza per l'esecuzione dell'indicizzatore su documenti nuovi e aggiornati nell'origine dati.
Il rilevamento delle modifiche è essenziale per determinare le novità o l'aggiornamento nell'origine dati. Gli indicizzatori usano le funzionalità di rilevamento delle modifiche dell'origine dati sottostante per determinare le novità o gli aggiornamenti nell'origine dati.
Archiviazione di Azure ha il rilevamento delle modifiche predefinito tramite la relativa proprietà LastModified.
Altre origini dati, ad esempio Azure SQL o Azure Cosmos DB, richiedono la configurazione per il rilevamento delle modifiche prima che l'indicizzatore possa leggere righe nuove e aggiornate.
Se il contenuto sottostante è invariato, un'operazione di esecuzione non ha alcun effetto. In questo caso, la cronologia di esecuzione dell'indicizzatore indica 0\0 i documenti elaborati.
Per rielaborare tutti i documenti, è necessario reimpostare l'indicizzatore.
Reimpostare gli indicizzatori
Dopo l'esecuzione iniziale, un indicizzatore monitora i documenti di ricerca che sono indicizzati tramite un limite massimo interno. Il marcatore non è esposto, ma internamente l'indicizzatore sa dove si è fermato l'ultima volta.
Per ricompilare tutto o parte di un indice, usare le API Reset disponibili a livelli decrescenti nella gerarchia degli oggetti:
- Reimposta gli indicizzatori cancella il marcatore del limite massimo ed esegue una reindicizzazione completa di tutti i documenti.
- Resync Indexers (anteprima) esegue una reindicizzazione parziale efficiente di tutti i documenti.
- Reimposta documenti (anteprima) reindicisce un documento o un elenco di documenti specifici.
- Reimposta abilità (anteprima) avvia l'elaborazione delle abilità per un'abilità specifica.
Dopo la reimpostazione, seguire il comando Esegui per rielaborare i documenti nuovi ed esistenti. Non è possibile rimuovere i documenti di ricerca orfani che non hanno alcuna controparte nell'origine dati tramite reimpostazione ed esecuzione. Per eliminare documenti specifici, vedere Eliminare documenti in un indice di ricerca o documenti - Indice.
Nota
Le tabelle non possono essere vuote. Se si utilizza TRUNCATE TABLE per cancellare le righe, una reimpostazione e una riesecuzione dell'indicizzatore non rimuoveranno i documenti di ricerca corrispondenti. Per rimuovere i documenti di ricerca orfani, è necessario indicizzarli con un'azione di eliminazione.
Come reimpostare ed eseguire indicizzatori
Reimposta cancella il limite massimo. Tutti i documenti nell'indice di ricerca vengono contrassegnati per la sovrascrittura completa, senza aggiornamenti inline o unione nel contenuto esistente. Per gli indicizzatori con un set di competenze e la memorizzazione nella cache di arricchimento (anteprima), la reimpostazione implicita dell'indice reimposta anche il set di competenze.
Il lavoro effettivo si verifica quando si segue una reimpostazione con un comando Esegui:
- Tutti i nuovi documenti trovati nell'origine sottostante vengono aggiunti all'indice di ricerca.
- Tutti i documenti presenti sia nell'origine dati che nell'indice di ricerca vengono sovrascritti nell'indice di ricerca.
- Tutti i contenuti arricchiti creati a partire da set di competenze vengono ricostruiti. La cache di arricchimento, se abilitata, viene aggiornata.
Come indicato in precedenza, la reimpostazione è un'operazione passiva: è necessario seguire con una richiesta Esegui per ricompilare l'indice.
Le operazioni di reimpostazione/esecuzione si applicano a un indice di ricerca o a un archivio conoscenze, a documenti o proiezioni specifici e agli arricchimenti memorizzati nella cache se una reimpostazione include in modo esplicito o implicito le competenze.
La reimpostazione si applica anche alle operazioni di creazione e aggiornamento. Non attiva l'eliminazione o la pulizia dei documenti orfani nell'indice di ricerca. Per altre informazioni sull'eliminazione di documenti, vedere Documenti - Indice.
Non è possibile annullare un'operazione di reimpostazione.
Passare al servizio di ricerca nel portale Azure.
Nella pagina Panoramica selezionare la scheda Indicizzatori .
Selezionare un indicizzatore.
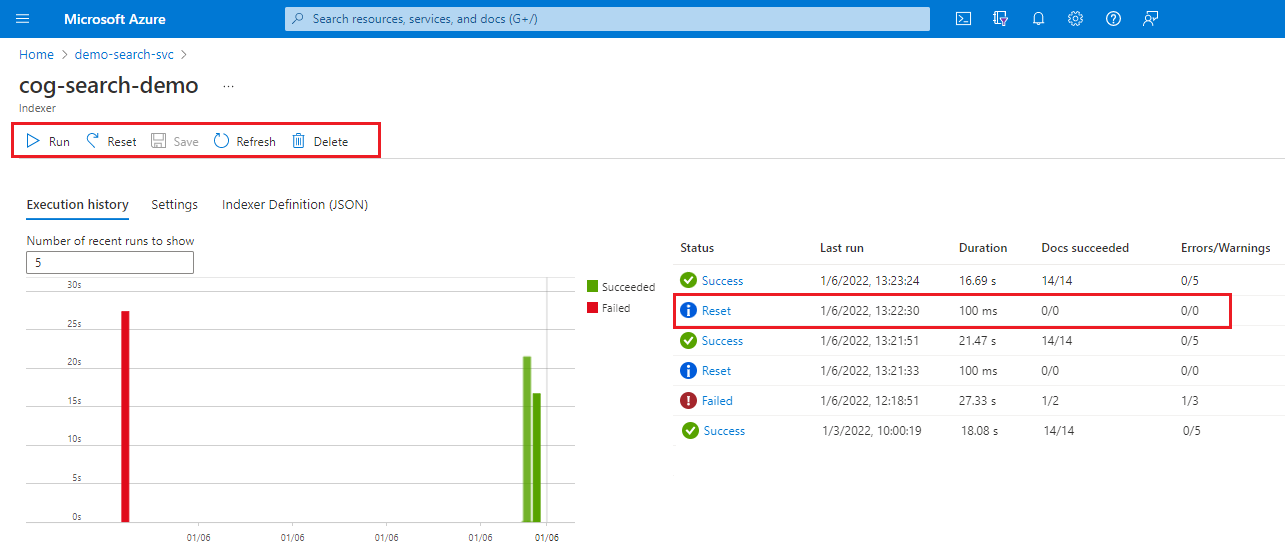
Selezionare il comando Reimposta e quindi selezionare Sì per confermare l'azione.
Aggiornare la pagina per visualizzare lo stato. È possibile selezionare l'elemento per visualizzarne i dettagli.
Selezionare Esegui per avviare l'elaborazione dell'indicizzatore oppure attendere l'esecuzione pianificata successiva.
Come reimpostare le competenze (anteprima)
La richiesta di reimpostazione delle competenze elabora in modo selettivo una o più competenze durante la successiva esecuzione dell'indicizzatore. Per gli indicizzatori che dispongono di set di competenze, è possibile reimpostare le singole competenze per forzare l'elaborazione ulteriore di quella specifica competenza e di qualsiasi competenza a valle che dipende dal suo output. Se è stata abilitata la cache di arricchimento, la richiesta lo aggiorna anche.
Per gli indicizzatori con memorizzazione nella cache abilitata, è possibile richiedere in modo esplicito l'elaborazione per gli aggiornamenti delle competenze che l'indicizzatore non riesce a rilevare. Ad esempio, se si apportano modifiche esterne, ad esempio revisioni a una competenza personalizzata, usare questa API per rieseguire la competenza. Il processo aggiorna gli output, ad esempio un archivio conoscenze o un indice di ricerca, usando dati riutilizzabili dalla cache e nuovo contenuto in base alla competenza aggiornata.
Usare l'API di anteprima più recente.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
È possibile specificare singole competenze, come illustrato nell'esempio precedente, ma se una di queste competenze richiede l'output delle competenze non elencate (da 2 a 4), il processo viene eseguito in modo non elencato, a meno che la cache non possa fornire le informazioni necessarie. Per rendere vera questa condizione, gli arricchimenti memorizzati nella cache per le competenze da #2 a #4 non devono dipendere da #1 (elencato per la reimpostazione).
Se non si specificano competenze, il processo esegue l'intero set di competenze e, se la memorizzazione nella cache è abilitata, aggiorna anche la cache.
Ricordarsi di eseguire il completamento con Run Indexer per richiamare l'elaborazione effettiva.
Come reimpostare la documentazione (anteprima)
L'API Indexers - Reset Docs (anteprima) accetta un elenco di chiavi di documento in modo da poter aggiornare documenti specifici. Se si specificano i parametri di reimpostazione, determinano esclusivamente ciò che viene elaborato, indipendentemente dalle altre modifiche nei dati sottostanti. Ad esempio, se sono stati aggiunti o aggiornati 20 BLOB dall'ultima esecuzione dell'indicizzatore, ma si reimposta un solo documento, l'indicizzatore elabora solo tale documento.
Per ogni documento, l'indicizzatore aggiorna tutti i campi del documento di ricerca con valori e metadati dall'origine dati. Non è possibile selezionare e scegliere i campi da aggiornare.
Se l'origine dati è Azure Data Lake Storage (ADLS) Gen2 e i BLOB sono associati ai metadati delle autorizzazioni, l'indicizzatore reinsegnerà tali autorizzazioni nell'indice di ricerca se le autorizzazioni cambiano nei dati sottostanti. Per altre informazioni, vedere Re-indexing ACL and RBAC scope with ADLS Gen2 indexers (Ridedicizzazione dell'ACL e dell'ambito RBAC con indicizzatori ADLS Gen2).
Se si arricchisce il documento tramite un set di competenze con dati memorizzati nella cache, l'indicizzatore richiama il set di competenze solo per i documenti specificati e aggiorna la cache per i documenti rielaborati.
Quando si testa questa API per la prima volta, le API seguenti consentono di convalidare e testare i comportamenti. Usare l'API di anteprima più recente.
Chiama Indexers - Ottieni lo stato utilizzando una versione dell'API di anteprima per controllare lo stato di ripristino e lo stato di esecuzione. È possibile trovare informazioni sulla richiesta di reimpostazione alla fine della risposta di stato.
Chiamare Indicizzatore - Reimposta documenti con una versione API di anteprima per specificare i documenti da elaborare.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
L'API accetta due tipi di identificatori di documento come input: chiavi documento che identificano in modo univoco i documenti in un indice di ricerca e identificatori di documento di origine dati che identificano in modo univoco i documenti in un'origine dati. Il corpo deve contenere un elenco di chiavi dei documenti oppure un elenco di identificatori di documento ricercati dall'indicizzatore all'interno della fonte di dati. La chiamata all'API aggiunge le chiavi del documento o gli identificatori del documento dell'origine dati per reimpostare i metadati dell'indicizzatore. Alla successiva esecuzione pianificata o su richiesta dell'indicizzatore, l'indicizzatore elabora solo i documenti di reimpostazione.
Se si utilizzano chiavi dei documenti per reimpostare i documenti e le chiavi dei documenti vengono menzionate in una mappatura dei campi dell'indicizzatore, l'indicizzatore utilizza la mappatura dei campi per individuare il campo appropriato nell'origine dati sottostante.
Le chiavi del documento fornite nella richiesta sono valori dell'indice di ricerca, che possono essere diversi dai campi corrispondenti nell'origine dati. Se non si è certi del valore della chiave, inviare una query per restituire il valore. È possibile usare
selectper restituire solo il campo chiave del documento.Per i BLOB che l'indicizzatore analizza come più documenti di ricerca (quando
parsingModeè impostato su jsonLines o jsonArrays oppure delimitedText), l'indicizzatore genera la chiave del documento e il processo potrebbe non essere noto. In questo scenario, si effettua una query sulla chiave del documento per restituire il valore corretto.Se si vuole che l'indicizzatore interrompa il tentativo di elaborare i documenti di reimpostazione, impostare
"documentKeys"o"datasourceDocumentIds"su un elenco[]vuoto. Questa azione fa sì che l'indicizzatore riprenda la normale indicizzazione in base al limite massimo. Chiavi documento non valide o che non esistono vengono ignorate.
Chiamare Run Indexer (qualsiasi versione dell'API) per elaborare i documenti specificati. L'indicizzatore indicizza solo i documenti specifici.
Chiamare Run Indexer una seconda volta per elaborare a partire dall'ultimo marcatore di progresso.
Chiamare i documenti di ricerca per verificare la presenza di valori aggiornati e anche per restituire le chiavi del documento se non si è certi del valore. Usare
"select": "<field names>"se si desidera limitare i campi visualizzati nella risposta.
Sovrascrivere l'elenco di chiavi del documento
Se si chiama l'API Reimposta documenti più volte con chiavi diverse, le nuove chiavi vengono aggiunte all'elenco di chiavi documento reimpostate. Se si chiama l'API con il overwrite parametro impostato su true, l'elenco corrente viene sostituito con quello nuovo:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Come risincronizzare gli indicizzatori (anteprima)
Resync Indexers è un'API REST di anteprima che esegue una reindicizzazione parziale di tutti i documenti. Un indicizzatore viene considerato sincronizzato con l'origine dati quando campi specifici di tutti i documenti nell'indice di destinazione sono coerenti con i dati nell'origine dati. In genere, un indicizzatore ottiene la sincronizzazione dopo un'esecuzione iniziale riuscita. Se si elimina un documento dall'origine dati, l'indicizzatore rimane sincronizzato in base a questa definizione. Tuttavia, durante l'esecuzione successiva dell'indicizzatore, il documento corrispondente nell'indice di destinazione viene rimosso se il rilevamento dell'eliminazione è abilitato.
Se si modifica un documento nell'origine dati, l'indicizzatore diventa non sincronizzato. In genere, i meccanismi di rilevamento delle modifiche risincronizzano l'indicizzatore durante l'esecuzione successiva. Ad esempio, in Archiviazione di Azure, la modifica di un blob aggiorna la data e l'ora dell'ultima modifica, in modo che l'indicizzatore possa reindicizzarlo durante l'esecuzione successiva, perché la data e l'ora aggiornate superano il valore limite massimo impostato dall'esecuzione precedente.
Al contrario, per alcune origini dati come ADLS Gen2, la modifica degli elenchi di controllo di accesso (ACL) di un blob non ne cambia la data e l'ora dell'ultima modifica, quindi il tracciamento delle modifiche è inefficace se gli ACL devono essere acquisiti. Di conseguenza, il BLOB modificato non viene indicizzato nuovamente nell'esecuzione successiva, perché vengono elaborati solo i documenti modificati dopo l'ultimo limite massimo.
Anche se l'uso di "reset" o "reset docs" può risolvere questo problema, "reset" può richiedere molto tempo e inefficiente per i set di dati di grandi dimensioni e "reimpostare la documentazione" richiede l'identificazione della chiave del documento del BLOB che si vuole aggiornare.
Resync Indexers offre un'alternativa efficiente e conveniente. È sufficiente posizionare l'indicizzatore in modalità risincronizzazione e specificare il contenuto da risincronizzare chiamando l'API degli indicizzatori risincroni. Nell'esecuzione successiva, l'indicizzatore controlla solo la parte rilevante dei dati nell'origine ed evita qualsiasi elaborazione non necessaria non correlata ai dati specificati. Esegue anche una query sui documenti esistenti nell'indice di destinazione e aggiorna solo i documenti che mostrano discrepanze tra l'origine dati e l'indice di destinazione. Dopo l'esecuzione della risincronizzazione, l'indicizzatore viene sincronizzato e ripristina la modalità di esecuzione regolare dell'indicizzatore per le esecuzioni successive.
Come risincronizzare ed eseguire indicizzatori
Chiamare Indicizzatori - Sincronizza nuovamente con una versione API di anteprima per specificare i contenuti da sincronizzare nuovamente.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- Il
optionscampo è obbligatorio. Attualmente, l'unica opzione supportata èpermissions. Vale a dire, vengono aggiornati solo i campi di filtro delle autorizzazioni nell'indice di destinazione.
- Il
Chiamare Run Indexer (qualsiasi versione dell'API) per sincronizzare nuovamente l'indicizzatore.
Chiamare Run Indexer una seconda volta per elaborare a partire dall'ultimo marcatore di progresso.
Controllare lo stato di reimpostazione "currentState"
Per controllare lo stato di reimpostazione e verificare quali chiavi del documento sono in coda per l'elaborazione, seguire questa procedura:
Chiamare Get Indexer Status (Ottieni stato indicizzatore) usando un'API di anteprima.
L'API di anteprima restituisce la
currentStatesezione trovata alla fine della risposta."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Controllare la "modalità":
Per Reimposta competenze, impostare la "modalità" su
indexingAllDocsperché potenzialmente tutti i documenti sono interessati, in termini di campi popolati dall'arricchimento tramite intelligenza artificiale.Per Sincronizza nuovamente indicizzatore, impostare la "modalità" su
indexingResync. L'indicizzatore controlla tutti i documenti e si concentra sui dati interessati nell'origine dati e sui campi interessati nell'indice di destinazione.Per Reimposta documenti, impostare la "modalità" su
indexingResetDocs. L'indicizzatore mantiene questo stato fino a quando non elabora tutte le chiavi del documento fornite nella chiamata di reimpostazione dei documenti. Durante questo periodo, non vengono eseguiti altri processi dell'indicizzatore durante l'avanzamento dell'operazione. Per trovare tutti i documenti nell'elenco delle chiavi dei documenti, è necessario analizzare ogni documento per individuare e confrontare la chiave. Questo processo può richiedere del tempo se il set di dati è di grandi dimensioni. Se un contenitore BLOB contiene centinaia di BLOB e i documenti da reimpostare sono alla fine, l'indicizzatore non trova i BLOB corrispondenti finché non verifica prima tutti gli altri.Dopo che l'indicizzatore ha rielaborato i documenti, eseguire nuovamente Ottieni lo stato dell'indicizzatore. L'indicizzatore torna alla
indexingAllDocsmodalità ed elabora tutti i documenti nuovi o aggiornati all'esecuzione successiva.
Controllare la quota di runtime dell'indicizzatore per i servizi di ricerca S3 HD e Serverless
Questa sezione si applica ai servizi di ricerca standard 3 ad alta densità (S3 HD) e serverless. Per indicazioni sulla pianificazione e sul comportamento delle quote aggregate, vedere Esecuzione dell'indicizzatore in Serverless e S3 HD (anteprima).
Ogni esecuzione dell'indicizzatore ha una durata massima di due ore. Separatamente, tutti gli indicizzatori condividono 24 ore di tempo di esecuzione cumulativo per servizio in ciascuna finestra di 24 ore UTC.
Per monitorare i tempi di esecuzione dell'indicizzatore rispetto alla finestra di 24 ore, ottenere statistiche del servizio e ottenere lo stato dell'indicizzatore restituiscono ora altre informazioni nella risposta.
Tenere traccia della quota cumulativa di tempo di esecuzione
Tenere traccia dell'utilizzo cumulativo del runtime dell'indicizzatore di un servizio di ricerca e determinare la quota di runtime lasciata all'interno dell'intervallo di 24 ore corrente.
Inviare una richiesta GET all'endpoint del servizio di ricerca. Per informazioni su come configurare un client REST e ottenere un token di accesso, vedere Connettersi a un servizio di ricerca.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Le risposte includono indexersRuntime proprietà che mostrano l'ora di inizio e di fine della finestra, i secondi cumulativi usati da tutti gli indicizzatori e i secondi rimanenti per il servizio.
Tenere traccia della quota di runtime dell'indicizzatore
Restituisce le stesse informazioni per un singolo indicizzatore.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Le risposte includono runtime proprietà che mostrano l'ora di inizio e di fine della finestra, i secondi usati dall'indicizzatore e i secondi rimanenti per tutti gli indicizzatori nel servizio.
Passaggi successivi
Le API di reimpostazione vengono usate per informare l'ambito dell'esecuzione successiva dell'indicizzatore. Per l'elaborazione effettiva, è necessario richiamare un'esecuzione dell'indicizzatore su richiesta o consentire a un processo pianificato di completare il lavoro. Al termine dell'esecuzione, l'indicizzatore riprende la normale elaborazione, sia essa pianificata o su richiesta.
Dopo aver reimpostato ed eseguito di nuovo i processi dell'indicizzatore, è possibile monitorare lo stato dal servizio di ricerca o ottenere informazioni dettagliate tramite la registrazione delle risorse.