Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Note
Azure AI Search è disponibile tramite il portale di Azure, le API REST e Azure SDK. È inoltre alla base di Foundry IQ, il livello di conoscenza gestito che trasforma il contenuto aziendale in knowledge base riutilizzabili e con riconoscimento delle autorizzazioni per gli agenti nel portale di Microsoft Foundry.
Importante
Le funzionalità, le funzionalità o le proprietà contrassegnate (anteprima) non sono coperte da un contratto di servizio, non sono consigliate per i carichi di lavoro di produzione e potrebbero cambiare o essere vincolate prima che diventino disponibili a livello generale. Le condizioni di anteprima Azure AI Search si applicano a tutte le funzionalità di anteprima, indipendente o parte di una funzionalità disponibile a livello generale.
Questo articolo illustra come aggiungere la memorizzazione nella cache a una pipeline del set di competenze in modo da poter modificare i passaggi di arricchimento downstream senza una ricompilazione completa ogni volta. La memorizzazione nella cache per l'arricchimento (anteprima) richiede un'API REST di anteprima. Per impostazione predefinita, un set di competenze è senza stato e la modifica di qualsiasi parte della sua composizione richiede una riesecuzione completa dell'indicizzatore. Con una cache di arricchimento, l'indicizzatore determina quali parti dell'albero del documento devono essere aggiornate in base alle modifiche apportate al set di competenze o alla definizione dell'indicizzatore. L'indicizzatore mantiene e riutilizza l'output elaborato esistente, se possibile.
Il contenuto memorizzato nella cache viene inserito in Archiviazione di Azure usando un stringa di connessione fornito dall'utente. L'indicizzatore crea questi oggetti quando viene eseguito. Considerare la cache di arricchimento un componente interno gestito dal servizio di ricerca che non è necessario modificare.
Importante
Una cache di arricchimento non è un backup degli output del set di competenze, dello stato dell'indicizzatore o dei documenti indicizzati. Non tiene traccia dei documenti che completano l'elaborazione. Per le origini dati di grandi dimensioni, vedere la sezione Limitazioni prima di abilitare la memorizzazione nella cache.
- Contenitore denominato
ms-az-search-indexercache-<alpha-numeric-string> - Tabelle chiamate
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Prerequisiti
Archiviazione di Azure per l'archiviazione degli arricchimenti memorizzati nella cache. L'account di archiviazione deve essere per utilizzo generico v2.
Solo per l'indicizzazione BLOB, se è necessaria la rimozione sincronizzata dei documenti dalla cache e dall'indice quando i BLOB vengono eliminati dall'origine dati, abilitare un criterio di eliminazione nell'indicizzatore. Senza questo criterio, l'eliminazione di documenti dalla cache non è supportata.
È necessario avere familiarità con la configurazione di indicizzatori e set di competenze. Iniziare con la panoramica dell'indicizzatore e quindi passare ai set di competenze per informazioni sulle pipeline di arricchimento.
Limitazioni
Attenzione
Se si usa l'indicizzatore SharePoint (anteprima), evitare l'arricchimento incrementale. In determinate circostanze, la cache diventa non valida. Per ricaricarlo, eseguire una reimpostazione dell'indicizzatore e la ricompilazione completa.
Le origini dati di grandi dimensioni presentano una limitazione aggiuntiva della cache.
Attenzione
Per le origini dati di grandi dimensioni, una cache di arricchimento può aumentare la rielaborazione complessiva quando si verificano skill a esecuzione prolungata, interruzioni ripetute o errori frequenti delle skill. L'indicizzatore privilegia la correttezza rispetto alla minimizzazione della rielaborazione, quindi un accumulo nella cache dovuto a interruzioni ripetute incrementa i ritentativi. Questo comportamento è previsto, non un bug.
"Per eseguire il ripristino da un backlog della cache in crescita, partizionare l'origine dati in contenitori o cartelle virtuali più piccole. Quindi utilizzare indicizzatori paralleli che puntano allo stesso indice. Per annullare l'associazione della cache, impostare la cache proprietà su null nell'indicizzatore. Per indicazioni sul modello di partizionamento, vedere Indicizzare set di dati di grandi dimensioni .
Autorizzazioni
Un'identità di Azure AI Search richiede l'accesso in scrittura ad Archiviazione di Azure:
- Collaboratore ai dati del BLOB di archiviazione
- Contributore ai dati delle tabelle di archiviazione
La sintassi stringa di connessione determina se viene usata un'identità assegnata dal sistema o assegnata dall'utente. Per altre informazioni, vedere Connetti ad Archiviazione di Azure utilizzando un'identità gestita.
Impostare la proprietà della cache
Utilizzare questa procedura sia per gli indicizzatori nuovi che per gli indicizzatori esistenti.
Nella definizione dell'indicizzatore impostare cache con:
- (Obbligatorio)
storageConnectionStringimpostato su una stringa di connessione di Archiviazione di Azure. - (Facoltativo)
enableReprocessing(trueper impostazione predefinita). Impostarlo sufalseper sospendere temporaneamente l'arricchimento incrementale e tornare atruein un secondo momento.
A sinistra selezionare Indicizzatori.
Selezionare Aggiungi indicizzatore per creare un nuovo indicizzatore o aprirne uno esistente in modalità di modifica JSON.
Abilitare l'arricchimento incrementale, impostare l'account di archiviazione della cache di arricchimento e salvare l'indicizzatore.
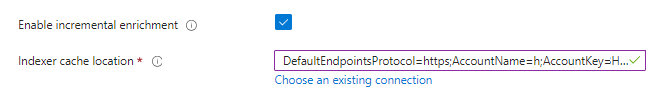
Reimpostare l'indicizzatore se esiste già.
Eseguire l'indicizzatore. Questa ricompilazione completa una tantum consente di eseguire il seeding della cache. Dopo il caricamento, il riutilizzo incrementale viene applicato alle esecuzioni successive.