Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Catatan
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
Artikel ini menjelaskan komposisi hasil pencarian dan cara membentuk hasil pencarian teks lengkap agar sesuai dengan skenario Anda. Hasil pencarian dikembalikan dalam respons kueri. Bentuk respons ditentukan oleh parameter dalam kueri itu sendiri. Parameter ini meliputi:
- Jumlah kecocokan yang ditemukan dalam indeks (
count) - Jumlah kecocokan yang dikembalikan dalam respons (50 secara default, dapat dikonfigurasi melalui
top) atau per halaman (skipdantop) - Skor pencarian untuk setiap hasil, digunakan untuk peringkat (
@search.score) - Bidang yang disertakan dalam hasil pencarian (
select) - Logika pengurutan (
orderby) - Penyorotan istilah dalam hasil, cocok dengan seluruh atau sebagian istilah dalam teks
- Elemen opsional dari ranker semantik (
answersdi bagian atas,captionsuntuk setiap pertandingan)
Hasil pencarian dapat mencakup bidang tingkat atas, tetapi sebagian besar respons terdiri dari dokumen yang cocok dalam array.
Klien dan API untuk menentukan respons kueri
Anda bisa menggunakan klien berikut untuk mengonfigurasi respons kueri:
- Search Explorer di portal Azure, menggunakan tampilan JSON sehingga Anda dapat menentukan parameter yang didukung
- Dokumen - POST (REST API)
- Metode SearchClient.Search (Azure SDK untuk .NET)
- Metode SearchClient.Search (Azure SDK untuk Python)
- Metode SearchClient.Search (Azure untuk JavaScript)
- Metode SearchClient.Search (Azure untuk Java)
Komposisi hasil
Hasil sebagian besar bersifat tabular, terdiri dari semua bidang retrievable, atau terbatas hanya pada bidang dalam parameter select yang ditentukan. Baris adalah dokumen yang cocok, biasanya diberi peringkat dalam urutan relevansi kecuali logika kueri Anda menghalangi peringkat relevansi.
Anda dapat memilih bidang mana yang ada di hasil pencarian. Meskipun dokumen pencarian mungkin memiliki sejumlah besar bidang, biasanya hanya beberapa yang diperlukan untuk mewakili setiap dokumen dalam hasil. Pada permintaan kueri, tambahkan select=<field list> untuk menentukan bidang mana yang retrievable akan muncul dalam respons.
Pilih elemen yang menawarkan kontras dan diferensiasi di antara dokumen, memberikan informasi yang memadai untuk mengundang respons clickthrough dari pengguna. Di situs e-commerce, mungkin nama produk, deskripsi, merek, warna, ukuran, harga, dan peringkat. Untuk indeks sampel hotel, mungkin bidang "pilih" dalam contoh berikut:
POST /indexes/hotels-sample/docs/search?api-version=2026-04-01
    {
      "search": "sandy beaches",
      "select": "HotelId, HotelName, Description, Rating, Address/City",
      "count": true
    }
Tips untuk Hasil Tak Terduga
Terkadang, output kueri bukan yang Anda harapkan untuk dilihat. Misalnya, Anda mungkin menemukan bahwa beberapa hasil tampaknya duplikat, atau hasil yang akan muncul di dekat bagian atas diposisikan lebih rendah dalam hasil. Saat hasil kueri tidak terduga, Anda bisa mencoba modifikasi kueri ini untuk melihat apakah hasilnya meningkat:
Ubah
searchMode=any(default) menjadisearchMode=alluntuk memerlukan kecocokan pada semua kriteria, bukan hanya salah satu kriteria. Ini terutama berlaku ketika operator boolean disertakan dalam kueri.Bereksperimenlah dengan penganalisis leksikal atau penganalisis khusus yang berbeda untuk melihat apakah itu mengubah hasil kueri. Penganalisis default memecah kata-kata yang menggunakan tanda hubung dan mengurangi kata-kata menjadi bentuk akar, yang biasanya meningkatkan keandalan tanggapan kueri. Namun, jika Anda perlu mempertahankan tanda hubung, atau jika string menyertakan karakter khusus, Anda mungkin perlu mengonfigurasi penganalisis kustom untuk memastikan indeks berisi token dalam format yang tepat. Untuk informasi lebih lanjut, lihat pencarian istilah parsial dan pola dengan karakter khusus (tanda hubung, wildcards, regex, pola).
Menghitung kecocokan
Parameter count mengembalikan jumlah dokumen dalam indeks yang dianggap cocok untuk kueri. Untuk mengembalikan jumlah, tambahkan count=true ke permintaan kueri. Tidak ada nilai maksimum yang diberlakukan oleh layanan pencarian. Bergantung pada kueri dan konten dokumen Anda, jumlahnya bisa sama tingginya dengan setiap dokumen dalam indeks.
Hitungan akurat ketika indeks stabil. Jika sistem secara aktif menambahkan, memperbarui, atau menghapus dokumen, jumlahnya adalah perkiraan, tidak termasuk dokumen apa pun yang tidak sepenuhnya diindeks.
Pemeliharaan rutin atau beban kerja lain pada layanan pencarian tidak memengaruhi jumlah. Namun, jika Anda memiliki beberapa partisi dan satu replika, Anda mungkin mengalami fluktuasi jangka pendek dalam jumlah dokumen (beberapa menit) saat partisi dimulai ulang.
Petunjuk / Saran
Untuk memeriksa operasi pengindeksan, Anda dapat mengonfirmasi apakah indeks berisi jumlah dokumen yang diharapkan dengan menambahkan count=true kueri pencarian search=* kosong. Hasilnya adalah jumlah lengkap dokumen dalam indeks Anda.
Saat menguji sintaks kueri, count=true dapat dengan cepat memberi tahu Anda apakah modifikasi Anda mengembalikan hasil yang lebih besar atau lebih sedikit, yang dapat menjadi umpan balik yang berguna.
Jumlah hasil dalam respons
Pencarian Azure AI menggunakan pagination sisi server untuk membatasi kueri agar tidak mengambil terlalu banyak dokumen sekaligus. Parameter kueri yang menentukan jumlah hasil dalam respons adalah top dan skip.
top mengacu pada jumlah hasil pencarian di halaman.
skip adalah interval dari top, dan memberi tahu mesin pencari berapa banyak hasil yang harus dilewati sebelum mendapatkan set berikutnya.
Ukuran halaman default adalah 50, sedangkan ukuran halaman maksimum adalah 1.000. Jika Anda menentukan nilai yang lebih besar dari 1.000 dan ada lebih dari 1.000 hasil yang ditemukan dalam indeks Anda, hanya 1.000 hasil pertama yang dikembalikan. Jika jumlah kecocokan melebihi ukuran halaman, respons menyertakan informasi untuk mendapatkan halaman hasil berikutnya. Contohnya:
"@odata.nextLink": "https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01"
Kecocokan teratas ditentukan oleh skor pencarian, dengan asumsi kueri adalah pencarian teks lengkap atau semantik. Jika tidak, hasil kecocokan teratas adalah dalam urutan sembarang untuk kueri pencocokan tepat (di mana @search.score=1.0 menunjukkan peringkat tanpa aturan).
Atur top untuk mengambil alih default 50. Di API pratinjau yang lebih baru, jika Anda menggunakan kueri hibrid, Anda dapat menentukan maxTextRecallSize untuk mengembalikan hingga 10.000 dokumen.
Untuk mengontrol pengurutan semua dokumen yang dikembalikan dalam set hasil, gunakan top dan skip bersama. Kueri ini mengembalikan kumpulan pertama dari 15 dokumen yang cocok ditambah jumlah total kecocokan.
POST https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01

{
    "search": "room with a view",
    "count": true,
    "top": 15,
    "skip": 0
}
Kueri ini mengembalikan set data kedua, melewati 15 hasil pertama untuk mengambil 15 hasil berikutnya (16 hingga 30):
POST https://contoso-search-eastus.search.windows.net/indexes/hotels-sample/docs/search?api-version=2026-04-01

{
    "search": "room with a view",
    "count": true,
    "top": 15,
    "skip": 15
}
Hasil kueri paginated tidak dijamin stabil jika indeks yang mendasarinya berubah. Halaman mengubah nilai skip untuk setiap halaman, tetapi setiap kueri independen dan beroperasi pada tampilan data saat ini seperti yang ada dalam indeks pada waktu kueri (dengan kata lain, tidak ada penembolokan atau rekam jepret hasil, seperti yang ditemukan dalam database tujuan umum).
Berikut ini adalah contoh bagaimana Anda mungkin mendapatkan duplikat. Asumsikan indeks dengan empat dokumen:
{ "id": "1", "rating": 5 }
{ "id": "2", "rating": 3 }
{ "id": "3", "rating": 2 }
{ "id": "4", "rating": 1 }
Sekarang asumsikan Anda ingin hasil dikembalikan dua sekaligus, diurutkan berdasarkan peringkat. Anda akan menjalankan kueri ini untuk mendapatkan halaman pertama hasil: $top=2&$skip=0&$orderby=rating desc, menghasilkan hasil berikut:
{ "id": "1", "rating": 5 }
{ "id": "2", "rating": 3 }
Pada layanan, anggaplah dokumen kelima ditambahkan ke indeks di antara panggilan kueri: { "id": "5", "rating": 4 }. Tak lama kemudian, Anda menjalankan kueri untuk mengambil halaman kedua: $top=2&$skip=2&$orderby=rating desc, dan mendapatkan hasil ini:
{ "id": "2", "rating": 3 }
{ "id": "3", "rating": 2 }
Perhatikan bahwa dokumen 2 dijemput dua kali. Ini karena dokumen baru 5 memiliki nilai peringkat yang lebih tinggi, sehingga diurutkan sebelum dokumen 2 dan dengan demikian berada di halaman pertama. Meskipun perilaku ini mungkin tidak terduga, ini merupakan ciri khas bagaimana mesin pencari berperilaku.
Menelusuri melalui sejumlah besar hasil
Teknik alternatif untuk pemanggilan halaman adalah menggunakan urutan penyortiran dan penyaring rentang sebagai solusi untuk .
Dalam solusi ini, pengurutan dan penyaringan diterapkan pada bidang ID dokumen atau bidang lain yang unik untuk setiap dokumen. Bidang unik harus memiliki filterable dan sortable atribusi dalam indeks pencarian.
Kirimkan kueri untuk mengembalikan hasil yang diurutkan dalam satu halaman penuh.
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "top": 50,
      "orderby": "id asc"
    }
Pilih hasil terakhir yang dikembalikan oleh kueri pencarian. Contoh hasil dengan hanya nilai ID yang diperlihatkan di sini.
{
    "id": "50"
}
Gunakan nilai ID tersebut dalam kueri rentang untuk mengambil halaman hasil berikutnya. Bidang ID ini harus memiliki nilai unik, jika tidak, paginasi mungkin menyertakan hasil duplikat.
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "top": 50,
      "orderby": "id asc",
      "filter": "id gt 50"
    }
Penomoran halaman berakhir saat kueri mengembalikan hasil nol.
Catatan
Atribut filterable dan sortable hanya dapat diaktifkan saat bidang pertama kali ditambahkan ke indeks, atribut tersebut tidak dapat diaktifkan pada bidang yang ada.
Hasil urutan
Dalam kueri pencarian teks lengkap, hasil dapat diberi peringkat dengan:
- skor pencarian
- skor pemeringkat ulang semantik
- pengurutan urutan pada bidang
sortable
Anda juga dapat meningkatkan kecocokan apa pun yang ditemukan di bidang tertentu dengan menambahkan profil penilaian.
Urutan berdasarkan skor pencarian
Untuk kueri pencarian teks lengkap, hasil secara otomatis diberi peringkat oleh skor pencarian menggunakan algoritma BM25, yang mempertimbangkan frekuensi istilah, panjang dokumen, dan panjang dokumen rata-rata untuk menentukan relevansi.
Rentangnya bisa tidak terbatas atau 0 hingga (tetapi tidak termasuk) 1,00 pada layanan yang lebih lama.
Untuk salah satu algoritma, nilai @search.score sama dengan 1,00 menunjukkan tataan hasil yang tidak diberi skor atau tidak diperingkat, yang mana skor 1,0 seragam di semua hasil. Hasil yang tidak ditandai terjadi ketika jenis kueri adalah pencarian fuzzy, kueri wildcard atau regex, atau pencarian kosong (search=*). Jika Anda perlu menetapkan struktur peringkat atas hasil yang orderby tidak diberi skor, pertimbangkan ekspresi untuk mencapai sasaran tersebut.
Pengurutan oleh reranker semantik
Jika Anda menggunakan ranker semantik, @search.rerankerScore menentukan urutan pengurutan hasil Anda.
Rentangnya @search.rerankerScore adalah 1 hingga 4,00, di mana skor yang lebih tinggi menunjukkan pertandingan semantik yang lebih kuat.
Pesanan dengan perintah orderby
Jika pemesanan yang konsisten adalah persyaratan aplikasi, Anda dapat menentukan orderby ekspresi pada suatu bidang. Hanya bidang yang diindeks sebagai "dapat diurutkan" yang dapat digunakan untuk mengurutkan hasil.
Bidang yang umum digunakan dalam orderby meliputi peringkat, tanggal, dan lokasi. Pemfilteran menurut lokasi mengharuskan ekspresi filter memanggil geo.distance() fungsi, selain nama bidang.
Bidang numerik (Edm.Double, Edm.Int32, ) Edm.Int64diurutkan dalam urutan numerik (misalnya, 1, 2, 10, 11, 20).
Bidang string (Edm.String, Edm.ComplexType subbidang) diurutkan dalam urutan pengurutan ASCII atau urutan pengurutan Unicode, tergantung pada bahasanya.
Konten numerik dalam bidang string diurutkan menurut abjad (1, 10, 11, 2, 20).
String yang menggunakan huruf besar diurutkan sebelum huruf kecil (APPLE, Apple, PISANG, Pisang, apel, pisang). Anda dapat menetapkan normalizer teks untuk memproses teks sebelum pengurutan guna mengubah perilaku ini. Menggunakan tokenizer huruf kecil pada bidang tidak berpengaruh pada perilaku pengurutan karena Pencarian Azure AI mengurutkan pada salinan yang tidak dianalisis dari bidang tersebut.
String yang diawali dengan diakritik muncul terakhir (Äpfel, Öffnen, Üben)
Meningkatkan relevansi menggunakan profil penilaian
Pendekatan lain yang mempromosikan konsistensi urutan adalah menggunakan profil penilaian yang disesuaikan. Profil penilaian memberi Anda kontrol lebih besar atas peringkat item dalam hasil pencarian, dengan kemampuan untuk meningkatkan kecocokan yang ditemukan di bidang tertentu. Logika penilaian tambahan dapat membantu mengatasi perbedaan kecil di antara replika karena skor pencarian untuk setiap dokumen lebih berbeda. Kami merekomendasikan algoritma peringkat untuk pendekatan ini.
Penyorotan hasil pencarian
Penyorotan hasil mengacu pada pemformatan teks (seperti sorotan tebal atau kuning) yang diterapkan pada istilah pencarian yang cocok, sehingga mudah untuk menemukan kecocokan. Penyorotan berguna untuk bidang konten yang lebih panjang, seperti bidang deskripsi, di mana kecocokan tidak segera jelas.
Perhatikan bahwa penyorotan diterapkan pada istilah individual. Tidak ada fitur sorotan untuk seluruh isi bidang. Jika Anda ingin menyoroti frasa, Anda harus memberikan istilah yang cocok (atau frasa) dalam string kueri yang diapit kutipan. Teknik ini dijelaskan lebih lanjut di bagian ini.
Petunjuk untuk menyoroti hit disediakan pada permintaan kueri. Kueri yang memicu ekspansi kueri dalam mesin, seperti pencarian fuzzy dan pencarian wildcard, memiliki dukungan terbatas untuk penyorotan hasil.
Persyaratan untuk penyorotan hasil
- Bidang harus
Edm.StringatauCollection(Edm.String) - Bidang harus dikaitkan pada
searchable
Tentukan penyorotan dalam permintaan
Untuk mengembalikan istilah yang disorot, sertakan parameter sorotan dalam permintaan kueri. Parameter diatur ke daftar bidang yang dibatasi koma.
Secara default, format markup adalah <em>, tetapi Anda dapat mengambil alih tag dengan menggunakan highlightPreTag parameter dan highlightPostTag . Kode klien Anda menangani respons (misalnya, dengan menerapkan font tebal atau latar belakang kuning).
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "divine secrets",
      "highlight": "title, original_title",
      "highlightPreTag": "<b>",
      "highlightPostTag": "</b>"
    }
Secara default, Pencarian Azure AI mengembalikan hingga lima sorotan per bidang. Anda dapat menyesuaikan angka ini dengan menambahkan tanda hubung diikuti dengan bilangan bulat. Misalnya, "highlight": "description-10" mengembalikan hingga 10 istilah yang disorot pada konten yang cocok di bidang deskripsi.
Hasil yang disorot
Saat penyorotan ditambahkan ke kueri, respons menyertakan @search.highlights untuk setiap hasil sehingga kode aplikasi Anda dapat menargetkan struktur tersebut. Daftar bidang yang ditentukan untuk "sorotan" disertakan dalam respons.
Dalam pencarian kata kunci, setiap istilah dipindai secara independen. Kueri untuk "rahasia ilahi" menghasilkan kecocokan pada dokumen yang berisi salah satu dari istilah tersebut.
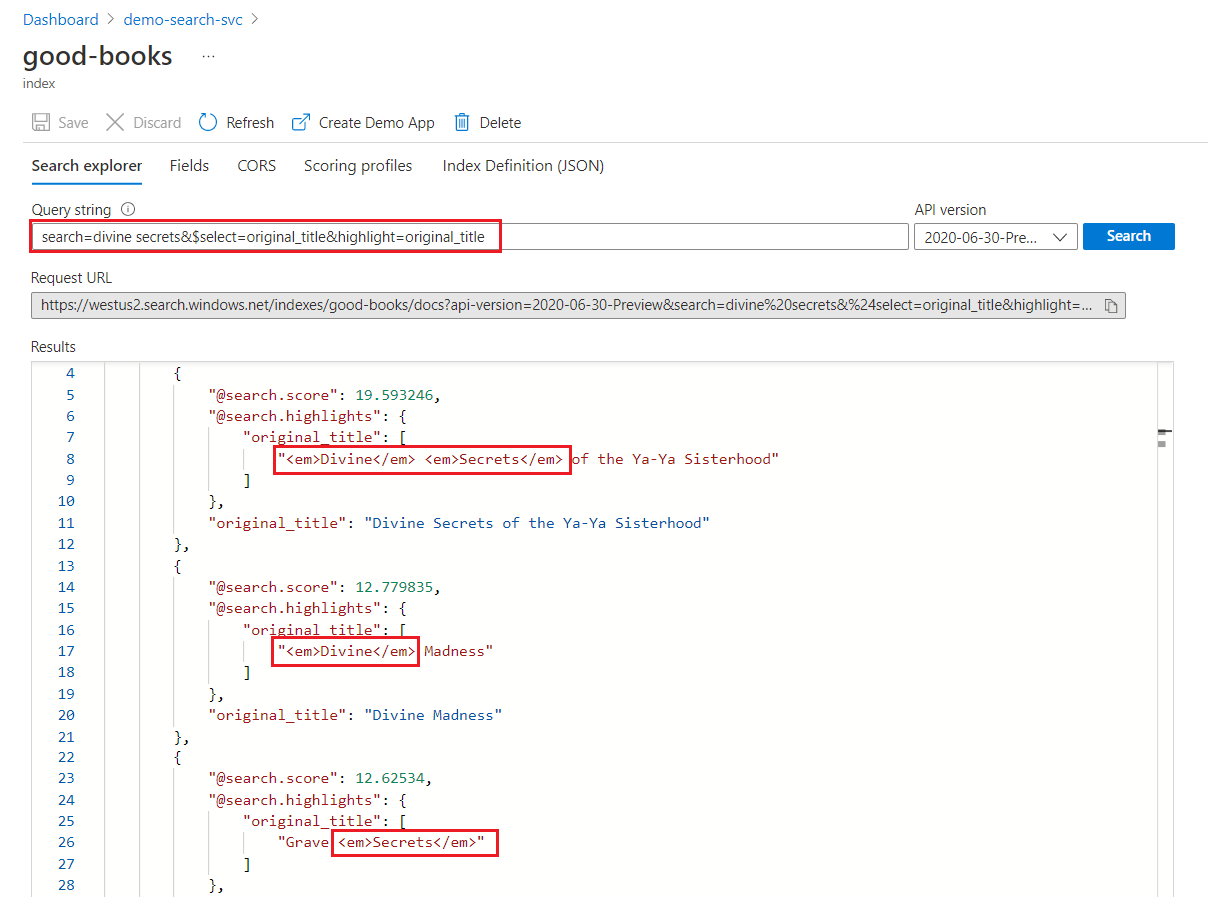
Penyorotan pencarian kata kunci
Dalam bidang yang disorot, pemformatan diterapkan ke seluruh istilah. Misalnya, pada pertandingan melawan "Rahasia Ilahi dari Ya-Ya Sisterhood", pemformatan diterapkan ke setiap istilah secara terpisah, meskipun berturut-turut.
"@odata.count": 39,
"value": [
    {
        "@search.score": 19.593246,
        "@search.highlights": {
            "original_title": [
                "<em>Divine</em> <em>Secrets</em> of the Ya-Ya Sisterhood"
            ],
            "title": [
                "<em>Divine</em> <em>Secrets</em> of the Ya-Ya Sisterhood"
            ]
        },
        "original_title": "Divine Secrets of the Ya-Ya Sisterhood",
        "title": "Divine Secrets of the Ya-Ya Sisterhood"
    },
    {
        "@search.score": 12.779835,
        "@search.highlights": {
            "original_title": [
                "<em>Divine</em> Madness"
            ],
            "title": [
                "<em>Divine</em> Madness (Cherub, #5)"
            ]
        },
        "original_title": "Divine Madness",
        "title": "Divine Madness (Cherub, #5)"
    },
    {
        "@search.score": 12.62534,
        "@search.highlights": {
            "original_title": [
                "Grave <em>Secrets</em>"
            ],
            "title": [
                "Grave <em>Secrets</em> (Temperance Brennan, #5)"
            ]
        },
        "original_title": "Grave Secrets",
        "title": "Grave Secrets (Temperance Brennan, #5)"
    }
]
Penyorotan pencarian frasa
Pemformatan seluruh istilah berlaku bahkan pada pencarian frasa, di mana beberapa istilah diapit dalam tanda kutip ganda. Contoh berikut adalah kueri yang sama, kecuali bahwa "rahasia ilahi" dikirimkan sebagai frasa yang diapit tanda kutip (beberapa klien REST mengharuskan Anda untuk melarikan tanda kutip interior dengan garis miring terbalik \"):
POST /indexes/good-books/docs/search?api-version=2026-04-01
    {
      "search": "\"divine secrets\"",
      "select": "title,original_title",
      "highlight": "title",
      "highlightPreTag": "<b>",
      "highlightPostTag": "</b>",
      "count": true
    }
Karena kriteria sekarang memiliki kedua istilah, hanya satu kecocokan yang ditemukan dalam indeks pencarian. Respons terhadap kueri sebelumnya terlihat seperti ini:
{
    "@odata.count": 1,
    "value": [
        {
            "@search.score": 19.593246,
            "@search.highlights": {
                "title": [
                    "<b>Divine</b> <b>Secrets</b> of the Ya-Ya Sisterhood"
                ]
            },
            "original_title": "Divine Secrets of the Ya-Ya Sisterhood",
            "title": "Divine Secrets of the Ya-Ya Sisterhood"
        }
    ]
}
Penyorotan frasa pada layanan lama
Layanan pencarian yang dibuat sebelum 15 Juli 2020 menerapkan pengalaman penyorotan yang berbeda untuk kueri frase.
Untuk contoh berikut, asumsikan string kueri yang menyertakan frasa dalam tanda kutip "super bowl". Sebelum Juli 2020, istilah apa pun dalam frasa disorot:
"@search.highlights": {
    "sentence": [
        "The <em>super</em> <em>bowl</em> is <em>super</em> awesome with a <em>bowl</em> of chips"
   ]
Untuk layanan pencarian yang dibuat setelah Juli 2020, hanya frasa yang cocok dengan kueri frasa lengkap yang dikembalikan di @search.highlights:
"@search.highlights": {
    "sentence": [
        "The <em>super</em> <em>bowl</em> is super awesome with a bowl of chips"
   ]
Langkah berikutnya
Untuk membuat halaman pencarian klien Anda dengan cepat, pertimbangkan opsi ini:
Buat aplikasi demo, di Portal Azure, membuat halaman HTML dengan bilah pencarian, navigasi berfaktor, dan area gambar mini jika Anda memiliki gambar.
Tambahkan pencarian ke aplikasi web adalah tutorial C# dan sampel kode yang menggunakan pustaka React JavaScript untuk pengalaman pengguna. Aplikasi ini dideploy menggunakan Azure Static Web Apps dan mengimplementasikan paginasi.