Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Catatan
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
Dalam Pencarian Azure AI, semantic ranker adalah fitur yang secara terukur meningkatkan relevansi pencarian dengan menggunakan model pemahaman bahasa Microsoft untuk mengurutkan kembali hasil pencarian. Peringkat semantik juga terintegrasi dalam pengambilan berbasis agen. Artikel ini adalah pengantar tingkat tinggi untuk membantu Anda memahami perilaku dan manfaat peringkat semantik.
Peringkat semantik adalah fitur premium yang ditagih berdasarkan penggunaan, tetapi Anda dapat menggunakannya secara gratis tunduk pada batas layanan untuk tingkat gratis. Kami merekomendasikan artikel ini untuk latar belakang, tetapi jika Anda lebih suka memulai, ikuti langkah-langkah ini.
Apa itu peringkat semantik?
Peringkat semantik adalah kumpulan kemampuan dari sisi kueri yang meningkatkan kualitas dari hasil pencarian awal yang berperingkat BM25 atau berperingkat RRF untuk kueri berbasis teks, bagian teks dari kueri vektor, dan kueri hibrid. Peringkat semantik memperluas alur eksekusi kueri dengan tiga cara:
Pertama, selalu menambahkan peringkat sekunder terhadap set hasil awal yang dinilai menggunakan BM25 atau Reciprocal Rank Fusion (RRF). Peringkat sekunder ini menggunakan model pembelajaran mendalam multibahasa yang diadaptasi dari Microsoft Bing untuk mempromosikan hasil yang paling relevan secara semantik.
Kedua, ini mengembalikan keterangan dan secara opsional mengekstrak jawaban dalam respons, yang dapat Anda render di halaman pencarian untuk meningkatkan pengalaman pencarian pengguna.
Ketiga, jika Anda mengaktifkan penulisan ulang kueri, kueri akan memperluas string kueri awal menjadi beberapa string kueri yang serupa secara semantik.
Peringkat sekunder dan "jawaban" berlaku untuk respons kueri. Penulisan ulang kueri adalah bagian dari permintaan kueri.
Peringkat semantik memiliki kemampuan berikut:
| Kemampuan | Deskripsi |
|---|---|
| Peringkat L2 | Menggunakan konteks atau arti semantik dari kueri untuk menghitung skor relevansi baru terhadap hasil yang telah terperingkat sebelumnya. |
| Keterangan dan sorotan semantik | Mengekstrak kalimat dan frasa verbatim dari area yang paling baik meringkas konten, dengan sorotan pada bagian kunci untuk memudahkan pemindaian. Keterangan yang meringkas hasil berguna saat bidang konten individual terlalu padat untuk halaman hasil pencarian. Teks yang disorot meningkatkan istilah dan frasa yang paling relevan sehingga pengguna dapat dengan cepat menentukan mengapa kecocokan dianggap relevan. |
| Jawaban semantik | Substruktur tambahan opsional yang dikembalikan dari kueri semantik. Ini memberikan jawaban langsung untuk kueri yang terlihat seperti pertanyaan. Ini mengharuskan dokumen memiliki teks dengan karakteristik jawaban. |
| Penulisan ulang kueri (pratinjau) | Menggunakan kueri teks atau bagian teks kueri vektor, ranker semantik membuat hingga 10 varian kueri, mungkin mengoreksi kesalahan ketik atau kesalahan ejaan, atau mengulangi kueri menggunakan sinonim yang dihasilkan. Kueri yang ditulis ulang berjalan pada mesin pencari. Hasilnya dinilai menggunakan penilaian BM25 atau RRF, dan kemudian diberi skor ulang oleh pengurut semantik. |
Cara kerja pemeringkat semantik
Peringkat semantik memproses kueri dan hasil, lalu mengirimkannya ke model pemahaman bahasa yang dihosting oleh Microsoft. Sistem ini memindai untuk menemukan kesesuaian yang lebih baik.
Ilustrasi berikut menjelaskan konsepnya. Pertimbangkan istilah "modal". Ini memiliki arti yang berbeda tergantung pada apakah konteksnya adalah keuangan, hukum, geografi, atau tata bahasa. Melalui pemahaman bahasa, pemeringkat semantik mendeteksi konteks dan mempromosikan hasil yang sesuai dengan niat kueri.
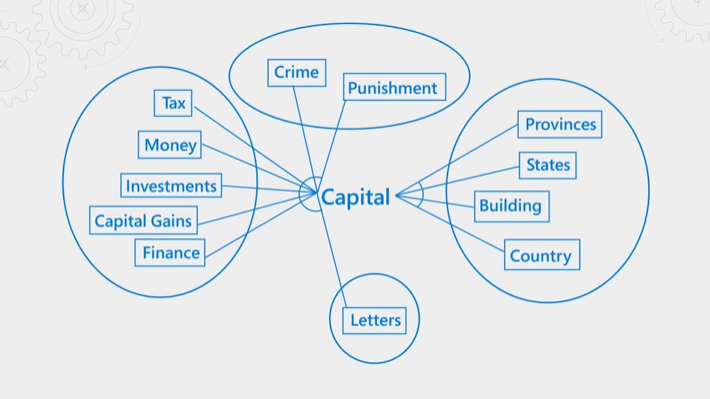
Peringkat semantik menggunakan banyak sumber daya dan waktu. Untuk menyelesaikan pemrosesan dalam latensi yang diharapkan dari operasi kueri, sistem mengonsolidasikan dan mengurangi input ke ranker semantik. Pendekatan ini membantu menyelesaikan langkah reranking secepat mungkin.
Peringkat semantik memiliki tiga langkah:
- Mengumpulkan dan meringkas input
- Menilai hasil menggunakan ranker semantik
- Output hasil yang dinilai ulang, caption, dan jawaban
Cara sistem mengumpulkan dan meringkas input
Dalam peringkat semantik, subsistem kueri meneruskan hasil pencarian sebagai input ke model ringkasan dan peringkat. Karena model peringkat memiliki batasan ukuran input dan sedang memproses intensif, hasil pencarian harus berukuran dan terstruktur (dirangkum) untuk penanganan yang efisien.
Peringkat semantik dimulai dengan hasil berperingkat BM25 dari kueri teks atau hasil berperingkat RRF dari kueri vektor atau hibrid. Latihan reranking hanya menggunakan teks. Bahkan jika hasil mencakup lebih dari 50 hasil, hanya 50 hasil teratas yang mengalami kemajuan ke peringkat semantik. Biasanya, peringkat semantik menggunakan bidang informasi dan deskriptif.
Untuk setiap dokumen dalam hasil pencarian, model ringkasan menerima hingga 2.000 token, di mana token sekitar 10 karakter. Model ini merakit input dari bidang "judul", "kata kunci", dan "konten" yang tercantum dalam konfigurasi semantik.
Sistem memangkas string yang terlalu panjang untuk memastikan panjang keseluruhan memenuhi persyaratan input langkah ringkasan. Latihan pemangkasan ini adalah mengapa penting untuk menambahkan bidang ke konfigurasi semantik Anda dalam urutan prioritas. Jika Anda memiliki dokumen yang sangat besar dengan bidang yang mengandung banyak teks, sistem akan mengabaikan semua konten setelah batas maksimum.
Bidang semantik Batas token "judul" 128 token "kata kunci" 128 token konten token yang tersisa Output ringkasan merupakan string ringkasan untuk setiap dokumen, terdiri dari informasi yang paling relevan dari bidang masing-masing. Sistem mengirimkan string ringkasan ke ranker untuk pemeringkatan, dan ke model pemahaman bacaan mesin untuk keterangan dan jawaban.
Pada November 2024, panjang maksimum setiap string ringkasan yang dihasilkan yang diteruskan ke ranker semantik adalah 2.048 token. Sebelumnya, itu adalah 256 token.
Bagaimana hasil dinilai
Sistem menilai hasil berdasarkan keterangan dan konten lain dari string ringkasan yang mengisi panjang token 2.048.
Sistem mengevaluasi keterangan untuk relevansi konseptual dan semantik, relatif terhadap kueri yang Anda berikan.
Sistem menetapkan @search.rerankerScore ke setiap dokumen berdasarkan relevansi semantik dokumen untuk kueri yang diberikan. Skor berkisar dari 4 hingga 0 (tinggi hingga rendah), di mana skor yang lebih tinggi menunjukkan relevansi yang lebih tinggi.
Skor Makna 4.0 Dokumen ini sangat relevan dan menjawab pertanyaan sepenuhnya, meskipun bagian tersebut mungkin berisi teks tambahan yang tidak terkait dengan pertanyaan. 3.0 Dokumen ini relevan tetapi tidak memiliki detail yang akan membuatnya selesai. 2.0 Dokumen agak relevan; ini menjawab pertanyaan baik sebagian atau hanya membahas beberapa aspek pertanyaan. 1.0 Dokumen terkait dengan pertanyaan, dan menjawab sebagian kecil darinya. 0.0 Dokumen tidak relevan. Sistem mencantumkan kecocokan dalam urutan menurun berdasarkan skor dan menyertakannya dalam payload respons pencarian. Payload mencakup jawaban, teks biasa, keterangan yang disorot, serta bidang apa pun yang Anda tandai sebagai dapat diambil atau ditentukan dalam klausa select.
Catatan
Untuk kueri tertentu, distribusi @search.rerankerScore dapat menunjukkan sedikit variasi karena kondisi di tingkat infrastruktur. Pembaruan model peringkat juga dapat memengaruhi distribusi. Untuk alasan ini, jika Anda menulis kode kustom untuk ambang minimum atau mengatur properti ambang batas untuk kueri vektor dan hibrid, jangan membuat batas terlalu terperinci.
Output ranker semantik
Dari setiap string ringkasan, model pemahaman pembacaan mesin menemukan bagian yang paling representatif.
Outputnya adalah:
Keterangan semantik untuk dokumen. Setiap keterangan tersedia dalam versi teks biasa dan versi sorotan, dan sering kurang dari 200 kata per dokumen.
Jawaban semantik opsional, dengan asumsi Anda menentukan
answersparameter, kueri diajukan sebagai pertanyaan, dan bagian ditemukan dalam string panjang yang memberikan kemungkinan jawaban atas pertanyaan.
Keterangan dan jawaban selalu merupakan teks asli dari indeks Anda. Tidak ada model AI generatif dalam alur kerja ini yang membuat atau menyusun konten baru.
Kemampuan dan batasan semantik
Apa yang dapat dilakukan ranker semantik:
Promosikan kecocokan yang lebih dekat secara semantik dengan tujuan dari kueri asli.
Temukan string untuk digunakan sebagai keterangan dan jawaban. Respons mengembalikan keterangan dan jawaban, yang dapat Anda render di halaman hasil pencarian.
Apa yang tidak dapat dilakukan oleh peringkat semantik adalah menjalankan kembali kueri di seluruh korpus untuk menemukan hasil yang relevan secara semantik. Peringkat semantik mengurutkan kembali set hasil yang ada, yang terdiri dari 50 hasil teratas yang dinilai oleh algoritma peringkat default. Selain itu, ranker semantik tidak dapat membuat informasi atau string baru. Model bahasa mengekstrak keterangan dan jawaban verbatim dari konten Anda, jadi jika hasilnya tidak menyertakan teks seperti jawaban, mereka tidak akan menghasilkannya.
Meskipun peringkat semantik tidak bermanfaat dalam setiap skenario, konten tertentu dapat memperoleh manfaat secara signifikan dari kemampuannya. Model bahasa dalam pemeringkat semantik bekerja paling baik pada konten yang dapat dicari yang kaya informasi dan terstruktur sebagai prosa. Pangkalan pengetahuan, dokumentasi online, atau dokumen yang berisi konten deskriptif melihat keuntungan terbanyak dari kemampuan peringkat semantik.
Teknologi yang mendasar berasal dari Bing dan Microsoft Research, dan diintegrasikan ke dalam infrastruktur Pencarian Azure AI sebagai fitur add-on. Untuk informasi selengkapnya tentang riset dan investasi AI yang mendukung pemeringkat semantik, lihat Bagaimana AI dari Bing mendukung Pencarian Azure AI (Microsoft Research Blog).
Video berikut ini memberikan gambaran umum tentang kemampuan.
Bagaimana Perangking Semantik Menggunakan Peta Sinonim
Jika Anda mengaktifkan dukungan untuk peta sinonim yang terkait dengan bidang dalam indeks pencarian Anda, dan menyertakan bidang tersebut dalam konfigurasi ranker semantik, peringkat semantik secara otomatis menerapkan sinonim yang dikonfigurasi selama proses reranking.
Ketersediaan dan harga
Peringkat semantik tersedia di wilayah tertentu. Ini dapat digunakan sebagai fitur mandiri atau sebagai komponen bawaan dari pengambilan informasi agen. Setiap fitur dikenakan biaya secara independen.
Peringkat Semantik menawarkan Paket Gratis (default), yang memberikan jatah permintaan gratis bulanan, serta Paket Standar dengan sistem bayar sesuai pemakaian setelah jatah gratis habis digunakan. Untuk informasi selengkapnya, lihat Mengaktifkan atau menonaktifkan penagihan ranker semantik.
Biaya untuk ranker semantik akan dikenakan saat permintaan kueri mencakup queryType=semantic dan string pencarian tidak kosong (misalnya, search=pet friendly hotels in New York). Jika string pencarian Anda kosong (search=*), Anda tidak dikenakan biaya, bahkan jika queryType diatur ke semantik.
Cara memulai
(Opsional) Beralih ke paket penagihan standar untuk penggunaan di luar kuota bulanan gratis.
Siapkan kueri untuk mengembalikan keterangan dan sorotan semantik.
(Opsional) Kembalikan jawaban semantik.