Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ha van egy vektor indexe az Azure AI Keresés-ben, ez a cikk a következőket ismertetni akarja:
Ez a cikk REST-et használ az ábrához. Miután megismerte az alapszintű munkafolyamatot, folytassa a Azure SDK kódmintákkal a azure-search-vector-samples adattárban, amely vektoros lekérdezéseket tartalmazó, végpontok közötti megoldásokat biztosít.
A Azure portálon Search Explorer is használhatja.
Előfeltételek
Egy Azure AI Keresés szolgáltatás bármely régióban és bármilyen szinten.
Vektorindex. Ellenőrizze, hogy van-e
vectorSearchszakasz az indexben annak megerősítésére.Ha szeretné, adjon hozzá vektorizálót az indexhez a beépített szöveg-vektor vagy kép-vektor átalakításhoz a lekérdezések során.
Visual Studio Code REST-ügyféllel és mintaadatokkal, ha ezeket a példákat önállóan szeretné futtatni. A REST-ügyfél használatának megkezdéséhez tekintse meg a következő rövid útmutatót: Teljes szöveges keresés REST használatával.
Lekérdezési sztring bemenetének konvertálása vektorsá
Vektormező lekérdezéséhez magának a lekérdezésnek vektornak kell lennie.
A felhasználó szöveges lekérdezési sztringjének vektoros ábrázolássá alakításának egyik módszere egy beágyazási kódtár vagy API meghívása az alkalmazáskódban. Ajánlott eljárásként mindig ugyanazokat a beágyazási modelleket használja, amelyeket beágyazások létrehozásához használ a forrásdokumentumokban. A azure-search-vector-samples adattárban találhatók kódrészletek, amelyek bemutatják, hogyan lehet beágyazásokat létrehozni.
A második módszer a integrált vektorizálás használata, amely mostantól általánosan elérhető, hogy Azure AI Keresés kezelje a lekérdezésvektorizációs bemeneteket és kimeneteket.
Íme egy REST API-példa egy Azure OpenAI-beágyazási modell üzembe helyezéséhez küldött lekérdezési sztringre:
POST https://{{openai-service-name}}.openai.azure.com/openai/deployments/{{openai-deployment-name}}/embeddings?api-version={{openai-api-version}}
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "input": "what azure services support generative AI'"
}
A várt válasz 202 lesz az üzembe helyezett modell sikeres hívásához.
A embedding válasz törzsének mezője a lekérdezési sztring inputvektoros ábrázolása. Tesztelési célokra a embedding tömb értékét a vectorQueries.vector lekérdezési kérelemben másolná, a szintaxist használva, amit a következő szakaszokban látni fog.
A POST-hívásra adott tényleges válasz az üzembe helyezett modellre 1536 beágyazást tartalmaz. Az olvashatóság érdekében ez a példa csak az első néhány vektort jeleníti meg.
{
    "object": "list",
    "data": [
        {
            "object": "embedding",
            "index": 0,
            "embedding": [
                -0.009171937,
                0.018715322,
                ...
                -0.0016804502
            ]
        }
    ],
    "model": "ada",
    "usage": {
        "prompt_tokens": 7,
        "total_tokens": 7
    }
}
Ebben a megközelítésben az alkalmazáskód felelős a modellhez való csatlakozásért, a beágyazások generálásáért és a válasz kezeléséhez.
Vektoros lekérdezési kérelem
Ez a szakasz a vektoros lekérdezések alapstruktúráját mutatja be. A Azure portál, a REST API-k vagy a Azure SDK-k segítségével vektoros lekérdezéseket hozhat létre.
Ha a 2023-07-01-es előnézeti verzióról átmigrál, kompatibilitási megszakítások lépnek fel. További információ: Frissítés a legújabb REST API-ra.
A stabil verzió a következőket támogatja:
-
vectorQueriesa vektorkeresés felépítése. -
vectorQueries.kindbe van állítva vektortömbre, vagyvector, ha a bemenet egy karakterlánc, és hatext. -
vectorQueries.vectora lekérdezés (szöveg vagy kép vektoros ábrázolása). -
vectorQueries.exhaustive(nem kötelező) teljes KNN-t hív meg lekérdezéskor, még akkor is, ha a mező indexelve van a HNSW-hez. -
vectorQueries.fields(nem kötelező) meghatározott mezőket céloz meg a lekérdezések végrehajtásához (lekérdezésenként legfeljebb 10). -
vectorQueries.weight(nem kötelező) a keresési műveletekben szereplő vektoros lekérdezések relatív súlyát adja meg. További információ: Vektorok súlyozása. -
vectorQueries.ka visszaadandó egyezések száma.
A következő példában a vektor ennek a sztringnek a reprezentációja: "what Azure services support full text search". A lekérdezés a contentVector mezőt célozza meg, és eredményeket ad k vissza. A tényleges vektor 1536 beágyazással rendelkezik, amelyeket ebben a példában az olvashatóság érdekében vágunk le.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector",
            "weight": 0.5,
            "k": 5
        }
    ]
}
Vektoros lekérdezési válasz
A Azure AI Keresés a lekérdezési válaszok alapértelmezés szerint az összes retrievable mezőből állnak. Azonban gyakran korlátozzák a keresési eredményeket a mezők részhalmazára retrievable, ha egy select utasításban felsorolják őket.
A vektoros lekérdezésekben gondosan gondolja át, hogy a válaszban vektormezőkre van-e szükség. A vektormezők nem ember által olvashatóak, ezért ha választ küld egy weblapra, akkor az eredményt reprezentáló nem vektor mezőket kell választania. Ha például a lekérdezés a contentVector ellen fut, akkor visszaadhatja a content-t.
Ha vektormezőket szeretne az eredményben, íme egy példa a válaszstruktúrára.
contentVector a beágyazások sztringtömbje, amelyet ebben a példában az olvashatóság érdekében vágunk le. A keresési pontszám relevanciát jelez. A kontextus érdekében más nem vektoriális mezők is szerepelnek.
{
    "@odata.count": 3,
    "value": [
        {
            "@search.score": 0.80025613,
            "title": "Azure Search",
            "category": "AI + Machine Learning",
            "contentVector": [
                -0.0018343845,
                0.017952163,
                0.0025753193,
                ...
            ]
        },
        {
            "@search.score": 0.78856903,
            "title": "Azure Application Insights",
            "category": "Management + Governance",
            "contentVector": [
                -0.016821077,
                0.0037742127,
                0.016136652,
                ...
            ]
        },
        {
            "@search.score": 0.78650564,
            "title": "Azure Media Services",
            "category": "Media",
            "contentVector": [
                -0.025449317,
                0.0038463024,
                -0.02488436,
                ...
            ]
        }
    ]
}
Főbb pontok:
kmeghatározza, hogy hány legközelebbi szomszéd eredményt ad vissza, ebben az esetben három. A vektoros lekérdezések mindig eredményeket adnak visszak, feltéve, hogy legalábbka dokumentumok léteznek, még akkor is, ha egyes dokumentumokban gyenge a hasonlóság. Ennek az az oka, hogy az algoritmus megkeresika lekérdezésvektor legközelebbi szomszédjait.A vektorkeresési algoritmus határozza meg a
@search.score.A keresési eredmények mezői vagy mind
retrievablemezők, vagy egyselectzáradék mezői. A vektoros lekérdezés végrehajtása során az egyeztetés csak vektoradatokon történik. A válaszok azonban az index bármelyretrievablemezőjét tartalmazhatják. Mivel a vektormezők eredményének dekódolására nincs lehetőség, a nemvektoros szövegmezők felvétele hasznos lehet érthető értékekkel.
Több vektormező
A tulajdonságot több vektormezőre is beállíthatja vectorQueries.fields . A vektoros lekérdezés a listában megadott fields összes vektormezőn fut. Legfeljebb 10 mezőt adhat meg.
Több vektormező lekérdezésekor győződjön meg arról, hogy mindegyik beágyazást tartalmaz ugyanabból a beágyazási modellből. A lekérdezést ugyanabból a beágyazási modellből is létre kell hozni.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-04-01
Content-Type: application/json
api-key: {{admin-api-key}}
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "exhaustive": true,
            "fields": "contentVector, titleVector",
            "k": 5
        }
    ]
}
Több vektoros lekérdezés
A több lekérdezéses vektoros keresés több lekérdezést küld a keresési index több vektormezőjében. Ezt a lekérdezéstípust gyakran használják olyan modelleknél, mint a CLIP a többmodális kereséshez, ahol ugyanaz a modell képes vektorizálni a szöveget és a képeket is.
Az alábbi lekérdezési példa mindkettőben myImageVector hasonlóságot keres, és myTextVector két megfelelő lekérdezési beágyazást küld, mindegyik párhuzamosan fut. Ennek a lekérdezésnek az eredménye a kölcsönös rangsor összevonásának (RRF) használatával kerül értékelésre.
-
vectorQueriesvektoros lekérdezések tömbje. -
vectorA keresési index képvektorait és szövegvektorait tartalmazza. Minden példány külön lekérdezés. -
fieldsmegadja, hogy melyik vektormezőt célozza meg. -
kaz eredményekbe belefoglalandó legközelebbi szomszéd egyezések száma.
{
    "count": true,
    "select": "title, content, category",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . .
                -0.02178128,
                -0.00086512347
            ],
            "fields": "myimagevector",
            "k": 5
        },
        {
            "kind": "vector"
            "vector": [
                -0.002222222,
                0.018708462,
                -0.013770515,
            . . .
            ],
            "fields": "mytextvector",
            "k": 5
        }
    ]
}
A keresési indexek nem tudnak képeket tárolni. Feltételezve, hogy az index tartalmaz egy mezőt a képfájlhoz, a keresési eredmények szöveg és képek kombinációját tartalmazzák.
Lekérdezés integrált vektorizálással
Ez a szakasz egy vektoros lekérdezést mutat be, amely meghívja az integrált vektorizációt , hogy egy szöveg- vagy kép lekérdezést vektorsá alakítson. A szolgáltatáshoz a stabil 2026-04-01 REST API, Search Explorer vagy újabb Azure SDK csomagokat javasoljuk.
Az előfeltétel egy olyan keresési index, amely egy vektormezőhöz konfigurált és hozzárendelt vektorizálóval rendelkezik. A vektorizáló kapcsolati adatokat biztosít a lekérdezési időpontban használt beágyazási modellhez.
A Search Explorer támogatja az integrált vektorizálást a lekérdezési időpontban. Ha az index vektormezőket tartalmaz, és vektorizálóval rendelkezik, használhatja a beépített szöveg-vektor konverziót.
Nyissa meg a keresőszolgáltatást a Azure portálon.
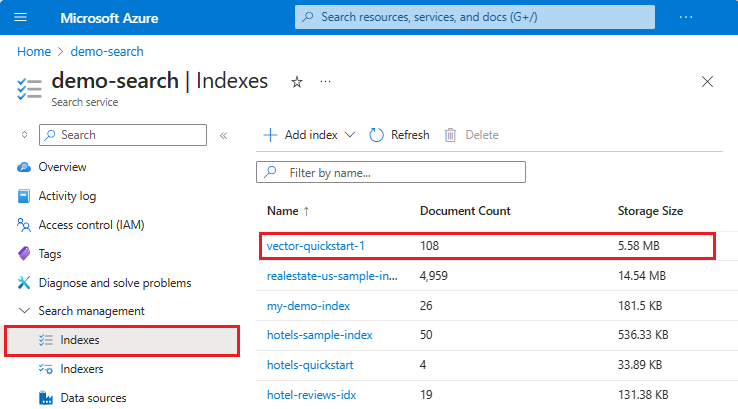
A bal oldali menüben válassza a Kereséskezelési>indexek lehetőséget, majd válassza ki az indexet.
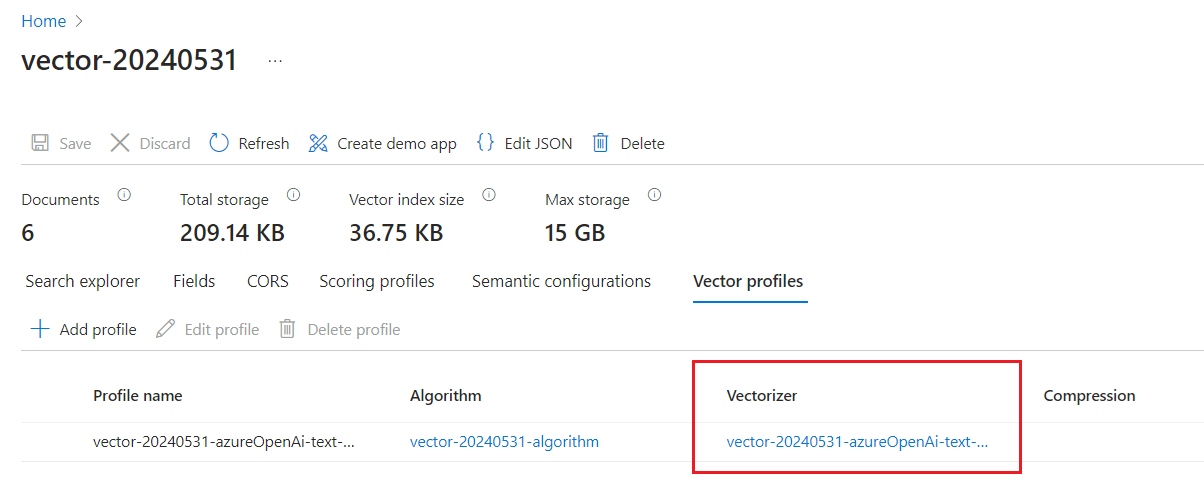
A Vektorprofilok lapon ellenőrizze, hogy rendelkezik-e vektorizálóval.
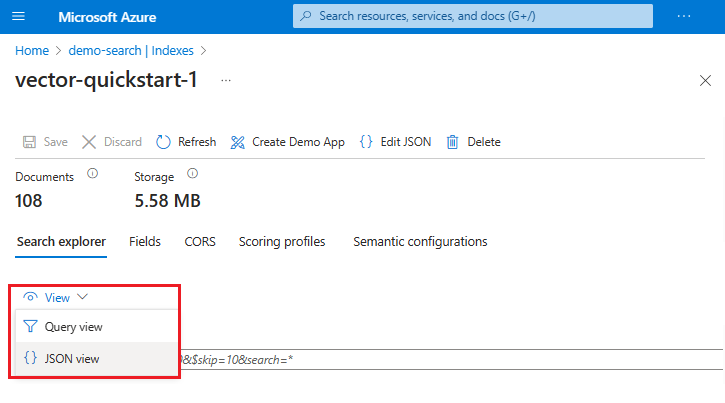
Válassza a Kereséskezelő lapot. Az alapértelmezett lekérdezési nézet használatával beírhat egy szöveges sztringet a keresősávba. A beépített vektorizáló vektorsá alakítja a sztringet, végrehajtja a keresést, és visszaadja az eredményeket.
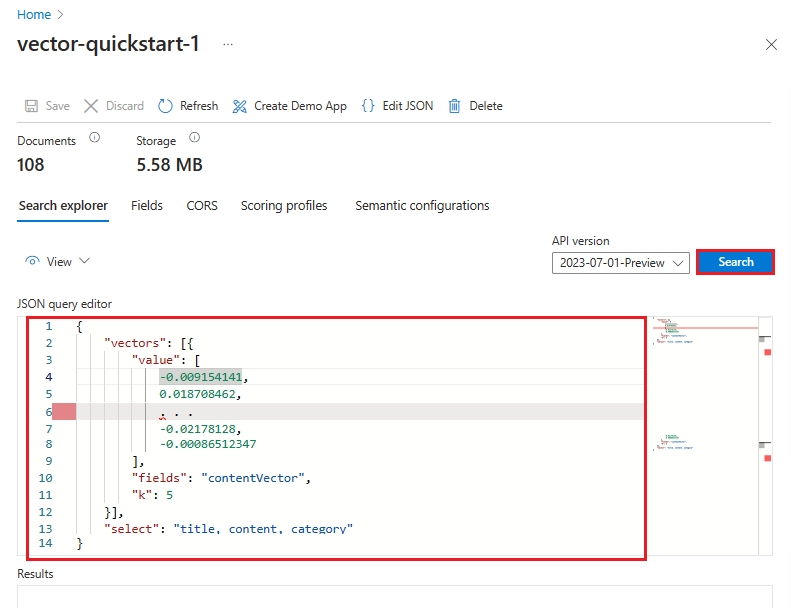
A lekérdezés megtekintéséhez vagy módosításához aJSON> lehetőséget is választhatja. Ha vektorok vannak jelen, a Keresőböngésző automatikusan beállít egy vektoros lekérdezést. A JSON-nézetben kiválaszthatja a keresésben és a válaszban használható mezőket, szűrőket adhat hozzá, és összetettebb lekérdezéseket hozhat létre, például hibrid lekérdezéseket. Egy JSON-példa megtekintéséhez válassza a szakaszban található REST API fület.
A rangsorolt eredmények száma vektoros lekérdezési válaszban
A vektoros lekérdezés megadja a k paramétert, amely meghatározza, hogy hány találatot ad vissza az eredmény. A keresőmotor mindig a találatok k számát adja vissza. Ha k nagyobb, mint az indexben lévő dokumentumok száma, a dokumentumok száma határozza meg a visszaadható dokumentumok felső korlátját.
Ha ismeri a teljes szöveges keresést, akkor tudja, hogy nulla találatot várhat, ha az index nem tartalmaz egy kifejezést vagy mondatot. A vektoros keresésben azonban a keresési művelet azonosítja a legközelebbi szomszédokat, és mindig visszaadja k az eredményeket, még akkor is, ha a legközelebbi szomszédok nem hasonlóak. Nem etikátlan vagy nem témakörön kívüli lekérdezések eredményei is lekérhetők, különösen akkor, ha nem használ utasításokat a határok megadásához. A kevésbé releváns eredmények rosszabb hasonlósági pontszámmal rendelkeznek, de még mindig ezek a "legközelebbi" vektorok, ha nincs közelebb semmi. Ezért egy jelentéssel nem bíró válasz továbbra is visszaadhat k eredményeket, de az egyes eredmények hasonlósági pontszáma alacsony lesz.
A teljes szöveges keresést magában foglaló hibrid megközelítés enyhítheti ezt a problémát. Egy másik megoldás egy minimális küszöbérték beállítása a keresési pontszámon, de csak akkor, ha a lekérdezés egy tiszta egyvektoros lekérdezés. A hibrid lekérdezések nem eredményeznek minimális küszöbértékeket, mert az RRF-tartományok sokkal kisebbek és változékonyabbak.
Az eredményszámot befolyásoló lekérdezési paraméterek a következők:
-
"k": ncsak vektoros lekérdezések eredményei. -
"top": nparamétereket tartalmazósearchhibrid lekérdezések eredményei.
Mindkettő k , és top nem kötelező. Ha nincs meghatározva, a válaszban szereplő eredmények alapértelmezett száma 50. Beállíthatja a top és skip értékét az eredmények átlapozásához, vagy módosíthatja az alapértelmezett értéket.
Vektoros lekérdezésekben használt rangsorolási algoritmusok
Az eredmények rangsorolását a következők alapján számítjuk ki:
- A hasonlóság metrika.
- RRF, ha több keresési találat van.
Hasonlóság metrika
A csak vektoros lekérdezés indexszakaszában vectorSearch megadott hasonlósági metrika. Az érvényes értékek a következők cosine: , euclideanés dotProduct.
Azure OpenAI beágyazási modellek koszinuszas hasonlóságot használnak, ezért Azure OpenAI-beágyazási modellek használata esetén a cosine ajánlott metrikát használni. Egyéb támogatott rangsorolási metrikák a következők: euclidean és dotProduct.
RRF
Több csoport akkor jön létre, ha a lekérdezés több vektormezőt céloz meg, több vektoros lekérdezést futtat párhuzamosan, vagy vektoros és teljes szöveges keresés hibridje, szemantikai rangsorolással vagy anélkül.
A lekérdezés végrehajtása során a vektoros lekérdezések csak egy belső vektorindexet célozhatnak meg. Több vektormező és több vektoros lekérdezés esetén a keresőmotor több lekérdezést hoz létre, amelyek az egyes mezők megfelelő vektorindexeit célják. A kimenet az egyes lekérdezések rangsorolt eredményeinek halmaza, amelyek az RRF használatával vannak egyesítve. További információ: Relevanciapontozás a Kölcsönös rangsor fúzióval.
Vektorok súlyozása
Adjon hozzá egy lekérdezési paramétert weight a keresési műveletekben szereplő vektoros lekérdezések relatív súlyának megadásához. Ez az érték két vagy több vektoros lekérdezés által ugyanabban a kérelemben vagy egy hibrid lekérdezés vektorrészéből előállított több rangsorlista eredményeinek kombinálásakor használatos.
Az alapértelmezett érték 1,0, az értéknek nullánál nagyobb pozitív számnak kell lennie.
Az egyes dokumentumok RRF-pontszámainak kiszámításakor súlyokat használunk. A számítás a dokumentum rangpontszámához weight viszonyított érték szorzója a megfelelő eredményhalmazon belül.
Az alábbi példa egy hibrid lekérdezés két vektoros lekérdezési sztringgel és egy szöveges sztringgel. A vektoros lekérdezésekhez súlyok vannak rendelve. Az első lekérdezés súlya 0,5, azaz a teljes súly fele, ami csökkenti a fontosságát a kérésen belül. A második vektoros lekérdezés kétszer olyan fontos.
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-04-01

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my_first_vector_field",
          "k": 10,
          "weight": 0.5
        },
        {
          "kind": "vector",
          "vector": [4.0, 5.0, 6.0],
          "fields": "my_second_vector_field",
          "k": 10,
          "weight": 2.0
        }
      ],
      "search": "hello world"
    }
A vektorok súlyozása csak vektorokra vonatkozik. A példában a "hello world" helyén szereplő szöveges lekérdezés implicit semleges súlya 1,0. Hibrid lekérdezésekben azonban a maxTextRecallSize beállításával növelheti vagy csökkentheti a szövegmezők fontosságát.
Küszöbértékek beállítása az alacsony pontszámú eredmények kizárásához (előzetes verzió)
Mivel a legközelebbi szomszédkeresés mindig a kért k szomszédokat adja vissza, több alacsony pontszámú találat is lekérhető a k keresési eredmények számkövetelményének teljesítése részeként. Az alacsony pontszámú keresési eredmények kizárásához hozzáadhat egy lekérdezési paramétert threshold , amely minimális pontszám alapján szűri az eredményeket. A szűrés a különböző visszahívási csoportok eredményeinek összeolvadása előtt történik.
Ez a paraméter előzetes verzióban érhető el. A Dokumentumok – Keresési bejegyzés (REST API) legújabb előzetes verzióját javasoljuk.
Ebben a példában a 0,8 alatti pontszámot tartalmazó összes találat ki lesz zárva a vektorkeresési eredményekből, még akkor is, ha a találatok száma alá kesik.
POST https://[service-name].search.windows.net/indexes/[index-name]/docs/search?api-version=2026-08-01-preview
    Content-Type: application/json
    api-key: [admin key]

    {
      "vectorQueries": [
        {
          "kind": "vector",
          "vector": [1.0, 2.0, 3.0],
          "fields": "my-cosine-field",
          "threshold": {
            "kind": "vectorSimilarity",
            "value": 0.8
          }
        }
      ]
    }
Következő lépések
Következő lépésként tekintse át Python, C# vagy JavaScript vektoros lekérdezéskód példáit.