Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Recherche Azure AI est un service entièrement géré hébergé dans le cloud qui connecte vos données à l’IA. Le service unifie l’accès au contenu d’entreprise et web afin que les agents et les modèles de langage volumineux (LLMs) puissent utiliser le contexte, l’historique des conversations et les signaux multi source pour produire des réponses fiables et ancrées.
Les cas d’usage courants incluent la recherche classique et la génération augmentée par récupération (RAG) à l’aide d’une récupération agentique, où le service orchestre la planification des requêtes, la récupération et la construction de la réponse. Ces fonctionnalités prennent en charge les scénarios allant de l’expérience de recherche traditionnelle aux agents et applications de conversation basés sur l’IA adaptés aux scénarios d’entreprise et de consommateur.
Lorsque vous créez un service de recherche, les fonctionnalités suivantes sont incluses :
- Deux moteurs : recherche classique pour les requêtes uniques et récupération agentique pour la recherche parallèle, itérative et assistée par LLM.
- Texte intégral, vecteur, hybride et requêtes modales sur le contenu local (indexé) et le contenu distant.
- L’enrichissement par IA pour segmenter, vectoriser et rendre le contenu brut pouvant faire l’objet d’une recherche.
- Réglage de pertinence pour améliorer la correspondance des intentions et la qualité des résultats.
- mise à l'échelle Azure, sécurité, surveillance et conformité.
- Intégrations Azure aux plateformes de données prises en charge, à Azure OpenAI et à Microsoft Foundry.
Pourquoi utiliser Recherche Azure AI ?
Agents de terrain et chatbots dans des données propriétaires, d’entreprise ou web pour obtenir des réponses précises et contextuelles.
Accédez aux données à partir de Stockage Blob Azure, de Azure Cosmos DB, de Microsoft SharePoint, de Microsoft OneLake et d’autres sources de données prises en charge. Choisissez l’accès indexé ou distant en fonction de vos besoins en matière de fraîcheur, de latence et de conformité.
Enrichissez et structurez le contenu au moment de l'indexation ou du temps de requête avec des fonctionnalités qui effectuent le découpage, l'intégration et des transformations assistées par des modèles linguistiques de grande taille (LLM).
Combinez la recherche en texte intégral avec la recherche vectorielle (recherche hybride) pour équilibrer la précision et le rappel.
Interroger le contenu contenant à la fois du texte et des images dans un seul pipeline multimodal.
Implémentez facilement des fonctionnalités liées à la recherche : réglage de la pertinence, navigation à facettes, filtres (y compris la recherche géospatique), mappage de synonymes et saisie semi-automatique.
Fournissez la sécurité d’entreprise, le contrôle d’accès et la conformité via Microsoft Entra ID, Azure Private Link, le contrôle d’accès au niveau du document et l’accès en fonction du rôle.
Évoluez et opérez en production avec la fiabilité, la surveillance et les diagnostics (journaux d’activité, mesures et alertes) d’Azure, ainsi que les outils REST API ou SDK pour l’automatisation.
Pour plus d’informations sur les fonctionnalités spécifiques, consultez Features de Recherche Azure AI.
Qu’est-ce que la recherche classique ?
La recherche classique est un modèle de récupération basé sur l'index pour les requêtes prévisibles et à faible latence. Chaque requête cible un seul index de recherche prédéfini et retourne des documents classés dans un cycle de requête-réponse. Aucune planification, itération ou synthèse assistée par LLM ne se produit pendant la récupération.
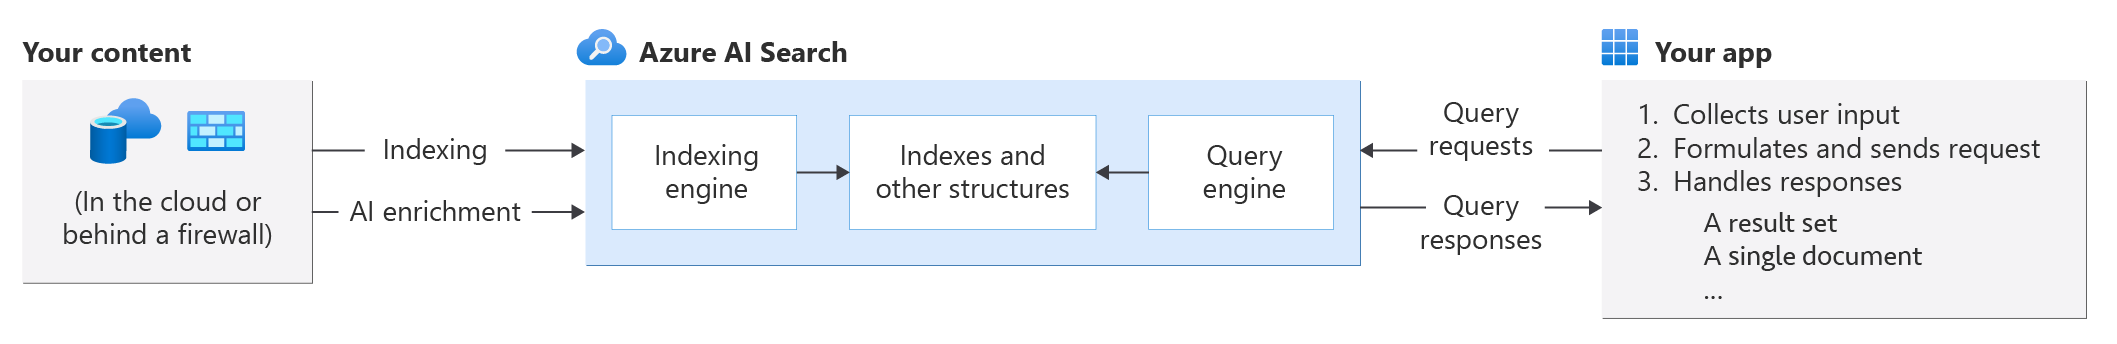
Dans cette architecture, votre service de recherche se trouve entre les magasins de données qui contiennent votre contenu non traité et votre application cliente. L’application est chargée d’envoyer des requêtes à votre service de recherche et de gérer la réponse.
Cette architecture comporte deux charges de travail principales :
L’indexation charge le contenu dans un index et le rend accessible à la recherche. En interne, le texte entrant est tokenisé et stocké dans des index inversés, tandis que les vecteurs entrants sont stockés dans des index vectoriels. Recherche Azure AI ne peut indexer que des documents JSON. Vous pouvez utiliser la méthode Push pour charger des documents JSON directement ou la méthode pull (indexeur ou workflow d’application logique) pour récupérer et sérialiser des données dans JSON.
Pendant l’indexation, vous pouvez utiliser l’enrichissement par IA pour segmenter du texte, générer des vecteurs et appliquer d’autres transformations qui créent une structure et du contenu. Recherche Azure AI sérialise ensuite la sortie enrichie dans des documents JSON et les ingère dans l’index.
Note
Ce diagramme sépare les moteurs d'indexation et de requête pour plus de clarté, mais dans Recherche Azure AI, ils sont le même composant fonctionnant en lecture-écriture et en lecture seule.
Qu’est-ce que la récupération agentique ?
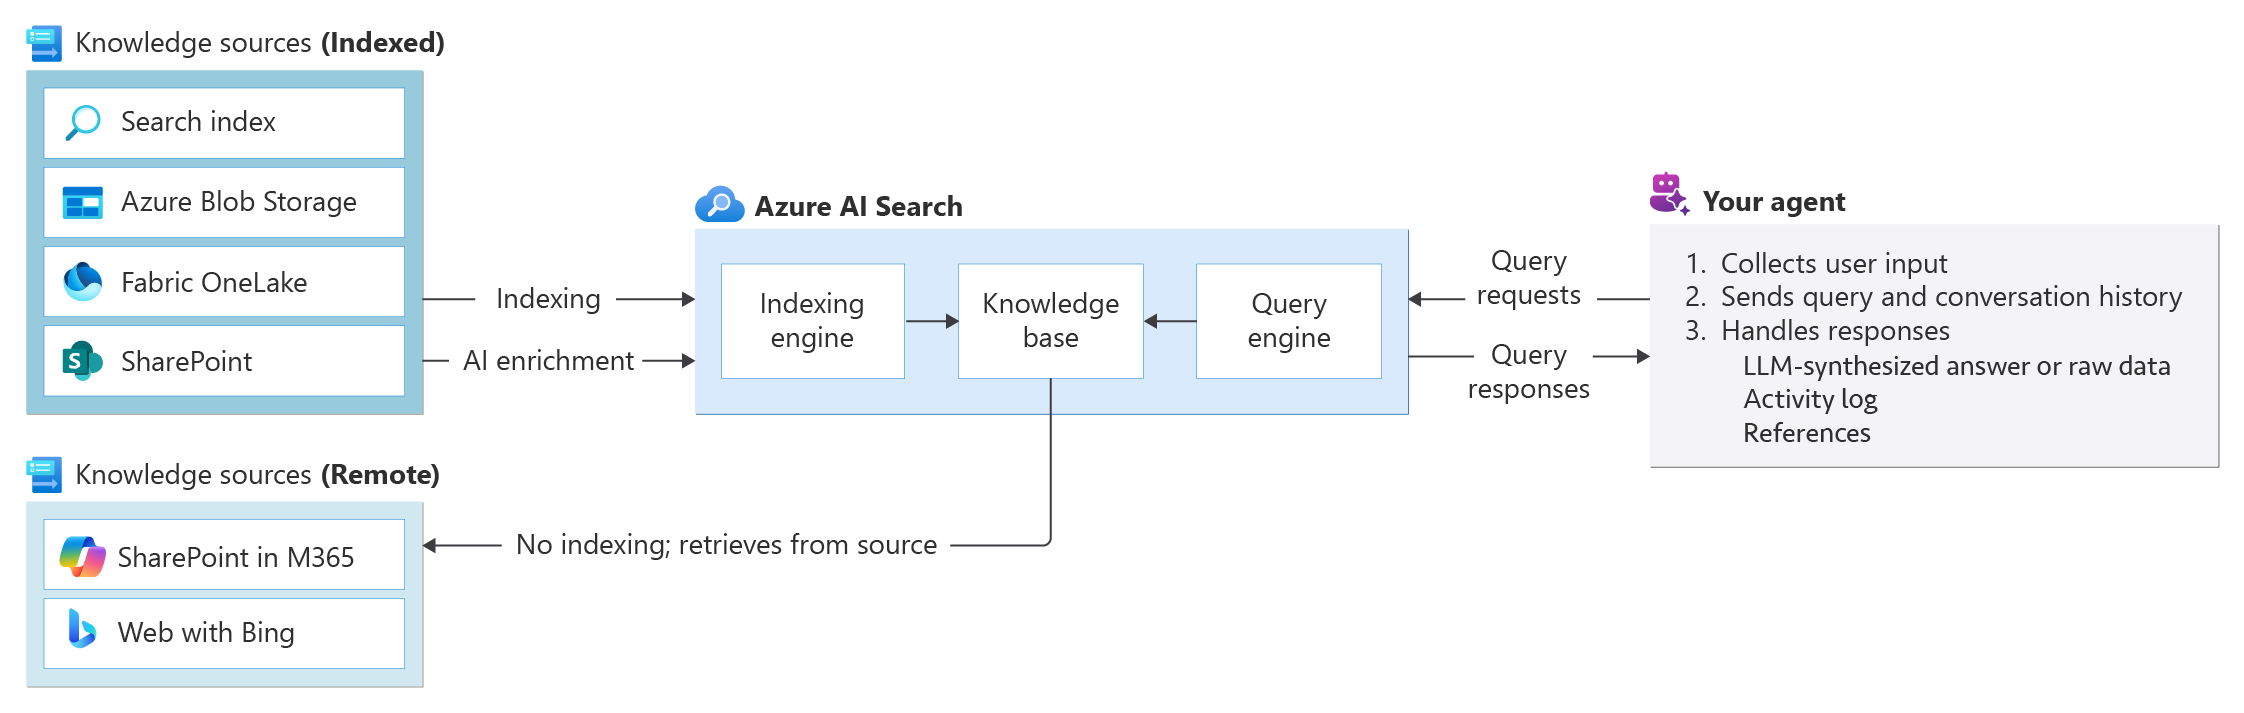
La récupération agentique est un pipeline à multi-requêtes conçu pour des flux de travail complexes d'agent à agent. Chaque requête cible une base de connaissances qui représente un domaine complet de connaissances. Votre agent fait référence à la base de connaissances pour sur quoi se baser, tandis que la base de connaissances gère comment effectuer l’ancrage.
Une base de connaissances se compose d’une ou plusieurs sources de connaissances, d’un LLM facultatif pour la planification des requêtes et la synthèse des réponses, et de paramètres qui régissent le comportement de récupération. Chaque requête subit une planification, une décomposition en sous-requêtes prioritaires, une récupération parallèle à partir de sources de connaissances, une reclassement sémantique et la fusion des résultats. La réponse en trois volets est optimisée pour la consommation d’agents.
Sous le capot, la récupération agentique s’appuie sur l’architecture de recherche classique en ajoutant une couche de contexte (base de connaissances) qui orchestre la récupération multi source. Les sources de connaissances peuvent être indexées ou distantes : les sources indexées utilisent les mêmes moteurs d’indexation et de requête que la recherche classique, tandis que les sources distantes contournent l’indexation et sont interrogées en direct.
Comment ils se comparent
La recherche classique et la récupération agentique sont des modes complémentaires de récupération d’informations. Les deux prennent en charge la recherche en texte intégral, vectorielle, hybride et modale . Toutefois, ils diffèrent de la façon dont le contenu est ingéré et interrogé. Le tableau suivant récapitule leurs principales différences.
| Aspect | Recherche classique | Récupération agentique |
|---|---|---|
| Corpus de recherche | Index de recherche | Source de connaissances |
| Cible de recherche | Un index défini par un schéma | Une base de connaissances pointant vers une ou plusieurs sources de connaissances |
| Plan de requête | Pas de plan, juste une demande | Plan assisté par un LLM ou fourni par l’utilisateur |
| Requête de consultation | Rechercher des documents dans un index | Récupérer à partir de sources de connaissances |
| Réponse | Résultats de recherche aplatis basés sur le schéma | Réponses formulées par LLM ou données sources brutes, journal d’activité, références |
| Restrictions de région | Non | Oui |
| Statut | Disponibilité généralisée | Disponible en général, avec certaines fonctionnalités en version préliminaire. |
| Prise en charge du modèle de tarification dédié | Oui | Oui |
| Prise en charge du modèle de tarification sans serveur (version préliminaire) | Oui | Oui |
Comment commencer
Vous pouvez accéder à Recherche Azure AI via le portail Azure, REST API, et SDK Azure pour .NET, Java, JavaScript et Python.
Le portail est utile pour l’administration des services et la gestion du contenu, avec des outils permettant de prototyper vos bases de connaissances, sources de connaissances, indexeurs, indexeurs, ensembles de compétences et sources de données. Les API REST et les kits SDK sont utiles pour l’automatisation de la production.
Choisir votre chemin
Avant de commencer, utilisez cette liste de contrôle pour prendre des décisions clés :
Choisissez un modèle de tarification : sélectionnez le modèle tarifaire Dédié ou Serverless (préversion). Consultez Choisir un modèle tarifaire et un niveau de service pour obtenir de l’aide sur le choix du modèle adapté à vos besoins.
Choisissez la façon dont vous souhaitez récupérer des données : Vous pouvez interroger directement à partir d’un index de recherche pour obtenir des résultats prévisibles et à faible latence ou utiliser la récupération agentique pour interroger plusieurs index via une base de connaissances. Si vous créez une application traditionnelle sans agent ou chatbot, les requêtes d’index directes peuvent répondre à la plupart des besoins avec un coût et une complexité moindres. Si vous souhaitez travailler sur plusieurs sources de connaissances ou prendre en charge des scénarios plus avancés, envisagez la récupération agentique avec un effort de raisonnement minimal (préversion).
Choisissez une région : Si vous utilisez la récupération agentique, choisissez une région prise en charge. Pour la recherche classique, choisissez une région qui offre les fonctionnalités et la capacité dont vous avez besoin.
Choisissez une méthode d’ingestion pour le contenu lié à l’index : Si votre contenu se trouve dans une source de données prise en charge, utilisez la méthode d’extraction pour récupérer et sérialiser des données dans JSON. Si vous n’avez pas de source de données prise en charge ou si votre contenu et votre index doivent être synchronisés en temps réel, la méthode Push est votre seule option.
Avez-vous besoin de vecteurs ? Les LLMs et les Agents ne nécessitent pas de vecteurs. Utilisez-les uniquement si vous avez besoin d’une recherche de similarité ou si vous avez du contenu qui peut être homogénéisé en vecteurs. Recherche Azure AI offre vectorisation intégrée pour cette tâche.
Avez-vous besoin d’un héritage des permissions basé sur l’utilisateur ? Le SharePoint distant est conçu pour ce scénario, mais vous pouvez également hériter des autorisations utilisateur attachées au contenu dans Stockage Blob Azure ou ADLS Gen2. Pour tous les autres scénarios, vous pouvez utiliser la solution de contournement du filtre de sécurité .
Choisir vos ressources d’apprentissage
Ces guides de démarrage rapide et ces exemples sont disponibles pour vous aider à commencer.
- Démarrage rapide : Récupération agentique (portail ou programme)
- Démarrage rapide : Recherche en texte intégral (portail ou programmatique)
- Démarrage rapide : Recherche vectorielle (portail ou programmatique)
Conseil
Pour obtenir de l’aide sur des solutions complexes ou personnalisées, contacter un partenaire avec une expertise approfondie dans Recherche Azure AI.