Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
La recherche en texte intégral est une approche de la récupération des informations qui correspond au texte brut stocké dans un index. Par exemple, étant donné une chaîne de requête « hôtels à San Diego à la plage », le moteur de recherche recherche des chaînes de caractères tokenisées en fonction de ces termes. Pour rendre les analyses plus efficaces, les chaînes de requête subissent une analyse lexicale : mettre tous les termes en minuscules, supprimer les mots vides comme « le/la/de/du/ce » et réduire les termes aux formes racines. Lorsque des termes correspondants sont trouvés, le moteur de recherche récupère les documents, les classe dans l’ordre de pertinence et retourne les premiers résultats.
L’exécution des requêtes peut être complexe. Cet article est destiné aux développeurs qui ont besoin d’une compréhension plus approfondie du fonctionnement de la recherche en texte intégral dans Recherche Azure AI. Pour les requêtes de texte, Recherche Azure AI fournit en toute transparence des résultats attendus dans la plupart des scénarios, mais parfois, vous pouvez obtenir un résultat qui semble « anormal » d’une certaine façon. Dans ces situations, avoir un arrière-plan dans les quatre étapes de l’exécution de requête Lucene (analyse des requêtes, analyse lexicale, correspondance de document et scoring) peut vous aider à identifier des modifications spécifiques apportées aux paramètres de requête ou à la configuration d’index qui produisent le résultat souhaité.
Note
Recherche Azure AI utilise Apache Lucene pour la recherche en texte intégral, mais l'intégration de Lucene n'est pas exhaustive. Nous exposons et étendons de manière sélective les fonctionnalités de Lucene pour les scénarios importants d'Recherche Azure AI.
Vue d’ensemble de l’architecture et diagramme
L’exécution des requêtes comporte quatre étapes :
- Analyse des requêtes
- Analyse lexicale
- Récupération de documents
- Évaluation
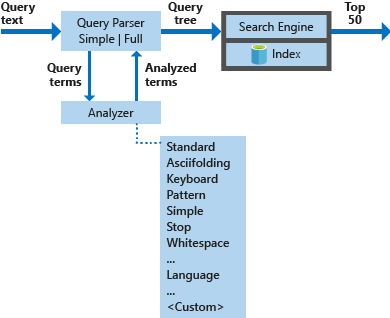
Une requête de recherche en texte intégral commence par analyser le texte de la requête pour extraire les termes et opérateurs de recherche. Il existe deux analyseurs pour que vous puissiez choisir entre la vitesse et la complexité. Une phase d’analyse est suivante, où les termes de requête individuels sont parfois décomposés et reconstitués dans de nouvelles formes. Cette étape permet de jeter un filet plus large sur ce qui pourrait être considéré comme une correspondance potentielle. Le moteur de recherche analyse ensuite l’index pour rechercher des documents avec des termes correspondants et des scores à chaque correspondance. Un jeu de résultats est ensuite trié par un score de pertinence affecté à chaque document correspondant individuel. Les premiers résultats de la liste ordonnée sont renvoyés à l’application appelante.
Le diagramme suivant illustre les composants utilisés pour traiter une demande de recherche :
| Composants clés | Description fonctionnelle |
|---|---|
| Analyseurs de requête | Séparez les termes de requête des opérateurs de requête et créez la structure de requête (arborescence de requêtes) à envoyer au moteur de recherche. |
| Analyseurs | Effectuez une analyse lexicale sur les termes de la requête. Ce processus peut impliquer la transformation, la suppression ou le développement des termes de requête. |
| Index | Structure de données efficace utilisée pour stocker et organiser les termes pouvant faire l’objet d’une recherche extraites de documents indexés. |
| Moteur de recherche | Récupère et note les documents correspondants en fonction du contenu de l’index inversé. |
Anatomie d’une demande de recherche
Une requête de recherche est une spécification complète de ce qui doit être retourné dans un jeu de résultats. Dans sa forme la plus simple, il s’agit d’une requête vide sans critères d’un type quelconque. Un exemple plus réaliste inclut des paramètres, plusieurs termes de requête, peut-être limités à certains champs, avec éventuellement une expression de filtre et des règles de classement.
L’exemple suivant est une demande de recherche que vous pouvez envoyer à Recherche Azure AI à l’aide de l’API REST :
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Pour cette requête, le moteur de recherche effectue les opérations suivantes :
Recherche des documents où le prix est d’au moins 60 $ et inférieur à 300 $.
Exécute la requête. Dans cet exemple, la requête de recherche se compose d’expressions et de termes :
"Spacious, air-condition* +\"Ocean view\""(Les utilisateurs n’entrent généralement pas de ponctuation, mais en l’incluant dans l’exemple, nous pouvons expliquer comment les analyseurs le gèrent.)Pour cette requête, le moteur de recherche analyse les champs de description et de titre spécifiés dans « searchFields » pour les documents qui contiennent
"Ocean view", et en outre sur le terme"spacious", ou sur les termes qui commencent par le préfixe"air-condition". Le paramètre « searchMode » est utilisé pour correspondre à n’importe quel terme (valeur par défaut) ou dans tous les cas où un terme n’est pas explicitement requis (+).Commande l’ensemble obtenu d’hôtels par proximité d’un emplacement géographique donné, puis retourne les résultats à l’application appelante.
La plupart de cet article concerne le traitement de la requête de recherche : "Spacious, air-condition* +\"Ocean view\"". Le filtrage et le classement sont hors du cadre. Pour plus d’informations, consultez la documentation de référence de l’API de recherche.
Étape 1 : Analyse des requêtes
Comme indiqué, la chaîne de requête est la première ligne de la requête :
"search": "Spacious, air-condition* +\"Ocean view\"",
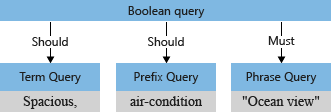
L’analyseur de requête sépare les opérateurs (tels que * et + dans l’exemple) des termes de recherche et déconstructe la requête de recherche en sous-requêtes d’un type pris en charge :
- requête de terme pour les termes autonomes (comme spacieux)
- requête d’expressions pour les termes entre guillemets (comme 'vue sur l'océan')
-
requête de préfixe pour les termes suivis par un opérateur
*de préfixe (comme la climatisation)
Pour obtenir la liste complète des types de requêtes pris en charge, consultez la syntaxe de requête Lucene.
Les opérateurs associés à une sous-requête déterminent si la requête « doit être » ou « devrait être » satisfaite pour qu’un document soit considéré comme une correspondance. Par exemple, +"Ocean view" est « must » en raison de l'opérateur +.
L’analyseur de requête restructure les sous-requêtes dans une arborescence de requêtes (structure interne représentant la requête), qu’il transmet au moteur de recherche. Dans la première étape de l’analyse de requête, l’arborescence de requêtes ressemble à ceci :
Analyseurs pris en charge : Simple Lucene et Full Lucene
Recherche Azure AI expose deux langages de requête différents : simple (par défaut) et full. En définissant le paramètre avec votre demande de recherche, vous indiquez à queryType l’analyseur de requête le langage de requête que vous choisissez afin qu’il sache comment interpréter les opérateurs et la syntaxe.
Le langage de requête simple est intuitif et robuste, souvent adapté à l’interprétation des as-is d’entrée utilisateur sans traitement côté client. Il prend en charge les opérateurs de requête familiers des moteurs de recherche.
Le langage de requête Lucene complet, que vous obtenez en définissant
queryType=full, étend le langage de requête simple par défaut en ajoutant la prise en charge d’autres opérateurs et types de requêtes tels que des caractères génériques, des expressions approximatives, des expressions régulières et des requêtes délimitées par des champs. Par exemple, une expression régulière envoyée dans la syntaxe de requête simple serait interprétée comme une chaîne de requête et non comme une expression. L’exemple de requête de cet article utilise le langage de requête Lucene complet.
Impact de searchMode sur l’analyseur
Un autre paramètre de demande de recherche qui affecte l’analyse est le paramètre « searchMode ». Il contrôle l’opérateur par défaut pour les requêtes booléennes : tout (par défaut) ou tout.
Lorsque « searchMode=any », qui est la valeur par défaut, le délimiteur d’espace entre l’espace spacieux et la condition aérienne est OR (||), ce qui rend l’exemple de texte de requête équivalent à :
Spacious,||air-condition*+"Ocean view"
Les opérateurs explicites, tels que + dans +"Ocean view", sont non ambigus dans la construction de requête booléenne (le terme doit correspondre). Il est moins évident de savoir comment interpréter les termes restants : spacieux et climatisation. Le moteur doit-il rechercher les correspondances avec vue mer et spacieux et air condition ? Ou doit-il rechercher les correspondances avec vue mer et l’un des termes restants ?
Par défaut (« searchMode=any »), le moteur de recherche suppose l’interprétation plus large. L’un ou l’autre champ doit être mis en correspondance, reflétant la sémantique « ou ». L’arborescence de requêtes initiale illustrée précédemment, avec les deux opérations « doit », affiche la valeur par défaut.
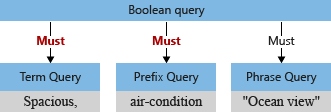
Supposons que nous définissions maintenant « searchMode=all ». Dans ce cas, l’espace est interprété comme une opération « et ». Les deux termes restants doivent être présents dans le document pour que cela soit considéré comme une correspondance. L’exemple de requête obtenu est interprété comme suit :
+Spacious,+air-condition*+"Ocean view"
Une arborescence de requêtes modifiée pour cette requête, où un document correspondant est l’intersection des trois sous-requêtes, ressemble à ceci :
Note
Le choix de « searchMode=any » sur « searchMode=all » est une décision la mieux prise en exécutant des requêtes représentatives. Les utilisateurs susceptibles d’inclure des opérateurs (courants lors de la recherche de bases de documents) peuvent trouver des résultats plus intuitifs si « searchMode=all » oriente les constructions de requêtes booléennes. Pour plus d’informations sur l’interaction entre « searchMode » et les opérateurs, consultez syntaxe de requête simple.
Étape 2 : Analyse lexicale
Les analyseurs lexicals traitent les requêtes de termes et les requêtes d’expressions après la structure de l’arborescence des requêtes. Un analyseur accepte les entrées de texte qui lui sont fournies par l’analyseur, traite le texte, puis renvoie les termes tokenisés à incorporer dans l’arborescence de requêtes.
La forme la plus courante d’analyse lexicale est l’analyse linguistique, qui transforme les termes de requête en fonction de règles spécifiques à un langage donné. Cela implique :
- Réduction d’un terme de requête à la forme racine d’un mot.
- Suppression de mots non essentiels (mots vides, tels que « the » ou « and » en anglais).
- Fractionnant un mot composite en parties de composant.
- Mettre en minuscules un mot en majuscules.
Toutes ces opérations ont tendance à effacer les différences entre l’entrée de texte fournie par l’utilisateur et les termes stockés dans l’index. Ces opérations vont au-delà du traitement du texte et nécessitent une connaissance approfondie de la langue elle-même. Pour ajouter cette couche de sensibilisation linguistique, Recherche Azure AI prend en charge une longue liste d’analyseurs language de Lucene et de Microsoft.
Note
Selon votre scénario, les exigences d’analyse peuvent varier d’un minimum à l’autre. Vous pouvez contrôler la complexité de l’analyse lexicale en sélectionnant l’un des analyseurs prédéfinis ou en créant votre propre analyseur custome. Les analyseurs sont limités aux champs pouvant faire l’objet d’une recherche et sont spécifiés dans le cadre d’une définition de champ. Cela vous permet de varier l’analyse lexicale sur une base par champ. S’il n’est pas spécifié, l’analyseur Lucene standard est utilisé.
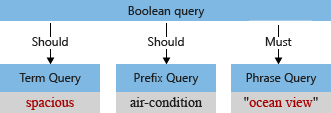
Dans notre exemple, avant l’analyse, l’arborescence de requêtes initiale a le terme « Spacieux », avec un majuscule « S » et une virgule que l’analyseur de requête interprète dans le cadre du terme de requête (une virgule n’est pas considérée comme un opérateur de langage de requête).
Lorsque l’analyseur par défaut traite le terme, il met en minuscule « vue sur l'océan » et « spacieux » et supprime la virgule. L’arborescence de requêtes modifiée ressemble à ceci :
Test des comportements de l’analyseur
Le comportement d’un analyseur peut être testé à l’aide de l’API Analyser. Indiquez le texte que vous souhaitez analyser pour voir les termes générés par l’analyseur donné. Par exemple, pour voir comment l’analyseur standard traiterait le texte « air-condition », vous pouvez émettre la requête suivante :
{
    "text": "air-condition",
    "analyzer": "standard"
}
L'analyseur standard décompose le texte d'entrée en les deux mots-clés suivants, en les annotant avec des attributs tels que les décalages de début et de fin (utilisés pour la mise en surbrillance des résultats) ainsi que leur position (utilisée pour la correspondance de phrases) :
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Exceptions à l’analyse lexicale
L’analyse lexicale s’applique uniquement aux types de requêtes qui nécessitent des termes complets, soit une requête de terme, soit une requête d’expression. Elle ne s’applique pas aux types de requêtes avec des termes incomplets ( requête de préfixe, requête générique et requête regex) ou à une requête approximative. Ces types de requêtes, y compris la requête de préfixe avec le terme air-condition* dans notre exemple, sont ajoutés directement à l’arborescence de requêtes, en contournant la phase d’analyse. La seule transformation effectuée sur les termes de requête de ce type est l’utilisation de minuscules.
Étape 3 : Récupération de documents
La récupération de documents fait référence à la recherche de documents avec des termes correspondants dans l’index. Cette étape est mieux comprise par l’intermédiaire d’un exemple. Commençons par un index d’hôtels qui a le schéma simple suivant :
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Supposons également que cet index contient les quatre documents suivants :
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Comment les termes sont indexés
Pour comprendre la récupération, il permet de connaître quelques notions de base sur l’indexation. L’unité de stockage est un index inversé, un pour chaque champ pouvant faire l’objet d’une recherche. Dans un index inversé, il s’agit d’une liste triée de tous les termes de tous les documents. Chaque terme correspond à la liste des documents dans lesquels il se produit, comme indiqué dans l’exemple ci-dessous.
Pour produire les termes d’un index inversé, le moteur de recherche effectue une analyse lexicale sur le contenu des documents, comme ce qui se passe pendant le traitement des requêtes :
- Les entrées de texte sont transmises à un analyseur, converties en minuscules, dépourvues de ponctuation, et ainsi de suite, en fonction de la configuration de l’analyseur.
- Les jetons sont la sortie de l’analyse lexicale.
- Les termes sont ajoutés à l’index.
Il est courant, mais pas obligatoire, d’utiliser les mêmes analyseurs pour les opérations de recherche et d’indexation afin que les termes de requête ressemblent davantage aux termes de l’index.
Note
Recherche Azure AI vous permet de spécifier différents analyseurs pour l’indexation et la recherche via des paramètres de champ indexAnalyzer et searchAnalyzer supplémentaires. S’il n’est pas spécifié, l’analyseur défini avec la analyzer propriété est utilisé pour l’indexation et la recherche.
Index inversé pour des exemples de documents
En retournant à notre exemple, pour le champ de titre , l’index inversé ressemble à ceci :
| Terme | Liste des documents |
|---|---|
| Atman | 1 |
| Plage | 2 |
| Hôtel | 1, 3 |
| Océan | 4 |
| Playa | 3 |
| complexe | 2 |
| Retraite | 4 |
Dans le champ titre, seul l’hôtel apparaît dans deux documents : 1 et 3.
Pour le champ de description , l’index ressemble à ceci :
| Terme | Liste des documents |
|---|---|
| Air | 3 |
| Et | 4 |
| Plage | 1 |
| conditionné | 3 |
| confortable | 3 |
| distance | 1 |
| Île | 2 |
| kauaʻi | 2 |
| Situé | 2 |
| Nord | 2 |
| Océan | 1, 2, 3 |
| De | 2 |
| Sur | 2 |
| Calme | 4 |
| Chambres | 1, 3 |
| Isolée | 4 |
| Rive | 2 |
| Spacieux | 1 |
| le | 1, 2 |
| À | 1 |
| Vue | 1, 2, 3 |
| Marche | 1 |
| Avec | 3 |
Correspondance des termes de requête par rapport aux termes indexés
Étant donné les index inversés ci-dessus, revenons à l’exemple de requête et voyons comment les documents correspondants sont trouvés pour notre exemple de requête. Rappelez-vous que l’arborescence de requête finale ressemble à ceci :
Pendant l’exécution des requêtes, les requêtes individuelles sont exécutées sur les champs pouvant faire l’objet d’une recherche indépendamment.
Le TermQuery « spacious » correspond au document 1 (Hôtel Atman).
PrefixQuery, « air-condition* », ne correspond à aucun document.
Ce comportement confond parfois les développeurs. Bien que le terme climatisé existe dans le document, il est séparé en deux mots par l’analyseur par défaut. Rappelez-vous que les requêtes de préfixe, qui contiennent des termes partiels, ne sont pas analysées. Par conséquent, les termes avec le préfixe « climatisation » sont recherchés dans l’index inversé mais sont introuvables.
PhraseQuery, « vue océan », recherche les termes « océan » et « vue » et vérifie la proximité des termes dans le document d’origine. Les documents 1, 2 et 3 correspondent à cette requête dans le champ description. Notez que le document 4 a le terme « océan » dans le titre, mais n’est pas considéré comme une correspondance, car nous recherchons l’expression « vue océan » plutôt que des mots individuels.
Note
Une requête de recherche est exécutée indépendamment sur tous les champs pouvant faire l’objet d’une recherche dans l’index Recherche Azure AI, sauf si vous limitez les champs définis avec le paramètre searchFields, comme illustré dans l’exemple de demande de recherche. Les documents qui correspondent dans l’un des champs sélectionnés sont retournés.
Dans l’ensemble, pour la requête en question, les documents correspondant sont 1, 2 et 3.
Étape 4 : Évaluation
Chaque document d’un jeu de résultats de recherche reçoit un score de pertinence. La fonction du score de pertinence consiste à classer plus haut les documents qui répondent le mieux à une question utilisateur, comme exprimé par la requête de recherche. Le score est calculé en fonction des propriétés statistiques des termes qui correspondent. Au cœur de la formule de scoring est la fréquence de terme- fréquence inverse du document (TF/IDF). Dans les requêtes contenant des termes rares et courants, TF/IDF promeut les résultats contenant le terme rare. Par exemple, dans un index hypothétique avec tous les articles Wikipédia, à partir de documents correspondant à la requête le président, les documents correspondant à président sont considérés comme plus pertinents que les documents correspondant à le.
Exemple de notation
Rappelez-vous les trois documents correspondant à notre exemple de requête :
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Le document 1 correspond le mieux à la requête, car le terme spacieux et la phrase requise vue océan apparaissent dans le champ de description. Les deux documents suivants correspondent uniquement à l’expression vue océan. Vous pouvez être surpris que les scores de pertinence des documents 2 et 3 soient différents, même s’ils correspondent à la requête de la même façon. C’est parce que la formule de scoring a plus de composants que tf/IDF. Dans ce cas, le document 3 a reçu un score légèrement plus élevé, car sa description est plus courte. Découvrez la formule de notation pratique de Lucene pour comprendre comment la longueur du champ et d’autres facteurs peuvent influencer le score de pertinence.
Certains types de requête (caractère générique, préfixe et expression régulière) contribuent toujours à un score constant dans le score général du document. Cela permet aux correspondances trouvées par le biais de l’extension de requête d’être incluses dans les résultats sans affecter le classement.
Un exemple illustre la raison pour laquelle cela est important. Les recherches par caractères génériques, y compris les recherches par préfixe, sont ambiguës par définition, car l’entrée est une chaîne partielle avec des correspondances potentielles sur un très grand nombre de termes disparates. Considérez une entrée de « tour* », avec des correspondances trouvées sur « tours », « tourettes » et « tourmaline ». Compte tenu de la nature de ces résultats, il n’existe aucun moyen de déduire raisonnablement quels termes sont plus précieux que d’autres. Pour cette raison, nous ignorons les fréquences des termes lorsque nous évaluons les résultats dans des requêtes de type générique, préfixe ou regex. Dans une demande de recherche en plusieurs parties qui inclut des termes partiels et complets, les résultats de l’entrée partielle sont incorporés avec un score constant pour éviter les biais vers des correspondances potentiellement inattendues.
Réglage de la pertinence
Il existe deux façons d’ajuster les scores de pertinence dans Recherche Azure AI :
Les profils de scoring favorisent les documents dans la liste classée des résultats en fonction d’un ensemble de règles. Dans notre exemple, nous pourrions considérer les documents correspondants dans le champ titre plus pertinents que les documents correspondant dans le champ description. En outre, si notre indice avait un champ de prix pour chaque hôtel, nous pourrions promouvoir des documents avec des prix inférieurs. En savoir plus sur l’ajout de profils de scoring à un index de recherche.
La promotion de termes (disponible uniquement dans la syntaxe de requête complète Lucene) fournit un opérateur de promotion
^qui peut être appliqué à d’autres parties de l’arborescence de requête. Dans notre exemple, au lieu de rechercher sur le préfixe climatisation*, vous pouvez rechercher soit le terme exact climatisation, soit le préfixe, mais les documents correspondant au terme exact sont classés plus haut en appliquant une pondération accrue à la requête de terme : air-condition^2||air-condition*. En savoir plus sur l’amélioration des termes dans une requête.
Le calcul du score dans un index distribué
Tous les index de Recherche Azure AI sont automatiquement divisés en plusieurs partitions, ce qui nous permet de distribuer rapidement l’index entre plusieurs nœuds pendant le scale-up ou le scale-down du service. Lorsqu'une demande de recherche est émise, elle est effectuée sur chaque shard de manière indépendante. Les résultats de chaque partition sont ensuite fusionnés et classés par score (si aucun autre classement n’est défini). Il est important de savoir que la fonction de scoring compare la fréquence de terme de requête à la fréquence inverse de documents dans tous les documents de la partition, et pas dans toutes les partitions.
Cela signifie qu’un score de pertinence pourrait être différent pour des documents identiques s’ils résident sur des fragments différents. Heureusement, ces différences ont tendance à disparaître à mesure que le nombre de documents dans l’index augmente en raison d’une distribution plus uniforme des termes. Il n’est pas possible de supposer sur quelle partition un document donné sera placé. Toutefois, en supposant qu’une clé de document ne change pas, elle est toujours affectée à la même partition.
En général, le score de document n’est pas le meilleur attribut pour classer les documents si la stabilité de l’ordre est importante. Par exemple, étant donné deux documents avec un score identique, il n’existe aucune garantie qu’un document apparaît en premier dans les exécutions suivantes de la même requête. Le score de document ne doit donner qu’un sens général de la pertinence du document par rapport aux autres documents de l’ensemble de résultats.
Conclusion
Le succès des moteurs de recherche commerciaux a suscité des attentes en matière de recherche en texte intégral sur des données privées. Pour presque n’importe quel type d’expérience de recherche, nous nous attendons maintenant à ce que le moteur comprenne notre intention, même lorsque les termes sont mal orthographiés ou incomplets. Nous pouvons même nous attendre à des correspondances basées sur des termes ou synonymes quasiment équivalents que nous n’avons jamais spécifiés.
Du point de vue technique, la recherche en texte intégral est très complexe, nécessitant une analyse linguistique sophistiquée et une approche systématique du processus pour distiller, développer et transformer les termes de requête de manière à fournir un résultat pertinent. Étant donné les complexités inhérentes, il existe de nombreux facteurs qui peuvent affecter le résultat d’une requête. Pour cette raison, investir le temps de comprendre les mécanismes de recherche en texte intégral offre des avantages tangibles lors de la tentative de travailler sur des résultats inattendus.
Cet article a exploré la recherche en texte intégral dans le contexte de Recherche Azure AI. Nous espérons qu’il vous donne suffisamment de connaissances pour reconnaître les causes et les résolutions potentielles pour résoudre les problèmes de requête courants.
Étapes suivantes
Générez l’exemple d’index, essayez différentes requêtes et passez en revue les résultats. Pour obtenir des instructions, consultez Build et interrogez un index dans le portail Azure.
Essayez d’autres syntaxes de requête à partir de l’exemple de section Search Documents ou de la syntaxe de requête Simple dans l’Explorateur de recherche dans le portail Azure.
Passez en revue les profils de scoring si vous souhaitez paramétrer le classement dans votre application de recherche.
Configurez des analyseurs personnalisés pour un traitement minimal ou un traitement spécialisé sur des champs spécifiques.