Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Nota
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
En Búsqueda de Azure AI, puede ejecutar un indexador de varias maneras:
- Ejecute inmediatamente después de la creación del indexador. Esta opción es el valor predeterminado a menos que cree el indexador en un estado deshabilitado.
- Ejecute según una programación para invocar la ejecución a intervalos regulares. Si un indexador programado deja de desencadenarse, consulte Preguntas más frecuentes sobre el comportamiento de programación para conocer los pasos de recuperación.
- Ejecutar bajo demanda, con o sin restablecimiento.
En este artículo se explica cómo ejecutar indizadores a petición, con y sin un restablecimiento. También describe la ejecución, la duración y la simultaneidad del indexador.
Cómo se conectan los indexadores a recursos de Azure
Los indexadores son uno de los pocos subsistemas que realizan llamadas salientes explícitas a recursos de Azure. Según el origen de datos externo, puede usar claves o roles para autenticar la conexión.
En términos de roles de Azure, los indexadores no tienen identidades independientes: una conexión del motor de búsqueda a otro recurso de Azure usa el sistema o la identidad administrada asignada por el usuario de un servicio de búsqueda, además de una asignación de roles en el recurso de Azure de destino. Si el indexador se conecta a un recurso de Azure en una red virtual, debe crear un vínculo privado compartido para esa conexión.
Nota
Los indexadores funcionan con permisos de nivel de servicio en lugar de permisos de usuario. Un indexador puede escribir en cualquier índice del servicio de búsqueda, incluso si asignó roles para restringir el acceso a índices específicos. Para obtener más información, consulte Operaciones de indización y ámbito por índice.
Ejecución del indexador
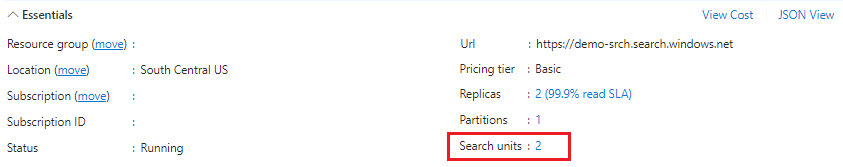
Un servicio de búsqueda ejecuta un trabajo de indexador por unidad de búsqueda. Cada servicio de búsqueda comienza con una unidad de búsqueda, pero cada nueva partición o réplica aumenta las unidades de búsqueda del servicio. Puede comprobar el recuento de unidades de búsqueda en la sección Essential del portal de Azure de la página Overview. Si necesita procesamiento simultáneo, asegúrese de que las unidades de búsqueda incluyan réplicas suficientes. Los indexadores no se ejecutan en segundo plano, por lo que es posible que experimente más limitación de consultas de lo habitual si el servicio está bajo presión.
En la captura de pantalla siguiente se muestra el número de unidades de búsqueda, que determina el número de indizadores que se pueden ejecutar a la vez.
Una vez iniciada la ejecución del indexador, no se puede pausar ni detenerla. La ejecución del indexador se detiene cuando no hay más documentos para cargar o actualizar, o cuando se alcanza el límite máximo de tiempo de ejecución .
Puede ejecutar varios indexadores a la vez suponiendo capacidad suficiente, pero cada indizador es una sola instancia. Al iniciar una nueva instancia mientras el indexador ya está en ejecución, se produce este error: "Failed to run indexer "<indexer name>" error: "Another indexer invocation is currently in progress; concurrent invocations are not allowed."
Entorno de ejecución del indexador
Un trabajo de indexador se ejecuta en un entorno de ejecución administrado. Actualmente, hay dos entornos:
Un entorno de ejecución privado se ejecuta en clústeres de búsqueda específicos del servicio de búsqueda.
Un entorno multiinquilino tiene procesadores de contenido que Microsoft administra y protege sin costo adicional. Este entorno descarga el procesamiento intensivo de cálculo, por lo que los recursos específicos del servicio permanecen disponibles para las operaciones rutinarias. Siempre que sea posible, la mayoría de las habilidades se ejecutan en un entorno multitenant. Este entorno es el predeterminado.
El procesamiento intensivo de cálculo hace referencia a los conjuntos de aptitudes que se ejecutan en procesadores de contenido y trabajos de indexador que procesan un gran volumen de documentos o documentos de un tamaño grande. La heurística y la información del sistema determinan el procesamiento no basado en conjuntos de habilidades en los procesadores de contenido multitenant, y esto no está bajo el control del cliente.
Puede evitar el uso del entorno multiinquilino en los servicios Standard2 o superior anclando un indexador y procesamiento de conjuntos de aptitudes exclusivamente a los clústeres de búsqueda.
Establezca el executionEnvironment parámetro en la definición del indexador para ejecutar siempre un indexador en el entorno de ejecución privado.
Los firewalls IP bloquean el entorno multiinquilino, por lo que si tiene un firewall, cree una regla que permita conexiones de procesador multiinquilino.
Los límites del indexador varían para cada entorno:
| Carga de trabajo | Duración máxima | Número máximo de trabajos | Entorno de ejecución |
|---|---|---|---|
| Ejecución privada | 24 horas | Un trabajo de indexador por unidad de búsqueda1. | La indexación no se ejecuta en segundo plano. En su lugar, el servicio de búsqueda equilibra todos los trabajos de indexación con las consultas en curso y las acciones de administración de objetos (como crear o actualizar índices). Al ejecutar indexadores, debería esperar ver cierta latencia de consulta si los volúmenes de indexación son grandes. |
| Multiinquilino | 2 horas 2 | Indeterminado 3 | Dado que el clúster de procesamiento de contenido es multiinquilino, el sistema agrega procesadores de contenido para satisfacer la demanda. Si experimenta un retraso en la ejecución programada o a petición, es probable que el sistema agregue procesadores o espere a que uno esté disponible. |
1 Las unidades de búsqueda pueden ser combinaciones flexibles de particiones y réplicas, pero los trabajos del indexador no están vinculados a uno o al otro. En otras palabras, si tiene 12 unidades, puede tener 12 trabajos de indexador que se ejecutan simultáneamente en ejecución privada, independientemente de cómo se implementen las unidades de búsqueda.
2 Si se necesitan más de dos horas para procesar todos los datos, habilite la detección de cambios y programe el indexador para que se ejecute a intervalos de 5 minutos para reanudar la indexación rápidamente si se detiene debido a un tiempo de espera. Consulte Indexación de un conjunto de datos grande para obtener más estrategias.
3 "Indeterminado" significa que el límite no se cuantifica por el número de trabajos. Algunas cargas de trabajo, como el procesamiento de conjuntos de aptitudes, se pueden ejecutar en paralelo, lo que podría dar lugar a muchos trabajos aunque solo haya un indexador implicado. Aunque el entorno no impone restricciones, todavía se aplican los límites del indexador para el servicio de búsqueda.
Ejecución sin restablecimiento
Una operación Ejecutar indexador detecta y procesa solo lo que necesita para sincronizar el índice de búsqueda con cambios en el origen de datos subyacente. La indexación incremental comienza localizando un punto máximo interno para encontrar el último documento de búsqueda actualizado. Este documento se convierte en el punto de partida para la ejecución del indexador en documentos nuevos y actualizados en el origen de datos.
La detección de cambios es esencial para determinar las novedades o actualizaciones en el origen de datos. Los indexadores usan las funcionalidades de detección de cambios del origen de datos subyacente para determinar las novedades o actualizaciones del origen de datos.
Azure Storage tiene detección de cambios integrada a través de su propiedad LastModified.
Otros orígenes de datos, como Azure SQL o Azure Cosmos DB, requieren configuración para la detección de cambios antes de que el indexador pueda leer filas nuevas y actualizadas.
Si el contenido subyacente no cambia, una operación de ejecución no tiene ningún efecto. En este caso, el historial de ejecución del indexador indica los documentos procesados 0\0 .
Para volver a procesar todos los documentos, debe restablecer el indexador.
Restablecer indizadores
Después de la ejecución inicial, un indexador realiza un seguimiento de los documentos de búsqueda que se indexan a través de una marca de agua alta interna. El marcador no se expone, pero internamente el indexador sabe dónde se detuvo por última vez.
Para volver a generar todo o parte de un índice, use Reset API disponibles en niveles decrecientes en la jerarquía de objetos:
- La opción Restablecer indexadores borra el punto máximo y realiza una reindexación completa de todos los documentos.
- Los indexadores de resincronización (versión preliminar) realizan una redexación parcial eficaz de todos los documentos.
- Restablecer documentos (versión preliminar) vuelve a indexar un documento específico o una lista de documentos.
- Restablecer aptitudes (versión preliminar) invoca el procesamiento de aptitudes para una aptitud específica.
Después del restablecimiento, siga con un comando Ejecutar para volver a procesar documentos nuevos y existentes. No es posible eliminar documentos de búsqueda huérfanos que no tengan su contraparte en la fuente de datos mediante el restablecimiento y la ejecución. Para eliminar documentos específicos, consulte Eliminar documentos en un índice de búsqueda o Documentos: Índice.
Nota
Las tablas no pueden estar vacías. Si usa TRUNCATE TABLE para borrar filas, el restablecimiento y la repetición del indexador no quitarán los documentos de búsqueda correspondientes. Para quitar documentos de búsqueda huérfanos, debe indexarlos con una acción de eliminación.
Cómo restablecer y ejecutar indexadores
El restablecimiento borra el límite máximo. Todos los documentos del índice de búsqueda se marcan para reescritura completa, sin actualizaciones en línea ni combinación con contenido existente. Para los indexadores con un conjunto de aptitudes y caché de enriquecimiento (vista previa), restablecer el índice también restablece implícitamente el conjunto de aptitudes.
El trabajo real se produce cuando se sigue un restablecimiento con un comando Ejecutar:
- Todos los documentos nuevos encontrados en el origen subyacente se agregan al índice de búsqueda.
- Todos los documentos que existen en el origen de datos y en el índice de búsqueda se sobrescriben en el índice de búsqueda.
- Cualquier contenido enriquecido creado a partir de conjuntos de habilidades vuelve a generarse. La caché de enriquecimiento, si está habilitada, se actualiza.
Como se indicó anteriormente, el restablecimiento es una operación pasiva: debe seguir con una solicitud de ejecución para volver a generar el índice.
Las operaciones de restablecimiento o ejecución se aplican a un índice de búsqueda o a un almacén de conocimiento, a documentos o proyecciones específicos y a enriquecimientos almacenados en caché si un restablecimiento incluye explícita o implícitamente aptitudes.
El reinicio también se aplica a las operaciones de creación y actualización. No provoca la eliminación de documentos huérfanos ni la depuración del índice de búsqueda. Para obtener más información sobre la eliminación de documentos, vea Documentos : índice.
No se puede deshacer una operación de restablecimiento.
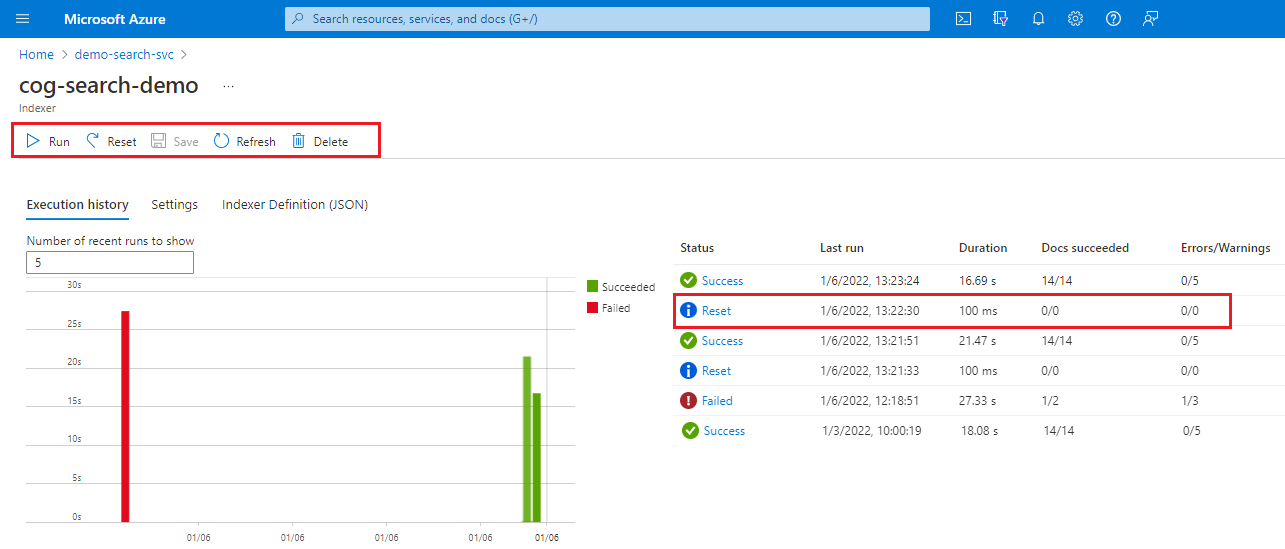
Vaya al servicio de búsqueda en el portal Azure.
En la página Información general , seleccione la pestaña Indexadores .
Seleccione un indexador.
Seleccione el comando Restablecer y, a continuación, seleccione Sí para confirmar la acción.
Actualice la página para mostrar el estado. Puede seleccionar el elemento para ver sus detalles.
Seleccione Ejecutar para iniciar el procesamiento del indexador o espere a la siguiente ejecución programada.
Cómo restablecer habilidades (versión preliminar)
La solicitud Reset Skills (Restablecer aptitudes) procesa de forma selectiva una o varias aptitudes durante la siguiente ejecución del indexador. En el caso de los indexadores que tengan conjuntos de aptitudes, restablezca las aptitudes individuales para volver a forzar el procesamiento de solo esa aptitud y cualquier aptitud de nivel inferior que dependa de su salida. Si ha habilitado la caché de enriquecimiento, la solicitud también la actualiza.
En el caso de los indexadores que tienen habilitado el almacenamiento en caché, puede solicitar explícitamente el procesamiento de actualizaciones de aptitudes que el indexador no puede detectar. Por ejemplo, si realiza cambios externos, como revisiones a una aptitud personalizada, use esta API para volver a ejecutar la aptitud. El proceso actualiza las salidas, como un almacén de conocimiento o un índice de búsqueda, mediante el uso de datos reutilizables de la memoria caché y el nuevo contenido según la aptitud actualizada.
Use la API de versión preliminar más reciente.
POST /skillsets/[skillset name]/resetskills?api-version=2026-08-01-preview
{
    "skillNames" : [
        "#1",
        "#5",
        "#6"
    ]
}
Puede especificar aptitudes individuales, como se muestra en el ejemplo anterior, pero si alguna de esas aptitudes requiere la salida de aptitudes no incluidas en la lista (#2 a #4), el proceso ejecuta aptitudes no incluidas en la lista a menos que la memoria caché pueda proporcionar la información necesaria. Para que esta condición se cumpla, los enriquecimientos almacenados en caché para las habilidades n.º 2 a n.º 4 no deben depender de la n.º 1 (incluida en el restablecimiento).
Si no especifica ninguna aptitud, el proceso ejecuta todo el conjunto de aptitudes y, si el almacenamiento en caché está habilitado, también actualiza la memoria caché.
No olvide realizar un seguimiento con Run Indexer para invocar el procesamiento real.
Cómo restablecer documentos (guía preliminar)
La API Indexers - Reset Docs (versión preliminar) acepta una lista de claves de documento para que pueda actualizar documentos específicos. Si especifica los parámetros de restablecimiento, determinan únicamente lo que se procesa, independientemente de otros cambios en los datos subyacentes. Por ejemplo, si se agregaron o actualizaron 20 blobs desde la última ejecución del indexador, pero solo se restablece un documento, el indexador solo procesa ese documento.
Por documento, el indexador actualiza todos los campos del documento de búsqueda con valores y metadatos del origen de datos. No se pueden seleccionar y elegir los campos que se van a actualizar.
Si el origen de datos es Azure Data Lake Storage (ADLS) Gen2 y los blobs están asociados con metadatos de permiso, el indexador vuelve a ingerir esos permisos en el índice de búsqueda si los permisos cambian en los datos subyacentes. Para obtener más información, consulte Volver a indexar la ACL y el ámbito de RBAC con indizadores de ADLS Gen2.
Si enriquece el documento a través de un conjunto de aptitudes y tiene datos almacenados en caché, el indexador invoca el conjunto de aptitudes solo para los documentos especificados y actualiza la memoria caché de los documentos reprocesados.
Al probar esta API por primera vez, las siguientes API pueden ayudarle a validar y probar los comportamientos. Use la API de versión preliminar más reciente.
Llame a Indizadores: Obtener estado con una API de versión preliminar para comprobar los estados del restablecimiento y la ejecución. Puede encontrar información sobre la solicitud de restablecimiento al final de la respuesta de estado.
Llame a Indizadores: Restablecer documentos con una API de versión preliminar para especificar los documentos que se van a procesar.
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "1001",
        "4452"
    ]
}
La API acepta dos tipos de identificadores de documento como entrada: claves de documento que identifican de forma única documentos en un índice de búsqueda y identificadores de documento de origen de datos que identifican de forma única los documentos de un origen de datos. El cuerpo debe contener una lista de claves de documento o bien una lista de identificadores de documentos que el indexador busca en el origen de datos. Al invocar la API, se agregan las claves de documento o los identificadores de documento del origen de datos para restablecerlos a los metadatos del indexador. En la siguiente ejecución programada o a petición del indexador, el indexador solo procesa los documentos de restablecimiento.
Si usa claves de documento para restablecer documentos y se hace referencia a sus claves de documento en un mapeo de campos del indexador, el indexador utiliza el mapeo de campos para localizar el campo adecuado en la fuente de datos subyacente.
Las claves de documento que proporcione en la solicitud son valores del índice de búsqueda, que pueden ser diferentes de los campos correspondientes del origen de datos. Si no está seguro del valor de clave, envíe una consulta para devolver el valor. Puede usar
selectpara devolver solo el campo de clave del documento.En el caso de los blobs que el indexador analiza para generar varios documentos de búsqueda (donde
parsingModese establece en jsonLines o jsonArrays, o delimitedText), el indexador genera la clave del documento y es posible que usted no la conozca. En este escenario, se realiza una consulta de la clave del documento para devolver el valor correcto.Si desea que el indexador deje de intentar procesar el restablecimiento de documentos, establezca
"documentKeys"o"datasourceDocumentIds"en una lista[]vacía. Esta acción hace que el indizador reanude la indexación normal basándose en la marca máxima. Se omiten las claves de documento no válidas o que no existen.
Llame a Run Indexer (cualquier versión de API) para procesar los documentos especificados. El indexador solo indexa esos documentos específicos.
Llame a Run Indexer una segunda vez para procesar desde el último punto de referencia.
Llame a Buscar documentos para comprobar si hay valores actualizados y también para devolver claves de documento si no está seguro del valor. Use
"select": "<field names>"si desea limitar los campos que aparecen en la respuesta.
Sobrescribir la lista de claves del documento
Si llama varias veces a la API Reset Documents con claves diferentes, las nuevas claves se añaden a la lista de claves de documento restablecidas. Si llama a la API con el overwrite parámetro establecido en true, la lista actual se reemplaza por la nueva:
POST https://[service name].search.windows.net/indexers/[indexer name]/resetdocs?api-version=2026-08-01-preview
{
    "documentKeys" : [
        "200",
        "630"
    ],
    "overwrite": true
}
Cómo resincronizar indizadores (versión preliminar)
Resync Indexers es una API REST en versión preliminar que realiza una reindexación parcial de todos los documentos. Un indexador se considera sincronizado con su origen de datos cuando los campos específicos de todos los documentos del índice de destino son coherentes con los datos del origen de datos. Normalmente, un indexador logra la sincronización después de una ejecución inicial correcta. Si elimina un documento del origen de datos, el indexador permanece sincronizado según esta definición. Sin embargo, durante la siguiente ejecución del indexador, se quita el documento correspondiente del índice de destino si se habilita el seguimiento de eliminación.
Si modifica un documento en el origen de datos, el indexador se desincroniza. Por lo general, los mecanismos de seguimiento de cambios vuelven a sincronizar el indexador durante la siguiente ejecución. Por ejemplo, en Azure Storage, al modificar un blob, se actualiza la fecha y hora de su última modificación, por lo que el indexador puede volver a indexarlo en la siguiente ejecución, ya que la fecha y hora actualizadas superan la marca máxima establecida por la ejecución anterior.
Por el contrario, para ciertas fuentes de datos como ADLS Gen2, modificar las listas de control de acceso (ACL) de un blob no cambia la fecha y hora de la última modificación, por lo que el seguimiento de cambios no es eficaz si se deben ingerir las ACL. Por lo tanto, el blob modificado no se vuelve a indexar en la ejecución subsiguiente, ya que solo se procesan los documentos modificados después de la última marca de nivel máximo.
Aunque el uso de "reset" o "reset docs" puede solucionar este problema, "reset" puede ser lento e ineficaz para grandes conjuntos de datos, y "reset docs" requiere identificar la clave de documento del blob que desea actualizar.
Los indexadores de resincronización ofrecen una alternativa eficaz y práctica. Simplemente coloque el indexador en modo de resincronización y especifique el contenido que se va a resincronizar llamando a la API de indexadores de resincronización. En la siguiente ejecución, el indexador inspecciona solo la parte pertinente de los datos del origen y evita cualquier procesamiento innecesario que no esté relacionado con los datos especificados. También consulta los documentos existentes en el índice de destino y solo actualiza los documentos que muestran discrepancias entre el origen de datos y el índice de destino. Después de la ejecución de resincronización, el indexador se sincroniza y vuelve al modo de ejecución normal del indexador para las ejecuciones posteriores.
Cómo resincronizar y ejecutar indizadores
Llame a Indexadores - Resincronizar utilizando una versión preliminar de la API para especificar qué contenido sincronizar nuevamente.
POST https://[service name].search.windows.net/indexers/[indexer name]/resync?api-version=2026-08-01-preview { "options" : [ "permissions" ] }- El
optionscampo es obligatorio. Actualmente, la única opción admitida espermissions. Es decir, solo se actualizan los campos de filtro de permisos del índice de destino.
- El
Llame a Run Indexer (cualquier versión de API) para volver a sincronizar el indexador.
Llame a Run Indexer una segunda vez para procesar desde el último punto de referencia.
Comprobar el estado de restablecimiento "currentState"
Para comprobar el estado de restablecimiento y ver qué claves de documento están en cola para su procesamiento, siga estos pasos:
Llame a Get Indexer Status mediante una API en versión preliminar.
La API de versión preliminar devuelve la
currentStatesección , que se encuentra al final de la respuesta."currentState": { "mode": "indexingResetDocs", "allDocsInitialTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "allDocsFinalTrackingState": "{\"LastFullEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"LastAttemptedEnumerationStartTime\":\"2021-02-06T19:02:07.0323764+00:00\",\"NameHighWaterMark\":null}", "resetDocsInitialTrackingState": null, "resetDocsFinalTrackingState": null, "resyncInitialTrackingState": null, "resyncFinalTrackingState": null, "resetDocumentKeys": [ "200", "630" ] }Compruebe el "modo":
Para Reset Skills, establece mode en
indexingAllDocs, ya que, en principio, todos los documentos se ven afectados en lo que respecta a los campos que rellena el enriquecimiento mediante IA.Para los indexadores de resincronización, establezca "mode" en
indexingResync. El indexador comprueba todos los documentos y se centra en los datos interesados en el origen de datos y los campos interesados en el índice de destino.Para Reset Documents (Restablecer documentos), establezca "mode" en
indexingResetDocs. El indexador mantiene este estado hasta que procesa todas las claves de documento proporcionadas en la llamada de reinicio de documentos. Durante este tiempo, no se ejecutan otros trabajos de indexador mientras progresa la operación. Para encontrar todos los documentos de la lista de claves de documento, es necesario analizar cada documento para localizar la clave y realizar la coincidencia. Este proceso puede tardar un tiempo si el conjunto de datos es grande. Si un contenedor de blobs contiene cientos de blobs y los documentos que desea restablecer están al final, el indexador no encuentra los blobs coincidentes hasta que comprueba primero todos los demás.Después de que el indexador vuelva a procesar los documentos, vuelva a ejecutar Get Indexer Status (Obtener estado del indexador). El indexador vuelve al
indexingAllDocsmodo y procesa los documentos nuevos o actualizados en la siguiente ejecución.
Comprobación de la cuota en tiempo de ejecución del indexador para los servicios de búsqueda S3 HD y sin servidor
Esta sección se aplica a los servicios de búsqueda Standard 3 High Density (S3 HD) y Serverless. Para obtener instrucciones de planificación y orientación sobre el comportamiento de las cuotas agregadas, consulte Ejecución del indexador en Serverless y S3 HD (versión preliminar).
Cada ejecución del indexador tiene un máximo de dos horas. Por separado, todos los indexadores comparten 24 horas de tiempo de ejecución acumulado por servicio en cada ventana UTC de 24 horas.
Para ayudarle a supervisar los tiempos de ejecución del indexador en relación con la ventana de 24 horas, Obtener estadísticas del servicio y Obtener estado del indexador ahora devuelven más información en la respuesta.
Seguimiento de la cuota acumulativa de tiempo de ejecución
Realice un seguimiento del uso acumulado del indizador de un servicio de búsqueda y determine cuánto tiempo de ejecución queda dentro de la ventana actual de 24 horas.
Envíe una solicitud GET al punto de conexión del servicio de búsqueda. Para obtener ayuda para configurar un cliente REST y obtener un token de acceso, consulte Conexión a un servicio de búsqueda.
GET {{search-endpoint}}/servicestats?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Las respuestas incluyen indexersRuntime propiedades que muestran las horas de inicio y finalización de la ventana, segundos acumulados usados por todos los indexadores y segundos restantes para el servicio.
Seguimiento de la cuota en tiempo de ejecución del indexador
Devuelve la misma información para un único indexador.
GET {{search-endpoint}}/indexers/hotels-sample-indexer/search.status?api-version=2026-08-01-preview
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}
Las respuestas incluyen runtime propiedades que muestran las horas de inicio y finalización de la ventana, segundos usados por el indexador y segundos restantes para todos los indexadores del servicio.
Pasos siguientes
Las APIs de restablecimiento se utilizan para definir el alcance de la siguiente ejecución del indexador. Para el procesamiento efectivo, debes ejecutar un indexador bajo demanda o permitir que una tarea programada finalice. Una vez finalizada la ejecución, el indexador vuelve al procesamiento normal, ya sea según una programación o en el procesamiento a petición.
Después de restablecer y volver a ejecutar trabajos del indexador, puede supervisar el estado desde el servicio de búsqueda o obtener información detallada a través del registro de recursos.