Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Note
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
Importante
Las características, funcionalidades o propiedades marcadas (versión preliminar) no están cubiertas por un contrato de nivel de servicio, no se recomiendan para cargas de trabajo de producción y pueden cambiar o restringirse antes de que estén disponibles con carácter general. Los términos de la versión preliminar Búsqueda de Azure AI se aplican a todas las funciones de vista previa, ya sea independiente o parte de una característica disponible con carácter general.
En este artículo se explica cómo añadir almacenamiento en caché a la canalización de un conjunto de aptitudes para que pueda modificar el proceso de enriquecimiento posterior sin necesidad de realizar una recompilación completa cada vez. El almacenamiento en caché de enriquecimiento (versión preliminar) requiere una API REST en versión preliminar. De forma predeterminada, un conjunto de aptitudes no tiene estado y el cambio de cualquier parte de su composición requiere una nueva ejecución completa del indexador. Con una caché de enriquecimiento, el indexador determina qué partes del árbol de documentos se deben actualizar en función de los cambios de definición del conjunto de aptitudes o del indexador. El indexador conserva y reutiliza la salida procesada existente siempre que sea posible.
Usted coloca el contenido almacenado en caché en Azure Storage mediante una cadena de conexión que proporciona. El indexador crea estos objetos cuando se ejecuta. Considere la caché de enriquecimiento un componente interno administrado por el servicio de búsqueda que no debe modificar.
Importante
Una caché de enriquecimiento no es una copia de seguridad de las salidas del conjunto de aptitudes, el estado del indexador o los documentos indexados. No realiza un seguimiento de los documentos que completan el procesamiento. Para orígenes de datos grandes, revise la sección Limitaciones antes de habilitar el almacenamiento en caché.
- Un contenedor denominado
ms-az-search-indexercache-<alpha-numeric-string> - Tablas denominadas
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Requisitos previos
Azure Storage para almacenar enriquecimientos almacenados en caché. La cuenta de almacenamiento debe ser de uso general v2.
Solo para la indexación de blobs, si necesita una eliminación sincronizada de documentos tanto de la caché como del índice cuando se eliminan blobs de su origen de datos, active una directiva de eliminación en el indexador. Sin esta directiva, no se admite la eliminación de documentos de la memoria caché.
Debe estar familiarizado con la configuración de indexadores y conjuntos de habilidades. Comience con la información general del indexador y continúe con las conjunto de aptitudes para aprender sobre las canalizaciones de enriquecimiento.
Limitaciones
Precaución
Si usa el indizador de SharePoint (versión preliminar), evite el enriquecimiento incremental. En determinadas circunstancias, la memoria caché deja de ser válida. Para volver a cargarlo, realice un restablecimiento del indexador y recompilación completa.
Los orígenes de datos grandes tienen una limitación adicional de la memoria caché.
Precaución
En el caso de fuentes de datos de gran tamaño, una caché de enriquecimiento puede aumentar el reprocesamiento total cuando se producen habilidades de larga duración, interrupciones repetidas o errores frecuentes de las habilidades. El indexador prioriza la corrección frente a minimizar el reprocesamiento, por lo que una acumulación en la caché provocada por interrupciones repetidas amplifica el comportamiento de reintento. Se espera este comportamiento, no un error.
Para recuperarse de un trabajo pendiente de caché creciente, particione el origen de datos en contenedores o carpetas virtuales más pequeños. A continuación, use indizadores paralelos que apuntan al mismo índice. Para desasociar la memoria caché, establezca la cache propiedad en null en el indexador. Consulte Indexación de grandes conjuntos de datos para obtener instrucciones sobre el patrón de creación de particiones.
Permisos
Una identidad de Búsqueda de Azure AI necesita acceso de escritura a Azure Storage:
- Colaborador de datos de Storage Blob
- Contribuidor de datos de la tabla de almacenamiento
La sintaxis de la cadena de conexión determina si se usa una identidad asignada por el sistema o por el usuario. Para obtener más información, consulte Connect to Azure Storage using a managed identity.
Establecimiento de la propiedad de caché
Use este procedimiento para indizadores nuevos y existentes.
En la definición del indexador, establezca cache con:
- (Obligatorio)
storageConnectionStringestablecido en una cadena de conexión de Azure Storage. - (Opcional)
enableReprocessing(truede forma predeterminada). Establézcalo enfalsepara suspender el enriquecimiento incremental temporalmente y vuelva a cambiarlo atruemás adelante.
A la izquierda, seleccione Indexadores.
Seleccione Agregar indexador para crear un nuevo indexador o abrir uno existente en modo de edición JSON.
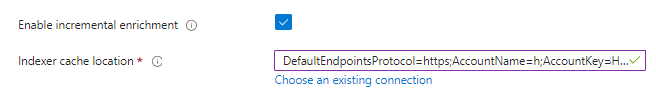
Habilite el enriquecimiento incremental, establezca la cuenta de almacenamiento de caché de enriquecimiento y guarde el indexador.
Restablezca el indexador si ya existe.
Ejecute el indexador. Esta recompilación completa de una sola vez inicializa la memoria caché. Una vez cargado, la reutilización incremental se aplica a las ejecuciones posteriores.