Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Wichtig
Features oder Funktionen, die in diesem Artikel als "Vorschau" gekennzeichnet sind, befinden sich in der öffentlichen Vorschau und unterliegen den ergänzenden Nutzungsbedingungen für Microsoft Azure Previews.
Spezifische Vorschaubedingungen für Foundry IQ (Azure KI-Suche) finden Sie unter Vorschaufunktionen.
Ausdrücke, die beim Herstellen einer Verbindung mit externen Datenquellen gelten, finden Sie unter "Externe Datenquellen".
Die SharePoint in Microsoft 365 Indexer importiert Dateien, Listenelemente und moderne Websiteseiten in Foundry IQ. Sie ist mit der 2026-10-01 REST-API allgemein verfügbar. In diesem Artikel wird diese Version für die Konfigurationsschritte verwendet, gefolgt von Verhalten und Szenarien.
Informationen zur layoutfähigen Extraktion und Teilung unterstützter Dokumente finden Sie unter Extrahieren und Anreichern von SharePoint Dokumenten in Foundry IQ. Verwenden Sie die Wissensquell-APIs für eine einfachere Einrichtung, oder konfigurieren Sie den Indexer und das Skillset direkt für mehr Kontrolle.
In Foundry IQ extrahiert ein Indexer durchsuchbare Daten und Metadaten aus einer Datenquelle. Die SharePoint in Microsoft 365 Indexer bietet die folgenden Funktionen:
- Indiziert Dateien und Metadaten aus einer oder mehreren Dokumentbibliotheken.
- Indiziert SharePoint-Listen und deren Feldwerte der Elemente, wobei jede Listenspalte als Quellfeld für die Feldzuordnung verfügbar ist.
- Indiziert ASPX-Websiteseiten (moderne Websiteseiten).
- Indiziert gemischte SharePoint Inhalte (Dokumentbibliotheken, Listen und Websiteseiten) in einem einzelnen Indexer mithilfe des
allSiteContent-Containerwerts. - Indiziert Inhalte über Unterwebsites hinweg, wenn
includeSubsites=truein der Datenquellenabfrage festgelegt wird. - Indiziert inkrementell, wobei nur die neuen und geänderten Dateien, Listenelemente, Seiten und Metadaten aufgenommen werden.
- Erkennt gelöschte Inhalte automatisch. Das Löschen von Dateien, Listenelementen oder Seiten wird bei der nächsten Indizierungsausführung aufgenommen, und das entsprechende Suchdokument wird aus dem Index entfernt.
- Extrahiert Text und normalisierte Bilder automatisch aus indizierten Dokumenten. Optional können Sie ein Skillset für eine tiefere KI-Anreicherung hinzufügen, z. B. optische Zeichenerkennung (OCR) oder Entitätserkennung.
- Unterstützt die Aufnahme von Berechtigungen auf Dokumentebene. Siehe den verknüpften Artikel für die unterstützte Berechtigungsuntermenge, Gruppenauflösung und Berechtigungssynchronisierung.
- Unterstützt die Erfassung und Berücksichtigung von Microsoft Purview-Vertraulichkeitsbezeichnungen zum Zeitpunkt der Abfrage. Diese Funktionalität befindet sich in der Vorschauversion.
Voraussetzungen
Foundry IQ, Basic-Preisstufe oder höher.
SharePoint in Microsoft 365 Clouddienst (OneDrive ist keine unterstützte Datenquelle).
Zu indizierende SharePoint-Inhalte: Dateien in einer Dokumentbibliothek, Listenelemente oder modernen Websiteseiten.
Visual Studio Code mit der REST-Clienterweiterung zum Einrichten und Ausführen der Indexerpipeline.
Wählen Sie Ihre Berechtigungseinstellungen
Bevor Sie die App-Registrierung in Schritt 3 erstellen, identifizieren Sie Ihr Szenario in der folgenden Tabelle. Beachten Sie die erforderlichen Microsoft Graph-Berechtigungen, SharePoint-API-Berechtigungen und den Typ der Anmeldeinformationen. Führen Sie dann die verknüpften Schritte weiter unten in diesem Artikel aus, um sie anzuwenden.
| Szenario | Microsoft Graph-Berechtigungen | SharePoint-API-Berechtigungen | Credential | Anwenden in |
|---|---|---|---|---|
| Nur Dokumentbibliotheken indizieren, keine ACL-Erfassung |
Files.Read.All, Sites.Read.All (Anwendung) oder delegierte Entsprechungen |
Nichts | Geheimer Clientschlüssel (Anwendung) oder Gerätecode (delegiert) | Schritt 3, Schritt 6 |
| Indexlisten, ASPX-Seiten oder gemischte Inhalte (keine ACL-Aufnahme) |
Files.Read.All, Sites.Read.All (Anwendung) |
Nichts | Geheimer Clientschlüssel oder Verbundanmeldeinformationen | Schritt 3 |
| ACL-Aufnahme oder Abfragezeitauflösung von SharePoint-Websitegruppen | Siehe die ACL-Berechtigungsmatrix. | Siehe die ACL-Berechtigungsmatrix. | Siehe die ACL-Berechtigungsmatrix. | Berechtigungen nach ACL-Szenario |
Berücksichtigen Sie beim Einrichten von Berechtigungen die folgenden Informationen:
- Delegierte Berechtigungen sind nur für kleine Tests geeignet und unterstützen keine ACL-Erfassung.
- Die Verbundanmeldeinformationen sind die empfohlene geheimnislose Authentifizierung. Dies umfasst sowohl die Indexerauthentifizierung als auch die SharePoint-Gruppenauflösung zur Abfragezeit.
- Wenn Sie
Sites.Selectedverwenden, gewähren Sie der App vor der Indizierung expliziten Zugriff auf jede SharePoint-Zielwebsite. Die Administratorzustimmung fürSites.Selectedin Microsoft Entra ID autorisiert die App nicht selbst für den Zugriff auf Websiteinhalte. Außerdem müssen Sie jeder Zielwebsite eine Berechtigung zuweisen. Wenn Sie der Datenquelle eine Website ohne explizite Berechtigungserteilung hinzufügen, schlägt der Indexer fehl. Siehe Gewähren von Websitezugriff bei Verwendung vonSites.Selected.
Anwendungsberechtigungen für die Datenaufnahme legen die Abfrageberechtigungen eines Endbenutzers nicht fest. In einer benutzerseitigen, berechtigungsgefilterten Anwendung authentifiziert x-ms-query-source-authorization den Aufrufer bei Search, während Authorization den Berechtigungskontext des Benutzers bereitstellt. Siehe Berechtigungsdurchsetzung zur Abfragezeit.
Ein Anwendungstoken stellt die Anwendung dar, kein angemeldeter Benutzer. Microsoft Identity Platform On-Behalf-Of-Flow unterstützt nur Benutzerprinzipale. Verwenden Sie kein Nur-App-Token als Benutzerassertion für diesen Fluss.
Unterstützte Dokumentformate
Die SharePoint in Microsoft 365 Indexer kann Text aus den folgenden Dokumentformaten extrahieren:
- CSV (siehe Indizierung von CSV-Blobs)
- EML
- EPUB
- GZ
- HTML
- JSON (siehe Indizierung von JSON-Blobs)
- KML (XML für geografische Darstellungen)
- Markdown
- Microsoft Office Formate: DOCX/DOC/DOCM, XLSX/XLSM, PPTX/PPT/PPTM, MSG (Outlook E-Mails), XML (sowohl 2003 als auch 2006 WORD XML)
- OpenDocument-Formate: ODT, ODS, ODP
- Nur-Text-Dateien (siehe auch "Nur-Text indizieren")
- RTF
- XML
- ZIP
Einschränkungen und Überlegungen
Hier sind die Einschränkungen dieses Features:
OneNote Notizbuchdateien werden nicht unterstützt.
Inkrementelle Indizierungseinschränkungen:
Durch das Umbenennen eines SharePoint Ordners wird die inkrementelle Indizierung unterbrochen. Ein umbenannter Ordner wird als neuer Inhalt behandelt.
Der Indexer kann zuvor indizierte Dokumente erneut verarbeiten, auch wenn sich der Inhalt nicht geändert hat. Dieses Verhalten ist beabsichtigt und trägt dazu bei, fehlende Änderungen zu vermeiden und die Datenintegrität beizubehalten. Eine erneute Verarbeitung kann während der Wiederherstellung nach vorübergehenden Fehlern im Quellsystem oder beim Aktualisieren von SharePoint-Metadaten in Microsoft 365 auftreten. Diese internen Ereignisse sind möglicherweise nicht über kundenorientierte Dokumenteigenschaften sichtbar.
Je nach Pipelinekonfiguration kann die Neuverarbeitung nachgeschaltete Dienste erneut aufrufen, einschließlich KI-Anreicherung und Einbettungsgenerierung. Berücksichtigen Sie diese zusätzliche Verarbeitung bei der Planung der Indizierungszeit, Kapazität und Kosten. Informationen zur Problembehandlung finden Sie unter Synchronisierungswiederholungen verstehen.
Sicherheitsbeschränkungen:
Verbindungen von Foundry IQ zu SharePoint Online verwenden öffentliche Endpunkte. SharePoint Online ist kein unterstütztes Ziel für freigegebene private Links, sodass für diese Quelle keine private ausgehende Verbindung verfügbar ist. Ihre Anwendung kann weiterhin über einen eingehenden privaten Endpunkt eine Verbindung mit Search herstellen. Siehe Eingehender und ausgehender Netzwerkdatenverkehr.
Keine Unterstützung für Mandanten mit aktiviertem Microsoft Entra ID-bedingten Zugriff.
Keine Unterstützung für vom Benutzer verschlüsselte Dateien und kennwortgeschützte ZIP-Dateien. Verschlüsselte Inhalte sind jedoch zulässig, wenn sie durch Microsoft Purview Vertraulichkeitsbezeichnungen geschützt sind und wenn die konfiguration zum Beibehalten und Berücksichtigen dieser Bezeichnungen (Vorschau) aktiviert ist.
Zugriffsberechtigungen auf Dokumentebene unterstützen eine Teilmenge des SharePoint Berechtigungsmodells. SharePoint ACL-Erfassung und -Filterung sind mit der REST-API
2026-10-01allgemein verfügbar. Ausführliche Informationen und Einrichtung finden Sie in der ACL-Konfigurationsdokumentation SharePoint. Informationen zu erforderlichen Berechtigungen pro Szenario finden Sie unter "Auswählen Ihrer Berechtigungseinrichtung".
Die Berechtigungsauflösung der SharePoint-Gruppe verfügt über einen Grenzwert von fünf Website-URL pro Index, wenn das Feld "Websitekontext" mit
sharepointSiteUrl: true"markiert" ist. Dieser Grenzwert gilt nicht für jede Berechtigungskonfiguration. Wenn Sie SharePoint-Gruppe Berechtigungen für weitere Websites benötigen, bewerten Sie separate Indizes und indizierte Wissensquellen. Siehe Planen der Topologie für SharePoint-Gruppe-Berechtigungen.Dokumentbibliotheken, Listen und moderne Seitenquellen weisen separate Standardeinstellungen für den Indizierungsbereich auf. Diese zählen ausgewählte Quellen, nicht einzelne Dateien, Listenelemente oder Seiten.
Im Folgenden finden Sie einige Überlegungen bei der Verwendung dieses Features:
Für den Abruf, ohne einen SharePoint Inhaltsindex in Foundry IQ zu erstellen, sollten Sie die Remote-SharePoint Wissensquelle (Vorschau) in Betracht ziehen. Sie verwendet die Copilot-Abruf-API, um Textinhalte aus SharePoint im Namen des Benutzers abzufragen. Vergleichen Sie diese Option mit indizierten und benutzerdefinierten Ingestionsansätzen in Architekturoptionen für SharePoint.
Wenn Sie eine benutzerdefinierte Copilot/RAG-Anwendung oder einen AI-Agent erstellen müssen, um mit SharePoint Daten in Produktionsumgebungen zu chatten, sollten Sie es zuerst direkt über Microsoft Copilot Studio erstellen. Wenn Copilot Studio Ihre Anforderungen nicht erfüllt, sollten Sie Folgendes berücksichtigen:
Erstellen eines benutzerdefinierten Connectors mit SharePoint Webhooks, Aufrufen des Microsoft Graph-API zum Exportieren von Daten in einen Azure Blob-Container und dann mithilfe des Azure Blob-Indexers für die inkrementelle Indizierung.
Erstellen Sie Ihren eigenen Azure Logic Apps Workflow, der den Azure Logic Apps SharePoint Connector und den Foundry IQ Connector verwendet. Der Foundry IQ Connector ist verfügbar, sobald er die allgemeine Verfügbarkeit erreicht. Verwenden Sie den workflow, der vom Assistenten Azure Portal als Ausgangspunkt generiert wurde, und passen Sie ihn dann im designer Azure Logic Apps an, um die erforderlichen Transformationsschritte hinzuzufügen. Der Workflow, den der Foundry IQ-Assistent erstellt, ist ein Verbrauchsworkflow. Wechseln Sie für Produktionsworkloads zu einem Standard-Logik-App-Workflow, um seine zusätzlichen Unternehmensfunktionen zu nutzen.
Unabhängig von der gewählten Vorgehensweise, ob Sie einen benutzerdefinierten Connector mit SharePoint-Webhooks erstellen oder einen Azure Logic Apps-Workflow entwickeln, sollten Sie unbedingt robuste Sicherheitsmaßnahmen implementieren. Zu diesen Maßnahmen gehören das Einrichten von Firewalls und das Beibehalten von Benutzerberechtigungen aus der Quelle und das Berücksichtigen dieser Berechtigungen zur Abfragezeit. Außerdem sollten Sie Ihre Pipeline regelmäßig prüfen und überwachen.
Für die SharePoint-ACL-Aufnahme werden Microsoft Entra-Gruppen, die in SharePoint-Gruppen geschachtelt sind, bis zu fünf Verschachtelungsebenen unterstützt. Es gilt auch ein separater Grenzwert für Sicherheitsprinzipale auf Siteebene. Siehe Unterstützte Gruppenbeziehungen für Konfigurationsanforderungen und den Grenzwert.
Indizierungstopologie planen
Für eine direkt konfigurierte Pipeline haben die Ressourcen separate Zuständigkeiten:
| Resource | Verantwortung |
|---|---|
| Microsoft Entra-App- und SharePoint-Website-Berechtigungen | Autorisieren Sie den Erfassungszugriff auf den ausgewählten Inhalt. Gewähren Sie bei Verwendung von Sites.Selected Zugriff auf jede ausgewählte Website. |
| Datenquelle | Definiert die Verbindung und wählt Websites, Bibliotheken, Listen, Seiten oder Ordner aus. Die Auswahl gewährt keinen Zugriff. |
| Indexer | Liest eine Datenquelle und benennt einen Zielindex in targetIndexName. Die Auswahl mehrerer Websites erstellt nicht automatisch mehrere Zielindizes. |
| Suchindex | Definiert die Felder und speichert durchsuchbare Inhalte, Metadaten und alle Berechtigungsfelder, die zum Abrufen verwendet werden. |
| Wissensquelle für den Suchindex und Wissensbasis | Optionalerweise können Sie den befüllten Index für den agentischen Abruf verfügbar machen. Diese Abrufressourcen ersetzen nicht die Indizierungskonfiguration oder die Dokumentberechtigungen des Benutzers. |
Zum Beispiel:
| Szenario | Ressourcenanordnung |
|---|---|
| Eine Website mit mehreren Bibliotheken oder Ordnern | Wählen Sie die erforderlichen Bibliotheken oder Ordner in einer Datenquelle aus, und verwenden Sie einen Indexer, wenn der Inhalt ein Zielschema und verarbeitungsanforderungen frei gibt. |
| Ausgewählte Websites B und C mit Standardendpunkt A | Verwenden Sie die standortübergreifende Abfragekonfiguration, gewähren Sie Zugriff auf B und C, und schreiben Sie über einen Indexer in einen Zielindex. Behalten Sie den Kontext der Ursprungswebsite bei, wenn die Berechtigungsfilterung dies erfordert. |
| Inhalte, die separate Schemas, Verarbeitungszeitpläne oder Governance erfordern | Verwenden Sie separate Indizierungspipelinen und Indizes. Stellen Sie für den agentischen Abruf jeden Index über eine Suchindex-Wissensquelle zur Verfügung und weisen Sie die Quellen einer Wissensbasis unter Beachtung der Grenzen der Wissensbasis zu. |
Die einzelne targetIndexName eines Indexers unterscheidet sich von Indexprojektionen, die angereicherte untergeordnete Dokumente an andere Indizes senden können. Jeder durchsuchbare Block muss die erforderlichen Berechtigungsfelder und den Ursprünglichen Websitekontext beibehalten. Befolgen Sie die ACL-Zuordnungs- und Projektionsanleitungen.
Das Hinzufügen von Indexern, die in denselben Index schreiben, erhöht nicht die Website-URL-Grenze der SharePoint-Gruppe. Verwenden Sie die vorhandene Anleitung zur Partitionierung für diesen Berechtigungsfluss.
Wenn Sie die vom Dienst verwaltete Erfassung bevorzugen, erstellen Sie eine indizierte SharePoint Wissensquelle, anstatt diese Indizierungsressourcen einzeln zu konfigurieren. Informationen zu Architektur- und Verantwortungsoptionen finden Sie unter SharePoint Architekturoptionen.
Konfigurieren Sie den "SharePoint in Microsoft 365"-Indexierungstool
Verwenden Sie die REST-API 2026-10-01, um den SharePoint-Indexer in Microsoft 365 zu konfigurieren.
(Optional) Schritt 1: Aktivieren einer vom System zugewiesenen verwalteten Identität
Aktivieren Sie eine vom System zugewiesene verwaltete Identität, um den Microsoft Entra Mandanten, in dem der Foundry IQ-Dienst bereitgestellt wird, automatisch zu erkennen.
Führen Sie diesen Schritt aus, wenn sich die SharePoint-Website und der Foundry IQ-Dienst im selben Microsoft Entra-Mandanten befinden. Überspringen Sie diesen Schritt, wenn sie sich in unterschiedlichen Microsoft Entra Tenants befinden. Die Identität wird für die Mandantenerkennung verwendet. Sie können diesen Schritt auch überspringen, wenn Sie die Microsoft Entra Mandanten-ID in die Verbindungszeichenfolge einfügen möchten. Um die vom System zugewiesene oder vom Benutzer zugewiesene verwaltete Identität für die geheime Indizierung zu verwenden, konfigurieren Sie die Anwendungsberechtigungen mit geheimer Authentifizierung.
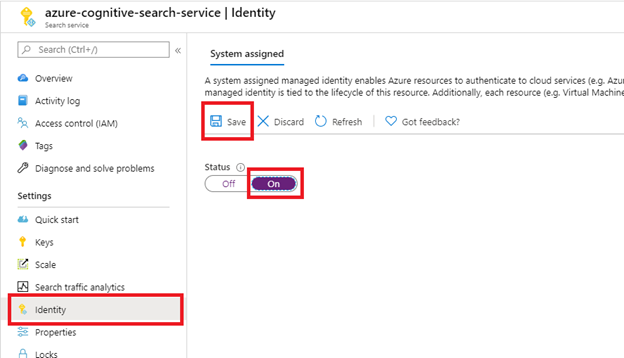
Nachdem Sie "Speichern" ausgewählt haben, erhalten Sie eine Objekt-ID, die Ihrem Foundry IQ-Dienst zugewiesen ist.
Schritt 2: Entscheiden, welche Berechtigungen der Indexer benötigt
Die Entscheidungsmatrix, die ACL- und Nicht-ACL-Szenarien abdeckt, finden Sie unter "Auswählen Ihrer Berechtigungseinrichtung". Wenn Sie delegierte Berechtigungen auswählen, laufen benutzerdelegierte Token alle 75 Minuten ab und erfordern eine manuelle Indizierung mithilfe von Run Indexer , wenn sie ablaufen. Delegierte Berechtigungen werden nur für kleine Testvorgänge empfohlen.
Schritt 3: Erstellen einer Microsoft Entra Anwendungsregistrierung
Die SharePoint in Microsoft 365 Indexer verwendet eine Microsoft Entra Anwendung für die Authentifizierung. Erstellen Sie die Anwendungsregistrierung, bevor Sie ihre Berechtigungen und Anmeldeinformationen konfigurieren.
Melden Sie sich beim portal Azure an.
Suchen oder navigieren Sie zu Microsoft Entra ID.
Wählen Sie auf der Seite "Übersicht" die Option +App-Registrierung hinzufügen> aus.
- Geben Sie einen Namen für Ihre App ein.
- Wählen Sie Nur einzelner Mandant – Mandantenname aus.
- Überspringen Sie den URI-Benennungsschritt. Es ist kein Umleitungs-URI erforderlich.
- Wählen Sie "Registrieren" aus.
Wählen Sie im linken Bereich"API-Berechtigungen>" aus.
Wählen Sie +Berechtigung hinzufügen und dann Microsoft Graph aus.
Wenn Ihr Indexer Anwendungs-API-Berechtigungen verwendet, wählen Sie Anwendungsberechtigungen aus.
Wählen Sie für die Standardindizierung Folgendes aus:
Files.Read.AllSites.Read.All
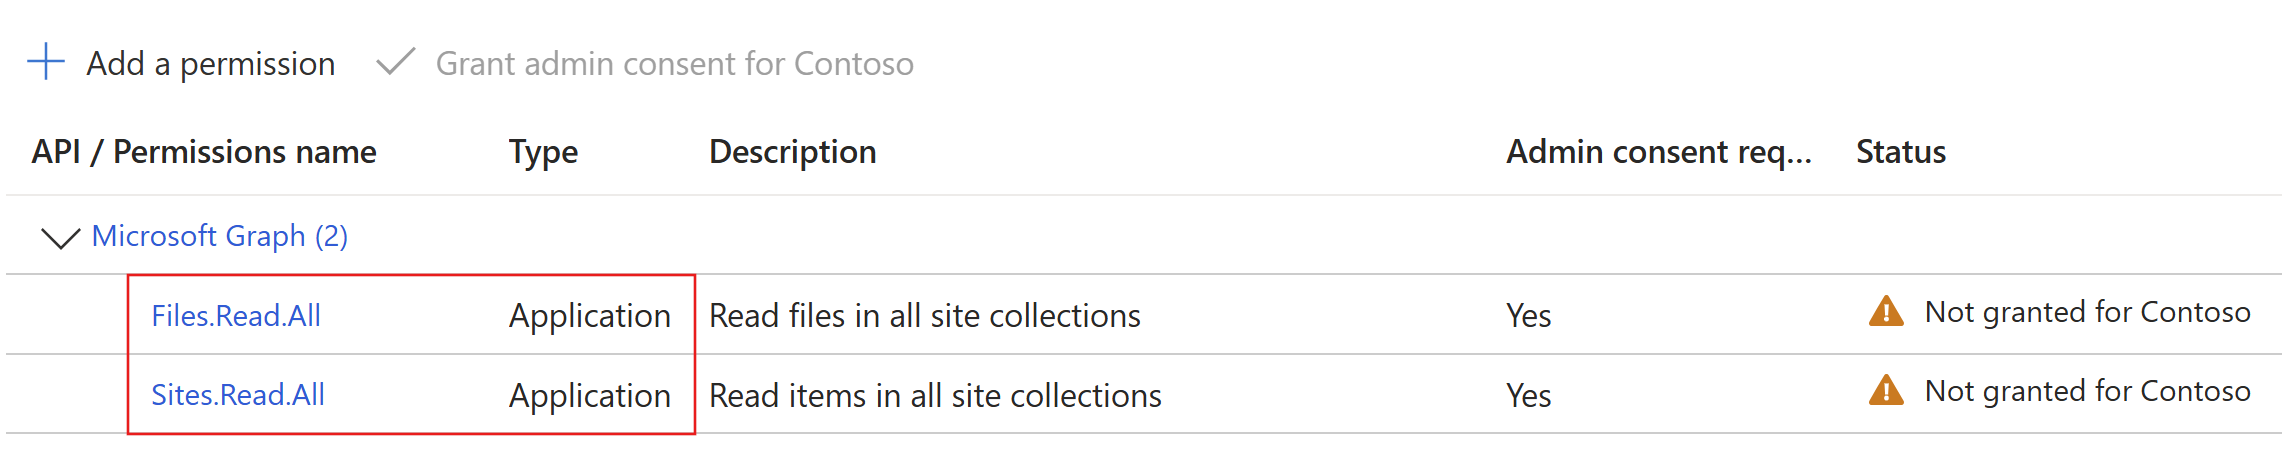
Wenn Sie die ACL-Erfassung aktivieren, hängen die erforderlichen Berechtigungen davon ab, welche Elementtypen (Dokumentbibliotheksdateien, Listenelemente, ASPX-Seiten) und Gruppentypen (Microsoft Entra vs. SharePoint Websitegruppen) sie indiziert haben. Bevor Sie diesen Schritt abschließen, lesen Sie das Szenario „Berechtigungen nach ACL“. Die Szenarioübergreifende Zusammenfassung finden Sie unter "Auswählen Ihrer Berechtigungseinrichtung".
Die Verwendung von Anwendungsberechtigungen bedeutet, dass der Indexer auf die SharePoint Website in einem Dienstkontext zugreift. Wenn Sie den Indexer ausführen, hat er daher Zugriff auf alle Inhalte im SharePoint Mandanten, was eine Genehmigung des Mandantenadministrators erfordert. Für die Authentifizierung ist zudem ein geheimer Clientschlüssel oder eine Konfiguration ohne geheimen Schlüssel erforderlich. Das Einrichten des Authentifizierungsmechanismus wird weiter unten in diesem Artikel unter "Verfügbare Authentifizierungsmethoden" nur für Anwendungs-API-Berechtigungen beschrieben.
Wenn Ihr Indexer delegierte API-Berechtigungen verwendet, wählen Sie delegierte Berechtigungen aus, und wählen Sie dann Folgendes aus:
Files.Read.AllSites.Read.AllUser.Read
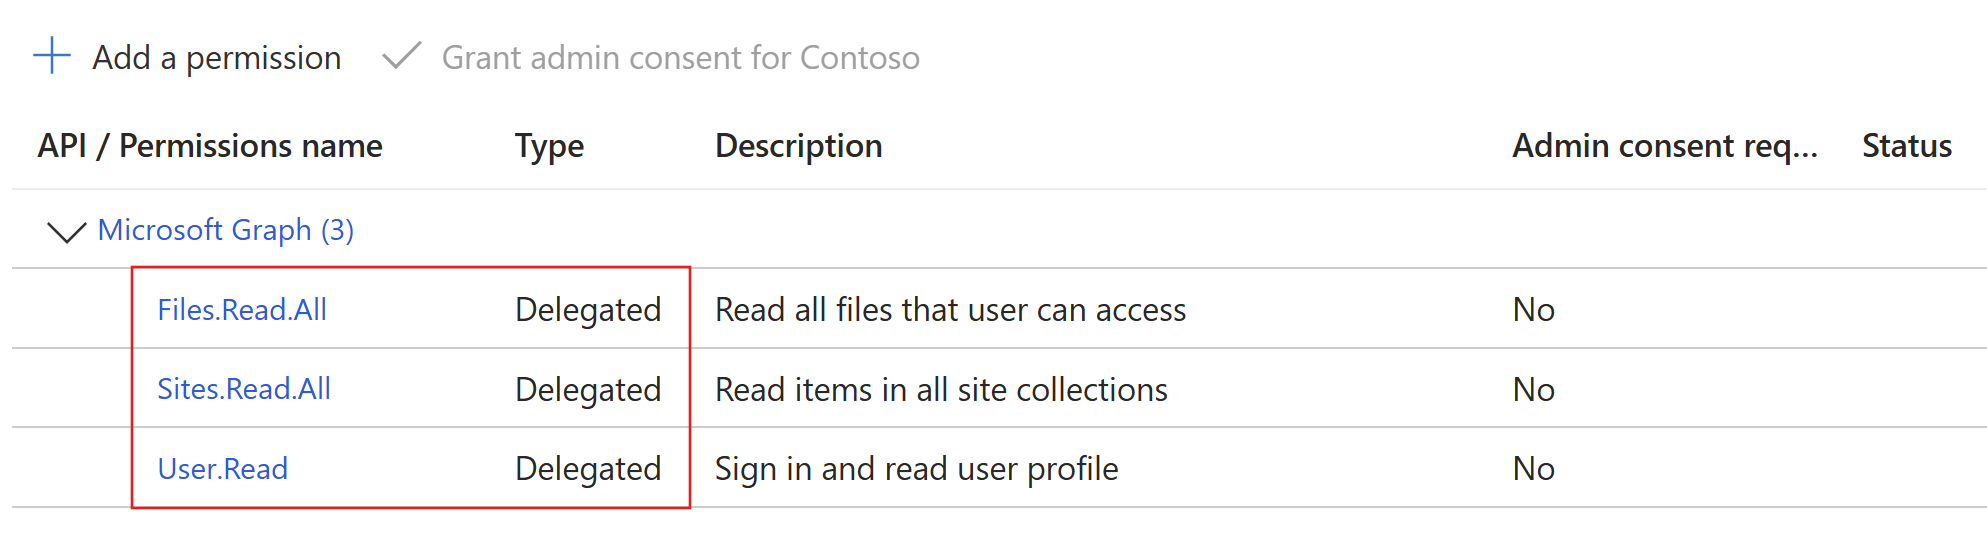
Delegierte Berechtigungen ermöglichen es dem Suchclient, eine Verbindung mit SharePoint unter der Sicherheitsidentität des aktuellen Benutzers herzustellen.
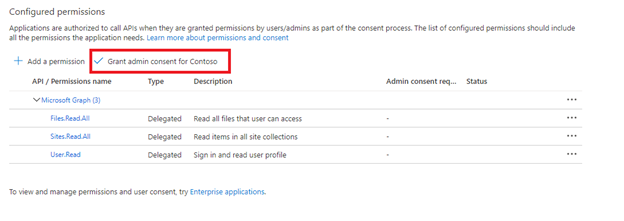
Wählen Sie Administratorzustimmung erteilen für Mandantenname aus.
Die Zustimmung des Mandantenadministrators ist erforderlich, wenn Anwendungs-API-Berechtigungen verwendet werden. Einige Mandanten sind so gesperrt, dass die Zustimmung des Mandantenadministrators auch für delegierte API-Berechtigungen erforderlich ist. Wenn eine der Bedingungen zutrifft, muss ein Mandantenadministrator die Zustimmung für diese Microsoft Entra Anwendung erteilen, bevor der Indexer erstellt wird.
Wählen Sie im linken Bereich Verwalten>Authentifizierung (Vorschau) aus.
Wählen Sie auf der Registerkarte " Umleitungs-URI-Konfiguration " die Option +Umleitungs-URI hinzufügen aus.
- Wählen Sie Mobile- und Desktopanwendungen aus.
- Wählen Sie den Umleitungs-URI
https://login.microsoftonline.com/common/oauth2/nativeclientaus. - Wählen Sie "Konfigurieren" aus.
Aktivieren Sie auf der Registerkarte "Einstellungen " den Umschalter " Öffentliche Clientflüsse zulassen ", und wählen Sie dann " Speichern" aus.
Konfigurieren Sie die Indexerauthentifizierungsmethode entsprechend Ihren Lösungsanforderungen.
Zugriff auf die Website gewähren, wenn Sites.Selected verwendet wird
Wenn Sie die App-Registrierung mit Sites.Selectedkonfigurieren, führen Sie die folgenden Schritte aus, bevor Sie den Indexer ausführen. Die Administratorzustimmung für Sites.Selected in Microsoft Entra ID erlaubt der App nur, bereichsbezogene SharePoint Berechtigungen zu verwenden. Es gewährt keinen Zugriff auf Websites, solange Sie nicht separat eine Website-Berechtigung zuweisen.
In Microsoft Entra ID: Zur App-Registrierung hinzufügen
Sites.Selectedund Administratorzustimmung erteilen. Fügen Sie die Berechtigung unter der API-Oberfläche hinzu, die Ihr Szenario erfordert, z. B. Microsoft Graph und für ACL-Aufnahmeszenarien, SharePoint.In SharePoint: Weisen Sie der App eine Berechtigungsrolle auf jeder Zielwebsite zu. Erteilen Sie für die Indizierung von Inhalten mindestens Lesezugriff.
Um der Website eine Berechtigung zu erteilen, verwenden Sie Microsoft Graph. Ersetzen Sie
{siteId}durch Ihre Site-ID:POST https://graph.microsoft.com/v1.0/sites/{siteId}/permissions Content-Type: application/json { "roles": ["read"], "grantedToIdentities": [ { "application": { "id": "<application-client-id>", "displayName": "<application-display-name>" } } ] }Um die gleiche Berechtigung mithilfe von PnP PowerShell zu erteilen:
Grant-PnPEntraIDAppSitePermission `
  -AppId "<application-client-id>" `
  -DisplayName "<application-display-name>" `
  -Site "https://<tenant>.sharepoint.com/sites/<site-name>" `
  -Permissions Read
Verfügbare Authentifizierungsmethoden nur für Anwendungs-API-Berechtigungen
Um die Microsoft Entra Anwendung mit Anwendungsberechtigungen zu authentifizieren, verwendet der Indexer entweder ein Clientgeheimnis oder eine geheimnislose Konfiguration.
Verwenden des geheimen Clientschlüssels
Diese Anweisungen konfigurieren die Anwendung so, dass ein geheimer Clientschlüssel verwendet wird, um den Indexer zu authentifizieren, sodass sie Daten aus SharePoint aufnehmen kann.
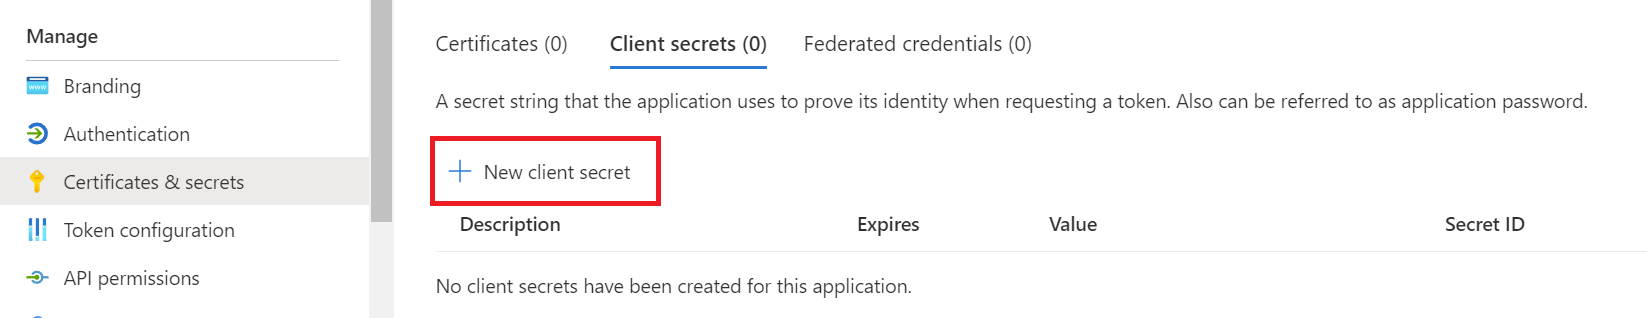
Wählen Sie "Zertifikate und Geheime Schlüssel" im Menü auf der linken Seite und dann " Geheime Clientschlüssel " und " Neuer geheimer Clientschlüssel" aus.
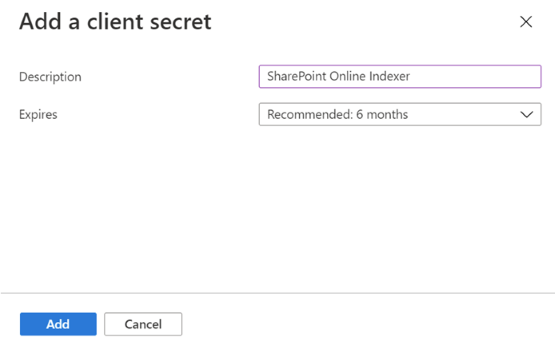
Geben Sie im Popupmenü eine Beschreibung für den neuen geheimen Clientschlüssel ein. Passen Sie das Ablaufdatum bei Bedarf an. Wenn der geheime Schlüssel abläuft, müssen Sie ihn neu erstellen und den Indexer mit dem neuen geheimen Schlüssel aktualisieren.
Der neue geheime Clientschlüssel wird in der Geheimnisliste angezeigt. Sobald Sie von der Seite weg navigieren, ist der geheime Schlüssel nicht sichtbar. Kopieren Sie den Wert daher mithilfe der Schaltfläche "Kopieren", und speichern Sie ihn an einem sicheren Speicherort.

Verwenden der geheimlosen Authentifizierung zum Abrufen von Anwendungstoken
Verwenden Sie Verbundanmeldeinformationen, um sich ohne einen geheimen Clientschlüssel anzumelden. Microsoft Entra vertraut einer verwalteten Identität, um ein Anwendungstoken abzurufen, sodass der Indexer Daten aus SharePoint ohne ein gespeichertes Geheimnis erfassen kann. Der nächste Abschnitt führt Sie durch die Konfiguration einer verwalteten Identität.
Konfigurieren der registrierten Anwendung mit einer verwalteten Identität
Erstellen (oder wählen) Sie je nach Ihren Szenarioanforderungen entweder eine vom Benutzer zugewiesene verwaltete Identität, und weisen Sie sie Ihrem Foundry IQ-Dienst zu oder eine vom System zugewiesene verwaltete Identität.
Erfassen Sie die Objekt-ID (Prinzipal-ID). Verwenden Sie diesen Wert als Teil der Anmeldeinformationenkonfiguration, wenn Sie die Datenquelle erstellen.
Wählen Sie im Menü auf der linken Seite Zertifikate und Geheimnisse aus.
Wählen Sie unter Verbundanmeldeinformationendie Option +Anmeldeinformationen hinzufügen aus.
Wählen Sie unter „Verbundanmeldeinformationen“ die Option „Verwaltete Identität“ aus.
Wählen Sie verwaltete Identität aus: Wählen Sie die verwaltete Identität aus, die in Schritt 1 erstellt wurde.
Fügen Sie einen Namen für Ihre Anmeldeinformationen hinzu, und wählen Sie "Speichern" aus.
Schritt 4: Erstellen einer Datenquelle
Verwenden Sie einen REST-Client mit API-Version 2026-10-01 für die verbleibenden Schritte.
Eine Datenquelle gibt an, welche Daten indiziert werden sollen, Anmeldeinformationen und Richtlinien, um Änderungen in den Daten effizient zu identifizieren (neue, geänderte oder gelöschte Zeilen). Mehrere Indexer im gleichen Foundry IQ-Dienst können dieselbe Datenquelle verwenden.
Für SharePoint Indizierung muss die Datenquelle über die folgenden erforderlichen Eigenschaften verfügen:
- Name ist der eindeutige Name der Datenquelle innerhalb Ihres Foundry IQ-Diensts.
- type muss "sharepoint" sein. Bei diesem Wert wird die Groß-/Kleinschreibung beachtet.
-
Anmeldeinformationen stellen den SharePoint Endpunkt und die Authentifizierungsmethode bereit, die für die Anwendung zulässig ist, um die Microsoft Entra Token anzufordern. Ein Beispiel SharePoint Endpunkts ist
https://[your-tenant-name].sharepoint.com/teams/MySharePointSite. Sie können den Endpunkt abrufen, indem Sie zur Startseite Ihrer SharePoint Website navigieren und die URL aus dem Browser kopieren. Überprüfen Sie das format Verbindungszeichenfolge für die unterstützte Syntax. - Container wählt die Dokumentbibliotheken, Listen oder Websiteseiten aus, die indiziert werden sollen. Die Eigenschaften steuern, welche Dokumente indiziert werden.
Rufen Sie zum Erstellen einer Datenquelle "Datenquelle erstellen" auf.
Hier ist ein Beispiel für eine Datenquellendefinition für Anmeldeinformationen mit einem Anwendungsgeheimnis oder einer systemseitig zugewiesenen verwalteten Identität.
POST https://[service name].search.windows.net/datasources?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
    "name" : "sharepoint-datasource",
    "type" : "sharepoint",
    "credentials" : { "connectionString" : "[connection-string]" },
    "container" : { "name" : "defaultSiteLibrary", "query" : null }
}
Konfigurationen für Verbundanmeldeinformationen erfordern FederatedCredentialApplicationId in der Verbindungszeichenfolge. Der Wert unterscheidet sich je nach Identitätstyp:
-
Vom System zugewiesene verwaltete Identität:
FederatedCredentialApplicationIdauf die Anwendungs-ID (Client-ID) der dem Dienst vom System zugewiesenen verwalteten Identität festlegen. Lassen Sie denidentityBlock weg. -
Vom Benutzer zugewiesene verwaltete Identität: Geben Sie den
identityBlock mit dem vom Benutzer zugewiesenen Verwalteten Identitätsressourcenpfad an. Legen SieFederatedCredentialApplicationIdauf die eigene Anwendungs-ID (Client-ID) der vom Benutzer zugewiesenen verwalteten Identität fest.
Hinweis
ApplicationId und FederatedCredentialApplicationId sind unterschiedliche Werte.
ApplicationId ist Ihre registrierte Entra-Ingestions-App, die die SharePoint-Berechtigungen enthält.
FederatedCredentialApplicationId ist die Anwendungs-ID (Client-ID) der verwalteten Identität selbst, bei der es sich um die Entität handelt, deren Token die Identität der verwalteten Identität beweist.
POST https://[service name].search.windows.net/datasources?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
    "name" : "sharepoint-datasource",
    "type" : "sharepoint",
    "credentials" : { "connectionString" : "[connection-string]" },
    "container" : { "name" : "defaultSiteLibrary", "query" : null },
    "identity": {
      "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity",
      "userAssignedIdentity": "/subscriptions/[Azure subscription ID]/resourceGroups/[resource-group]/providers/Microsoft.ManagedIdentity/userAssignedIdentities/[user-assigned managed identity]"
    }
}
Verbindungszeichenfolgenformat
Das Format der Verbindungszeichenfolge ändert sich basierend darauf, ob der Indexer delegierte API-Berechtigungen oder Anwendungs-API-Berechtigungen verwendet.
Format der Verbindungszeichenfolge für delegierte API-Berechtigungen
SharePointOnlineEndpoint=[SharePoint site URL];ApplicationId=[Microsoft Entra application ID];TenantId=[SharePoint site's Microsoft Entra tenant ID]Anwendungs-API-Berechtigungen mit Anwendungsgeheimnis-Verbindungszeichenfolgenformat
SharePointOnlineEndpoint=[SharePoint site URL];ApplicationId=[Microsoft Entra application ID];ApplicationSecret=[Microsoft Entra application client secret];TenantId=[SharePoint site's Microsoft Entra tenant ID]API-Berechtigungen für Anwendungen mit Verbindungszeichenfolgenformat ohne Geheimnis (Verbundidentitäts-Anmeldeinformationen):
SharePointOnlineEndpoint=[SharePoint site URL];ApplicationId=[Microsoft Entra application ID];FederatedCredentialApplicationId=[managed identity's application (client) ID];TenantId=[SharePoint site's Microsoft Entra tenant ID]
In der folgenden Tabelle werden die einzelnen Verbindungszeichenfolge Felder beschrieben.
| Feld | Erforderlich | Beschreibung |
|---|---|---|
SharePointOnlineEndpoint |
Ja | Standardmäßige SharePoint Website-URL (z. B., https://[your-tenant-name].sharepoint.com). Ein useQuery Container kann andere Websites im selben Mandanten auswählen. Siehe Auswählen von Inhalten von anderen Websites. |
ApplicationId |
Ja | Microsoft Entra Anwendungs-ID (Client-ID) der Erfassungs-App. Muss eine gültige GUID sein. |
TenantId |
Fakultativ | Microsoft Entra Mandanten-ID (GUID) für den Mandanten, der die SharePoint-Website besitzt. Dieser Mandant ist nicht unbedingt der Microsoft Entra-Mandant, der dem Foundry IQ-Dienst zugeordnet ist. Erforderlich, wenn sich die SharePoint-Website und der Foundry IQ-Dienst in verschiedenen Microsoft Entra-Tenants befinden. |
ApplicationSecret |
Conditional | Geheimer Clientschlüssel der Erfassungs-App. Wird für die geheime Authentifizierung verwendet. |
FederatedCredentialApplicationId |
Bedingt (Verbundidentitätsanmeldeinformationen) | Microsoft Entra Anwendungs-ID (Client-ID), die zum Überprüfen der verwalteten Identität verwendet wird. Muss eine gültige GUID sein. Verwenden Sie für eine vom System zugewiesene verwaltete Identität die Anwendungs-ID (Client-ID) der Identität. Verwenden Sie für eine vom Benutzer zugewiesene verwaltete Identität die eigene Anwendungs-ID (Client-ID). Verwenden Sie für eine mandantenübergreifende benutzerseitig zugewiesene verwaltete Identität mit federatedIdentityClientId, die im Block identity festgelegt ist, die Client-ID der mandantenübergreifenden App. |
Wichtig
FederatedCredentialApplicationId und ApplicationSecret schließen sich gegenseitig aus. Verbindungszeichenfolgen, die sie kombinieren, werden beim Erstellen oder Aktualisieren der Datenquelle abgelehnt.
Berücksichtigen Sie beim Einrichten von Berechtigungen die folgenden Informationen:
Aus Gründen der Abwärtskompatibilität akzeptiert der SharePoint Indexer weiterhin
FederatedCredentialObjectId(die Objekt-/Prinzipal-ID der Verbundidentitätsanmeldeinformationen für die Aufnahme-App) in der Verbindungszeichenfolge, sodass vorhandene Datenquellen ohne Änderungen funktionieren. Verwenden SieFederatedCredentialApplicationIdfür neue und aktualisierte Datenquellen.
Um TenantId abzurufen, öffnen Sie das Microsoft Entra Admin Center für den Mandanten, zu dem die SharePoint-Website gehört, und kopieren Sie die Mandanten-ID aus Übersicht.
Sie können die verwaltete Identität object (principal) ID aus dem Abschnitt "Konfigurieren der registrierten Anwendung mit verwalteter Identität " abrufen.
Berücksichtigen Sie beim Einrichten von Berechtigungen die folgenden Informationen:
Wenn sich der SharePoint-Standort und der Foundry IQ-Dienst im selben Microsoft Entra Mandanten befinden und die vom System zugewiesene verwaltete Identität aktiviert ist, müssen Sie
TenantIdin der Verbindungszeichenfolge nicht einschließen. Wenn sie sich in unterschiedlichen Microsoft Entra-Mandanten befinden, müssen SieTenantIdeinschließen.
Die folgenden Beispiele zeigen Datenquellen, die mit FederatedCredentialApplicationId erstellt wurden:
Vom System zugewiesene verwaltete Identität mit Verbundanmeldeinformationen:
POST https://[service name].search.windows.net/datasources?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
  "name": "sharepoint-ds",
  "type": "sharepoint",
  "credentials": {
    "connectionString": "SharePointOnlineEndpoint=https://[your-tenant-name].sharepoint.com;ApplicationId=[Microsoft Entra application ID];TenantId=[SharePoint site's Microsoft Entra tenant ID];FederatedCredentialApplicationId=[system-assigned managed identity's application (client) ID]"
  },
  "container": { "name": "defaultSiteLibrary" }
}
Vom Benutzer zugewiesene verwaltete Identität mit Verbundanmeldeinformationen (Single-Tenant):
{
  "name": "sharepoint-uami-fed",
  "type": "sharepoint",
  "credentials": {
    "connectionString": "SharePointOnlineEndpoint=https://[your-tenant-name].sharepoint.com;ApplicationId=[Microsoft Entra application ID];TenantId=[SharePoint site's Microsoft Entra tenant ID];FederatedCredentialApplicationId=[user-assigned managed identity application (client) ID]"
  },
  "container": { "name": "defaultSiteLibrary" },
  "identity": {
    "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/[subscription-id]/resourceGroups/[resource-group]/providers/Microsoft.ManagedIdentity/userAssignedIdentities/[uami-name]"
  }
}
Hinweis
Bei einer vom Benutzer zugewiesenen verwalteten Identität muss FederatedCredentialApplicationId der Anwendungs-ID (Client-ID) der vom Benutzer zugewiesenen verwalteten Identität entsprechen, nicht der ID der Erfassungs-App (ApplicationId). Wenn Sie den identity Block weglassen, greift der Indexer auf die vom System zugewiesene verwaltete Identität zurück.
Mandantenübergreifende, vom Benutzer zugewiesene verwaltete Identität mit Verbundanmeldeinformationen (erweitert):
Bevor Sie diese Konfiguration verwenden, stellen Sie sicher, dass Ihre vom Benutzer zugewiesene verwaltete Identität mit einer Verbundidentitäts-Anmeldeinformation konfiguriert ist, die der Multiinstanzen-Microsoft Entra-App vertraut. Schritte zum Einrichten finden Sie unter Konfigurieren der registrierten Anwendung mit einer verwalteten Identität.
{
  "name": "sharepoint-uami-crosstenantfed",
  "type": "sharepoint",
  "credentials": {
    "connectionString": "SharePointOnlineEndpoint=https://[your-tenant-name].sharepoint.com;ApplicationId=[Microsoft Entra application ID];TenantId=[SharePoint site's Microsoft Entra tenant ID];FederatedCredentialApplicationId=[multitenant app client ID]"
  },
  "container": { "name": "defaultSiteLibrary" },
  "identity": {
    "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity",
    "userAssignedIdentity": "/subscriptions/[subscription-id]/resourceGroups/[resource-group]/providers/Microsoft.ManagedIdentity/userAssignedIdentities/[uami-name]",
    "federatedIdentityClientId": "[multi-tenant app client ID]"
  }
}
Verwenden Sie die mandantenübergreifende, vom Benutzer zugewiesene verwaltete Identitätskonfiguration, wenn die vom Benutzer zugewiesene verwaltete Identität selbst mit einer mehrinstanzenfähigen Microsoft Entra App verbunden ist. Legen Sie in diesem Fall federatedIdentityClientId im Block identity auf die Client-ID der Multitenant-App fest, und legen Sie FederatedCredentialApplicationId in der Verbindungszeichenfolge auf die Client-ID derselben Multitenant-App fest. Wenn FederatedCredentialApplicationId in diesem Szenario auf die eigene Client-ID der benutzerseitig zugewiesenen verwalteten Identität festgelegt wird, schlägt die Validierung fehl.
Wenn Ihr Indexer SharePoint ACL-Konfiguration verwendet oder Microsoft Purview Vertraulichkeitsbezeichnungen (Vorschau) bewahrt und berücksichtigt, lesen Sie die zugehörigen Artikel, bevor Sie den Indexer erstellen. Jedes Feature verfügt über spezifische Konfigurationsschritte für Datenquellen, Index und Skillset.
Schritt 5: Erstellen eines Indexes
Der Index gibt die Felder in einem Dokument, Attributen und anderen Konstrukten an, die die Suchoberfläche bilden.
Rufen Sie zum Erstellen eines Indexes " Index erstellen" auf:
POST https://[service name].search.windows.net/indexes?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
    "name" : "sharepoint-index",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "metadata_spo_item_name", "type": "Edm.String", "key": false, "searchable": true, "filterable": false, "sortable": false, "facetable": false },
        { "name": "metadata_spo_item_path", "type": "Edm.String", "key": false, "searchable": false, "filterable": false, "sortable": false, "facetable": false },
        { "name": "metadata_spo_item_content_type", "type": "Edm.String", "key": false, "searchable": false, "filterable": true, "sortable": false, "facetable": true },
        { "name": "metadata_spo_item_last_modified", "type": "Edm.DateTimeOffset", "key": false, "searchable": false, "filterable": false, "sortable": true, "facetable": false },
        { "name": "metadata_spo_item_size", "type": "Edm.Int64", "key": false, "searchable": false, "filterable": false, "sortable": false, "facetable": false },
        { "name": "content", "type": "Edm.String", "searchable": true, "filterable": false, "sortable": false, "facetable": false }
    ]
}
Wichtig
Das Schlüsselfeld in einem Index, der vom SharePoint in Microsoft 365 Indexer ausgefüllt wird, hängt vom Containertyp in der Datenquelle ab:
- Verwenden Sie für Inhalte der Dokumentbibliothek (
defaultSiteLibrary,allSiteLibrariesoderuseQuerymit Bibliotheks- oder Ordnerfiltern)metadata_spo_site_library_item_id. Wenn in der Datenquelle kein Schlüsselfeld vorhanden ist,metadata_spo_site_library_item_idwird das Schlüsselfeld automatisch zugeordnet. - Verwenden Sie
allSiteListsfür Listen-, Seiten- oder gemischten Inhalt (allSitePages,allSiteContentodermetadata_spo_site_asset_item_id) . Die automatische Zuordnung gilt nicht für dieses Feld. Definieren Sie einen explizitenfieldMappingsEintrag, dermetadata_spo_site_asset_item_idIhrem Indexschlüsselfeld zuordnet.
Wenden Sie die Zuordnungsfunktion base64Encode an, wenn Sie diese Schlüsselfelder ihrem Indexfeld id zuordnen.
Schritt 6: Erstellen eines Indexers
Ein Indexer verbindet eine Datenquelle mit einem Zielsuchindex und bietet einen Zeitplan zum Automatisieren der Datenaktualisierung. Nachdem Sie die Datenquelle und den Index erstellt haben, erstellen Sie den Indexer.
So erstellen Sie den Indexer:
Senden einer Create Indexer-Anforderung :
POST https://[service name].search.windows.net/indexers?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
    "name" : "sharepoint-indexer",
    "dataSourceName" : "sharepoint-datasource",
    "targetIndexName" : "sharepoint-index",
    "parameters": {
    "batchSize": null,
    "maxFailedItems": null,
    "maxFailedItemsPerBatch": null,
    "configuration": {
        "indexedFileNameExtensions" : ".pdf, .docx",
        "excludedFileNameExtensions" : ".png, .jpg",
        "dataToExtract": "contentAndMetadata"
      }
    },
    "fieldMappings" : [
        {
          "sourceFieldName" : "metadata_spo_site_library_item_id",
          "targetFieldName" : "id",
          "mappingFunction" : {
            "name" : "base64Encode"
          }
         }
    ]
}
Für Datenquellen, die die Containerwerte
allSiteLists,allSitePagesoderallSiteContentverwenden, ordnen Siemetadata_spo_site_asset_item_idstattmetadata_spo_site_library_item_idzu.Das Beispiel für die Dokumentbibliothek enthält nur
.pdfund.docxDateien. Passen Sie die Dateitypfilter an den Inhalt an, den Sie indizieren möchten.Wenn Sie Anwendungsberechtigungen verwenden, können Sie den Index abfragen, während die anfängliche Indizierung ausgeführt wird, aber nur Elemente, die bereits indizierte Ergebnisse zurückgeben. Warten Sie, bis die Ausführung abgeschlossen wurde, um die vollständige Abdeckung zu gewährleisten. Die restlichen Anweisungen in diesem Schritt gelten nur für delegierte Berechtigungen.
Wenn Sie den Indexer zum ersten Mal erstellen, wartet die Create Indexer-Anforderung , bis Sie den nächsten Schritt abgeschlossen haben. Sie müssen "Indexerstatus abrufen " aufrufen, um den Link abzurufen und den neuen Gerätecode einzugeben.
GET https://[service name].search.windows.net/indexers/sharepoint-indexer/status?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]
Wenn Sie den Indexerstatus nicht innerhalb von 10 Minuten aufrufen, läuft der Code ab, und Sie müssen die Datenquelle neu erstellen.
Kopieren Sie den Geräteanmeldungscode aus der Antwort "Indexerstatus abrufen ". Der Geräteanmeldungscode befindet sich in der "errorMessage".
{
    "lastResult": {
        "status": "transientFailure",
        "errorMessage": "To sign in, use a web browser to open the page https://microsoft.com/devicelogin and enter the code <CODE> to authenticate."
    }
}
Geben Sie den Code ein, der in der Fehlermeldung enthalten war.
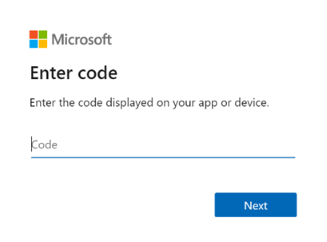
Die SharePoint in Microsoft 365 Indexer greift als angemeldeter Benutzer auf den SharePoint Inhalt zu. Der Benutzer, der sich während dieses Schritts anmeldet, ist der angemeldete Benutzer. Wenn Sie sich also mit einem Benutzerkonto anmelden, das keinen Zugriff auf ein Dokument in der Dokumentbibliothek hat, das Sie indizieren möchten, hat der Indexer keinen Zugriff auf dieses Dokument.
Erstellen Sie nach Möglichkeit ein neues Organisationsbenutzerkonto, und erteilen Sie ihm die genauen Berechtigungen, über die der Indexer verfügen soll.
Genehmigen Sie die angeforderten Berechtigungen.
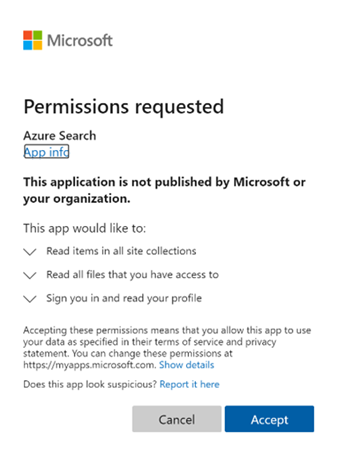
Die anfängliche Anforderung Create Indexer wird abgeschlossen, wenn alle zuvor bereitgestellten Berechtigungen korrekt sind und innerhalb des 10-Minuten-Zeitrahmens liegen.
Berücksichtigen Sie beim Einrichten von Berechtigungen die folgenden Informationen:
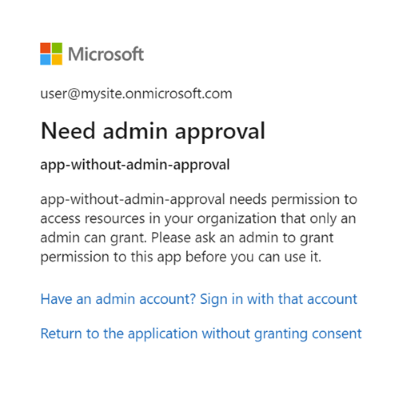
Wenn die Microsoft Entra Anwendung eine Administratorgenehmigung erfordert und vor der Anmeldung nicht genehmigt wurde, wird möglicherweise der folgende Bildschirm angezeigt. Die Administratorgenehmigung ist erforderlich, um den Vorgang fortzusetzen.
Schritt 7: Überprüfen des Indexerstatus
Rufen Sie nach dem Erstellen des Indexers Get Indexer Status auf:
GET https://[service name].search.windows.net/indexers/sharepoint-indexer/status?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]
Überprüfen Sie in lastResult den status, die endTime, itemsProcessed und itemsFailed der neuesten Ausführung. Überprüfen Sie die Fehler und Warnungen, auch wenn die Ausführung als erfolgreich gemeldet wird. Der Indexerstatus running der obersten Ebene bedeutet, dass der Indexer zur Ausführung verfügbar ist und nicht, dass derzeit eine Ausführung ausgeführt wird. Siehe Ausführung des Indexers überwachen.
Verwenden Sie nach Abschluss der Ausführung die folgende Abfrage, um einen Index ohne Berechtigungsfilterung auf Dokumentebene zu prüfen:
GET https://[service-name].search.windows.net/indexes/[index-name]/docs?search=*&$count=true&api-version=2026-10-01
api-key: [admin-api-key]
Folgen Sie für einen Index mit aktivierten Berechtigungen stattdessen den Prüfungen zur Berechtigungserfassung. Verwenden Sie eine autorisierte Abfrage mit erhöhten Leseberechtigungen , um geschützte Inhalte zu prüfen. Ein Administratorschlüssel allein gibt keine ACL-geschützten Inhalte zurück.
Überprüfen Sie die Metadaten und Die Metadaten eines bekannten Quellelements content , nicht nur die Anzahl der Dokumente. Vergleichen Sie für Listenelemente und moderne Seiten das Ergebnis mit der erwarteten Inhaltsdarstellung. Wenn Sie SharePoint-Gruppe-Auflösung konfiguriert haben, überprüfen Sie auch das Feld „Ausgangswebsite“ für Dokumente und projizierte Blöcke.
Testen Sie zulässige und Benutzer ohne Berechtigung separat mit berechtigungsgefilterten Abfragen, ohne den Header mit erhöhten Rechten. Reservieren Sie erhöhte Leseberechtigungen für autorisierte administrative Untersuchungen, nicht als Fallback für Endbenutzerabfragen.
Aktualisieren der Datenquelle
Im Indexerbeispiel wird kein Zeitplan konfiguriert. Um spätere Quelländerungen zu verarbeiten, konfigurieren Sie einen Indexerzeitplan , oder führen Sie den Indexer manuell aus. Die delegierte Authentifizierung erfordert weiterhin die Anmeldeschritte im folgenden Abschnitt, wenn das Token abläuft.
Wenn Sie die Datenquelle ändern, während der Gerätecode abgelaufen ist, melden Sie sich erneut an, um den Indexer auszuführen. Wenn Sie beispielsweise die Abfrage der Datenquelle ändern, melden Sie sich erneut über https://microsoft.com/devicelogin an und rufen Sie den neuen Gerätecode ab.
Führen Sie zum Aktualisieren einer Datenquelle die folgenden Schritte aus, wenn ein abgelaufener Gerätecode vorausgesetzt wird:
Rufen Sie run Indexer auf, um die Ausführung des Indexers manuell zu starten.
POST https://[service name].search.windows.net/indexers/sharepoint-indexer/run?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]
Überprüfen Sie den Indexerstatus.
GET https://[service name].search.windows.net/indexers/sharepoint-indexer/status?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]
Wenn Sie eine Fehlermeldung erhalten, in der Sie aufgefordert werden, die Seite zu besuchen
https://microsoft.com/devicelogin, öffnen Sie die Seite, und kopieren Sie den neuen Code.Fügen Sie den Code in das Dialogfeld ein.
Führen Sie den Indexer manuell erneut aus, und überprüfen Sie den Indexerstatus. Dieses Mal sollte die Indexerausführung erfolgreich gestartet werden.
Indizierte Inhalte verstehen
Das content Feld enthält unterschiedliche Darstellungen für Dateien, Listenelemente und moderne Seiten.
| SharePoint Asset | Darstellung in content |
|---|---|
| Dokumentbibliotheksdatei | Aus der Datei extrahierter Text mithilfe des konfigurierten Dokumentextraktionspfads. |
| Listenelement | JSON-formatierte Feldwerte. Sie können auch auf einzelne Spalten für die Feldzuordnung zugreifen. |
| Moderne ASPX-Websiteseite | Serialisierte Seitenfelder, die HTML-Markup- und JSON-Escapesequenzen enthalten können. Es ist nicht garantiert, dass diese Darstellung reiner Text ist, der der gerenderten Seite entspricht. |
Für Listen und Seiten können serialisierte Inhalte Feldnamen und andere Werte über den sichtbaren Text hinaus enthalten. Bevor Sie Chunking oder Einbettungen konfigurieren, überprüfen Sie die Eingabe, die content an Ihr Skillset übergeben wurde.
Eine indizierte SharePoint-Wissensquelle generiert einen Indexer, der text Parsing für Listen- und Nur-Seiten-Auswahlen verwendet. Es verwendet die Analyse default für Dokumentbibliotheken oder gemischte Auswahlen wie z. B. allSiteContent. Der Indexerparsingmodus ist von der nachgeschalteten Skillsetverarbeitung getrennt.
Für verwaltete mehrsprachige Erfassung unterstützt eine indizierte SharePoint-Wissensquelle automatische sprachspezifische Analyzer (Vorschau). Weisen Sie für einen Index, den Sie direkt konfigurieren, den durchsuchbaren Zeichenfolgenfeldern Sprachanalysatoren zu. Diese Konfigurationspfade sind getrennt.
Indexdokumentmetadaten
Wenn Sie Dokumentmetadaten indizieren ("dataToExtract": "contentAndMetadata"), können Sie die folgenden Metadaten für die Indizierung verwenden.
| Bezeichner | Typ | Beschreibung |
|---|---|---|
| metadata_spo_site_library_item_id | Edm.String | Der Kombinationsschlüssel von Website-ID, Bibliotheks-ID und Element-ID, die ein Element in einer Dokumentbibliothek für eine Website eindeutig identifiziert. Verwenden Sie dieses Feld als Indexschlüssel für die defaultSiteLibraryContainerwerte , allSiteLibrariesund useQuery (Bibliotheks- oder Ordnerfilter). |
| metadata_spo_site_asset_item_id | Edm.String | Der zusammengesetzte Schlüssel, der ein Listenelement, eine ASPX-Webseite oder eine beliebige Ressource im Mischinhaltsmodus eindeutig identifiziert. Verwenden Sie dieses Feld als Indexschlüssel für die Containerwerte allSiteLists, allSitePages und allSiteContent. |
| metadata_spo_site_id | Edm.String | Die ID der SharePoint-Website. |
| metadata_spo_library_id | Edm.String | Die ID der Dokumentbibliothek. |
| metadata_spo_item_id | Edm.String | Die ID des (Dokument)-Elements in der Bibliothek. |
| Metadaten_spo_Element_zuletzt_geändert | Edm.DateTimeOffset | Das Datum/die Uhrzeit der letzten Änderung (UTC) des Elements. |
| metadata_spo_item_name | Edm.String | Der Name des Elements. |
| metadata_spo_item_size | Edm.Int64 | Die Größe (in Byte) des Elements. |
| metadata_spo_item_content_type | Edm.String | Der Inhaltstyp des Elements. |
| metadata_spo_item_extension | Edm.String | Die Erweiterung des Elements. |
| metadata_spo_item_weburi | Edm.String | Der URI des Elements. |
| metadata_spo_item_path | Edm.String | Die Kombination des übergeordneten Pfads und des Elementnamens. |
| metadata_spo_site_url | Edm.String | Die URL zur SharePoint-Website. Erforderlich, wenn Sie die Auflösung von SharePoint-Websitengruppen aktivieren. Siehe Configure SharePoint Gruppenunterstützung. |
Die SharePoint in Microsoft 365 Indexer unterstützt auch Metadaten, die für jeden Dokumenttyp spezifisch sind. Weitere Informationen finden Sie unter Inhaltsmetadateneigenschaften, die in Foundry IQ verwendet werden.
Wenn Sie benutzerdefinierte Dokumentbibliotheksmetadaten in einem direkt konfigurierten Indexer verfügbar machen möchten, geben Sie diese additionalColumns in der Datenquellenabfrage an. Verwenden Sie dann Feldzuordnungen , um die verfügbar gemachten Quellfelder kompatiblen Indexfeldern zuzuordnen. Das Auswählen von Spalten und das Zuordnen dieser Spalten sind separate Schritte: Eine Zuordnung ruft keine Spalte ab, die von der Datenquelle nicht verfügbar gemacht wurde.
Behalten Sie die Schlüsselzuordnung und alle erforderlichen Berechtigungs- und Ursprungswebsitezuordnungen beim Hinzufügen von benutzerdefinierten Feldern bei. Für SharePoint-Liste-Spalten folgen Sie Listenspalten Indexfeldern zuordnen.
SharePoint-Listen indizieren
Legen Sie die Datenquelle container.name auf allSiteLists fest, um alle SharePoint-Liste-Elemente auf einer Website zu indizieren. Verwenden Sie allSiteContent, um Listenelemente mit Dokumentbibliotheken und Websiteseiten in einem einzigen Indexer zu kombinieren. Um Listen von Unterwebsites einzubeziehen, fügen Sie includeSubsites=true zu container.query hinzu.
Für listenbasierte Indexer oder Indexer für gemischte Inhalte muss das Indexschlüsselfeld die Zuordnung von metadata_spo_site_asset_item_id aus durchführen. Der Inhalt des Listenelements erscheint im Feld content als JSON-formatierte Feldwerte, und die Standardfelder metadata_spo_item_* (wie metadata_spo_item_name, metadata_spo_item_weburi und metadata_spo_item_last_modified) werden für jedes Listenelement befüllt.
Listenspalten zu Indexfeldern zuordnen
Jede Spalte, die Sie für eine SharePoint-Liste definieren, wird als Quellfeld mit demselben Namen wie die SharePoint Spalte angezeigt. Verwenden Sie Feldzuordnungen , um jede Spalte einem Indexfeld zuzuordnen.
Betrachten Sie z. B. eine SharePoint-Liste mit den folgenden Spalten.
| SharePoint-Spalte | SharePoint Spaltentyp |
|---|---|
Title |
Einzelne Textzeile |
Price |
Nummer |
InStock |
Ja/Nein |
Category |
Wahl |
Fügen Sie der Indexdefinition übereinstimmende Felder hinzu, und ordnen Sie dann jede Spalte dem Zielfeld im Indexer zu:
{
  "name": "my-sharepoint-list-indexer",
  "dataSourceName": "my-sharepoint-list-ds",
  "targetIndexName": "products-index",
  "fieldMappings": [
    {
      "sourceFieldName": "metadata_spo_site_asset_item_id",
      "targetFieldName": "id",
      "mappingFunction": { "name": "base64Encode" }
    },
    { "sourceFieldName": "Title", "targetFieldName": "productName" },
    { "sourceFieldName": "Price", "targetFieldName": "price" },
    { "sourceFieldName": "InStock", "targetFieldName": "available" },
    { "sourceFieldName": "Category", "targetFieldName": "category" },
    { "sourceFieldName": "metadata_spo_item_last_modified", "targetFieldName": "lastUpdated" },
    { "sourceFieldName": "metadata_spo_item_weburi", "targetFieldName": "itemUrl" }
  ]
}
Stellen Sie sicher, dass jedes Zielfeld in Ihrem Index mit einem kompatiblen Typ vorhanden ist (z. B. Edm.String für Title, Edm.Double oder Edm.Int64 für Price, Edm.Boolean für InStock).
Indizierung von ASPX-Websiteseiten
Legen Sie die Datenquelle container.name auf allSitePages fest, um alle modernen ASPX-Websiteseiten von einer Website zu indizieren. Verwenden Sie allSiteContent, um Seiten mit Dokumentbibliotheken und Listen in einem einzigen Indexer zu kombinieren. Um Unterwebseiten einzubeziehen, fügen Sie includeSubsites=true zu container.query hinzu.
Für seitenbasierte Indexer oder Indexer für gemischte Inhalte muss das Indexschlüsselfeld die Zuordnung von metadata_spo_site_asset_item_id aus durchführen. Das content Feld enthält serialisierte Seitenfelder, die HTML-Markup- und JSON-Escapesequenzen enthalten können, anstatt garantierten, vom Browser gerenderten Nur-Text. Die Standardfelder metadata_spo_item_* (z. B. metadata_spo_item_name, metadata_spo_item_weburi und metadata_spo_item_last_modified) werden für jede Seite ausgefüllt.
Einschließen oder Ausschließen nach Dateityp
Legen Sie Einschluss- und Ausschlusskriterien im Abschnitt "Parameter" der Indexerdefinition fest, um zu steuern, welche Dateien indiziert werden.
Um bestimmte Dateierweiterungen einzubeziehen, legen Sie "indexedFileNameExtensions" auf eine durch Kommas getrennte Liste von Dateierweiterungen mit vorangestelltem Punkt fest. Um bestimmte Dateierweiterungen auszuschließen, setzen Sie "excludedFileNameExtensions" auf die Erweiterungen, die Sie überspringen möchten. Wenn die gleiche Erweiterung in beiden Listen angezeigt wird, schließt der Indexer sie aus der Indizierung aus.
PUT /indexers/[indexer name]?api-version=2026-10-01
{
    "parameters" : {
        "configuration" : {
            "indexedFileNameExtensions" : ".pdf, .docx",
            "excludedFileNameExtensions" : ".png, .jpeg"
        }
    }
}
Legen Sie fest, welche Dokumente indiziert werden
Ein einzelner SharePoint-Indexer in Microsoft 365 kann Inhalte aus einer oder mehreren Dokumentbibliotheken indizieren. Um anzugeben, welche Websites und Dokumentbibliotheken indiziert werden sollen, verwenden Sie den Parameter "container" in der Datenquellendefinition.
Der Abschnitt "container" der Datenquelle enthält zwei Eigenschaften für diese Aufgabe: "Name" und "Abfrage".
Namen
Die name Eigenschaft ist erforderlich und muss einen der folgenden Werte aufweisen:
| Wert | Beschreibung |
|---|---|
| Standardseitenbibliothek | Indizierung aller Inhalte aus der Standarddokumentbibliothek der Website. |
| allSiteLibraries | Indizierung aller Inhalte aus allen Dokumentbibliotheken auf einer Website. Dokumentbibliotheken von einer Unterwebsite sind außerhalb des Gültigkeitsbereichs, es sei denn, wenn Sie in der Abfrage includeSubsites=true festlegen. Sie können auch useQuery auswählen und includeLibrariesInSite angeben, um den Bereich auf bestimmte Websites oder Unterwebsites einzugrenzen. |
| allSiteLists | Indizieren Sie alle Elemente einer SharePoint-Liste von einer Website. |
| allSitePages | Alle modernen ASPX-Website-Seiten von einer Website indizieren. |
| allSiteContent | Indexbibliotheken, Listen und Seiten von einer Website in einem einzigen Indexer. |
| useQuery | Indiziert nur den in der queryDatei definierten Inhalt. |
Für Datenquellen, die allSiteLists, allSitePages oder allSiteContent verwenden, muss die Schlüsselfeldzuordnung des Indexers metadata_spo_site_asset_item_id anstelle von metadata_spo_site_library_item_id verwenden. Ausführliche Informationen finden Sie unter Schritt 6: Erstellen eines Indexers.
Abfrage
Der Parameter "query" der Datenquelle besteht aus Schlüsselwort-Wert-Paaren. Verwenden Sie die folgenden Schlüsselwörter. Die Werte sind entweder Website-URLs oder Dokumentbibliotheks-URLs.
Berücksichtigen Sie beim Einrichten von Berechtigungen die folgenden Informationen:
Um den Wert für ein bestimmtes Schlüsselwort abzurufen, wechseln Sie zu der Dokumentbibliothek, die Sie einschließen oder ausschließen möchten, und kopieren Sie den URI aus dem Browser. Diese Methode ist die einfachste Methode, um den Wert abzurufen, der mit einem Schlüsselwort in der Abfrage verwendet werden soll.
| Schlüsselwort | Wertbeschreibung und Beispiele |
|---|---|
| Null | Wenn NULL oder leer ist, indexen Sie je nach Containername entweder die Standarddokumentbibliothek oder alle Dokumentbibliotheken. Beispiel: "container" : { "name" : "defaultSiteLibrary", "query" : null } |
| Unterwebsites einschließen | Bei Festlegung auf true durchläuft der Indexer die Stammwebsite und Unterwebsites innerhalb der anwendbaren Traversalgrenzen. Kombinieren mit allSiteLibraries, , allSiteLists, allSitePagesoder allSiteContent. Beispiel: "container" : { "name" : "allSiteLibraries", "query" : "includeSubsites=true" } |
| Bibliotheken in Webseite einfügen | Indizierung von Inhalten aus allen Bibliotheken unter der Website oder Unterwebsite, die durch den Wert dieses Schlüsselworts angegeben wird. Diese Website kann sich in der Verbindungszeichenfolge von SharePointOnlineEndpoint unterscheiden. Wiederholen Sie das Schlüsselwort, um mehrere Websites auszuwählen. Siehe Inhalte von anderen Websites auswählen. Beispiel 1: "container" : { "name" : "useQuery", "query" : "includeLibrariesInSite=https://mycompany.sharepoint.com/mysite" } Beispiel 2 (nur einige Unterwebsites enthalten): "container" : { "name" : "useQuery", "query" : "includeLibrariesInSite=https://mycompany.sharepoint.com/sites/TopSite/SubSite1;includeLibrariesInSite=https://mycompany.sharepoint.com/sites/TopSite/SubSite2" } |
| Bibliothek einbinden | Indizierung aller Inhalte aus dieser Bibliothek. Der Wert ist der vollqualifizierte Pfad zur Bibliothek, den Sie aus Ihrem Browser kopieren können: Beispiel 1 (vollqualifizierter Pfad): "container" : { "name" : "useQuery", "query" : "includeLibrary=https://mycompany.sharepoint.com/mysite/MyDocumentLibrary" } Beispiel 2 (aus Ihrem Browser kopierter URI): "container" : { "name" : "useQuery", "query" : "includeLibrary=https://mycompany.sharepoint.com/teams/mysite/MyDocumentLibrary/Forms/AllItems.aspx" } |
| excludeLibrary | Inhalte aus dieser Bibliothek nicht indizieren. Der Wert ist der vollqualifizierte Pfad zur Bibliothek, den Sie aus Ihrem Browser kopieren können: Beispiel 1 (vollqualifizierter Pfad): "container" : { "name" : "useQuery", "query" : "includeLibrariesInSite=https://mysite.sharepoint.com/subsite1; excludeLibrary=https://mysite.sharepoint.com/subsite1/MyDocumentLibrary" } Beispiel 2 (aus Ihrem Browser kopierter URI): "container" : { "name" : "useQuery", "query" : "includeLibrariesInSite=https://mycompany.sharepoint.com/teams/mysite; excludeLibrary=https://mycompany.sharepoint.com/teams/mysite/MyDocumentLibrary/Forms/AllItems.aspx" } |
| Ordner einschließen | Indexiere Inhalte aus einem bestimmten Ordner und dessen Unterordnern. Der Wert muss eine vollständige SharePoint Ordner-URL sein. Verhalten: Gilt rekursiv für alle Unterordner. Mehrere Ordner können durch Wiederholen des Parameters mit Semikolons angegeben werden. Ordnerfilter sind auf eine einzelne Dokumentbibliothek begrenzt. Nur-Stamm-Pfade werden nicht unterstützt. Wenn ein Ordner, auf den verwiesen wird, umbenannt wird, muss die Abfrage aktualisiert werden. Beispiel 1 (einzelner Ordner): "container": { "name": "useQuery", "query": "includeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Policies" }Beispiel 2 (mehrere Ordner): "container": { "name": "useQuery", "query": "includeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Specs;includeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Designs" } |
| Ordner ausschließen | Indizieren Sie keine Inhalte aus einem bestimmten Ordner und dessen Unterordnern. Der Wert muss eine vollständige SharePoint Ordner-URL sein. Verhalten: Gilt rekursiv für alle Unterordner. Wenn eine Datei sowohl Einschluss- als auch Ausschlussregeln entspricht, hat die Ausschlussregel Vorrang, und die Datei wird übersprungen. Ordnerfilter sind auf eine einzelne Dokumentbibliothek begrenzt. Beispiel 1 (Ordner ausschließen): "container": { "name": "useQuery", "query": "excludeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Policies/Archive" }Beispiel 2 (Kombinieren von "include" + "exclude"): "container": { "name": "useQuery", "query": "includeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Policies;excludeFolder=[your-tenant-name].sharepoint.com/sites/hr/Shared Documents/Policies/Drafts" } |
| zusätzliche Spalten | Indexieren Sie Spalten aus der Dokumentbibliothek. Der Wert ist eine durch Trennzeichen getrennte Liste von Spaltennamen, die Sie indizieren möchten. Verwenden Sie einen doppelten umgekehrten Schrägstrich, um Semikolons und Kommas in Spaltennamen mit Escapezeichen zu versehen: Beispiel 1 (zusätzlicheSpalten=MyCustomColumn,MyCustomColumn2): "container" : { "name" : "useQuery", "query" : "includeLibrary=https://mycompany.sharepoint.com/mysite/MyDocumentLibrary;additionalColumns=MyCustomColumn,MyCustomColumn2" } Beispiel 2 (Escapezeichen mit doppeltem umgekehrtem Schrägstrich): "container" : { "name" : "useQuery", "query" : "includeLibrary=https://mycompany.sharepoint.com/teams/mysite/MyDocumentLibrary/Forms/AllItems.aspx;additionalColumns=MyCustomColumnWith\\,,MyCustomColumnWith\\;" } |
Auswählen von Inhalten von anderen Websites
Das SharePointOnlineEndpoint der Verbindungszeichenfolge identifiziert die Standardwebsite. Durch Festlegen container.name auf useQuery, wählt die Abfrage aus, welche Websites oder Bibliotheken indiziert werden sollen. Die ausgewählten Websites können sich von dieser Standardwebsite unterscheiden.
In den folgenden Konfigurationsbeispielen werden drei Standorte im selben Mandanten verwendet: Standort A, Standort B und Standort C. Ersetzen Sie {{sharepoint-site-a-connection-string}} durch eine Verbindungszeichenfolge, deren SharePointOnlineEndpoint Name lautethttps://contoso.sharepoint.com/sites/site-a. Konfigurieren Sie die Berechtigungen der Aufnahmeanwendung für jede ausgewählte Website.
Diese Datenquelle wählt Website B aus, obwohl die Verbindungszeichenfolge Website A identifiziert:
{
  "name": "sharepoint-site-b",
  "type": "sharepoint",
  "credentials": {
    "connectionString": "{{sharepoint-site-a-connection-string}}"
  },
  "container": {
    "name": "useQuery",
    "query": "includeLibrariesInSite=https://contoso.sharepoint.com/sites/site-b"
  }
}
Verweis:Datenquellen – Erstellen
Wenn Sie „Sites B“ und „C“ auswählen möchten, wiederholen Sie includeLibrariesInSite in der Abfrage:
{
  "name": "sharepoint-sites-b-c",
  "type": "sharepoint",
  "credentials": {
    "connectionString": "{{sharepoint-site-a-connection-string}}"
  },
  "container": {
    "name": "useQuery",
    "query": "includeLibrariesInSite=https://contoso.sharepoint.com/sites/site-b;includeLibrariesInSite=https://contoso.sharepoint.com/sites/site-c"
  }
}
Referenz:Datenquellen – Erstellen
Die Queryauswahl gewährt keinen Zugriff. Wenn Sie Sites.Selected verwenden, gewähren Sie der App Zugriff auf jede ausgewählte Website. Siehe Gewähren von Websitezugriff bei Verwendung von Sites.Selected.
Die Datenquellenerstellung und der Laufzeitzugriff sind separate Prüfungen. Wenn die Überprüfung der Einrichtung den Verbindungszeichenfolgenendpunkt überprüft, überprüft der erfolgreiche Zugriff auf Website A nicht den Zugriff auf Websites B oder C. Überprüfen Sie den Status und den Ausführungsverlauf des Indexers , um die Verarbeitung der ausgewählten Websites zu überprüfen.
Folgen Sie für die berechtigungsabhängige Indizierung der SharePoint-Berechtigungskonfiguration, um metadata_spo_site_url zuzuordnen und den Ursprungswebsitekontext im Index und allen projizierten Dokumenten beizubehalten. Die sharepointSiteUrl: true Feldeigenschaft identifiziert das Websitekontextfeld, das für die Auflösung von SharePoint-Gruppe verwendet wird; es handelt sich nicht um eine Websiteauswahlregel oder eine Zulassungsliste. Der Grenzwert pro Indexwebsite gilt weiterhin.
Fehler behandeln
Die fehlerhafte Verbindung identifizieren
Eine erfolgreiche Anforderung an Foundry IQ beweist nicht, dass der Indexer SharePoint lesen kann. Eine erfolgreiche Ingestion beweist auch nicht, dass ein Endbenutzer ein geschütztes Element abrufen kann. Identifizieren Sie die fehlerhafte Phase, bevor Sie Berechtigungen oder Netzwerkeinstellungen ändern.
| Verbindung | Identität oder Anmeldeinformationen, die überprüft werden sollen | Diagnosevorgang |
|---|---|---|
| Client oder Anwendung zu Foundry IQ | Die Microsoft Entra-Identität oder der konfigurierte API-Schlüssel des Aufrufers. | Überprüfen Sie den Suchendpunkt, anwendbare Datenebenenrollen und den Suchdienst-Netzwerkzugriff. Die Anruferauthentifizierung unterscheidet sich von den Dokumentberechtigungen des Benutzers. |
| Indexer zum Microsoft Graph und SharePoint | Die konfigurierte SharePoint-Erfassungs-App und ggf. die delegierte Anmeldung. | Überprüfen Sie den Indexerstatus und den Ausführungsverlauf. Überprüfen Sie den Mandanten, die Anmeldeinformationen, die Administratorzustimmung und die Websiteberechtigungen für jede ausgewählte Website. Der Verbindungszeichenfolgenendpunkt allein richtet keinen Zugriff auf jede für die Abfrage ausgewählte Site ein. |
| Berechtigungsauflösung zur Abfragezeit für Microsoft Graph und SharePoint | Der Berechtigungskontext des Endbenutzers und die konfigurierte SharePoint-Gruppe-Auflösungs-App. | Führen Sie Diagnose zur SharePoint-Berechtigungsfilterung aus. Überprüfen Sie das Abfragetoken, die indizierten Berechtigungs-/Websitemetadaten und die Gruppenauflösungskonfiguration, anstatt den Zugriff der Erfassungs-App zu erweitern. |
| Anreicherung an Modell- oder Foundry-Endpunkte | Verwenden Sie die verwaltete Suchidentität für schlüssellose Anrufe oder den konfigurierten Ressourcenschlüssel. | Überprüfen Sie den fehlerhaften Skill und dessen Ressourcenendpunkt, Autorisierung, Eingabebeschränkungen und Netzwerkkonfiguration. |
Prüfen Sie eingehende und ausgehende Verbindungen separat. Ein eingehender privater Endpunkt für die Suche kann mit öffentlichen ausgehenden Verbindungen zu SharePoint Online koexistieren. Freigegebene private Links gelten nur für unterstützte Ziele, nicht SharePoint Online. Die Einschränkung für bedingten Zugriff gilt weiterhin.
Für den Support erfassen Sie die fehlerhafte Phase, den UTC-Zeitstempel, den HTTP-Status und die Anforderungs- oder Korrelations-ID. Entfernen Sie Token, API-Schlüssel, geheime Schlüssel und mandantenspezifische Identifikationsdetails aus der freigegebenen Diagnose.
Behandeln von Indizierungsfehlern
Informationen zu einer Invalid AAD tenant Nachricht, einer fehlenden Microsoft Entra Mandanten-ID oder eines Mandantenkonflikts, der im Indexerausführungsverlauf angezeigt wird, finden Sie unter Problembehandlung allgemeiner Indexerfehler und -warnungen.
Die Einstellungen zum Überspringen von Dokumenten im folgenden Abschnitt beheben keine Authentifizierungs- oder Berechtigungsfehler.
Standardmäßig wird die SharePoint in Microsoft 365 Indexer beendet, sobald ein Dokument mit einem nicht unterstützten Inhaltstyp wie einem Bild auftritt. Verwenden Sie den excludedFileNameExtensions Parameter, um bestimmte Inhaltstypen zu überspringen. Möglicherweise müssen Sie dokumente jedoch indizieren, ohne alle möglichen Inhaltstypen im Voraus zu kennen. Um die Indizierung fortzusetzen, wenn der Indexer auf einen nicht unterstützten Inhaltstyp trifft, legen Sie den failOnUnsupportedContentType Konfigurationsparameter auf "false" fest:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-10-01
Content-Type: application/json
api-key: [admin key]

{
    ... other parts of indexer definition
    "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false } }
}
Bei einigen Dokumenten kann Foundry IQ den Inhaltstyp nicht ermitteln oder ein Dokument eines anderen unterstützten Inhaltstyps nicht verarbeiten. Um diesen Fehlermodus zu ignorieren, legen Sie den failOnUnprocessableDocument Konfigurationsparameter auf "false" fest:
"parameters" : { "configuration" : { "failOnUnprocessableDocument" : false } }
Für SharePoint-Quelldateien gelten die gemeinsamen Grenzwerte für Quelldateigröße und extrahierte Zeichen bei BLOB-ähnlichen Indexern. Standardmäßig werden überdimensionierte Dokumente als Fehler behandelt. Sie können jedoch weiterhin Speichermetadaten überdimensionierter Dokumente indizieren, wenn Sie den indexStorageMetadataOnlyForOversizedDocuments Konfigurationsparameter auf "true" festlegen:
"parameters" : { "configuration" : { "indexStorageMetadataOnlyForOversizedDocuments" : true } }
Wenn Sie ein Skillset hinzufügen, überprüfen Sie die Eingabe- und nachgeschalteten Dienstgrenzwerte der einzelnen Fähigkeiten separat. Eine Fähigkeit kann weniger Daten akzeptieren, als der SharePoint-Indexer extrahiert.
Sie können die Indizierung auch fortsetzen, wenn An einem beliebigen Punkt der Verarbeitung Fehler auftreten, entweder beim Analysieren von Dokumenten oder beim Hinzufügen von Dokumenten zu einem Index. Um eine bestimmte Anzahl von Fehlern zu ignorieren, legen Sie die maxFailedItems Parameter und maxFailedItemsPerBatch Konfigurationsparameter auf die gewünschten Werte fest. Zum Beispiel:
{
    ... other parts of indexer definition
    "parameters" : { "maxFailedItems" : 10, "maxFailedItemsPerBatch" : 10 }
}
Synchronisierungswiederholungen verstehen
Der Prozess, der Änderungen in SharePoint nachverfolgt, kann einen Synchronisierungs-Wiederholungsvorgang anfordern. Foundry IQ kann dann zuvor indizierte Elemente erneut verarbeiten, um fehlende Änderungen zu vermeiden und die Datenintegrität beizubehalten, auch wenn Sie diese Elemente nicht bearbeitet haben.
Dieses Verhalten gilt mit oder ohne ACL-Ingestion. Je nach Pipeline kann die Neuverarbeitung Anreicherung und die Generierung von Einbettungen erneut ausführen, wodurch die Verarbeitungszeit und die Kosten erhöht werden.
Eine Synchronisierungswiederholung ist von einer Berechtigungs-Neusynchronisierung getrennt, die indizierte Berechtigungen aktualisiert, ohne Anreicherung oder Einbettungen erneut auszuführen. Die erneute Verarbeitung von Inhalten während einer späteren normalen Ausführung bedeutet nicht, dass der Lauf nur für Berechtigungen diese Arbeit ausgeführt hat.
Wenn sich Wiederholungsversuche wiederholen oder Verarbeitungen unerwartet sind, überprüfen Sie den Ausführungsverlauf des Indexers. Stellen Sie beim Kontaktieren des Supports die UTC-Zeiten, den Status, Fehler und die verfügbaren Anforderungs-IDs der betroffenen Ausführungen bereit. Schließen Sie keine Anmeldeinformationen, Benutzertoken oder Dokumentinhalte ein.
Verwandte Inhalte
- Indexer in Foundry IQ
- Inhaltsmetadateneigenschaften, die in Foundry IQ verwendet werden
- SharePoint-Inhalte und andere Quellen in Foundry IQ mithilfe von Azure Logic App Connectors indizieren
- SharePoint ACL-Konfiguration aufnehmen
- Synchronisieren von ACLs zwischen SharePoint und dem Index
- Konfigurieren Sie die Unterstützung für SharePoint-Gruppen
- Beibehalten und berücksichtigen Microsoft Purview Vertraulichkeitsbezeichnungen (Vorschau)