Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Note
Azure Yapay Zeka Arama Azure portalı, REST API'leri ve Azure SDK’ları aracılığıyla kullanılabilir. Ayrıca kuruluş içeriğini Microsoft Foundry portalındaki aracılar için yeniden kullanılabilir, izin kullanan bilgi bankalarına dönüştüren yönetilen bilgi katmanı Foundry IQ'yu temel alır.
İlginin gerçek ölçüsü, alınan bir sonuç kümesinin müşteri ve kullanıcı bilgileri gereksinimlerinizi ne kadar iyi karşıladığını gösterir. Bu makalede, aşağıdakiler hakkında bilgi edinin:
- Azure Yapay Zeka Arama'te ilgili sonuçları üretmeye yönelik ana stratejiler
- İlginin nasıl ölçülmüş olduğu mekaniği
- İlgi düzeyini artırmak için gerçekleştirebileceğiniz eylemler
Son derece ilgili sonuçlar için stratejiler
Azure Yapay Zeka Arama'te, son derece ilgili sonuçlar üretmeye yönelik en iyi yaklaşımlar olarak iki ana strateji ortaya çıkmıştır.
- Anlamsal sıralayıcı ile hibrit arama
- LLM tabanlı sorgu planlaması (önizleme) ve yanıt sentezi (önizleme) ile aracılı alma
Karma arama (klasik), tek bir dizini hedefleyen bir arama isteğinde anahtar sözcük sorgularının duyarlığını ve vektör sorgularının anlamsal benzerliğini birleştirerek ilgi sunar. Anahtar sözcük araması sözcüksel bir sorgu üzerinde çalışır. Vektör araması aynı dizenin vektörleştirilmiş sürümünü kullanarak aynı sorguyu çalıştırır. Sorgular paralel olarak yürütülür ve hassas ve benzer eşleşmeler arar. Sonuçlar birleştirilir, derecelendirilir ve ardından en uygun eşleşmeleri yükselten bir anlamsal derece oluşturucu kullanılarak yeniden kaydedilir. Anahtar sözcük ve vektör aramasının birlikte kullanılması, tek başına bir çözüm olarak her yaklaşımın zayıflıklarını dengeler. Anlam dereceleyicisi, daha iyi bir sonuca katkıda bulunabilen ek bir bileşendir.
Etmen tabanlı bilgi getirme, LLM tabanlı sorgu planlaması (önizleme), yanıt sentezi (önizleme) ve tüm bir arama etki alanını tanımlayan bir bilgi tabanı aracılığıyla ilgililik sağlar. LLM, daha etkili bir şekilde bilgi elde etmek için sorguları analiz edebilir ve dönüştürebilir. Karmaşık soruları hedeflenen alt sorgular halinde ayrıştırabilir, belirsiz istekleri iyileştirebilir veya daha geniş bir kapsam için dar soruları genelleştirebilir. Etmen temelli bir geri alma iş yükünde, LLM en iyi içeriği tanımlamak ve maksimum faydayı sağlamak için soruyu mantık yürütme yeteneğini, sohbet geçmişi bağlamını ve geri alma talimatlarını kullanarak yanıtlar. LLM tabanlı sorgu planlaması, çok kaynaklı bilgi bankası araması ve LLM mantığının bu birleşimi, aracılı alma işleminin yüksek oranda ilgili sonuçlar döndürme şeklidir.
İlgi, yeterli miktarda ve kalitede topraklama verilerinin bulunmasına da bağlıdır. Yararlı bilgi alma sürecinde, aranabilir unsurların kapsamını genişletmek ve belirli bilgi kaynaklarını seçmeye yönelik mantık sağlamak için birden çok bilgi kaynağını listeleyebilirsiniz.
İlginin nasıl ölçüldü?
İçeriğin nasıl alındığına bakılmaksızın, herhangi bir sonucun ilgisi, sorgunun arama grubundaki içeriğe ne kadar yakın olduğuna bağlı olarak eşleşmenin gücünü değerlendiren bir derecelendirme algoritması tarafından belirlenir. Eşleşme bulunduğunda, algoritma bir puan atar ve sonuçlar bu puana göre derecelenir ve yanıtta en üstteki sonuçlar döndürülür.
Sıralama, sorgu isteği aracısal geri alma, anahtar kelime, vektör ve hibrit sorgular için klasik arama olduğunda gerçekleşir. Sorgu, yalnızca filtre sorgusu veya otomatik tamamlama, öneriler, jeo-uzamsal arama, belirsiz arama veya normal ifade araması gibi özel bir sorgu formu gibi katı desen eşleştirmesi çağırırsa gerçekleşmez. Tekdüzen arama puanı 1,0, derecelendirme algoritmasının bulunmamasını gösterir.
Derecelendirme düzeyleri
Azure Yapay Zeka Arama'teki sorgu altyapısı, arama sonuçlarını sıralamak için çok düzeyli bir yaklaşımı destekler. Burada her sorgu türü için yerleşik bir derecelendirme modalitesi ve genişletilmiş ilgi ayarı için ek derecelendirme özellikleri bulunur.
Bu bölümde puanlama işlemlerinin düzeyleri açıklanmaktadır. Birlikte nasıl çalıştıklarını gösteren bir çizim için bu makaledeki diyagrama bakın. Bu makalede tüm arama puanı türlerinin ve aralıklarının karşılaştırması da sağlanır.
| Level | Description |
|---|---|
| Düzey 1 (L1) | İlk arama puanı (@search.score). Belirteçli dizelerle eşleşen metin sorguları için sonuçlar her zaman başlangıçta BM25 derecelendirme algoritması kullanılarak sıralanır. Vektör sorguları için sonuçlar Hiyerarşik Gezinilebilir Küçük Dünya (HNSW) veya kapsamlı en yakın K komşu (KNN) kullanılarak sınıflandırılır. Görüntü arama veya çok modüllü aramalar, vektör sorgularını temel alır ve L1 vektör derecelendirme algoritmaları kullanılarak puanlanmıştır. |
| Birleştirilmiş L1 |
Karşılıklı Derecelendirme Fusion (RRF) algoritmasını kullanarak birden çok sorgudan puanlama. RRF, metin ve vektör bileşenleri içeren karma sorgular için kullanılır. RRF, birden çok vektör sorgusu paralel olarak yürütülürken de kullanılır. RRF'den alınan arama puanı @search.score yansıtılır. |
| Düzey 2 (L2) |
Anlam derecelendirme puanı (@search.reRankerScore), makine okuma kavramasını L1 derecelendirmesi tarafından alınan metin içeriğine uygular ve L1 sonuçlarını sorgunun anlamsal amacına daha iyi uyacak şekilde yeniden puanlar. L2, L1 sonuçlarını yeniden kaydırır çünkü bunu yapmak zaman ve para tasarrufu sağlar; semantik derecelendirmeyi L1 derecelendirme sistemi olarak kullanmak yasak olacaktır. Anlamsal derecelendirme, semantik derecelendirme modellerinin kullanımını faturalayan premium bir özelliktir. Metin içeren metin sorguları ve vektör sorguları için isteğe bağlıdır, ancak aracılı alma için gereklidir. Aracılı alma, sorgu altyapısına birden çok sorgu gönderse de, aracısal alma için sıralama algoritması anlamsal dereceleyicidir. |
| Düzey 3 (L3) |
ajan tabanlı alma ve medium alma akıl yürütme çabası (önizleme) için geçerlidir. L3 derecelendirmesi yinelemeli aramayı ifade eder ve aracılı alma altyapısı ve LLM daha ilgili bir sonuç döndürmek için ikinci bir sorgu geçişi gerektiğini kabul ettiğinde çağrılır. Daha fazla bilgi için Orta yineleme ile arama kısmına bakın. |
İlgi düzeyini ayarlama
İlgi ayarı , ağırlıklı alanlar, yenilik veya yakınlık gibi ek ölçütlere göre arama puanlarını artırmaya yönelik bir tekniktir. Azure Yapay Zeka Arama'te ilgi ayarı seçenekleri sorgu türüne göre değişir:
Anahtar sözcük veya karma aramadaki metinsel ve sayısal (seçici olmayan) içerik için , puanlama profilleri aracılığıyla veya anlam derecesini çağırarak ilgi düzeyini ayarlayabilirsiniz.
Karma sorgudaki vektör içeriği için, vektör bileşeninin karma sorgunun metin bileşenine göre önemini artırmak için vektör alanını ağırlıklandırabilirsiniz .
Saf vektör sorguları için Hiyerarşik Gezinilebilir Küçük Dünya (HNSW) ile en yakın K-yakın komşular (KNN) arasında denemeler yapabilir ve bir algoritmanın senaryonuzda diğerinin üzerinde performans gösterip göstermediğini görebilirsiniz. Sorgu zamanında kapsamlı bir KNN geçersiz kılma ile HNSW grafı, karşılaştırma testi için en esnek yaklaşımdır. Ayrıca, hangilerinin daha yüksek kaliteli sonuçlar ürettiğini görmek için çeşitli ekleme modellerini deneyebilirsiniz. Son olarak, ilgi alanı olmayan alanları içeren belgelerdeki karma sorgunun veya vektör sorgusunun ilgi ayarlama için kapsam içinde olduğunu, dolayısıyla ilgi ayarlama çabalarına katılamayan yalnızca vektör alanlarının kendileri olduğunu unutmayın.
Puanlama profillerini kullanarak özel artırma mantığı
Puanlama profilleri , fazladan kullanıcı tanımlı ölçütlere göre puan artırmaya yönelik isteğe bağlı bir özelliktir. Ölçütler, belirli bir alanda bulunan bir eşleşmenin farklı bir alanda bulunan aynı eşleşmeden daha fazla ağırlık verildiği ağırlıklı alanları içerebilir. Ölçütler, yenilik, yakınlık, büyüklük veya aralık ile güçlendiren işlevler aracılığıyla da tanımlanabilir. Puanlama profilleriyle ilişkili ek maliyet yoktur. Puanlama profili kullanmak için, bunu bir dizinde tanımlar ve ardından sorguda belirtirsiniz.
Puanlama mantığı metin ve sayısal nonvector içeriği için geçerlidir. Puanlama profillerini şu şekilde kullanabilirsiniz:
- Metin (anahtar sözcük) araması
- Saf vektör sorguları
- Metin ve vektör alt sorgularının paralel olarak yürütüldüğü karma sorgular
- Sıralanmış sorgular
Tek başına metin sorguları için puanlama profilleri BM25 dereceli aramada ilk 1.000 eşleşmeyi tanımlar ve yanıtta ilk 50 eşleşme döndürülür.
Saf vektörler için sorgu yalnızca vektördür, ancak k eşleşen belgeler insan tarafından okunabilen içeriğe sahip vektör olmayan alanlar içeriyorsa, belgedeki vektör olmayan alanlara bir puanlama profili uygulanır.
Karma sorgunun metin bileşeni için puanlama profilleri BM25 dereceli aramada ilk 1.000 eşleşmeyi tanımlar. Ancak bu 1.000 sonuç belirlendikten sonra, vektör sonuçları ile birlikte yeniden puanlanabilmeleri için özgün BM25 sıralamasına geri döndürülür. Daha sonra skor profilinin (çizimde "son belge artırma ayarı" olarak tanımlanır) yanı sıra vektör ağırlıklama ve anlamsal sıralama uygulanarak nihai Karşılıklı Derecelendirme İşlevi (RRF) sıralamasına entegre edilirler.
Semantik sıralanmış sorgular için (diyagramda gösterilmemiştir), en son önizleme REST API'sini veya önizleme Azure SDK paketini kullandığınız varsayıldığında, sıralanmış bir L2 sonuç kümesine puanlama profilleri uygulanabilir ve bu, son derecelendirmeyi belirleyen yeni bir @search.rerankerBoostedScore sonuç kümesi oluşturabilir.
Arama puanı türleri
Sorgu yanıtında her eşleşme için puanlanan sonuçlar gösterilir. Bu tabloda, ilişkili bir aralığa sahip tüm arama puanları listelenir. Aralık algoritmaya göre değişir.
| Score | Range | Algorithm |
|---|---|---|
@search.score |
0 ile sınırsız | Metin araması için BM25 derecelendirme algoritması |
@search.score |
0.333 - 1.00 | Vektör araması için HNSW veya kapsamlı KNN algoritması |
@search.score |
0 ile sorgu sayısı tarafından belirlenen üst sınır arasında | RRF algoritması |
@search.rerankerScore |
0.00 - 4.00 | L2 derecelendirmesi için anlamsal derecelendirme algoritması |
@search.rerankerBoostedScore |
0 ile sınırsız | Puanlama profili artırma ile anlamsal derecelendirme (puanlar 4'ten önemli ölçüde yüksek olabilir) |
Derecelendirme algoritmaları diyagramı
Aşağıdaki diyagramda derecelendirme algoritmalarının birlikte nasıl çalıştığı gösterilmektedir.
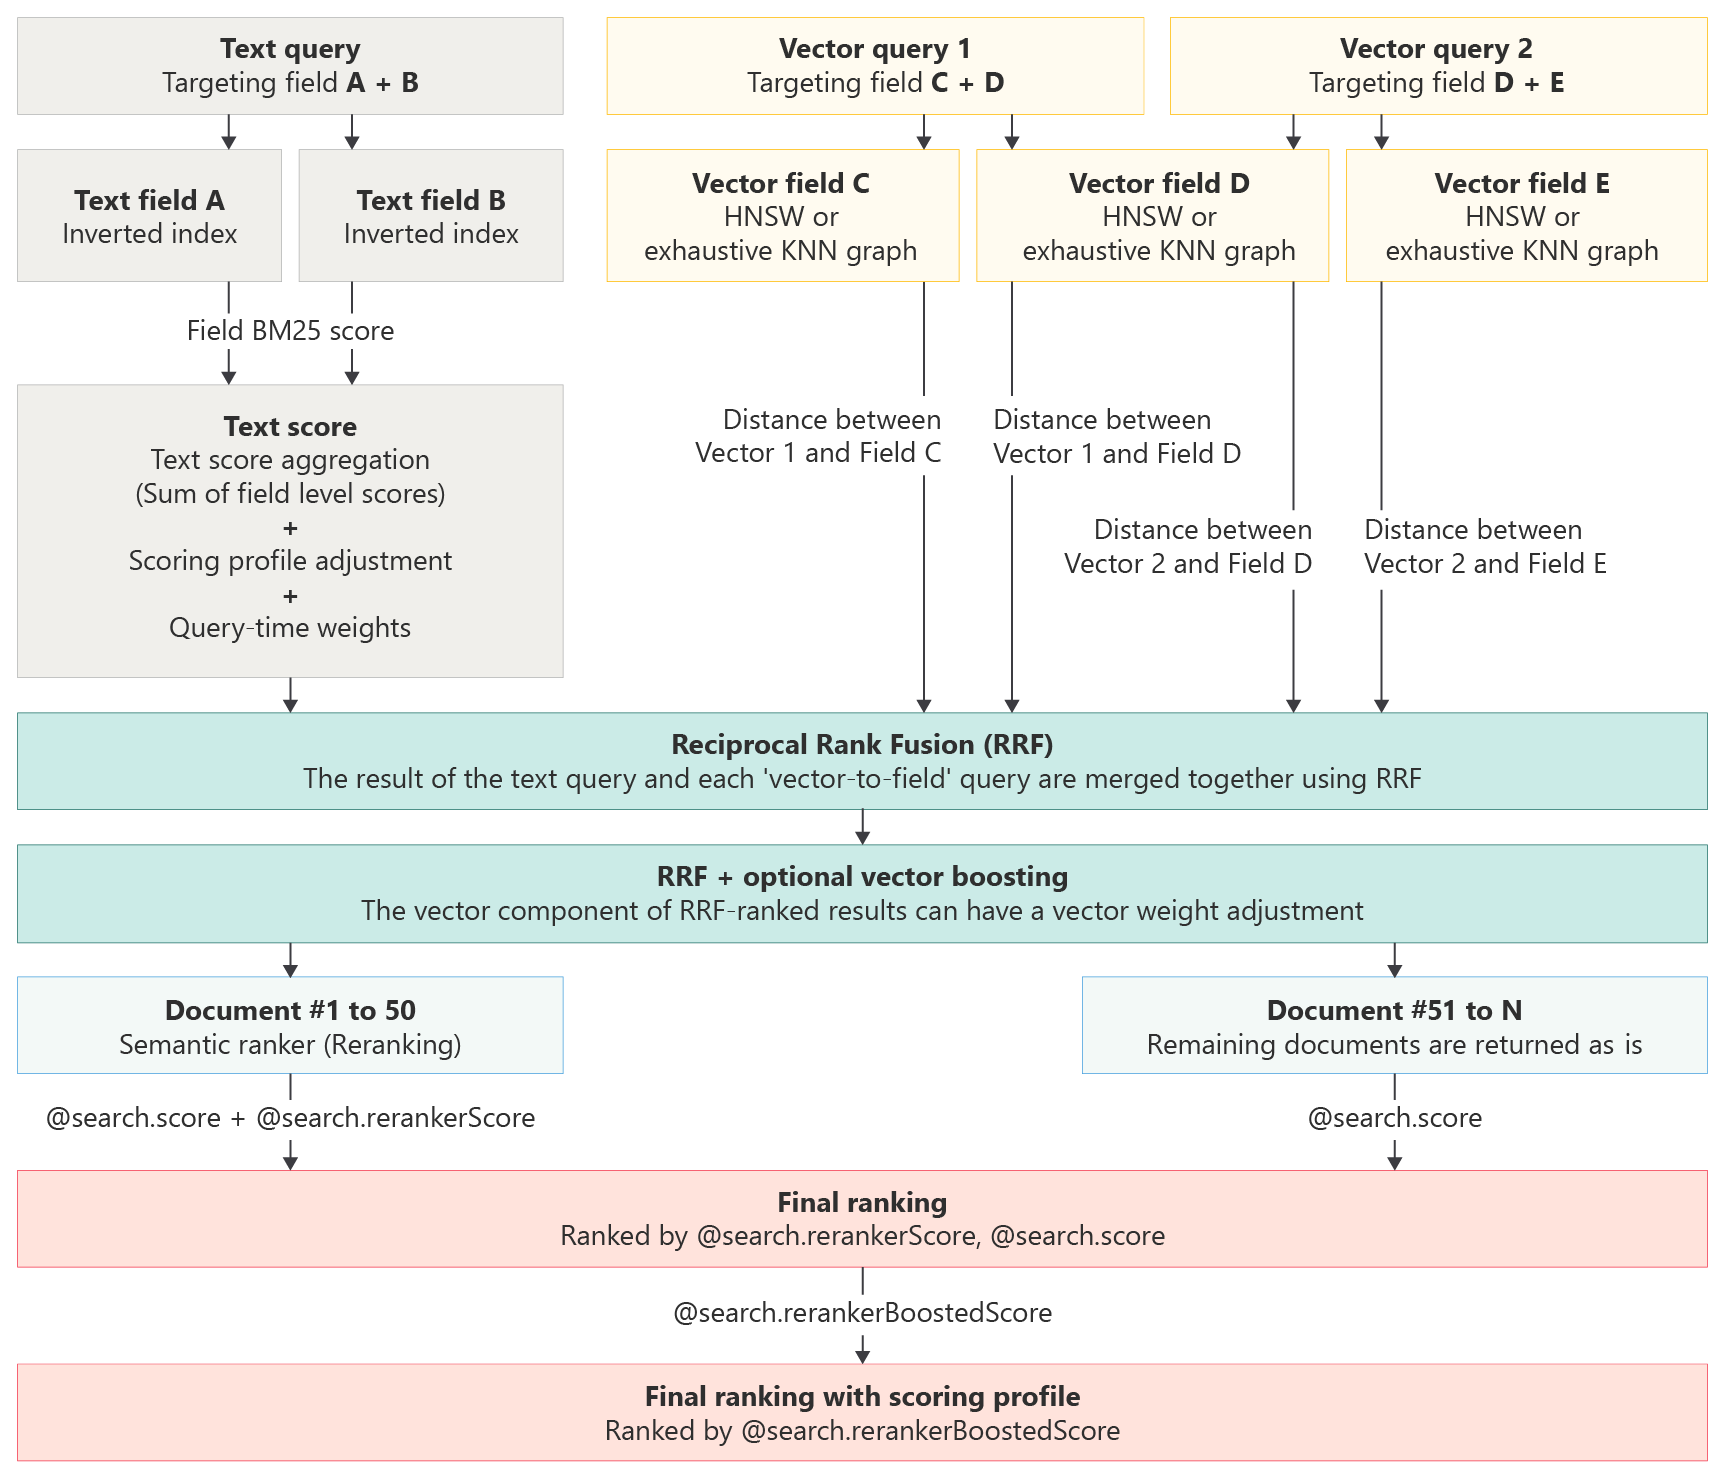
Note
Anlamsal derecelendirme kullanıyorsanız rankingOrder özelliği sonuçların, puanlama profili uygulandıktan sonra oluşturulan semantik olarak puanlanan sonuçlar mı (@search.rerankerScore) yoksa artırılmış puanlar mı ( @search.rerankerBoostedScore) olduğunu belirler.
Tüm derecelendirme algoritmaları dahil örnek sorgu
Aşağıdaki karma anlamsal sorgu, önceki diyagramdaki derecelendirme iş akışını gösterir. Sorgu, RRF (metin ve vektörler için L1 puanlarına göre) ve ardından anlamsal derecelendirme kullanılarak puanlanır.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-08-01-preview

{
  "search": "cloud formation over water",
  "count": true,
  "vectorQueries": [
    {
      "kind": "text",
      "text": "cloud formation over water",
      "fields": "text_vector,image_vector"
    }
  ],
  "queryType": "semantic",
  "semanticConfiguration": "my-semantic-configuration",
  "select": "title,chunk",
  "top": 5
}
Hibrit anlamsal sorguya yönelik bir yanıt, orijinal RRF'yi @search.score ve @search.rerankerScore'i içerir.
  "value": [
    {
      "@search.score": 0.03177805617451668,
      "@search.rerankerScore": 2.6919238567352295,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n32\n\nFraming an Iceberg\nSouth Atlantic Ocean\n\nIn June 2016, the Suomi NPP satellite captured this image of various cloud formations in the South Atlantic Ocean. Note how low \n\nstratus clouds framed a hole over iceberg A-56 as it drifted across the sea. \n\nThe exact reason for the hole in the clouds is somewhat of a mystery. It could have formed by chance, although imagery from the \n\ndays before and after this date suggest something else was at work. It could be that the relatively unobstructed path of the clouds \n\nover the ocean surface was interrupted by thermal instability created by the iceberg. In other words, if an obstacle is big enough,  \n\nit can divert the low-level atmospheric flow of air around it, a phenomenon often caused by islands.",
      "title": "page-39.pdf",
    },
    {
      "@search.score": 0.030621785670518875,
      "@search.rerankerScore": 2.557225465774536,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n24\n\nMaking Tracks\nPacific Ocean\n\nShips steaming across the Pacific Ocean left this cluster of bright cloud trails lingering in the atmosphere in February 2012. The \n\nnarrow clouds, known as ship tracks, form when water vapor condenses around tiny particles of pollution from ship exhaust. The \n\ncrisscrossing clouds off the coast of California stretched for many hundreds of kilometers from end to end. The narrow ends of the \n\nclouds are youngest, while the broader, wavier ends are older.\n\nSome of the pollution particles generated by ships (especially sulfates) are soluble in water and can serve as the seeds around which \n\ncloud droplets form. Clouds infused with ship exhaust have more and smaller droplets than unpolluted clouds. As a result, light \n\nhitting the ship tracks scatters in many directions, often making them appear brighter than other types of marine clouds, which are \n\nusually seeded by larger, naturally occurring particles like sea salt.",
      "title": "page-31.pdf",
    },
    {
      "@search.score": 0.013698630034923553,
      "@search.rerankerScore": 2.515575408935547,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n16\n\nRiding the Waves\nMauritania\n\nYou cannot see it directly, but air masses from Africa and the Atlantic Ocean are colliding in this Landsat 8 image from August 2016. \n\nThe collision off the coast of Mauritania produces a wave structure in the atmosphere. \n\nCalled an undular bore or solitary wave, this cloud formation was created by the interaction between cool, dry air coming off the \n\ncontinent and running into warm, moist air over the ocean. The winds blowing out from the land push a wave of air ahead like a  \n\nbow wave moving ahead of a boat. \n\nParts of these waves are favorable for cloud formation, while other parts are not. The dust blowing out from Africa appears to be \n\nriding these waves. Dust has been known to affect cloud growth, but it probably has little to do with the cloud pattern observed here.",
      "title": "page-23.pdf",
    },
    {
      "@search.score": 0.028949543833732605,
      "@search.rerankerScore": 2.4990925788879395,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n14\n\nBering Streets\nArctic Ocean\n\nWinds from the northeast pushed sea ice southward and formed cloud streets—parallel rows of clouds—over the Bering Strait in \n\nJanuary 2010. The easternmost reaches of Russia, blanketed in snow and ice, appear in the upper left. To the east, sea ice spans \n\nthe Bering Strait. Along the southern edge of the ice, wavy tendrils of newly formed, thin sea ice predominate.\n\nThe cloud streets run in the direction of the northerly wind that helps form them. When wind blows out from a cold surface like sea \n\nice over the warmer, moister air near the open ocean, cylinders of spinning air may develop. Clouds form along the upward cycle in \n\nthe cylinders, where air is rising, and skies remain clear along the downward cycle, where air is falling. The cloud streets run toward \n\nthe southwest in this image from the Terra satellite.",
      "title": "page-21.pdf",
    },
    {
      "@search.score": 0.027637723833322525,
      "@search.rerankerScore": 2.4686081409454346,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n38\n\nLofted Over Land\nMadagascar\n\nAlong the muddy Mania River, midday clouds form over the forested land but not the water. In the tropical rainforests of Madagascar, \n\nthere is ample moisture for cloud formation. Sunlight heats the land all day, warming that moist air and causing it to rise high into the \n\natmosphere until it cools and condenses into water droplets. Clouds generally form where air is ascending (over land in this case), \n\nbut not where it is descending (over the river). Landsat 8 acquired this image in January 2015.",
      "title": "page-45.pdf",
    }
  ]