Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Not
Azure Yapay Zeka Arama Azure portalı, REST API'leri ve Azure SDK’ları aracılığıyla kullanılabilir. Ayrıca kuruluş içeriğini Microsoft Foundry portalındaki aracılar için yeniden kullanılabilir, izin kullanan bilgi bankalarına dönüştüren yönetilen bilgi katmanı Foundry IQ'yu temel alır.
Bu makalede, tam metin araması için arama puanlarını hesaplamak için kullanılan BM25 ilgi puanlama algoritması açıklanmaktadır. BM25'in ilgisi yalnızca tam metin arama için geçerlidir. Filtre sorguları, otomatik tamamlama ve önerilen sorgular, joker karakter araması ve benzer arama sorguları alaka düzeyi için puanlanmaz veya sıralanmaz.
Tam metin aramasında kullanılan puanlama algoritmaları
Azure Yapay Zeka Arama, tam metin araması için aşağıdaki puanlama algoritmalarını sağlar:
| Algoritma | Kullanım | Aralık |
|---|---|---|
BM25Similarity |
Temmuz 2020'de oluşturulan tüm arama hizmetlerinde algoritma düzeltildi. Bu algoritmayı yapılandırabilirsiniz, ancak eski bir algoritmaya (klasik) geçemezsiniz. | Sınırsız. |
ClassicSimilarity |
Temmuz 2020 öncesi eski arama hizmetlerinde varsayılandır. Eski hizmetlerde BM25'i kabul edebilir ve dizin başına bir BM25 algoritması seçebilirsiniz. | 0 < 1,00 |
Hem BM25 hem de Klasik, TF-IDF benzeri alma işlevleridir ve her belge-sorgu çiftinin alaka puanlarını hesaplamak için değişken olarak terim sıklığını (TF) ve ters belge sıklığını (IDF) kullanır; bu işlevler daha sonra sonuçları sıralamak için kullanılır. Kavramsal olarak klasiklere benzer olsa da BM25, kullanıcı araştırması tarafından ölçülen daha sezgisel eşleşmeler üreten olasılıksal bilgi alımına sahiptir.
BM25, kullanıcının ilgililik puanının eşlenen terimlerin terim sıklığıyla nasıl ölçeklendirileceğine karar vermesine izin verme gibi gelişmiş özelleştirme seçenekleri sunar.
BM25 derecelendirmesi nasıl çalışır?
İlgi puanı, bir öğenin geçerli sorgu bağlamındaki ilgisine ilişkin bir gösterge olarak hizmet veren bir arama puanının (@search.score) hesaplanması anlamına gelir. Aralık sınırsız. Ancak, puan ne kadar yüksek olursa, öğe o kadar ilgili olur.
Arama puanı, dize girişinin istatistiksel özelliklerine ve sorgunun kendisine göre hesaplanır. Azure Yapay Zeka Arama, arama terimleriyle (searchMode'a bağlı olarak bazıları veya tümü) eşleşen belgeler bulur ve arama teriminin birçok örneğini içeren belgeleri tercih eder. Terimin veri dizininde nadir, ancak belge içinde yaygın olması durumunda arama puanı daha da yüksek olur. Bilgi işlem ilgisine yönelik bu yaklaşımın temeli TF-IDF veya terim sıklığı ters belge sıklığı olarak bilinir.
Arama puanları bir sonuç kümesi boyunca tekrarlanabilir. Birden çok isabet aynı arama puanına sahip olduğunda, aynı puana sahip öğelerin sıralaması belirsizdir ve sabit değildir. Sorguyu yeniden çalıştırdığınızda, özellikle de ücretsiz hizmeti veya birden çok çoğaltması olan faturalanabilir bir hizmeti kullanıyorsanız öğelerin konum değiştirdiğini görebilirsiniz. Aynı puana sahip iki öğe göz önünde bulundurulduğunda, önce birinin görünmesi garanti edilmez.
Eşit puanlar arasındaki dengeyi bozmak için, önce puana göre, ardından başka bir sıralanabilir alana ( gibi) göre sıralama yapacak şekilde bir
Yalnızca dizinde searchable veya sorguda searchFields olarak işaretlenmiş alanlar puanlama için kullanılır. Yalnızca retrievable olarak işaretlenen alanlar veya sorguda select olarak belirtilen alanlar, arama sonuçlarıyla birlikte ve arama puanlarıyla birlikte döndürülür.
Not
A @search.score = 1 , puanlanmamış veya derecelendirilmemiş bir sonuç kümesini gösterir. Puan tüm sonuçlarda tekdüzendir. Puanlanmamış sonuçlar, sorgu formu belirsiz arama, joker karakter veya regex sorguları ya da boş bir arama olduğunda (search=*bazen filtrenin eşleşme döndürmenin birincil aracı olduğu filtrelerle eşleştirildiğinde) oluşur.
Aşağıdaki video segmenti, Azure Yapay Zeka Arama'te kullanılan genel kullanıma açık derecelendirme algoritmalarının açıklamasına hızlı bir şekilde iletmektedir. Daha fazla arka plan için videonun tamamını izleyebilirsiniz.
Metin sonuçlarındaki puanlar
Sonuçlar derecelendirildiğinde, @search.score özellik sonuçları sıralamak için kullanılan değeri içerir.
Aşağıdaki tablo puanlama özelliğini, algoritmayı ve aralığı tanımlar.
| Arama yöntemi | Parametre | Puanlama algoritması | Aralık |
|---|---|---|---|
| tam metin araması | @search.score |
Dizinde belirtilen parametreleri kullanan BM25 algoritması. | Sınırsız. |
Puan varyasyonu
Arama puanları, aynı sonuç kümesindeki diğer belgelere göre eşleşmenin gücünü yansıtan genel ilgi duygusunu ifade eder. Ancak puanlar her zaman bir sorgudan diğerine tutarlı değildir, bu nedenle sorgularla çalışırken arama belgelerinin sıralı olarak küçük tutarsızlıklar olduğunu fark edebilirsiniz. Bunun neden meydana gelebileceğine ilişkin birkaç açıklama vardır.
| Neden | Açıklama |
|---|---|
| Aynı puanlar | Birden çok belge aynı puana sahipse, bunlardan herhangi biri önce görünebilir. |
| Verilerin geçiciliği | Siz belge ekledikçe, değiştirdikçe veya sildikçe dizin içeriği değişir. Dizin güncelleştirmeleri zaman içinde işlendikçe terim sıklıkları değişir ve eşleşen belgelerin arama puanlarını etkiler. |
| Birden çok kopya | Birden çok kopya kullanan hizmetler için, sorgular her kopyaya paralel olarak gönderilir. Arama puanını hesaplamak için kullanılan indeks istatistikleri, her bir çoğaltma için ayrı ayrı hesaplanır, ardından sonuçlar sorgu yanıtında birleştirilir ve sıralanır. Çoğaltmalar genellikle birbirinin yansımalarıdır, ancak durumlardaki ufak farklılıklar nedeniyle istatistikler değişiklik gösterebilir. Örneğin, bir çoğaltma, istatistiklerine katkıda bulunan ve diğer çoğaltmaların dışında birleştirilen belgeleri silmiş olabilir. Genellikle, çoğaltma başına istatistiklerdeki farklar daha küçük dizinlerde daha belirgindir. Aşağıdaki bölümde bu koşul hakkında daha fazla bilgi sağlanmaktadır. |
Sorgu sonuçları üzerindeki parçalama efektleri
Parça, bir dizinin öbekleridir. Azure Yapay Zeka Arama, bölümleri ekleme işlemini daha hızlı hale getirmek için (parçaları yeni arama birimlerine taşıyarak) dizini parçalara ayırır. Bir arama hizmetinde parça yönetimi bir uygulama ayrıntılarıdır ve yapılandırılamaz, ancak bir dizinin parçalandığını bilmek, sıralama ve otomatik tamamlama davranışlarındaki ara sıra anomalileri anlamanıza yardımcı olur:
Sıralama anormallikleri: Arama puanlandırmaları önce dilim düzeyinde hesaplanır ve ardından tek bir sonuç kümesinde toplanır. Parça içeriğinin özelliklerine bağlı olarak, bir parçadan gelen eşleşmeler, diğer parçadaki eşleşmelerden daha yüksek sıralanabilir. Arama sonuçlarında sezgisel sıralamaların karşıt olduğunu fark ederseniz, bunun nedeni büyük olasılıkla parçalamanın etkileridir, özellikle dizinler küçükse. Tüm dizin genelinde puanları hesaplamayı seçerek bu derecelendirme anomalilerinden kaçınabilirsiniz, ancak bunu yaptığınızda bir performans cezası uygulanır.
Otomatik tamamlama anomalileri: Kısmen girilen bir terimin ilk birkaç karakterinde eşleşmelerin yapıldığı otomatik tamamlama sorguları, yazımda küçük sapmaları affeden benzer bir parametreyi kabul eder. Otomatik tamamlama için, bulanık eşleştirme geçerli kısım içindeki terimlerle kısıtlanır. Örneğin, bir parça "Microsoft" içeriyorsa ve kısmi bir "mikro" terimi girilirse, arama altyapısı bu parçadaki "Microsoft" ile eşleşir, ancak dizinin kalan bölümlerini tutan diğer parçalarda eşleşmez.
Aşağıdaki diyagramda replikalar, bölümlemeler, parçalar ve arama birimleri arasındaki ilişki gösterilmektedir. İki bölümden ve iki çoğaltmadan oluşan bir hizmetteki dört arama birimi arasında tek bir dizinin nasıl yayıldığını gösteren bir örnek. Dört arama biriminin her biri, dizinin parçalarının yalnızca yarısını depolar. Sol sütundaki arama birimleri parçaların ilk yarısını depolar ve sağ sütundakiler ikinci bölümü içeren parçaların ikinci yarısını depolar. İki çoğaltma olduğundan, her dizin parçasının iki kopyası vardır. Üst satırdaki arama birimleri ilk çoğaltmayı içeren bir kopya depolarken, alt satırdakiler ikinci çoğaltmayı içeren başka bir kopya depolar.
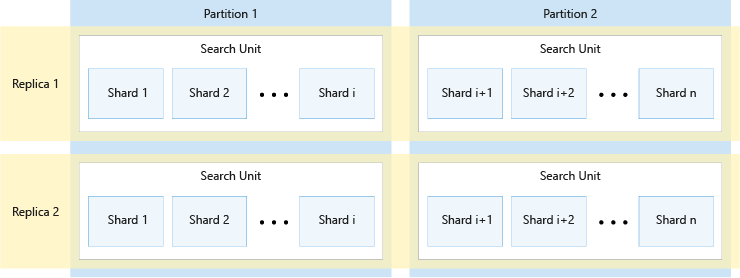
Yukarıdaki diyagram yalnızca bir örnektir. En fazla 36 toplam arama birimi olmak üzere birçok bölüm ve çoğaltma bileşimi mümkündür.
Not
Çoğaltma ve bölüm sayısı eşit olarak 12'ye ayrılır (özellikle, 1, 2, 3, 4, 6, 12). Azure Yapay Zeka Arama, tüm bölümlere eşit parçalar halinde yayılabilmesi için her dizini 12 parçaya (shard) önceden böler. Örneğin, hizmetinizin üç bölümü varsa ve bir dizin oluşturursanız, her bölüm dizinin dört parçası içerir. Azure Yapay Zeka Arama'ün bir dizini nasıl parçalandıracakları, gelecek sürümlerde değişikliğe tabi olan bir uygulama ayrıntısıdır. Sayı bugün 12 olsa da, gelecekte bu sayın her zaman 12 olmasını beklememelisiniz.
Puanlama istatistikleri ve yapışkan oturumlar
Ölçeklenebilirlik için Azure Yapay Zeka Arama, her dizini bir parçalama işlemi aracılığıyla yatay olarak dağıtır ve bu da dizinin bölümlerinin fiziksel olarak ayrı olduğu anlamına gelir.
Varsayılan olarak, bir belgenin puanı bir parça içindeki verilerin istatistiksel özelliklerine göre hesaplanır. Bu yaklaşım genellikle büyük bir veri kolordusu için sorun oluşturmaz ve tüm parçalar genelindeki bilgilere göre puanı hesaplamak zorunda kalmaktan daha iyi performans sağlar. Bununla birlikte, bu performans iyileştirmesini kullanmak, çok benzer iki belgenin (veya hatta aynı belgelerin) farklı parçalar halinde olması durumunda farklı ilgi puanlarına sahip olmasına neden olabilir.
Puanı tüm parçalardaki istatistiksel özelliklere göre hesaplamayı tercih ediyorsanız, bunu sorgu parametresi olarak ekleyerek scoringStatistics=global (veya sorgu isteğinin gövde parametresi olarak ekleyerek"scoringStatistics": "global") yapabilirsiniz.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "scoringStatistics": "global"
}
Kullanmak scoringStatistics, aynı çoğaltmadaki tüm parçaların aynı sonuçların sağlanmasını garanti eder. Bununla birlikte, her zaman dizininizdeki en son değişikliklerle güncelleştirildiğinden farklı çoğaltmalar birbirinden biraz farklı olabilir. Bazı senaryolarda, kullanıcılarınızın "sorgu oturumu" sırasında daha tutarlı sonuçlar elde etmelerini isteyebilirsiniz. Bu tür senaryolarda, sorgularınızın bir parçası olarak bir sessionId sağlayabilirsiniz.
sessionId, benzersiz bir kullanıcı oturumuna başvurmak için oluşturduğunuz benzersiz bir dizedir.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "sessionId": "<string>"
}
Aynı sessionId kullanıldığı sürece, aynı çoğaltmayı hedeflemek için en iyi çaba gösteriliyor ve kullanıcılarınızın göreceği sonuçların tutarlılığı artırılıyor.
Not
Aynı sessionId değerleri tekrar tekrar yeniden kullanma, isteklerin çoğaltmalar arasında yük dengelemesini etkileyebilir ve arama hizmetinin performansını olumsuz etkileyebilir. sessionId olarak kullanılan değer '_' karakteriyle başlayamaz.
İlgi düzeyini ayarlama
Azure Yapay Zeka Arama'te anahtar sözcük araması ve karma sorgunun metin bölümü için BM25 algoritma parametrelerini yapılandırabilir, ayrıca aşağıdaki mekanizmalarla arama ilgisi ayarlayabilir ve arama puanlarını artırabilirsiniz.
| Yaklaşım | Uygulama | Açıklama |
|---|---|---|
| BM25 algoritma yapılandırması | Arama dizini | Belge uzunluğunun ve terim sıklığının ilgi puanını nasıl etkileyeceğini yapılandırın. |
| Puanlama modelleri | Arama dizini | İçerik özelliklerine göre bir eşleşmenin arama puanını artırmak için ölçütler sağlayın. Örneğin, eşleşmeleri gelir potansiyellerine göre artırabilir, daha yeni öğeleri tanıtabilir veya belki de envanterde çok uzun süre bulunan öğeleri artırabilirsiniz. Puanlama profili, ağırlıklı alanlar, işlevler ve parametrelerden oluşan dizin tanımının bir parçasıdır. Mevcut bir dizini, dizin yeniden derlemesi yapmadan puanlama profili değişiklikleriyle güncelleştirebilirsiniz. |
| Anlamsal derecelendirme | Sorgu isteği | Makine okuma kavramasını arama sonuçlarına uygulayarak daha anlamlı olarak ilgili sonuçları en üste yükseltme. |
| featuresMode parametresi | Sorgu isteği | Bu parametre çoğunlukla BM25 dereceli puanın paketini açmak için kullanılır, ancak özel puanlama çözümü sağlayan kodda için kullanılabilir. |
featuresMode parametresi (önizleme)
Not
featuresMode parametresi REST API'lerinde belgelenmemiştir, ancak BM25 sıralamalı Anahtar Sözcük araması için metin aramak amacıyla önizleme REST API çağrısında kullanabilirsiniz.
Arama Belgeleri (önizleme) istekleri, alan düzeyinde bm25 featuresMode ilgi puanı hakkında daha fazla ayrıntı sağlayan bir parametreyi destekler.
@searchScore belgenin tamamı için hesaplandığı halde (bu belge, bu sorgu bağlamında ne kadar ilgili), featuresMode, @search.features yapısında ifade edildiği gibi, her bir alanla ilgili bilgileri ortaya koyar. Yapı, sorguda kullanılan tüm alanları (sorgudaki searchField'ler aracılığıyla belirli alanlar veya dizinde aranabilir olarak özniteliklendirilen tüm alanları) içerir.
Özellikler için geçerli değerlerMode:
- "none" (varsayılan). Özellik düzeyi puanlama ayrıntıları verilmiyor.
- etkinleştirildi Alan başına ayrıntılı puanlama dökümleri döndürür
Her alan @search.features için aşağıdaki değerleri alırsınız:
- Alanda bulunan benzersiz belirteçlerin sayısı
- Benzerlik puanı veya sorgu terimine göre alanın içeriğinin ne kadar benzer olduğuna ilişkin bir ölçü
- Terim sıklığı veya sorgu teriminin alanda bulunma sayısı
Bu parametre özellikle belirli belgelerin arama sonuçlarında neden daha yüksek veya daha düşük olduğunu anlamaya çalışırken kullanışlıdır. Farklı alanların genel puana nasıl katkı sağlayacağını açıklamaya yardımcı olur.
"Açıklama" alanını hedefleyen bir sorgu için istek aşağıdaki gibi görünebilir:
POST {{baseUrl}}/indexes/hotels-sample/docs/search?api-version=2026-08-01-preview  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}

    {
        "search": "lake view",
        "select": "HotelId, HotelName, Tags, Description",
        "featuresMode": "enabled",
        "searchFields": "Description, Tags",
        "count": true
    }
Bir yanıtın @search.features içermesi, aşağıdaki örneğe benzer olabilir.
  "value": [
    {
      "@search.score": 3.0860271,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 2.0,
          "similarityScore": 3.0860272,
          "termFrequency": 2.0
        }
      },
      "HotelName": "Downtown Mix Hotel",
      "Description": "Mix and mingle in the heart of the city. Shop and dine, mix and mingle in the heart of downtown, where fab lake views unite with a cheeky design.",
      "Tags": [
        "air conditioning",
        "laundry service",
        "free wifi"
      ]
    },
    {
      "@search.score": 2.7294855,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.6023184,
          "termFrequency": 1.0
        },
        "Tags": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.1271671,
          "termFrequency": 1.0
        }
      },
      "HotelName": "Ocean Water Resort & Spa",
      "Description": "New Luxury Hotel for the vacation of a lifetime. Bay views from every room, location near the pier, rooftop pool, waterfront dining & more.",
      "Tags": [
        "view",
        "pool",
        "restaurant"
      ]
    }
  ]
Bu veri noktalarını özel puanlama çözümlerinde kullanabilir veya aramayla ilgili sorunlarda hata ayıklamak için bu bilgileri kullanabilirsiniz.
Tam metin sorgu yanıtında dereceli sonuç sayısı
Varsayılan olarak, sayfalandırma kullanmıyorsanız, arama altyapısı tam metin araması için en yüksek 50 derecelendirme eşleşmesini döndürür. Parametresini top kullanarak daha az veya daha fazla sayıda öğe döndürebilirsiniz (tek bir yanıtta en fazla 1.000). Sonuçları sayfalara ayırmak için skip ve next kullanabilirsiniz. Sayfalama, her mantıksal sayfadaki sonuç sayısını belirler ve içerik gezintisini destekler. Daha fazla bilgi için bkz . Şekil arama sonuçları.
Tam metin sorgunuz karma sorgunun parçasıysa, sorgunun metin tarafındaki sonuç sayısını artıracak veya azaltacak şekilde ayarlayabilirsinizmaxTextRecallSize.
Tam metin araması en fazla 1.000 eşleşme sınırına tabidir (bkz . API yanıt sınırları). 1.000 eşleşme bulunduktan sonra arama motoru artık daha fazlasını aramaz.