Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Note
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
Истинной мерой релевантности является то, насколько хорошо извлеченный набор результатов соответствует вашим потребностям клиента и информации о пользователе. Из этой статьи вы узнаете о следующих возможностях:
- Основные стратегии создания соответствующих результатов в поиске ИИ Azure
- Механика измерения релевантности
- Действия, которые можно предпринять для повышения релевантности
Стратегии для высоко релевантных результатов
В службе "Поиск ИИ Azure" появились две основные стратегии, которые являются лучшими подходами к созданию важных результатов.
- Гибридный поиск с семантическим рангером
- Агентный поиск с планированием запросов на основе LLM (предварительная версия) и синтезом ответов (предварительная версия)
Гибридный поиск (классическая модель) обеспечивает релевантность путем объединения точности запросов ключевых слов и семантического сходства векторных запросов в поисковом запросе, предназначенным для одного индекса. Поиск ключевых слов работает над подробным запросом. Векторный поиск выполняет идентичный запрос, используя векторную версию той же строки. Запросы выполняются параллельно, чтобы находить как точные, так и семантически похожие соответствия. Результаты объединяются, упорядочиваются, а затем пересчитываются с помощью семантического ранжировщика, который выделяет наиболее релевантные совпадения. Использование ключевого слова и векторного поиска вместе смещает слабые места каждого подхода в качестве автономного решения. Семантический рангер — это дополнительный компонент, который способствует лучшему результату.
Агентное извлечение обеспечивает релевантность благодаря планированию запросов на основе LLM (предварительная версия), синтезу ответов (предварительная версия) и базе знаний, которая определяет всю область поиска. LLM может анализировать и преобразовывать запросы для более эффективного извлечения. Он может разложить сложные вопросы в целевые подзапросы, уточнить расплывчатые запросы или обобщить узкие вопросы для более широкой области. В типичной рабочей нагрузке при агентной выборке LLM отвечает на вопрос, используя свои аналитические способности, контекст из истории чата и инструкции по извлечению, чтобы определить самое актуальное содержимое и извлечь из него наибольшую выгоду. Именно сочетание планирования запросов на основе LLM, поиска по базе знаний из нескольких источников и рассуждения с помощью LLM позволяет агентному поиску выдавать высокорелевантные результаты.
Релевантность также зависит от наличия достаточных данных о количестве и качестве. В агентическом извлечении можно перечислить несколько источников знаний, чтобы расширить область поиска и предоставить логику выбора определенных.
Как измеряется релевантность
Независимо от того, как извлекается содержимое, релевантность любого заданного результата определяется алгоритмом ранжирования, который оценивает силу совпадения на основе того, насколько тесно запрос соответствует содержимому в корпусе поиска. При обнаружении совпадения алгоритм назначает оценку и результаты ранжируются по этой оценке, а самые верхние результаты возвращаются в ответе.
Ранжирование происходит всякий раз, когда запрос предназначен для агентного извлечения и классического поиска по ключевым словам, векторам и гибридным запросам. Это не происходит, если запрос вызывает строгое сопоставление шаблонов, например запрос только для фильтра или специализированную форму запроса, например автозавершение, предложения, геопространственный поиск, поиск нечетких выражений или поиск регулярных выражений. Единая оценка поиска 1.0 указывает на отсутствие алгоритма ранжирования.
Уровни ранжирования
Поисковая система в Поиск с использованием ИИ Azure поддерживает многоуровневый подход к ранжированию результатов поиска, где существует встроенная модель ранжирования для каждого типа запроса, а также дополнительные возможности для расширенной настройки релевантности.
В этом разделе описываются уровни операций оценки. Иллюстрация того, как они работают вместе, см. на схеме в этой статье. Сравнение всех типов и диапазонов оценки поиска также представлено в этой статье.
| Level | Description |
|---|---|
| Уровень 1 (L1) | Начальная оценка поиска (@search.score). Для текстовых запросов, соответствующих маркеризованным строкам, результаты всегда ранжируются с помощью алгоритма ранжирования BM25. Для векторных запросов результаты ранжируются с помощью иерархической навигационной структуры Small World (HNSW) или исчерпывающего поиска K-ближайших соседей (KNN). Поиск изображений или многомодальные поиски основаны на векторных запросах и оцениваются с помощью алгоритмов ранжирования векторов L1. |
| Сопряженный L1 | Оценка по нескольким запросам с помощью алгоритма Reciprocal Ranking Fusion (RRF). RRF используется для гибридных запросов, включающих текстовые и векторные компоненты. RRF также используется при параллельном выполнении нескольких векторных запросов. Оценка поиска из RRF отражается в @search.scoreдругом диапазоне. |
| Уровень 2 (L2) |
Семантическая оценка ранжирования (@search.reRankerScore) применяет распознавание машинного чтения к текстовому содержимому, полученному рейтингом L1, перезаписыв результаты L1, чтобы лучше соответствовать семантическому намерению запроса. L2 переупорядочивает результаты L1, так как это позволяет сэкономить время и деньги; было бы слишком дорого использовать семантический рейтинг в качестве системы ранжирования L1. Семантическое ранжирование — это функция уровня "Премиум", которая оплачивает использование семантических моделей ранжирования. Это необязательно для текстовых запросов и векторных запросов, содержащих текст, но обязательно для агентного поиска. Хотя агентское извлечение отправляет несколько запросов в поисковую систему, алгоритм ранжирования для агентского извлечения является семантическим ранжировщиком. |
| Уровень 3 (L3) | Применяется к агентному поиску и medium уровню логических рассуждений при поиске (предварительная версия). Рейтинг L3 относится к итеративному поиску, и он вызывается, когда агентная система извлечения и LLM согласны с тем, что вторичный запрос необходим для возврата более релевантного результата. Дополнительные сведения см. в итеративном поиске для извлечения данных. |
Настройка релевантности
Настройка релевантности — это метод повышения показателей поиска на основе дополнительных критериев, таких как весовые поля, свежесть или близость. В поиске ИИ Azure параметры настройки релевантности зависят от типа запроса:
Для текстового и числового (невектора) содержимого в ключевом слове или гибридном поиске можно настроить релевантность с помощью профилей оценки или вызова семантического рангера.
Для содержимого вектора в гибридном запросе можно взвесить поле вектора , чтобы повысить важность компонента вектора относительно текстового компонента гибридного запроса.
Для чисто векторных запросов можно поэкспериментировать с алгоритмами иерархической навигационной модели малого мира (HNSW) и K-ближайших соседей (KNN), чтобы выяснить, какой алгоритм лучше подходит вашему сценарию. Графирование HNSW с исчерпывающим переопределением KNN во время запроса является самым гибким подходом для тестирования сравнения. Вы также можете экспериментировать с различными моделями внедрения, чтобы увидеть, какие из них создают более качественные результаты. Наконец, помните, что гибридный запрос или векторный запрос к документам, включающим невекторные поля, могут быть настроены на релевантность, поэтому только векторные поля не могут участвовать в процессе настройки релевантности.
Настраиваемая логика повышения рейтинга с помощью профилей оценки
Профили оценки — это необязательная функция повышения показателей на основе дополнительных пользовательских критериев. Критерии могут включать взвешенные поля, в которых совпадение, найденное в определенном поле, имеет больше веса, чем то же совпадение, найденное в другом поле. Критерии также можно определить с помощью функций, повышающих свежесть, близость, величину или диапазон. Дополнительные затраты, связанные с профилями оценки, отсутствуют. Чтобы использовать профиль оценки, необходимо определить его в индексе, а затем указать его в запросе.
Логика оценки применяется к тексту и числовым невекторным содержимому. Профили оценки можно использовать с помощью:
- Поиск текста (ключевого слова)
- Чистые векторные запросы
- Гибридные запросы, в которых текстовые и векторные вложенные запросы выполняются параллельно
- Семантически ранжированные запросы
Для автономных текстовых запросов профили оценки определяют первые 1000 совпадений в поиске по рейтингу BM25, при этом в ответе возвращаются первые 50 совпадений.
Для чистых векторов запрос касается только векторов, но если документы, соответствующие по k-значению, включают невекторные поля с читаемым человеком содержимым, к невекторным полям в этих документах применяется оценочный профиль.
Для текстового компонента гибридного запроса профили ранжирования определяют первые 1000 совпадений в поиске по BM25. Однако после идентификации этих 1000 результатов они восстанавливаются в их исходном порядке BM25, чтобы их можно было повторно оценивать вместе с результатами по векторам, что приводит к окончательному упорядочению с использованием функции обратного ранжирования (RRF), где профиль оценки (обозначенный как "окончательная корректировка усиления документа" на рисунке) применяется к объединенным результатам, а также взвешивание векторов и семантическое ранжирование в качестве последнего шага.
Для семантически ранжированных запросов (не показанных на схеме), если вы используете последнюю предварительную версию REST API или предварительный просмотр пакета azure SDK, профили оценки можно применить к результирующем набору L2, создав новый @search.rerankerBoostedScore , определяющий окончательный рейтинг.
Типы показателей поиска
Результаты с оценкой указываются для каждого совпадения в ответе запроса. В этой таблице перечислены все оценки поиска с соответствующим диапазоном. Диапазон зависит от алгоритма.
| Score | Range | Algorithm |
|---|---|---|
@search.score |
От 0 до неограниченного | Алгоритм ранжирования BM25 для поиска текста |
@search.score |
0.333 - 1.00 | Алгоритм HNSW или исчерпывающий алгоритм KNN для поиска векторов |
@search.score |
От 0 до верхнего предела, определяемого числом запросов | Алгоритм RRF |
@search.rerankerScore |
0.00 - 4.00 | Алгоритм семантического ранжирования для L2-рейтингования |
@search.rerankerBoostedScore |
От 0 до неограниченного | Семантическое ранжирование с повышением профиля оценки (оценки могут быть значительно выше 4) |
Схема алгоритмов ранжирования
На следующей схеме показано, как работают алгоритмы ранжирования.
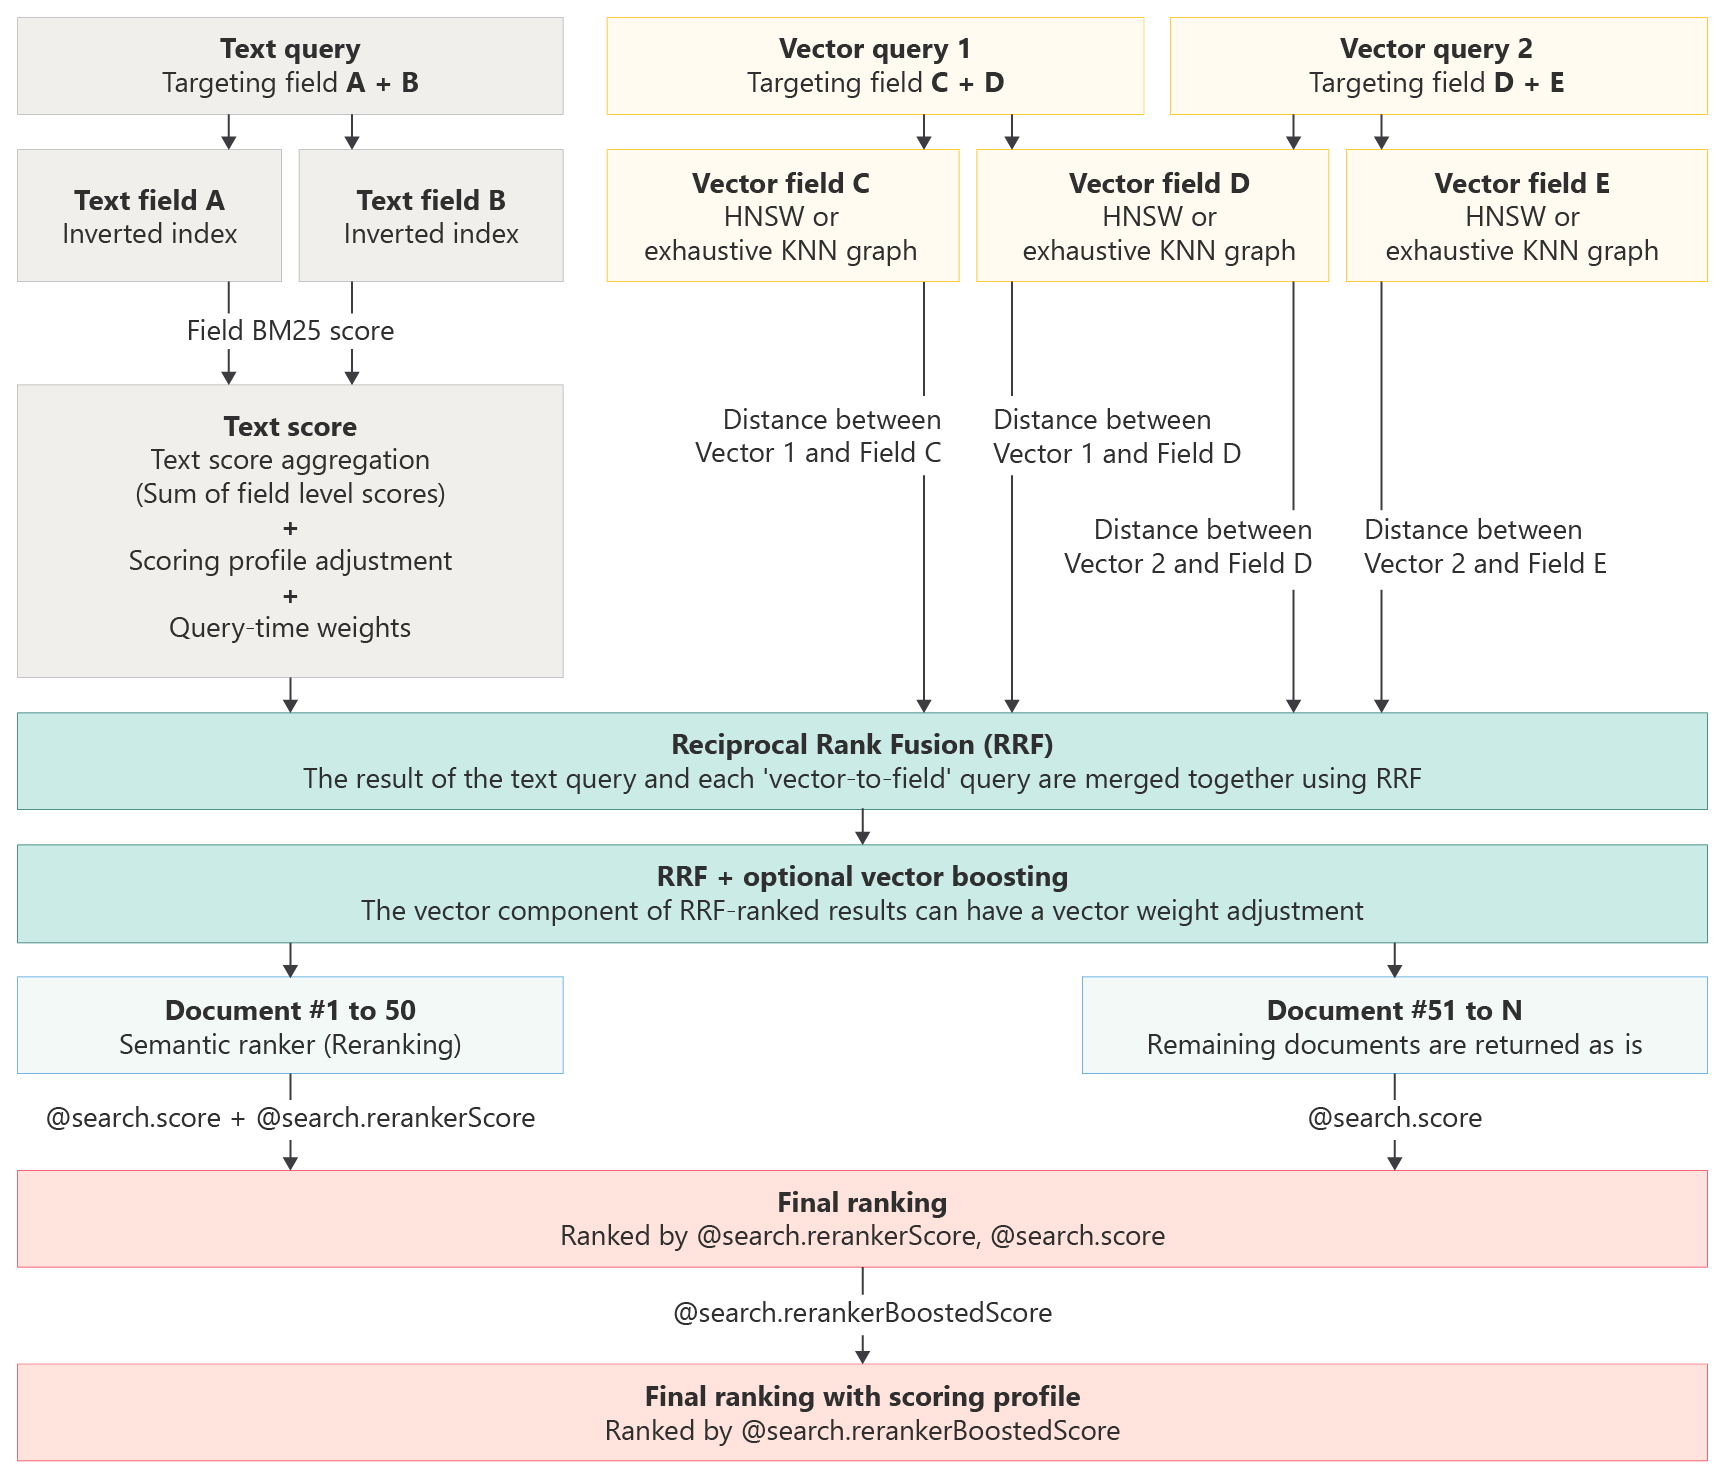
Note
При использовании семантического ранжирования свойство Order определяет, являются ли результаты семантически оцененными результатами (@search.rerankerScore) или увеличенными оценками (@search.rerankerBoostedScore), которые создаются после применения профиля оценки.
Пример запроса, включающего все алгоритмы ранжирования
Следующий гибридный семантический запрос демонстрирует рабочий процесс ранжирования на предыдущей схеме. Запрос оценивается с помощью RRF (на основе показателей L1 для текста и векторов), а затем семантического ранжирования.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-08-01-preview

{
  "search": "cloud formation over water",
  "count": true,
  "vectorQueries": [
    {
      "kind": "text",
      "text": "cloud formation over water",
      "fields": "text_vector,image_vector"
    }
  ],
  "queryType": "semantic",
  "semanticConfiguration": "my-semantic-configuration",
  "select": "title,chunk",
  "top": 5
}
Ответ на гибридный семантический запрос включает исходный RRF @search.score и @search.rerankerScore.
  "value": [
    {
      "@search.score": 0.03177805617451668,
      "@search.rerankerScore": 2.6919238567352295,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n32\n\nFraming an Iceberg\nSouth Atlantic Ocean\n\nIn June 2016, the Suomi NPP satellite captured this image of various cloud formations in the South Atlantic Ocean. Note how low \n\nstratus clouds framed a hole over iceberg A-56 as it drifted across the sea. \n\nThe exact reason for the hole in the clouds is somewhat of a mystery. It could have formed by chance, although imagery from the \n\ndays before and after this date suggest something else was at work. It could be that the relatively unobstructed path of the clouds \n\nover the ocean surface was interrupted by thermal instability created by the iceberg. In other words, if an obstacle is big enough,  \n\nit can divert the low-level atmospheric flow of air around it, a phenomenon often caused by islands.",
      "title": "page-39.pdf",
    },
    {
      "@search.score": 0.030621785670518875,
      "@search.rerankerScore": 2.557225465774536,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n24\n\nMaking Tracks\nPacific Ocean\n\nShips steaming across the Pacific Ocean left this cluster of bright cloud trails lingering in the atmosphere in February 2012. The \n\nnarrow clouds, known as ship tracks, form when water vapor condenses around tiny particles of pollution from ship exhaust. The \n\ncrisscrossing clouds off the coast of California stretched for many hundreds of kilometers from end to end. The narrow ends of the \n\nclouds are youngest, while the broader, wavier ends are older.\n\nSome of the pollution particles generated by ships (especially sulfates) are soluble in water and can serve as the seeds around which \n\ncloud droplets form. Clouds infused with ship exhaust have more and smaller droplets than unpolluted clouds. As a result, light \n\nhitting the ship tracks scatters in many directions, often making them appear brighter than other types of marine clouds, which are \n\nusually seeded by larger, naturally occurring particles like sea salt.",
      "title": "page-31.pdf",
    },
    {
      "@search.score": 0.013698630034923553,
      "@search.rerankerScore": 2.515575408935547,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n16\n\nRiding the Waves\nMauritania\n\nYou cannot see it directly, but air masses from Africa and the Atlantic Ocean are colliding in this Landsat 8 image from August 2016. \n\nThe collision off the coast of Mauritania produces a wave structure in the atmosphere. \n\nCalled an undular bore or solitary wave, this cloud formation was created by the interaction between cool, dry air coming off the \n\ncontinent and running into warm, moist air over the ocean. The winds blowing out from the land push a wave of air ahead like a  \n\nbow wave moving ahead of a boat. \n\nParts of these waves are favorable for cloud formation, while other parts are not. The dust blowing out from Africa appears to be \n\nriding these waves. Dust has been known to affect cloud growth, but it probably has little to do with the cloud pattern observed here.",
      "title": "page-23.pdf",
    },
    {
      "@search.score": 0.028949543833732605,
      "@search.rerankerScore": 2.4990925788879395,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n14\n\nBering Streets\nArctic Ocean\n\nWinds from the northeast pushed sea ice southward and formed cloud streets—parallel rows of clouds—over the Bering Strait in \n\nJanuary 2010. The easternmost reaches of Russia, blanketed in snow and ice, appear in the upper left. To the east, sea ice spans \n\nthe Bering Strait. Along the southern edge of the ice, wavy tendrils of newly formed, thin sea ice predominate.\n\nThe cloud streets run in the direction of the northerly wind that helps form them. When wind blows out from a cold surface like sea \n\nice over the warmer, moister air near the open ocean, cylinders of spinning air may develop. Clouds form along the upward cycle in \n\nthe cylinders, where air is rising, and skies remain clear along the downward cycle, where air is falling. The cloud streets run toward \n\nthe southwest in this image from the Terra satellite.",
      "title": "page-21.pdf",
    },
    {
      "@search.score": 0.027637723833322525,
      "@search.rerankerScore": 2.4686081409454346,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n38\n\nLofted Over Land\nMadagascar\n\nAlong the muddy Mania River, midday clouds form over the forested land but not the water. In the tropical rainforests of Madagascar, \n\nthere is ample moisture for cloud formation. Sunlight heats the land all day, warming that moist air and causing it to rise high into the \n\natmosphere until it cools and condenses into water droplets. Clouds generally form where air is ascending (over land in this case), \n\nbut not where it is descending (over the river). Landsat 8 acquired this image in January 2015.",
      "title": "page-45.pdf",
    }
  ]