Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание.
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
В этой статье объясняется алгоритм оценки релевантности BM25, используемый для вычисления показателей поиска для полнотекстового поиска. Релевантность BM25 применяется только к полнотекстовом поиску. Фильтрация запросов, автозаполнение и предлагаемые запросы, поиск подстановочных знаков и нечеткие поисковые запросы не оцениваются или ранжируются по релевантности.
Алгоритмы оценки, используемые в полнотекстовом поиске
Поиск ИИ Azure предоставляет следующие алгоритмы оценки для полнотекстового поиска:
| Алгоритм | Использование | Диапазон |
|---|---|---|
BM25Similarity |
Исправлен алгоритм для всех служб поиска, созданных после июля 2020 года. Этот алгоритм можно настроить, но вы не можете переключиться на более старый (классический). | Неограниченный. |
ClassicSimilarity |
Значение по умолчанию для старых служб поиска, предшествующих июлю 2020 г. На более старых службах вы можете включить BM25 и выбрать алгоритм BM25 для каждого индекса. | 0 < 1,00 |
BM25 и Classic — это функции извлечения TF-IDF, которые используют частоту терминов (TF) и обратную частоту документа (IDF) в качестве переменных для вычисления показателей релевантности для каждой пары запросов к документу, которая затем используется для ранжирования результатов. Хотя концептуально похоже на классическую модель, BM25 основан на вероятностном извлечении информации, что создает более интуитивно понятные совпадения, что подтверждается исследованиями пользователей.
BM25 предлагает расширенные параметры настройки, например разрешить пользователю решить, как масштабируются оценки релевантности с частотой соответствующих терминов.
Как работает ранжирование BM25
Оценка релевантности относится к вычислению оценки поиска (@search.score), которая служит индикатором релевантности элемента в контексте текущего запроса. Диапазон неограничен. Тем не менее, чем выше оценка, тем более релевантный элемент.
Оценка поиска вычисляется на основе статистических свойств строковых входных данных и самого запроса. Поиск ИИ Azure находит документы, соответствующие условиям поиска (некоторые или все в зависимости от searchMode), предпочитающие документы, содержащие множество экземпляров термина поиска. Оценка поиска возрастает, если условие поиска редко встречается в индексе данных, но часто — внутри документа. Основу для такого подхода к вычислению релевантности называют TF-IDF или частотой условия — инверсная частота в документе.
Оценки поиска могут повторяться в результирующем наборе. Если несколько попаданий имеют одинаковую оценку поиска, порядок элементов с одинаковыми оценками не определен и нестабилен. Запустите запрос еще раз, и вы, возможно, увидите изменение положения элементов, особенно если вы используете бесплатную услугу или платную услугу с несколькими репликами. Учитывая два элемента с одинаковым показателем, нет никакой гарантии того, что он отображается в первую очередь.
Чтобы разрешить ситуацию с дублирующимися оценками, вы можете добавить предложение $orderby для первоначальной сортировки по оценке, затем по другому полю, доступному для сортировки (например, $orderby=search.score() desc,Rating desc).
Для оценки используются только поля, помеченные как в searchable индексе или в searchFields запросе. В результатах поиска возвращаются только поля, помеченные как retrievable, или поля, указанные в select в запросе, вместе с их оценкой поиска.
Примечание.
@search.score = 1 указывает на набор результатов без оценивания или без ранжирования. Оценка одинакова для всех результатов. Результаты без оценки возникают, когда форма запроса является нечетким поиском, использованием подстановочных знаков или запросами регулярных выражений, или пустым поиском (search=*), иногда сопряженным с фильтрами, где фильтр является основным средством для возврата совпадения.
Следующий сегмент видео перематывает вперед к объяснению алгоритмов ранжирования, доступных всем, используемых в Поиск с использованием ИИ Azure. Дополнительные сведения можно получить, просмотрев полное видео.
Оценки в текстовых результатах
Каждый раз, когда результаты ранжируются, свойство содержит значение, @search.score используемое для упорядочивания результатов.
В следующей таблице определяется свойство оценки, алгоритм и диапазон.
| Метод поиска | Параметр | Алгоритм оценки | Диапазон |
|---|---|---|---|
| полнотекстовый поиск | @search.score |
Алгоритм BM25 с использованием параметров, указанных в индексе. | Неограниченный. |
Изменение оценки
Показатели поиска дают общее представление о релевантности, отражающее качество совпадений относительно других документов в том же результирующем наборе. Оценки не всегда согласованы от одного запроса к другому, поэтому при работе с запросами вы можете заметить небольшие расхождения в том, как происходит упорядочивание документов в поиске. Существует несколько объяснений, почему это может произойти.
| Причина | Описание |
|---|---|
| Идентичные результаты | Если несколько документов имеют одинаковый рейтинг, то один из них может появиться первым. |
| Изменчивость данных | Содержимое индекса меняется по мере того, как вы добавляете, изменяете или удаляете документы. Частота терминов изменяется при обработке обновлений индекса с течением времени, что влияет на показатели поиска соответствующих документов. |
| Несколько копий | Для служб, использующих несколько реплик, запросы к каждой реплике выдаются параллельно. Статистика индекса, используемая для вычисления оценки показателей поиска, вычисляется отдельно для каждой реплики, а результаты объединяются и упорядочиваются в ответе на запрос. Реплики в основном являются зеркальным отражением друг друга, но статистика может отличаться из-за наличия небольших различий в состоянии. Например, одна реплика могла удалить документы, участвующие в статистике, которые были объединены из других реплик. Как правило, различия в статистике на каждую реплику более заметны в небольших индексах. В следующем разделе приведены дополнительные сведения об этом условии. |
Влияние сегментирования на результаты запроса
Сегмент — это блок индекса. Поиск ИИ Azure подразделяет индекс на сегменты , чтобы ускорить процесс добавления секций (путем перемещения сегментов в новые единицы поиска). В службе поиска управление шардами — это деталь реализации и неконфигурируемое, но зная, что индекс расшарден, помогает разобраться в случайных аномалиях в поведении ранжирования и автозаполнения.
Аномалии с ранжированием: рейтинг поиска сначала рассчитывается на уровне сегментов, а затем объединяется в результирующий набор. В зависимости от особенностей содержимого шардов совпадения в одном шарде могут ранжироваться выше, чем в другом. Если вы заметите неинтуитивные ранжировки в результатах поиска, скорее всего, это связано с эффектами шардирования, особенно если индексные данные малы. Чтобы избежать подобных аномалий, перейдите на глобальный расчет рейтингов по всему индексу, но это приведет к снижению производительности.
Аномалии с автозаполнением: запросы автозаполнения, где совпадения подбираются по первым нескольким символам частично введенного ключевого слова, принимают параметр нечеткого соответствия, который допускает небольшие отклонения в написании. Для автозаполнения нечеткие совпадения возможны только по терминам в пределах текущего сегмента. Например, если шард содержит "Майкрософт" и введён частичный термин "micro", поисковая система сопоставит с "Майкрософт" в этом шарде, но не в других шардах, которые содержат оставшиеся части индекса.
На схеме ниже показана связь между репликами, секциями, сегментами и единицами поиска. Пример демонстрирует, как один индекс охватывает четыре единицы поиска в службе с двумя репликами и двумя разделами. В каждой из четырех единиц поиска хранится только половина сегментов индекса. В поисковых блоках в левом столбце хранится первая половина шардов, составляющая первую секцию, в то время как в правом столбце хранится вторая половина шардов, составляющая вторую секцию. Поскольку существует две реплики, у каждого шарда индекса по две копии. В единицах поиска в верхней строке хранится одна копия, составляющая первую реплику, а в нижней строке — вторая копия, представляющая вторую реплику.
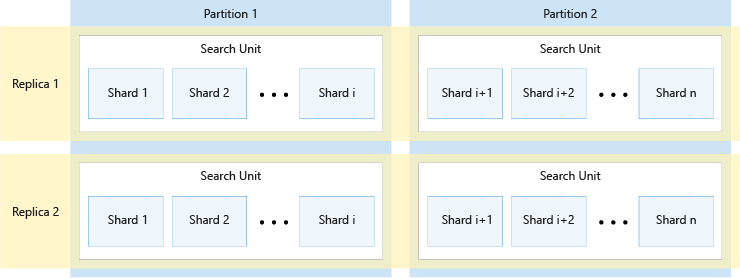
На схеме выше показан лишь один пример. Поддерживаются различные комбинации партиций и реплик, до максимума в 36 единиц поиска.
Примечание.
Количество реплик и разделов должно равномерно распределяться на 12 (а именно, 1, 2, 3, 4, 6, 12). Поиск по искусственному интеллекту Azure предварительно делит каждый индекс на 12 сегментов, чтобы его можно было распределять по равным частям по всем секциям. Например, если в вашей службе есть три секции и вы создаете индекс, то каждая секция будет содержать по четыре сегмента индекса. Как Поиск с использованием ИИ Azure сегментирует индекс — это деталь реализации, которая может измениться в будущих выпусках. Несмотря на то, что сегодня это число 12, вам не следует полагаться на то, что в будущем оно не изменится.
Статистика начисления очков и «липкие» сессии
Для масштабируемости поиск ИИ Azure распределяет каждый индекс по горизонтали через процесс сегментирования, что означает, что части индекса физически отделены.
По умолчанию оценка документа вычисляется на основе статистических свойств данных в сегменте. Этот подход, как правило, не является проблемой для большого объема данных. Он обеспечивает лучшую производительность, чем вычисление оценки на основе информации по всем сегментам. Тем не менее, использование этой оптимизации производительности может привести к тому, что два очень похожих (или даже идентичных) документа будут иметь разные оценки релевантности, если они окажутся в разных сегментах.
Если вы предпочитаете вычислить оценку на основе статистических свойств для всех сегментов, это можно сделать, добавив scoringStatistics=global в качестве параметра запроса (или добавьте в качестве основного "scoringStatistics": "global" запроса).
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "scoringStatistics": "global"
}
Использование scoringStatistics гарантирует, что все сегменты в одной реплике предоставляют одинаковые результаты. Однако, следует отметить, что разные реплики могут немного отличаться друг от друга, так как они всегда обновляются с последними изменениями в вашем индексе. В некоторых сценариях может потребоваться, чтобы пользователи могли получать более согласованные результаты во время сеанса запроса. В таких случаях вы можете предоставить sessionId как часть запросов.
sessionId является уникальной строкой, которую вы создаете для ссылки на уникальный сеанс пользователя.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "sessionId": "<string>"
}
До тех пор, пока используется тот же sessionId, прилагаются усилия, чтобы целиться на ту же реплику, что увеличивает согласованность результатов, которые будут видеть ваши пользователи.
Примечание.
Повторное использование одних и тех же значений sessionId может повлиять на балансировку нагрузки запросов по репликам, а также негативно повлиять на производительность службы поиска. Значение, используемое в качестве sessionId, не может начинаться с символа "_".
Настройка релевантности
В службе "Поиск ИИ Azure" для поиска ключевых слов и текстовой части гибридного запроса можно настроить параметры алгоритма BM25, а также настроить релевантность поиска и повысить оценку поиска с помощью следующих механизмов.
| Подход | Внедрение | Описание |
|---|---|---|
| Конфигурация алгоритма BM25 | Поисковый индекс | Настройте, как длина документа и частота терминов влияют на оценку релевантности. |
| Оценочные профили | Поисковый индекс | Укажите критерии повышения оценки поиска соответствия на основе характеристик контента. Например, вы можете повысить совпадения на основе их потенциала дохода, повысить новые элементы или, возможно, увеличить элементы, которые были в инвентаризации слишком долго. Профиль оценки — часть определения индекса, состоящая из взвешенных полей, функций и параметров. Можно обновить существующий индекс с изменениями профиля оценки без перестроения индекса. |
| Семантическое ранжирование | Запрос на выполнение запроса | Применяет понимание машинного чтения к результатам поиска, выводя семантически релевантные результаты на первые позиции. |
| Параметр featuresMode | Запрос на выполнение запроса | Этот параметр в основном используется для распаковки оценки BM25, но его можно использовать в коде, предоставляющем решение для пользовательской оценки. |
Параметр featuresMode (предварительная версия)
Примечание.
Параметр featuresMode не задокументирован в REST API, но его можно использовать в предварительном вызове REST API для поиска документов по тексту (ключевому слову), который ранжируется по BM25.
Запросы на поиск документов (предварительная версия) поддерживают featuresMode параметр, предоставляющий дополнительные сведения о оценке релевантности BM25 на уровне поля. @searchScore В то время как @searchScore вычисляется для документа в целом (насколько документ релевантен в контексте этого запроса), режим функций показывает сведения о отдельных полях, как это выражено в структуре . В этой структуре содержатся все поля, используемые в запросе (определенные поля используются с помощью конструкции searchFields из запроса или все поля с атрибутом доступные для поиска в индексе).
Допустимые значения для featuresMode:
- "none" (по умолчанию). Сведения о оценке на уровне компонентов не возвращаются.
- "включено". Возвращает подробную разбивку оценок по полям
Для каждого поля @search.features укажите следующие значения:
- Число уникальных токенов, найденных в поле
- Оценка подобия или мера того, насколько содержимое поля сходно с термином из запроса
- Частота термина или количество раз, когда термин из запроса был найден в поле
Этот параметр особенно полезен при попытке понять, почему некоторые документы ранжируется выше или ниже в результатах поиска. Это помогает объяснить, как различные поля способствуют общей оценке.
Для запроса, предназначенного для поля описания, запрос может выглядеть следующим образом:
POST {{baseUrl}}/indexes/hotels-sample/docs/search?api-version=2026-08-01-preview  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}

    {
        "search": "lake view",
        "select": "HotelId, HotelName, Tags, Description",
        "featuresMode": "enabled",
        "searchFields": "Description, Tags",
        "count": true
    }
Ответ, который включает в себя @search.features, возможно, будет выглядеть как следующий пример.
  "value": [
    {
      "@search.score": 3.0860271,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 2.0,
          "similarityScore": 3.0860272,
          "termFrequency": 2.0
        }
      },
      "HotelName": "Downtown Mix Hotel",
      "Description": "Mix and mingle in the heart of the city. Shop and dine, mix and mingle in the heart of downtown, where fab lake views unite with a cheeky design.",
      "Tags": [
        "air conditioning",
        "laundry service",
        "free wifi"
      ]
    },
    {
      "@search.score": 2.7294855,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.6023184,
          "termFrequency": 1.0
        },
        "Tags": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.1271671,
          "termFrequency": 1.0
        }
      },
      "HotelName": "Ocean Water Resort & Spa",
      "Description": "New Luxury Hotel for the vacation of a lifetime. Bay views from every room, location near the pier, rooftop pool, waterfront dining & more.",
      "Tags": [
        "view",
        "pool",
        "restaurant"
      ]
    }
  ]
Вы можете использовать эти величины в пользовательских решениях оценки или применить эту информацию для отладки проблем, связанных с релевантностью поиска.
Число ранжированных результатов в ответе полнотекстового запроса
По умолчанию, если вы не используете разбиение на страницы, поисковая система возвращает 50 самых высоких совпадений для полнотекстового поиска. Параметр можно использовать top для возврата меньшего или большего числа элементов (до 1000 в одном ответе). Вы можете использовать skip и next для разбивки результатов на страницы. Разбиение на страницы определяет количество результатов на каждой логической странице и поддерживает навигацию по содержимому. Дополнительные сведения см. в результатах поиска фигур.
Если полнотекстовый запрос является частью гибридного запроса, можно maxTextRecallSize задать для увеличения или уменьшения количества результатов из текстовой стороны запроса.
Полнотекстовый поиск имеет максимальное ограничение в 1000 совпадений (см . ограничения ответа API). После того как найдены 1000 совпадений, поисковая система больше не ищет.