Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
Полнотекстовый поиск — это подход к получению информации, которая соответствует обычному тексту, хранящемуся в индексе. Например, учитывая строку запроса "отели в Сан-Диего на пляже", поисковая система ищет токенизованные строки на основе этих терминов. Чтобы сделать сканирование более эффективным, строки запроса проходят лексический анализ: приведение всех терминов к нижнему регистру, удаление стоп-слов, таких как "the", и приведение терминов к их примитивным корневым формам. При обнаружении соответствующих терминов поисковая система извлекает документы, ранжирует их по порядку релевантности и возвращает первые результаты.
Выполнение запроса может быть сложным. Эта статья предназначена для разработчиков, которым требуется более глубокое понимание того, как работает полнотекстовый поиск в Поиск с использованием ИИ Azure. Для текстовых запросов Поиск с использованием ИИ Azure гладко выдает ожидаемые результаты в большинстве случаев, но иногда вы можете получить результат, который кажется "не совсем таким". В таких ситуациях, иметь опыт в четырех этапах выполнения запроса Lucene (анализ запросов, лексический анализ, сопоставление документов и ранжирование) может помочь вам определить конкретные изменения параметров запроса или конфигурации индекса, которые создают нужный результат.
Примечание
Поиск с использованием ИИ Azure использует Apache Lucene для полнотекстового поиска, но интеграция Lucene не является исчерпывающей. Мы выборочно предоставляем и расширяем функциональные возможности Lucene, чтобы поддерживать сценарии, важные для Поиск с использованием ИИ Azure.
Обзор архитектуры и схема
Выполнение запроса состоит из четырех этапов:
- Синтаксический анализ запросов
- Лексический анализ
- Извлечение документов
- Оценка
Запрос полнотекстового поиска начинается с анализа текста запроса для извлечения терминов и операторов поиска. Существует два средства синтаксического анализа, чтобы выбрать между скоростью и сложностью. Этап анализа будет следующим, где отдельные термины запросов иногда разбиваются и переосмысливаются в новых формах. Этот шаг помогает расширить охват и определить, что можно рассматривать как потенциальное соответствие. Затем поисковая система сканирует индекс, чтобы найти документы с соответствующими терминами и оценивает каждое совпадение. Затем результирующий набор сортируется по оценке релевантности, назначенной каждому отдельному документу сопоставления. Те, кто находятся в верхней части ранжированного списка, возвращаются вызывающему приложению.
На следующей схеме показаны компоненты, используемые для обработки запроса поиска:
схема архитектуры запросов 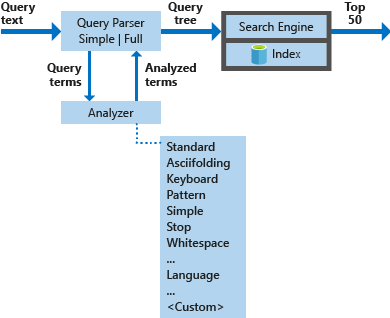
| Ключевые компоненты | Функциональное описание |
|---|---|
| Средства синтаксического анализа запросов | Разделите термины запросов от операторов запросов и создайте структуру запроса (дерево запросов), которая будет отправлена поисковой системе. |
| Анализаторы | Выполните лексический анализ терминов запроса. Этот процесс может включать преобразование, удаление или расширение терминов запроса. |
| Индекс | Эффективная структура данных, используемая для хранения и упорядочивания терминов поиска, извлеченных из индексированных документов. |
| Поисковая система | Извлекает и оценивает соответствующие документы на основе содержимого инвертированного индекса. |
Анатомия запроса поиска
Поисковый запрос — это полная спецификация возвращаемого в результирующем наборе. В самой простой форме это пустой запрос без критериев любого вида. Более реалистичный пример включает параметры, несколько терминов запроса, возможно, в пределах определенных полей, с выражением фильтра и правилами сортировки.
Следующий пример — это запрос поиска, который можно отправить Поиск с использованием ИИ Azure с помощью API REST:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Для этого запроса поисковая система выполняет следующие операции:
Находит документы, где цена составляет не менее $60 и менее $ 300.
Выполняет запрос. В этом примере поисковый запрос состоит из фраз и терминов:
"Spacious, air-condition* +\"Ocean view\""(Обычно пользователи не вводят пунктуацию, но в том числе в примере, мы можем объяснить, как анализаторы обрабатывают его.)Для этого запроса поисковая система сканирует поля описания и заголовка, указанные в searchFields, для документов, содержащих
"Ocean view", а также на термин"spacious"или на термины, начинающиеся с префикса"air-condition". Параметр searchMode используется для сопоставления с любым термином (по умолчанию) или всеми из них, в тех случаях, когда термин не является явным образом обязательным (+).Упорядочивает результирующий набор отелей по степени близости к указанному географическому местоположению, а затем возвращает результаты вызывающему приложению.
Большая часть этой статьи заключается в обработке поискового запроса: "Spacious, air-condition* +\"Ocean view\"" Фильтрация и упорядочение не предусмотрены. Дополнительные сведения см. в справочной документации по API поиска.
Этап 1. Синтаксический анализ запросов
Как отмечалось, строка запроса является первой строкой запроса:
"search": "Spacious, air-condition* +\"Ocean view\"",
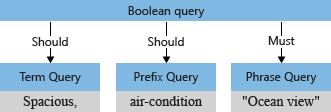
Средство синтаксического анализа запросов отделяет операторы (например * , и + в примере) от условий поиска и деконструирует поисковый запрос в вложенные запросы поддерживаемого типа:
- запрос терминов для автономных терминов (например, просторный)
- поисковый запрос для фраз в кавычках (например, "вид на океан")
-
запрос префикса для терминов, за которыми следует префиксный оператор
*(например, кондиционирование воздуха)
Полный список поддерживаемых типов запросов см. в синтаксисе запросов Lucene.
Операторы, связанные с вложенным запросом, определяют, должен ли запрос "должен быть" или "может быть" удовлетворен, чтобы документ считался совпадением. Например, +"Ocean view" — это "обязательно" из-за оператора +.
Средство синтаксического анализа запросов реструктурирует вложенные запросы в дерево запросов (внутренняя структура, представляющая запрос), который передается поисковой системе. На первом этапе синтаксического анализа запроса дерево запросов выглядит следующим образом:
Поддерживаемые средства синтаксического анализа: Simple и Full Lucene
Поиск с использованием ИИ Azure предоставляет два разных языка запросов: simple (по умолчанию) и full. Задав параметр queryType с запросом поиска, вы сообщаете синтаксическому анализатору запросов, какой язык запроса вы выбираете, чтобы он знал, как интерпретировать операторы и синтаксис.
Язык простых запросов является интуитивно понятным и надежным, часто подходит для интерпретации пользовательских входных as-is без обработки на стороне клиента. Он поддерживает операторы запросов, которые знакомы пользователям веб-поисковых систем.
Язык запросов Full Lucene, который вы получаете по параметру
queryType=full, расширяет язык простых запросов по умолчанию, добавив поддержку для дополнительных операторов и типов запросов, таких как подстановочные знаки, нечеткие, regex и запросы с областью полей. Например, регулярное выражение, отправленное в синтаксисе простого запроса, интерпретируется как строка запроса, а не выражение. В примере запроса в этой статье используется язык запросов Full Lucene.
Влияние searchMode на средство синтаксического анализа
Другим параметром запроса поиска, влияющим на синтаксический анализ, является параметр searchMode. Он управляет оператором по умолчанию для логических запросов: любой (по умолчанию) или все.
Если "searchMode=any", который является значением по умолчанию, разделитель пространства между просторным и кондиционером имеет значение OR (||), что эквивалентно тексту примера запроса:
Spacious,||air-condition*+"Ocean view"
Явные операторы, такие как +, однозначны при логическом построении запросов: термин +"Ocean view" должен соответствовать шаблону. Менее очевидным является то, как интерпретировать оставшиеся термины: просторный и кондиционер. Должна ли поисковая система найти совпадения по виду на океан и просторным и с кондиционером? Или он должен найти вид океана плюс любой из оставшихся терминов?
По умолчанию ("searchMode=any"), поисковая система предполагает более широкую интерпретацию. Любое поле должно соответствовать, отражая семантику "или". Первоначальное дерево запросов, иллюстрированное ранее, с двумя операциями "должен", показывает значение по умолчанию.
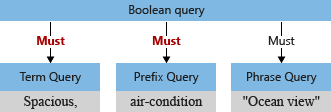
Предположим, что теперь задано значение searchMode=all. В этом случае пространство интерпретируется как операция "и". Оба оставшихся термина должны присутствовать в документе, для того чтобы считаться совпадением. Результирующий пример запроса будет интерпретирован следующим образом:
+Spacious,+air-condition*+"Ocean view"
Измененное дерево запросов для этого запроса, где соответствующий документ является пересечением всех трех подзапросов, будет выглядеть следующим образом:
Примечание
Выбор "searchMode=any" на "searchMode=all" — это решение, лучше всего принятое путем выполнения репрезентативных запросов. Пользователи, которые, вероятно, включат операторы (что часто бывает при поиске в хранилищах документов), могут найти результаты более интуитивно понятными, если searchMode=all служит для настройки логических конструкций запросов. Дополнительные сведения о взаимодействии между searchMode и операторами см. в разделе "Простой синтаксис запроса".
Этап 2. Лексический анализ
Лексические анализаторы обрабатывают запросы терминов и запросы фраз после структуры дерева запросов. Анализатор принимает текстовые входные данные, предоставленные ему анализатором, обрабатывает текст, а затем отправляет обратно маркеризованные термины, которые будут включены в дерево запросов.
Наиболее распространенной формой лексического анализа является лингвистический анализ, который преобразует термины запросов на основе правил, относящихся к заданному языку. Это включает в себя:
- Сокращение термина запроса к корневой форме слова.
- Удаление неважных слов (стоп-слов, таких как "the" или "and" на английском языке).
- Разделение составного слова на составные части.
- Преобразование заглавного слова в строчные буквы.
Все эти операции, как правило, удаляют различия между входными данными текста, предоставленными пользователем, и терминами, хранящимися в индексе. Такие операции выходят за рамки обработки текста и требуют глубокого знания о самом языке. Чтобы добавить этот уровень лингвистической осведомленности, Поиск с использованием ИИ Azure поддерживает длинный список анализаторов language от Lucene и Microsoft.
Примечание
В зависимости от вашего сценария требования к анализу могут варьироваться от минимального до сложного. Вы можете управлять сложностью лексического анализа, выбрав один из предопределенных анализаторов или создав собственный анализатор custom. Анализаторы относятся к полям с возможностью поиска и задаются как часть определения поля. Это позволяет изменять лексический анализ в зависимости от поля. Если не указано, используется стандартный анализатор Lucene.
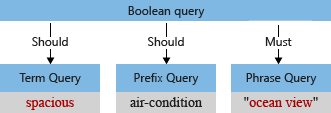
В нашем примере перед анализом исходное дерево запросов имеет термин "Просторный", с верхним регистром "S" и запятой, которую средство синтаксического анализа запросов интерпретирует как часть термина запроса (запятая не считается оператором языка запросов).
Когда анализатор по умолчанию обрабатывает термин, он переведет в нижний регистр "вид на океан" и "просторное" и удалит символ запятой. Измененное дерево запросов выглядит следующим образом:
Тестирование поведения анализатора
Поведение анализатора можно проверить с помощью API анализа. Укажите текст, который нужно проанализировать, чтобы узнать, какие термины генерирует данный анализатор. Например, чтобы узнать, как стандартный анализатор обработает текст "условие воздуха", можно выполнить следующий запрос:
{
    "text": "air-condition",
    "analyzer": "standard"
}
Стандартный анализатор разбивает входной текст на следующие два токена, аннотируя их атрибутами, такими как начальные и конечные смещения (используемые для выделения попаданий), а также их позиции (используется для сопоставления фраз):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Исключения для лексического анализа
Лексический анализ применяется только к типам запросов, которым требуются полные термины, запрос терминов или запрос фразы. Он не применяется к типам запросов с неполными терминами (запрос префикса, запрос с подстановкой, запрос регулярного выражения) или к нечеткому запросу. Эти типы запросов, включая запрос префикса с термином air-condition* в нашем примере, добавляются непосредственно в дерево запросов, обходя этап анализа. Единственное преобразование, выполняеме с точки зрения запросов этих типов, — снижение.
Этап 3. Извлечение документов
Извлечение документов относится к поиску документов с соответствующими терминами в индексе. Этот этап лучше всего понятен с помощью примера. Начнем с индекса отелей, имеющего следующую простую схему:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Далее предположим, что этот индекс содержит следующие четыре документа:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Индексирование терминов
Чтобы понять извлечение, это помогает узнать несколько основных принципов индексирования. Единица хранилища — это инвертируемый индекс, по одному для каждого поля, доступного для поиска. В инвертированном индексе содержится отсортированный список всех терминов из всех документов. Каждый термин сопоставляется со списком документов, в которых она возникает, как показано в приведенном ниже примере.
Чтобы создать термины в инвертированного индекса, поисковая система выполняет лексический анализ содержимого документов, аналогично тому, что происходит во время обработки запросов:
- Текстовые вводы передаются анализатору, преобразуются в нижний регистр, очищаются от знаков препинания и т. д., в зависимости от конфигурации анализатора.
- Маркеры — это выходные данные лексического анализа.
- Термины добавляются в индекс.
Обычное, но необязательное использование тех же анализаторов для операций поиска и индексирования позволяет терминам запросов выглядеть более схоже с терминами внутри индекса.
Примечание
Поиск с использованием ИИ Azure позволяет указать различные анализаторы для индексирования и поиска с помощью дополнительных параметров поля indexAnalyzer и searchAnalyzer. Если не указано, анализатор с analyzer свойством используется как для индексирования, так и для поиска.
Инвертированные индексы для примеров документов
Возвращаясь к нашему примеру в поле заголовка , инвертированные индексы выглядят следующим образом:
| Термин | Список документов |
|---|---|
| Атман | 1 |
| Пляж | 2 |
| Отель | 1, 3 |
| Океан | 4 |
| Плайя | 3 |
| Курорт | 2 |
| Отступление | 4 |
В поле заголовка отображается только отель в двух документах: 1 и 3.
Для поля описания индекс выглядит следующим образом:
| Термин | Список документов |
|---|---|
| Воздух | 3 |
| И | 4 |
| Пляж | 1 |
| кондиционированный | 3 |
| Удобный | 3 |
| Расстояние | 1 |
| Остров | 2 |
| kauaʻi | 2 |
| Расположен | 2 |
| север | 2 |
| Океан | 1, 2, 3 |
| из | 2 |
| На | 2 |
| Тихий | 4 |
| Комнаты | 1, 3 |
| Уединенный | 4 |
| Берег | 2 |
| Просторные | 1 |
| Этот | 1, 2 |
| Кому | 1 |
| Вид | 1, 2, 3 |
| Ходить | 1 |
| С | 3 |
Сопоставление терминов запроса с индексированных терминов
Учитывая инвертированные индексы выше, давайте вернемся к образцу запроса и посмотрим, как найдены соответствующие документы для нашего примера запроса. Помните, что окончательное дерево запросов выглядит следующим образом:
Во время выполнения запроса отдельные запросы выполняются независимо от полей, доступных для поиска.
TermQuery, «просторный», соответствует документу 1 (Отель Atman).
Префиксный запрос "кондиционер*" не совпадает ни с одним документом.
Это поведение иногда путает разработчиков. Несмотря на то, что термин «кондиционированный воздух» существует в документе, он разделяется на два термина анализатором по умолчанию. Помните, что запросы префикса, содержащие частичные термины, не анализируются. Поэтому термины с префиксом "кондиционер" ищутся в инвертированном индексе и не находятся.
PhraseQuery, "вид на океан", ищет термины "океан" и "вид" и проверяет близость терминов в исходном документе. Документы 1, 2 и 3 соответствуют этому запросу в поле описания. Обратите внимание, что документ 4 имеет термин "океан" в названии, но не считается совпадением, так как мы ищем фразу "вид океана", а не отдельные слова.
Примечание
Поисковый запрос выполняется независимо от всех полей, доступных для поиска, в индексе Поиск с использованием ИИ Azure, если вы не ограничиваете поля, заданные параметром searchFields, как показано в примере запроса поиска. Возвращаются документы, соответствующие любому из выбранных полей.
В целом, для данного запроса соответствующие документы - это 1, 2 и 3.
Этап 4. Оценка
Каждому документу в результирующем наборе поиска назначается оценка релевантности. Функция оценки релевантности заключается в том, чтобы ранжировать эти документы, которые лучше всего отвечают на вопрос пользователя, как указано в поисковом запросе. Оценка вычисляется на основе статистических свойств терминов, которые соответствуют. В основе формулы оценки используется частота термов - обратная частота документов (TF/IDF). В запросах, содержащих редкие и распространенные термины, TF/IDF способствует результатам, содержащим редкий термин. Например, в гипотетическом индексе со всеми статьями Википедии из документов, которые соответствовали запросу the president, документы, соответствующие president, считаются более актуальными, чем документы, соответствующие the.
Пример оценки
Помните три документа, которые соответствовали нашему примеру запроса:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Документ 1 лучше всего соответствует запросу, так как термин просторный и обязательная фраза вид на океан встречаются в поле описания. Следующие два документа соответствуют только фразе вид на океан. Вы можете быть удивлены тем, что оценки релевантности для документов 2 и 3 отличаются, даже если они совпадают с запросом. Это связано с тем, что формула оценки имеет больше компонентов, чем просто TF/IDF. В этом случае документ 3 получил немного более высокую оценку, так как его описание короче. Узнайте о формуле практической оценки Lucene , чтобы понять, как длина поля и другие факторы могут повлиять на оценку релевантности.
Некоторые типы запросов (подстановочные знаки, префикс и regex) всегда вносят постоянную оценку в общую оценку документа. Это позволяет совпадениям, найденным путем расширения запросов, включаться в результаты, не влияя на рейтинг.
Пример иллюстрирует, почему это важно. Поиск с использованием подстановочных знаков, включая поиск по префиксу, является по определению неоднозначным, поскольку входная строка является частичной и может соответствовать очень большому числу различных терминов. Рассмотрим входные данные "tour*", совпадения найдены на "тур", "туретты" и "турмалин". Учитывая характер этих результатов, нет способа разумно определить, какие термины являются более ценными, чем другие. По этой причине мы игнорируем частоты терминов при оценке результатов в запросах типов подстановочных знаков, префиксов и регулярных выражений. В многокомпонентном поисковом запросе, включающем частичные и полные термины, результаты частичного ввода включаются в константную оценку, чтобы избежать предвзятости к потенциально непредвиденным совпадениям.
Настройка релевантности
В Поиск с использованием ИИ Azure можно настроить оценки релевантности двумя способами.
Профили оценки повышают ранжирование документов в ранговом списке результатов на основе набора правил. В нашем примере мы могли бы рассмотреть документы, которые соответствуют в поле заголовка более релевантными, чем документы, соответствующие в поле описания. Кроме того, если наш индекс имел поле цены для каждого отеля, мы могли бы поднять в рейтинге документы с более низкими ценами. Дополнительные сведения о добавлении профилей оценки в индекс поиска.
Усиление терминов (доступно только в синтаксисе полного запроса Lucene) предоставляет оператор
^усиления, которое можно применить к любой части дерева запроса. В нашем примере вместо поиска по префиксу air-condition*, можно найти точный термин кондиционер или префикс, но документы, соответствующие точному термину, имеют более высокий ранг за счёт применения повышения к запросу термина: air-condition^2||air-condition*. Узнайте больше об усилении терминов в запросе.
Оценка в распределенном индексе
Все индексы в Поиск с использованием ИИ Azure автоматически разделяются на несколько сегментов, что позволяет быстро распределять индекс между несколькими узлами во время увеличения или уменьшения масштаба службы. При выдаче поискового запроса он выдается независимо от каждого сегмента. Результаты каждого сегмента затем объединяются и упорядочены по оценке (если другое упорядочение не определено). Важно знать, что функция оценки учитывает частоту термина запроса относительно его обратной частоты по документам в каждом шарде, а не во всех шардов!
Это означает, что оценка релевантности может отличаться для идентичных документов, если они находятся на разных шардах. К счастью, такие различия, как правило, исчезают, так как число документов в индексе растет из-за более равномерного распределения терминов. Невозможно предположить, на какой сегмент будет помещен любой указанный документ. Однако при условии, что ключ документа не изменяется, он всегда назначается одному сегменту.
Как правило, оценка документов не является лучшим атрибутом для сортировки документов, если важна стабильность порядка. Например, учитывая два документа с одинаковым показателем, нет никакой гарантии того, какой из них появится первым в новых запусках одного и того же запроса. Оценка документов должна иметь общее представление о релевантности документа относительно других документов в наборе результатов.
Заключение
Успех коммерческих поисковых систем вызвал ожидания полнотекстового поиска по частным данным. Для почти любого вида опыта поиска мы теперь ожидаем, что подсистема понимает наше намерение, даже если термины неправильно или неполны. Мы даже можем ожидать совпадений на основе почти эквивалентных терминов или синонимов, которые мы никогда не указали.
С технической точки зрения, полнотекстовый поиск очень сложный, требуя сложного лингвистического анализа и систематического подхода к обработке таким образом, чтобы дистиллировать, расширять и преобразовывать термины запросов, чтобы предоставить релевантный результат. Учитывая присущие сложности, существует множество факторов, которые могут повлиять на результат запроса. Затратив время на понимание механики полнотекстового поиска, можно получить ощутимые преимущества, имея дело с непредвиденными результатами.
В этой статье рассматривается полнотекстовый поиск в контексте Поиск с использованием ИИ Azure. Мы надеемся, что это дает достаточную информацию для определения потенциальных причин и решений для устранения распространённых проблем с запросами.
Дальнейшие действия
Создайте пример индекса, попробуйте выполнить различные запросы и просмотреть результаты. Для получения инструкций см. раздел Создание и запрос индекса на портале Azure.
Попробуйте использовать другой синтаксис запроса из раздела Search Documents или из синтаксиса запросов Simple в обозревателе поиска на портале Azure.
Просмотрите профили оценки , если вы хотите настроить ранжирование в приложении поиска.
Применение лексических анализаторов для конкретного языка.
Настройте пользовательские анализаторы для минимальной обработки или специализированной обработки в определенных полях.