Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Примечание
Поиск с использованием ИИ Azure доступна через портал Azure, REST API и Azure SDKs. Он также лежит в основе Foundry IQ — управляемого слоя знаний, который преобразует корпоративный контент в многократно используемые базы знаний с учетом разрешений доступа для агентов на портале Microsoft Foundry.
Important
Функции, возможности или свойства, помеченные (предварительная версия), не охватываются соглашением об уровне обслуживания, не рекомендуются для рабочих нагрузок и могут изменяться или ограничиваться до того, как они становятся общедоступными. Условия предварительной версии Поиск с использованием ИИ Azure применяются ко всем функциям предварительной версии, независимо от того, является ли он автономным или частью общедоступной функции.
В Поиск с использованием ИИ Azure агентическое извлечение — это конвейер с несколькими запросами, предназначенный для сложных вопросов, которые задают пользователи или агенты в чатах и приложениях помощников. Он предназначен для шаблонов создания дополненного экземпляра (RAG) и рабочих процессов агента к агенту.
Вот как работает агентный поиск:
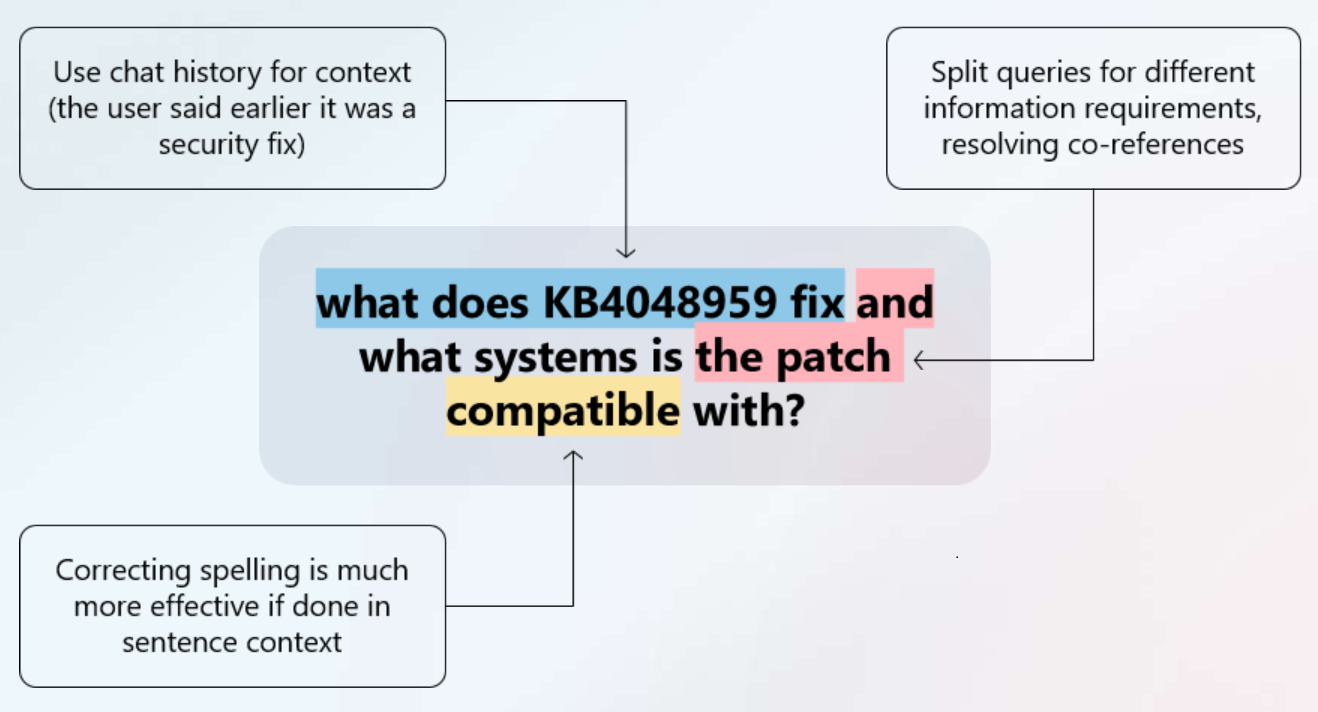
Можно использовать планирование запросов на базе LLM (предварительная версия), чтобы разбивать сложный запрос на более мелкие, сфокусированные подзапросы для более полного охвата внутреннего и внешнего контента. Планирование запросов может использовать журнал чата для дополнительного контекста.
Параллельное выполнение подзапросов. Каждый вложенный запрос семантически пересматривается для продвижения наиболее релевантных совпадений.
Объединяет лучшие результаты в унифицированный ответ, который LLM может использовать для создания обоснованных ответов.
Может возвращать ссылки на источники и журнал действий вместе с объединённым содержимым, чтобы вы могли использовать только данные для обоснования или передать их в LLM для получения полного ответа.
Этот высокопроизводительный конвейер помогает создавать высококачественные данные для обоснования ответов или сами ответы для вашего чат-приложения и позволяет быстро отвечать на сложные вопросы.
Зачем использовать агентный поиск?
Агентный поиск поддерживает как готовые, так и пользовательские сценарии работы для агентов и приложений. На портале Microsoft Foundry он служит основой для Foundry IQ как управляемого слоя знаний для агентов. Вы также можете создавать пользовательские решения для агентного поиска с помощью портала Azure, REST API службы поиска или поддерживаемого пакета SDK Azure.
Используйте агентное извлечение, если хотите предоставить агентам и приложениям наиболее релевантный контент для ответов на более сложные вопросы, опираясь на контекст чата, ваш проприетарный контент и внешние источники.
Агентивное извлечение увеличивает задержку по сравнению с конвейером, использующим один запрос, но оно справляется со сложными запросами, с которыми один запрос не справляется. Например, он может обрабатывать следующее:
Вопросы с несколькими условиями, такие как «найти отель недалеко от пляжа, с трансфером из аэропорта и в пешей доступности от вегетарианских ресторанов».
Вопросы, зависящие от более ранних контекстов в беседе.
Запросы, которым помогает переформулирование с использованием карт синонимов и перефразирования, сгенерированного LLM, для расширения охвата контента.
Ошибки орфографии.
Архитектура и рабочий процесс
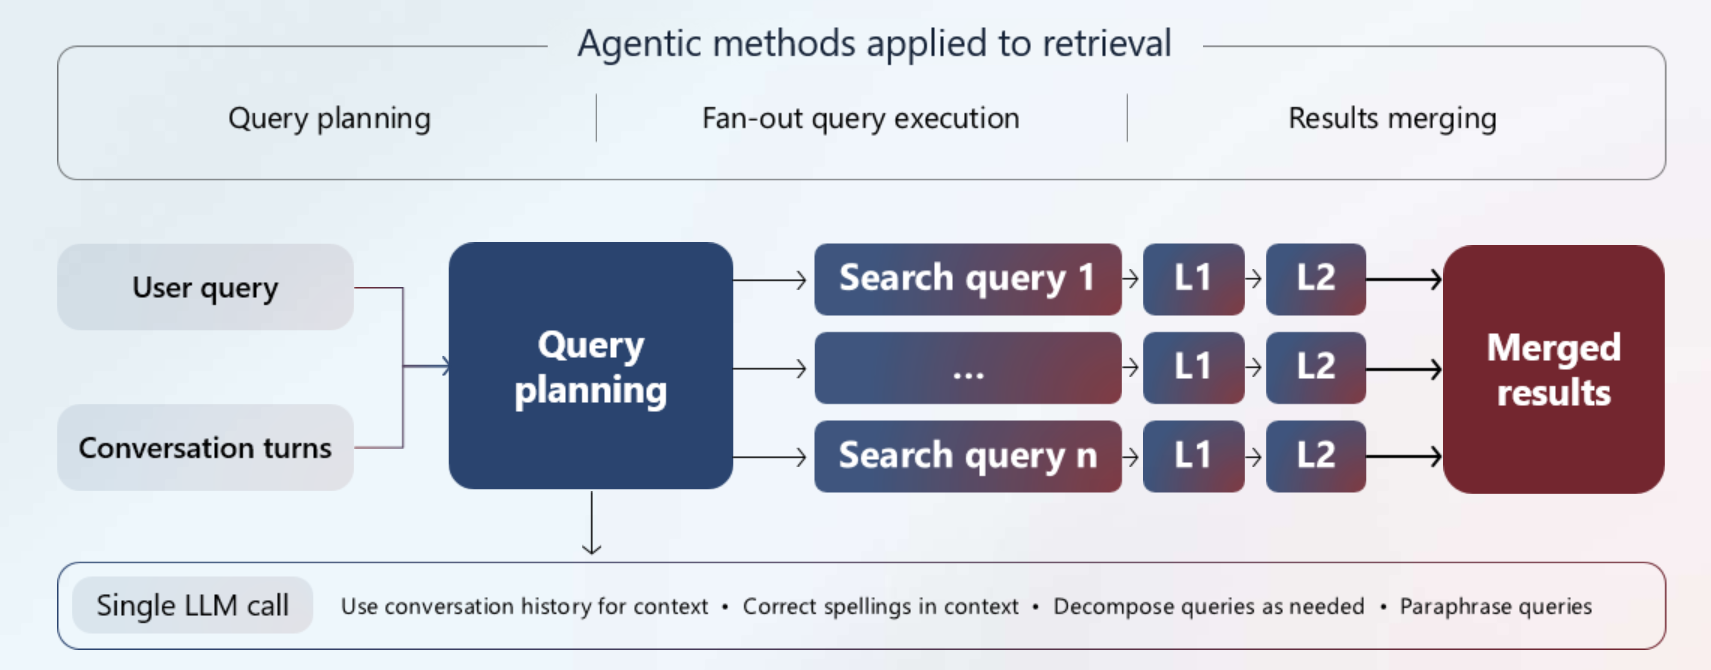
Агентный процесс извлечения работает следующим образом:
Запуск рабочего процесса: Приложение вызывает базу знаний с действием извлечения, которое предоставляет журнал запросов и бесед.
Планирование запросов: При
lowиmediumуровне вычислительных усилий при извлечении база знаний отправляет ваш запрос и историю беседы в LLM, которая генерирует целевые подзапросы. Приminimalусилии этот шаг пропускается, и запросы отправляются непосредственно к источникам знаний. Уровень рассуждений по умолчанию:low; он настраивается в базе знаний.Выполнение запроса: База знаний отправляет вложенные запросы в источники знаний. Все вложенные запросы выполняются одновременно и могут быть ключевыми словами, вектором или гибридным поиском. Каждый подзапрос проходит семантическое повторное ранжирование, чтобы найти наиболее релевантные совпадения. Ссылки извлекаются и сохраняются в целях ссылки.
Синтез результатов: Система объединяет все результаты в единый ответ. Объединенный контент всегда возвращается. Исходные ссылки и журнал действий выполнения являются необязательными.
Components
Для всех сценариев агентного поиска требуются база знаний и как минимум один источник знаний. Другие компоненты являются необязательными и зависят от конфигурации.
| Компонент | Служба | Роль |
|---|---|---|
| База знаний | Поиск с использованием ИИ Azure | Управляет конвейером, управляет источниками знаний и параметрами запроса. |
| Источник знаний | Поиск с использованием ИИ Azure | Определяет содержимое, используемое в конвейере. Может быть индексируемым (поддерживаемым поисковым индексом в вашей службе) или удаленным (содержимое извлекается во время выполнения запроса с внешней платформы). |
| Индекс поиска | Поиск с использованием ИИ Azure | Сохраняет содержимое, доступные для поиска (текст и векторы) с семантической конфигурацией. Определяет, какие типы запросов выполняются и какие оптимизации применяются. Требуется только для индексированных источников знаний. |
| Семантический ранжировщик | Поиск с использованием ИИ Azure | Используется внутри агентного конвейера поиска для переранжирования результатов по релевантности (переранжирование L2). |
| Магистр права (LLM) | Azure OpenAI | Может использоваться на нескольких этапах агентного поиска: для планирования запросов и выбора источников знаний (предварительная версия), обобщения веб-результатов и создания ответов со ссылками на источники с помощью синтеза ответов (предварительная версия). |
Требования к интеграции
Приложение управляет конвейером, вызывая базу знаний и обрабатывая ответ. Конвейер возвращает контекстные данные, которые можно передать LLM для генерации ответов или использовать непосредственно в интерфейсе чата. Дополнительные сведения о реализации см. в руководстве по созданию комплексного автономного решения для извлечения данных.
Доступность функций
Агентное извлечение поддерживает как общедоступные, так и предварительные возможности. Выберите версию REST API службы поиска, соответствующую вашему сценарию агентного поиска:
2026-04-01Используйте REST API для рабочих нагрузок, использующих общедоступные типы источников знаний с минимальным извлечением.Используйте
2026-08-01-previewREST API для работы с типами источников знаний и возможностями, доступными в предварительной версии, такими как планирование запросов на основе LLM, синтез ответов, неминимальные вычислительные усилия при извлечении и многоходовые сообщения. Ознакомьтесь с условиями предварительной версии Поиск с использованием ИИ Azure.
Порталы Azure и Microsoft Foundry предоставляют доступ ко всем возможностям агентного поиска только в режиме предварительной версии. Объекты, созданные на любом портале, могут использовать схемы предварительной версии и требовать миграцию при переходе на общедоступную версию REST API. Подробное описание по версиям и рекомендации по миграции см. в разделе Перенос кода агентного поиска на последнюю версию.
Доступность, ограничения и выставление счетов в регионе
Прежде чем использовать агентный поиск, ознакомьтесь с его региональной доступностью, ограничениями службы и моделью оплаты.
Доступность по регионам
Агентский доступ доступен в определённых регионах.
Limits
Источники знаний и базы знаний имеют максимальные ограничения , которые зависят от ценовой категории и усилий по извлечению причин.
Биллинг
Извлечение агента влечет за собой расходы на две услуги:
Поиск с использованием ИИ Azure взимает плату за токены выборки, потребляемые во время выполнения вложенных запросов и семантического ранжирования. Бесплатный план (по умолчанию) предоставляет ежемесячное выделение токенов. Стандартный план предоставляет возможность оплаты по факту использования после исчерпания бесплатного лимита. Дополнительные сведения см. в разделе Включение или отключение выставления счетов за агентную выборку.
Azure OpenAI взимает плату за входные и выходные токены, используемые при планировании запросов на основе LLM и синтезе ответов (предварительная версия). Цены всегда являются оплатой по мере использования и основаны на модели, назначаемой базе знаний. Начисления отображаются в вашем счете Azure OpenAI. Сведения о тарифах см. в разделе цены на Azure OpenAI.
В следующей таблице сравнивается выставление счетов между классическим потоком с одним запросом и агентским потоком извлечения с несколькими запросами. В классическом конвейере компонент, подлежащий оплате, является семантический ранжировщик.
| Аспект | Классический конвейер | Извлечение агентности |
|---|---|---|
| Единицы | На основе запроса | На основе токена |
| Затраты на единицу | Унифицированные затраты на запрос | Переменные затраты на токен (зависят от усилий на рассуждение) |
| Оценка затрат | Оценка количества запросов | Оценка использования токена |
| Бесплатное пособие | Ежемесячный бесплатный лимит на запросы | Ежемесячное выделение бесплатных токенов |
Пример. Оценка затрат
В этом примере показано, как проиллюстрировать процесс оценки затрат для планирования запросов и выполнения запросов, но не синтеза ответов. Ваши затраты могут быть ниже. Для получения текущих тарифов см. разделы Цены Поиск с использованием ИИ Azure и Цены Azure OpenAI.
Чтобы оценить стоимость выполнения планов запросов по модели «оплата по мере использования» в Azure OpenAI, предположим, gpt-4o-mini:
- 15 центов за 1 миллион входных токенов.
- 60 центов за 1 миллион токенов на выходе.
- 2,000 токенов ввода для среднего размера беседы в чате.
- 350 маркеров для среднего размера плана вывода.
Предполагаемые затраты на выставление счетов для выполнения запросов
Чтобы оценить количество маркеров агентского получения, начните с представления о том, как выглядит средний документ в индексе. Например, можно приблизиться к следующему:
- 10 000 блоков, где каждый блок составляет один до двух абзацев PDF.
- 500 токенов на блок.
- Каждый подзапрос перераспределяет до 50 фрагментов.
- В среднем на один план запроса приходится три вложенных запроса.
Вычисление цены на выполнение
Предположим, что мы делаем 2000 агентных извлечений с тремя подзапросами в каждой схеме. Это дает нам около 6000 общих запросов.
Переупорядочить 50 фрагментов на каждый подзапрос, что составляет в общей сложности 300 000 фрагментов.
Средний блок составляет 500 токенов, поэтому общий объем токенов для пересчета ранжирования составляет 150 миллионов.
Учитывая гипотетическую цену 0,022 за токен, 3,30 $ является общей стоимостью для переранжирования в долларах США.
Переход к стоимости планов запросов: 2000 входных токенов, умноженные на 2000 агентных извлечений, составляют 4 миллиона входных токенов в общей стоимости 60 центов.
Оцените выходные затраты на основе среднего значения в 350 токенов. Если умножить 350 на 2000 агентов извлечения, мы получим 700 000 выходных токенов всего за 42 цента.
Сложив все это вместе, вы заплатите около $3,30 за агентический поиск в Поиск с использованием ИИ Azure, 60 центов за входные токены в Azure OpenAI и 42 цента за выходные токены в Azure OpenAI, всего $1,02 за планирование запросов. Совокупная стоимость полного выполнения составляет 4,32 $.
Советы по управлению затратами
Просмотрите журнал действий в ответе, чтобы узнать, какие запросы были отправлены к источникам и какие параметры использовались. Вы можете повторно выполнить эти запросы к индексам и использовать общедоступный токенизатор для оценки маркеров и сравнения с использованием API. Точное восстановление запроса или ответа не гарантируется. Факторы включают тип источника знаний, например, общедоступные веб-данные или удаленный источник знаний в SharePoint, основанный на идентификации пользователя, что может повлиять на выполнение запросов.
Уменьшите количество источников знаний (индексов); консолидация контента может снизить фан-аут и объем токенов.
Уменьшите когнитивные затраты для снижения использования LLM в процессе планирования и расширения запросов (с использованием итеративного поиска).
Упорядочение содержимого таким образом, чтобы наиболее релевантные сведения можно найти с меньшим количеством источников и документов (например, сводные сводки или таблицы).
Начало работы
Чтобы создать агентное решение для поиска, можно использовать портал Azure, портал Microsoft Foundry (новый), REST API или аналогичный пакет Azure SDK.
- Быстрый старт: агентное извлечение в портале Azure
- Quickstart: agentic retrieval (C#, Java, JavaScript, Python, TypeScript, REST)