Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
Importante
Estas funcionalidades e capacidades permitem a ligação a outros serviços da Microsoft e a serviços de terceiros. A utilização destes serviços está sujeita aos respetivos termos e pode resultar no processamento ou armazenamento de dados fora do limite de conformidade do Azure, bem como no fluxo de dados para o limite de conformidade do Azure.
É sua responsabilidade gerir se os seus dados irão fluir para além dos limites de conformidade e geográficos da sua organização e quaisquer implicações relacionadas, e garantir que as permissões, limites e aprovações apropriadas sejam providenciadas.
És responsável por rever e testar cuidadosamente as aplicações que constróis no contexto dos teus casos de uso específicos e por tomar todas as decisões e personalizações apropriadas. Isto inclui implementar as suas próprias mitigações de IA responsável, como metaprompts, filtros de conteúdo ou outros sistemas de segurança, e assegurar que as suas aplicações cumprem os padrões adequados de qualidade, fiabilidade, segurança e confiabilidade. Para mais informações, consulte a Nota de Transparência Pesquisa de IA do Azure.
Neste artigo, aprende a usar um conjunto de competências para segmentar e vetorizar conteúdo de uma fonte de dados suportada. O conjunto de habilidades chama a habilidade de divisão de texto ou a habilidade de layout de documentos para o chunking e uma habilidade de embedding que está associada a um modelo de embedding suportado para vetorização de fragmentos. Também aprende a armazenar o conteúdo segmentado e vetorizado num índice vetorial.
Este artigo descreve o fluxo de trabalho de ponta a ponta para vetorização integrada usando REST. Para instruções baseadas em portal, consulte Quickstart: Vetorizar texto e imagens no portal Azure.
Pré-requisitos
Uma conta no Azure com uma subscrição ativa. Cria uma conta gratuitamente.
Um serviço Pesquisa de IA do Azure. Recomendamos o nível Básico ou superior.
Conclusão do Quickstart: Conectar sem chaves e Configurar uma identidade gerida atribuída pelo sistema. Embora possa usar autenticação baseada em chaves para operações no plano de dados, este artigo assume papéis e identidades geridas, que são mais seguras.
Fontes de dados suportadas
A vetorização integrada funciona com todas as fontes de dados suportadas. No entanto, este artigo foca-se nas fontes de dados mais utilizadas, descritas na tabela seguinte.
| Fonte de dados | Descrição |
|---|---|
| Armazenamento de Blobs do Azure | Esta fonte de dados funciona com blobs e tabelas. Deve usar uma conta de desempenho padrão (uso geral v2). Os níveis de acesso podem ser quentes, frios ou gelados. |
| Azure Data Lake Storage (ADLS) Gen2 | Esta é uma conta do Armazenamento do Azure com um namespace hierárquico ativado. Para confirmar que tem Data Lake Storage, verifique o separador Properties na página Overview.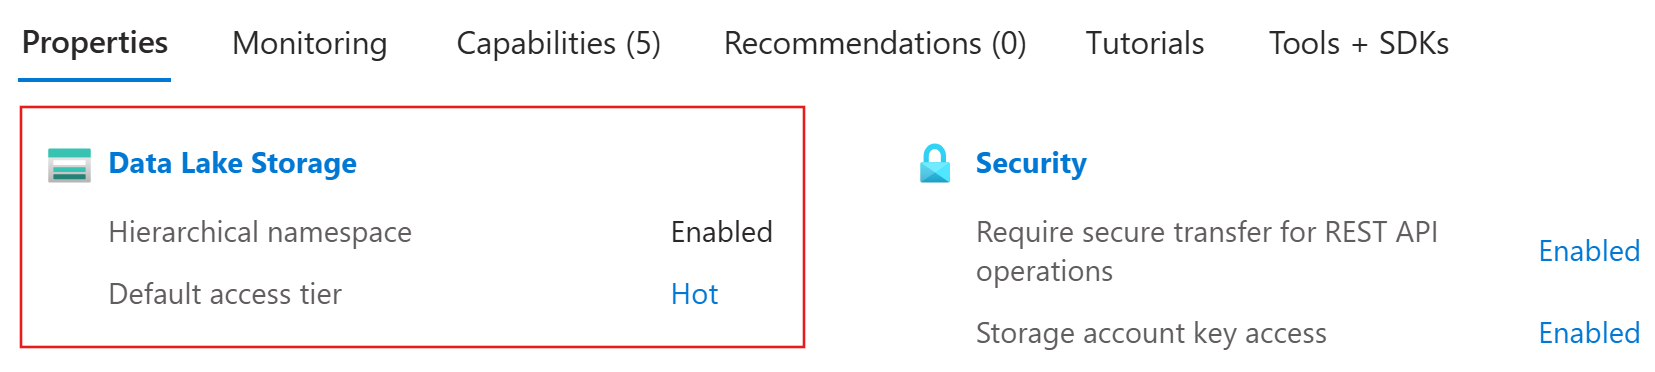
|
| Microsoft OneLake | Esta fonte de dados liga-se a ficheiros e atalhos do OneLake. |
Modelos de embedding suportados
Use um dos seguintes modelos de embedding para vetorização integrada. As instruções de implantação são fornecidas numa secção posterior.
| Fornecedor | Modelos suportados |
|---|---|
| Recurso OpenAI do Azure1, 2 | text-embedding-ada-002 Embutir texto-3-pequeno texto-embedding-3-grande |
| Microsoft Foundry3 | Para texto e imagens: Azure Vision multimodal4 |
1 O endpoint do seu recurso OpenAI Azure deve ter um subdomínio personalizado, como https://my-unique-name.openai.azure.com. Se criaste o teu recurso no portal do Azure, este subdomínio foi gerado automaticamente durante a configuração do recurso.
2 recursos do Azure OpenAI (com acesso a modelos de incorporação) criados no Portal do Microsoft Foundry não são suportados. Deve criar um recurso Azure OpenAI no portal Azure.
3 Para efeitos de faturação, precisa anexar o seu recurso Microsoft Foundry ao seu conjunto de habilidades Pesquisa de IA do Azure. A menos que você use uma conexão sem chave para criar o conjunto de habilidades, ambos os recursos devem estar na mesma região.
4 O modelo de embedding multimodal Azure Vision está disponível em regiões selecionadas.
Acesso baseado em funções
Pode usar o Microsoft Entra ID com atribuições de função ou autenticação baseada em chaves com cadeias de conexão de acesso total. Para ligações do Pesquisa de IA do Azure a outros recursos, recomendamos atribuições de funções.
Para configurar o acesso baseado em função para vetorização integrada:
No seu serviço de pesquisa, ative as funções e configure uma identidade gerida atribuída pelo sistema.
Na sua plataforma de fonte de dados e no fornecedor de modelos de embedding, crie atribuições de funções que permitam ao seu serviço de pesquisa aceder a dados e modelos. Veja Prepare os seus dados e Prepare o seu modelo de embedding.
Nota
Os serviços de pesquisa gratuitos suportam ligações baseadas em funções para o Pesquisa de IA do Azure. No entanto, não suportam identidades geridas em ligações de saída para Armazenamento do Azure ou Azure Vision. Este comportamento exige que utilize autenticação baseada em chaves nas ligações entre serviços de pesquisa gratuitos e outros recursos do Azure.
Para ligações mais seguras, use o nível Básico ou superior. Depois pode ativar funções e configurar uma identidade gerida para acesso autorizado.
Obtenha informações de ligação para Pesquisa de IA do Azure
Nesta secção, recupera o endpoint e o token Microsoft Entra para o seu serviço Pesquisa de IA do Azure. Ambos os valores são necessários para estabelecer ligações em pedidos REST.
Dica
Os passos seguintes assumem que está a usar acesso baseado em funções para testes de prova de conceito. Se quiser usar vetorização integrada para desenvolvimento de aplicações, veja Conecte a sua aplicação à Pesquisa de IA do Azure usando identidades.
Vá ao seu serviço de pesquisa no portal Azure.
Para obter o seu endpoint de pesquisa, copie o URL na página Overview. Um exemplo de endpoint de pesquisa é
https://my-service.search.windows.net.Para obter o seu token Microsoft Entra, execute o seguinte comando no seu sistema local. Este passo requer a conclusão do Quickstart: Ligar sem chaves.
az account get-access-token --scope https://search.azure.com/.default --query accessToken --output tsv
Prepare os seus dados
Nesta secção, prepara os seus dados para vetorização integrada carregando ficheiros para uma fonte de dados suportada, atribuindo funções e obtendo informações de ligação.
Vai à tua conta Armazenamento do Azure no portal Azure.
No painel esquerdo, selecioneContentores> de Dados.
Crie um contentor ou selecione um contentor existente e depois carregue os seus ficheiros para o contentor.
Para atribuir funções:
No painel esquerdo, selecione Controlo de Acesso (IAM).
Selecione Adicionar>Adicionar atribuição de função.
Em funções de trabalho, selecione Leitor de Dados de Blob de Armazenamento e depois selecione Seguinte.
Em Membros, selecione Identidade Gerida e depois selecione Selecionar membros.
Selecione a sua subscrição e a identidade gerida do seu serviço de pesquisa.
Para obter uma "cadeia de ligação":
No painel esquerdo, selecione Chaves de Acesso de Segurança + rede>.
Copie qualquer uma das cadeias de conexão, que você especifica mais tarde em Definir variáveis.
(Opcional) Sincronize as eliminações no seu contentor com as eliminações no índice de pesquisa. Para configurar o seu indexador para deteção de eliminações:
Ativa a eliminação suave na tua conta de armazenamento. Se estiver a usar soft delete nativo, o passo seguinte não é necessário.
Adicione metadados personalizados que um indexador possa analisar para determinar quais os blobs marcados para eliminação. Dê à sua propriedade personalizada um nome descritivo. Por exemplo, pode dar o nome "IsDeleted" à propriedade e defini-la como false. Repita este passo para cada blob no contêiner. Quando quiseres apagar o blob, muda a propriedade para true. Para mais informações, consulte "Deteção de alterações e eliminações ao indexar a partir do Armazenamento do Azure".
Prepare o seu modelo de embedding
Nesta secção, prepara o seu recurso de IA Azure para vetorização integrada, atribuindo funções, obtendo um endpoint e implementando um modelo de embedding suportado .
O Pesquisa de IA do Azure suporta text-embedding-ada-002, text-embedding-3-small e text-embedding-3-large. Internamente, Pesquisa de IA do Azure chama a skill Azure OpenAI Embedding para estabelecer ligação ao Azure OpenAI.
Vai ao teu recurso Azure OpenAI no portal Azure.
Para atribuir funções:
No painel esquerdo, selecione Controlo de Acesso (IAM).
Selecione Adicionar>Adicionar atribuição de função.
Em funções de trabalho, selecione Utilizador OpenAI de Serviços Cognitivos e depois Seguinte.
Em Membros, selecione Identidade Gerida e depois selecione Selecionar membros.
Selecione a sua subscrição e a identidade gerida do seu serviço de pesquisa.
Para obter um ponto final:
No painel esquerdo, selecione Gestão de Recursos>Chaves e Ponto Final.
Copie o endpoint para o seu recurso Azure OpenAI. Especifica este URL mais tarde em Set variables.
Para implementar um modelo de embedding:
Inicie sessão no portal Foundry e selecione o seu recurso Azure OpenAI.
Implemente um modelo de embedding suportado.
Copie os nomes de implementação e modelo, que especifica mais tarde em Set variables. O nome de implementação é o nome personalizado que escolheu, enquanto o nome do modelo é o modelo que implementou, como
text-embedding-ada-002.
Definir variáveis
Nesta secção, especifica as informações de conexão do seu serviço Pesquisa de IA do Azure, a sua fonte de dados suportada e o seu modelo de embedding suportado.
No Visual Studio Code, cole os seguintes marcadores no seu ficheiro
.restou.http.@baseUrl = PUT-YOUR-SEARCH-SERVICE-URL-HERE @token = PUT-YOUR-MICROSOFT-ENTRA-TOKEN-HERESubstitua
@baseUrlpelo endpoint de pesquisa e@tokenpelo token de Microsoft Entra que obteve em Obtenha informações de ligação para Pesquisa de IA do Azure.Dependendo da sua fonte de dados, adicione as seguintes variáveis.
Fonte de dados Variáveis Insira esta informação Armazenamento de Blobs do Azure @storageConnectionStringe@blobContainerA cadeia de conexão e o nome do contenedor que criou em Prepare your data. ADLS Gen2 @storageConnectionStringe@blobContainerA cadeia de conexão e o nome do contenedor que criou em Prepare your data. OneLake @workspaceIde@lakehouseIdOs IDs do espaço de trabalho e da casa do lago que obteve em Prepare os seus dados. Dependendo do seu fornecedor de modelos de embedding, adicione as seguintes variáveis.
Fornecedor de modelos de incorporação Variáveis Insira esta informação Azure OpenAI @aoaiEndpoint,@aoaiDeploymentName, e@aoaiModelNameO endpoint, o nome da implementação e o nome do modelo que obtiveste em Prepare o teu modelo de embedding. Azure Vision @AiFoundryEndpointO endpoint que obteve em Prepare o seu modelo de incorporação. Para verificar as variáveis, envie o seguinte pedido.
### List existing indexes by name
GET {{baseUrl}}/indexes?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}
Uma resposta deve aparecer num painel adjacente. Se tiveres índices existentes, eles estão listados. Caso contrário, a lista fica vazia. Se o código HTTP for
200 OK, estás pronto para avançar.
Liga-te aos teus dados
Nesta secção, liga-se a uma fonte de dados suportada para indexação baseada em indexadores. Um indexador em Pesquisa de IA do Azure requer uma fonte de dados que especifique o tipo, credenciais e contentor.
Use o Create Data Source para definir uma fonte de dados que forneça informação de ligação durante a indexação.
### Create a data source
POST {{baseUrl}}/datasources?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "name": "my-data-source",
    "type": "azureblob",
    "subtype": null,
    "credentials": {
        "connectionString": "{{storageConnectionString}}"
    },
    "container": {
        "name": "{{blobContainer}}",
        "query": null
    },
    "dataChangeDetectionPolicy": null,
    "dataDeletionDetectionPolicy": null
  }
Defina
typepara a sua fonte de dados:azureblobouadlsgen2.Para criar a fonte de dados, selecione Enviar pedido.
Se estiver a usar o OneLake, defina
credentials.connectionStringparaResourceId={{workspaceId}}econtainer.namepara{{lakehouseId}}.
Crie um conjunto de competências
Nesta secção, crias um conjunto de competências que chama uma habilidade incorporada para fragmentar o teu conteúdo e uma habilidade de embedding para criar representações vetoriais dos chunks. O conjunto de habilidades é executado durante a indexação numa secção posterior.
Chama uma habilidade incorporada para segmentar o teu conteúdo
Particionar o seu conteúdo em blocos ajuda-o a cumprir os requisitos do seu modelo de embedding e evita a perda de dados devido ao truncamento. Para mais informações sobre fragmentação, consulte Fragmentar documentos grandes para soluções de pesquisa vetorial.
Para a fragmentação de dados integrada, o Pesquisa de IA do Azure oferece as competências Text Split skill e Azure Content Understanding skill. A competência Text Split divide o texto em frases ou páginas de um determinado comprimento, enquanto a competência Azure Content Understanding executa segmentos semânticos e com perfil de layout que respeitam os limites dos parágrafos.
Use Criar Conjunto de Competências para definir um conjunto de competências.
### Create a skillset
POST {{baseUrl}}/skillsets?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "name": "my-skillset",
    "skills": []
  }
Na matriz
skills, chame a competência Text Split ou a competência Compreensão de Conteúdo do Azure. Pode colar uma das seguintes definições."skills": [ { "@odata.type": "#Microsoft.Skills.Text.SplitSkill", "name": "my-text-split-skill", "textSplitMode": "pages", "maximumPageLength": 2000, "pageOverlapLength": 500, "maximumPagesToTake": 0, "unit": "characters", "defaultLanguageCode": "en", "inputs": [ { "name": "text", "source": "/document/text", "inputs": [] } ], "outputs": [ { "name": "textItems" } ] }, { "@odata.type": "#Microsoft.Skills.Util.ContentUnderstandingSkill", "name": "my-content-understanding-skill", "context": "/document", "chunkingProperties": { "method": "semantic", "unit": "tokens", "maximumLength": 500 }, "inputs": [ { "name": "file_data", "source": "/document/file_data" } ], "outputs": [ { "name": "text_sections", "targetName": "text_sections" } ] } ]
Chama uma capacidade de embedding para vetorizar os segmentos
Para vetorizar o teu conteúdo em blocos, o conjunto de competências precisa de uma competência de embedding que aponte para um modelo de embedding suportado.
Depois da competência de segmentação incorporada na matriz
skills, chame a competência de incorporações do Azure OpenAI ou a competência de incorporações multimodais do Azure Vision (pré-visualização). Pode colar uma das seguintes definições.{ "@odata.type": "#Microsoft.Skills.Text.AzureOpenAIEmbeddingSkill", "resourceUri": "{{aoaiEndpoint}}", "deploymentId": "{{aoaiDeploymentName}}", "modelName": "{{aoaiModelName}}", "dimensions": 1536, "inputs": [ { "name": "text", "source": "/document/text" } ], "outputs": [ { "name": "embedding" } ] }, { "@odata.type": "#Microsoft.Skills.Vision.VectorizeSkill", "context": "/document", "modelVersion": "2023-04-15", "inputs": [ { "name": "url", "source": "/document/metadata_storage_path" }, { "name": "queryString", "source": "/document/metadata_storage_sas_token" } ], "outputs": [ { "name": "vector" } ] }Nota
A funcionalidade de embeddings multimodais do Azure Vision está em versão prévia. Se quiser invocar esta competência, utilize a versão de pré-visualização mais recente da API.
Se estiver a utilizar a capacidade Azure OpenAI Embedding, defina
dimensionspara o número de embeddings gerados pelo seu modelo de embedding.Se estiver a utilizar a habilidade de embeddings multimodais do Azure Vision, anexe o seu recurso do Microsoft Foundry após o array
skills. Este anexo destina-se a efeitos de faturação."skills": [ ... ], "cognitiveServices": { "@odata.type": "#Microsoft.Azure.Search.AIServicesByIdentity", "subdomainUrl": "{{AiFoundryEndpoint}}" }Para criar o conjunto de competências, selecione Enviar pedido.
Criar um índice vetorial
Nesta secção, configura estruturas de dados físicas no seu serviço Pesquisa de IA do Azure criando um índice vetorial . O esquema de um índice vetorial requer o seguinte:
- Nome
- Campo chave (cadeia de caracteres)
- Um ou mais campos vetoriais
- Configuração vetorial
Os campos vetoriais armazenam representações numéricas dos teus dados fragmentados. Devem ser pesquisáveis e recuperáveis, mas não podem ser filtráveis, facetados ou ordenáveis. Também não podem ter analisadores, normalizadores ou atribuições de mapas de sinónimos.
Para além dos campos vetoriais, o índice amostral nos passos seguintes contém campos não vetoriais para conteúdo legível por humanos. É comum incluir equivalentes em texto simples do conteúdo que se pretende vetorializar. Para mais informações, veja Criar um índice vetorial.
Use o Create Index para definir o esquema de um índice vetorial.
### Create a vector index
POST {{baseUrl}}/indexes?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "name": "my-vector-index",
    "fields": [],
    "vectorSearch": []
  }
Adicione uma configuração de pesquisa vetorial à
vectorSearchsecção."vectorSearch": { "algorithms": [ { "name": "hnsw-algorithm", "kind": "hnsw", "hnswParameters": { "m": 4, "efConstruction": 400, "efSearch": 100, "metric": "cosine" } } ], "profiles": [ { "name": "vector-profile-hnsw", "algorithm": "hnsw-algorithm", } ] }vectorSearch.algorithmsespecifica o algoritmo usado para indexar e consultar campos vetoriais, enquantovectorSearch.profilesliga a configuração do algoritmo a um perfil que pode atribuir a campos vetoriais.Dependendo do seu modelo de incorporação, atualize
vectorSearch.algorithms.metric. Valores válidos para métricas de distância sãocosine,dotproduct,euclidean, ehamming.Adiciona campos aos
fieldsarrays. Inclua um campo-chave para identificação de documentos, campos não vetoriais para conteúdo legível por humanos e campos vetoriais para embeddings."fields": [ { "name": "id", "type": "Edm.String", "key": true, "filterable": true }, { "name": "title", "type": "Edm.String", "searchable": true, "filterable": true, "sortable": true, "retrievable": true }, { "name": "titleVector", "type": "Collection(Edm.Single)", "searchable": true, "retrievable": false, "stored": true, "dimensions": 1536, "vectorSearchProfile": "vector-profile-hnsw" }, { "name": "content", "type": "Edm.String", "searchable": true, "retrievable": true }, { "name": "contentVector", "type": "Collection(Edm.Single)", "searchable": true, "retrievable": false, "stored": false, "dimensions": 1536, "vectorSearchProfile": "vector-profile-hnsw" } ]Dependendo da tua competência de embedding, define
dimensionspara cada campo vetorial o valor seguinte.Competência de embedding Insira este valor Azure OpenAI O número de embeddings gerados pelo seu modelo de embedding. Azure Vision 1024
Adicionar um vetorizador ao índice
Nesta secção, ativa a vetorização no momento da consulta, definindo um vetorizador no seu índice. O vetorizador utiliza o modelo de embedding que indexa os seus dados para decodificar uma cadeia de pesquisa ou imagem num vetor para pesquisa vetorial.
Adicione o vetor Azure OpenAI ou o vetor Azure Vision (pré-visualização) após
vectorSearch.profiles. Pode colar uma das seguintes definições."profiles": [ ... ], "vectorizers": [ { "name": "my-openai-vectorizer", "kind": "azureOpenAI", "azureOpenAIParameters": { "resourceUri": "{{aoaiEndpoint}}", "deploymentId": "{{aoaiDeploymentName}}", "modelName": "{{aoaiModelName}}" } }, { "name": "my-ai-services-vision-vectorizer", "kind": "aiServicesVision", "aiServicesVisionParameters": { "resourceUri": "{{AiFoundryEndpoint}}", "modelVersion": "2023-04-15" } } ]Nota
O vetorizador do Azure Vision está em pré-visualização. Se quiseres chamar este vetorizador, usa a versão mais recente da API de pré-visualização.
Especifique o seu vetorizador em
vectorSearch.profiles."profiles": [ { "name": "vector-profile-hnsw", "algorithm": "hnsw-algorithm", "vectorizer": "my-openai-vectorizer" } ]Para criar o índice vetorial, selecione Enviar pedido.
Criar um indexador
Nesta secção, crias um indexador para gerir todo o pipeline de vetorização, desde a recuperação de dados à execução de competências e à indexação. Recomendamos que execute o indexador numa agenda para processar alterações ou documentos que tenham sido perdidos devido à restrição.
Use Create Indexer para definir um indexador que execute o pipeline de vetorização.
### Create an indexer
POST {{baseUrl}}/indexers?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "name": "my-indexer",
    "dataSourceName": "my-data-source",
    "targetIndexName": "my-vector-index",
    "skillsetName": "my-skillset",
    "schedule": {
      "interval": "PT2H"
    },
    "parameters": {
      "batchSize": null,
      "maxFailedItems": null,
      "maxFailedItemsPerBatch": null
    }
  }
Para criar o indexador, selecione Enviar pedido.
Execute uma consulta vetorial para confirmar a indexação
Nesta secção, verifica se o seu conteúdo foi indexado com sucesso criando uma consulta vetorial. Como configurou um vetorizador numa secção anterior, o motor de busca pode decodificar texto simples ou uma imagem num vetor para execução de consultas.
Use Documents - Search Post para definir uma consulta vetorizada no momento da consulta.
### Run a vector query
POST {{baseUrl}}/indexes('my-vector-index')/docs/search.post.search?api-version=2026-04-01  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "count": true,
    "select": "title, content",
    "vectorQueries": [
        {
          "kind": "text",
          "text": "a sample text string for integrated vectorization",
          "fields": "titleVector, contentVector",
          "k": "3"
        }
    ]
  }
Nota
O vetorizador do Azure Vision está em pré-visualização. Se quiseres chamar este vetorizador, usa a versão mais recente da API de pré-visualização.
Para consultas que invocam vetorização integrada,
kinddeve ser definido paratext, etextdeve especificar uma cadeia de texto. Esta cadeia é passada ao vetorizador atribuído ao campo vetorial. Para mais informações, consulte Consulta com vetorização integrada.Para executar a consulta vetorial, selecione Enviar pedido.