Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Observação
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
Important
Estas funcionalidades e capacidades permitem a ligação a outros serviços da Microsoft e a serviços de terceiros. A utilização destes serviços está sujeita aos respetivos termos e pode resultar no processamento ou armazenamento de dados fora do limite de conformidade do Azure, bem como no fluxo de dados para o limite de conformidade do Azure.
É sua responsabilidade gerir se os seus dados irão fluir para além dos limites de conformidade e geográficos da sua organização e quaisquer implicações relacionadas, e garantir que as permissões, limites e aprovações apropriadas sejam providenciadas.
És responsável por rever e testar cuidadosamente as aplicações que constróis no contexto dos teus casos de uso específicos e por tomar todas as decisões e personalizações apropriadas. Isto inclui implementar as suas próprias mitigações de IA responsável, como metaprompts, filtros de conteúdo ou outros sistemas de segurança, e assegurar que as suas aplicações cumprem os padrões adequados de qualidade, fiabilidade, segurança e confiabilidade. Para mais informações, consulte a Nota de Transparência Pesquisa de IA do Azure.
Depois que um índice de pesquisa inicial é criado, talvez você queira que os trabalhos de indexador subsequentes peguem apenas documentos novos e alterados. Para conteúdo indexado originado do Armazenamento do Azure, a deteção de alterações ocorre automaticamente porque os indexadores controlam a última atualização usando os carimbos de data/hora internos em objetos e arquivos no Armazenamento do Azure.
Embora a deteção de alterações seja um dado adquirido, a deteção de exclusão não é. Um indexador não controla a exclusão de objetos em fontes de dados. Para evitar ter documentos de pesquisa órfãos, você pode implementar uma estratégia de "exclusão suave" que resulta na exclusão de documentos de pesquisa primeiro, com a exclusão física no Armazenamento do Azure seguindo como uma segunda etapa.
Há duas maneiras de implementar uma estratégia de exclusão suave:
- Exclusão suave de blob nativo, aplica-se somente ao Armazenamento de Blob
- Exclusão suave usando metadados personalizados
A estratégia de deteção de exclusão deve ser aplicada desde a primeira execução do indexador. Se não estabeleceste a política de eliminação antes da execução inicial, quaisquer documentos que tenham sido eliminados antes da implementação da política permanecem no teu índice, mesmo que adiciones a política ao indexador mais tarde e a reinicies. Se isso tiver ocorrido, é sugerido que você crie um novo índice usando um novo indexador, garantindo que a política de exclusão esteja em vigor desde o início.
Pré-requisitos
Usar um indexador de Armazenamento do Azure para Armazenamento Blob, Armazenamento Tabela, Armazenamento de Ficheiros ou Armazenamento Data Lake Gen2
Use chaves de documento e estrutura de arquivo consistentes. A alteração de chaves de documento ou nomes e caminhos de diretório (aplica-se ao ADLS Gen2) quebra as informações de rastreamento interno usadas pelos indexadores para saber qual conteúdo foi indexado e quando foi indexado pela última vez.
Observação
O ADLS Gen2 permite que os diretórios sejam renomeados. Quando um diretório é renomeado, os carimbos de data/hora dos blobs nesse diretório não são atualizados. Como resultado, o indexador não reindexará esses blobs. Se você precisar que os blobs em um diretório sejam reindexados após uma renomeação de diretório porque eles agora têm novas URLs, será necessário atualizar o carimbo LastModified de data/hora de todos os blobs no diretório para que o indexador saiba reindexá-los durante uma execução futura. Os diretórios virtuais no Armazenamento de Blobs do Azure não podem ser alterados, portanto, eles não têm esse problema.
Exclusão suave de blob nativo
Para esta abordagem de deteção de eliminação, o Pesquisa de IA do Azure depende do recurso nativo de eliminação suave de blobs no Armazenamento de Blobs do Azure para determinar se os blobs transitaram para um estado de eliminação suave. Quando blobs são detetados nesse estado, um indexador de pesquisa usa essas informações para remover o documento correspondente do índice.
Requisitos para exclusão suave nativa
Os blobs têm de estar num contentor de Armazenamento de Blobs do Azure, incluindo o contentor de Blobs ADLS Gen2. A política de eliminação suave de blobs nativos do Pesquisa de IA do Azure não é suportada para Ficheiros do Azure.
As chaves de documento para os documentos em seu índice devem ser mapeadas para serem uma propriedade de blob ou metadados de blob, como "metadata_storage_path".
Você pode usar a API REST ou a configuração da Fonte de Dados do indexador no portal do Azure para configurar o suporte para exclusão suave.
O versionamento de Blob não deve ser ativado na conta de armazenamento. Caso contrário, a exclusão suave nativa não é suportada pelo design.
Configurar eliminação suave nativa
No Armazenamento de Blobs, ao ativar a eliminação suave conforme os requisitos, defina a política de retenção para um valor muito superior ao seu calendário de intervalos do indexador. Se houver um problema ao executar o indexador ou se você tiver um grande número de documentos para indexar, haverá muito tempo para o indexador eventualmente processar os blobs excluídos suavemente. Os indexadores do Pesquisa de IA do Azure apagam um documento do índice apenas se processarem o blob enquanto está em estado de eliminação suave.
No Pesquisa de IA do Azure, configure uma política nativa de deteção de eliminação suave de blobs na fonte de dados. Você pode fazer isso no portal do Azure ou usando a API REST. As instruções a seguir explicam como definir a política de deteção de exclusão no portal do Azure ou por meio de APIs REST.
Vá para o seu serviço de pesquisa no portal do Azure.
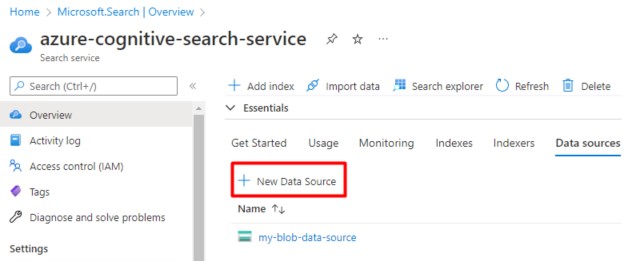
Na página Visão Geral do serviço Pesquisa de IA do Azure, vá para Nova Fonte de Dados, um editor visual para especificar uma definição de fonte de dados.
A captura de tela a seguir mostra onde você pode encontrar esse recurso no portal do Azure.
No formulário Nova fonte de dados, preencha os campos obrigatórios, marque a caixa de seleção Rastrear eliminações e escolha eliminação suave de blob nativo. Depois seleciona Guardar para ativar a funcionalidade na criação da Fonte de Dados.

Reindexar blobs não eliminados usando políticas nativas de eliminação suave
Se restaurares um blob apagado suavemente no Armazenamento de Blobs, o indexador nem sempre o reindexa. Isso ocorre porque o indexador utiliza o timestamp do blob para determinar se é necessária a indexação. Quando um blob excluído suavemente não é excluído, seu LastModified carimbo de data/hora não é atualizado, portanto, se o indexador já tiver processado blobs com carimbos de data/hora mais recentes LastModified , ele não reindexará o blob não excluído.
Para garantir que um blob não eliminado seja reindexado, atualize o carimbo temporal do blob LastModified. Uma maneira de fazer isso é salvando novamente os metadados desse blob. Não precisas de alterar os metadados, mas guardar novamente os metadados atualiza o carimbo temporal do blob LastModified, para que o indexador o reconheça.
Estratégia de exclusão suave usando metadados personalizados
Esse método usa metadados personalizados para indicar se um documento de pesquisa deve ser removido do índice. Ele requer duas ações separadas: excluir o documento de pesquisa do índice, seguido pela exclusão de arquivo no Armazenamento do Azure.
Este recurso está disponível em geral.
Há etapas a serem seguidas no Armazenamento do Azure e na Pesquisa de IA do Azure, mas não há outras dependências de recursos.
No Armazenamento do Azure, adicione um par chave-valor de metadados personalizados ao arquivo para indicar que o arquivo está sinalizado para exclusão. Por exemplo, você pode nomear a propriedade "IsDeleted", definida como false. Quando quiser excluir o arquivo, altere-o para true.
No Pesquisa de IA do Azure, edite a definição da fonte de dados para incluir uma propriedade "dataDeletionDetectionPolicy". Por exemplo, a política a seguir considera um arquivo a ser excluído se ele tiver uma propriedade
IsDeletedde metadados com o valortrue:PUT https://[service name].search.windows.net/datasources/file-datasource?api-version=2026-04-01 { "name" : "file-datasource", "type" : "azurefile", "credentials" : { "connectionString" : "<your storage connection string>" }, "container" : { "name" : "my-share", "query" : null }, "dataDeletionDetectionPolicy" : { "@odata.type" :"#Microsoft.Azure.Search.SoftDeleteColumnDeletionDetectionPolicy", "softDeleteColumnName" : "IsDeleted", "softDeleteMarkerValue" : "true" } }Execute o indexador. Depois de o indexador processar o ficheiro e apagar o documento do índice de pesquisa, pode então eliminar o ficheiro físico no Armazenamento do Azure.
Reindexar blobs e arquivos não excluídos
Você pode reverter uma exclusão suave se o arquivo de origem original ainda existir fisicamente no Armazenamento do Azure.
Altere o
"softDeleteMarkerValue" : "false"no blob ou arquivo no Armazenamento do Azure.Verifique o carimbo de
LastModifieddata/hora do blob ou do arquivo para torná-lo mais recente do que a última execução do indexador. Você pode forçar uma atualização para a data e hora atuais salvando novamente os metadados existentes.Execute o indexador.
Limitações
Nem a "soft delete" nativa de blob nem a "soft delete" via metadados personalizados se aplicam quando se utilizam cenários de indexação one-to-many. Para eliminar a entrada do documento, deve submeter um pedido de eliminação ao índice usando a operação de eliminação da API REST.