Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Nota
O Pesquisa de IA do Azure está disponível através do portal Azure, APIs REST e SDKs do Azure. Também sustenta o Foundry IQ, a camada de conhecimento gerida que transforma conteúdos empresariais em bases de conhecimento reutilizáveis e conscientes de permissões para agentes no portal Microsoft Foundry.
Este artigo explica o algoritmo de pontuação de relevância BM25 usado para calcular pontuações de pesquisa para pesquisa de texto completo. A relevância do BM25 aplica-se apenas à pesquisa de texto completo. Consultas de filtro, preenchimento automático e consultas sugeridas, pesquisa curinga e consultas de pesquisa difusa não são pontuadas ou classificadas quanto à relevância.
Algoritmos de pontuação usados na pesquisa de texto completo
O Pesquisa de IA do Azure fornece os seguintes algoritmos de pontuação para pesquisa de texto completo:
| Algoritmo | Utilização | Alcance |
|---|---|---|
BM25Similarity |
Algoritmo fixo em todos os serviços de pesquisa criados após julho de 2020. Você pode configurar esse algoritmo, mas não pode alternar para um mais antigo (clássico). | Sem limites. |
ClassicSimilarity |
Padrão em serviços de pesquisa mais antigos anteriores a julho de 2020. Em serviços mais antigos, você pode optar pelo BM25 e escolher o algoritmo BM25 por índice. | 0 < 1,00 |
Tanto o BM25 quanto o Classic são funções de recuperação semelhantes ao TF-IDF que usam o termo frequência (TF) e a frequência inversa do documento (IDF) como variáveis para calcular pontuações de relevância para cada par documento-consulta, que é então usado para classificar os resultados. Embora conceitualmente semelhante ao clássico, o BM25 está enraizado na recuperação probabilística de informações que produz correspondências mais intuitivas, conforme medido pela pesquisa do usuário.
O BM25 oferece opções avançadas de personalização, como permitir que o utilizador decida como o escalar da pontuação de relevância é influenciado pela frequência dos termos correspondentes.
Como funciona o ranking BM25
A pontuação de relevância refere-se ao cálculo de uma pontuação de pesquisa (@search.score) que serve como um indicador da relevância de um item no contexto da consulta atual. O intervalo é ilimitado. No entanto, quanto maior a pontuação, mais relevante o item.
A pontuação da pesquisa é calculada com base nas propriedades estatísticas da entrada da cadeia de caracteres e da própria consulta. O Pesquisa de IA do Azure encontra documentos que correspondem em termos de pesquisa (alguns ou todos, dependendo do searchMode), favorecendo documentos que contêm muitas instâncias do termo de pesquisa. A pontuação da pesquisa sobe ainda mais se o termo for raro em todo o índice de dados, mas comum dentro do documento. A base para esta abordagem à relevância computacional é conhecida como TF-IDF ou termo frequência de documento inversa à frequência.
As pontuações de pesquisa podem ser repetidas ao longo de um conjunto de resultados. Quando vários resultados têm a mesma pontuação de pesquisa, a ordenação dos itens com a mesma pontuação é indefinida e não é consistente. Execute a consulta novamente e você poderá ver os itens mudarem de posição, especialmente se estiver usando o serviço gratuito ou um serviço faturável com várias réplicas. Dado dois itens com uma pontuação idêntica, não há garantia de que um apareça primeiro.
Para quebrar o empate entre pontuações repetidas, você pode adicionar uma cláusula $orderby à primeira ordem por pontuação e, em seguida, à ordem por outro campo classificável (por exemplo, $orderby=search.score() desc,Rating desc).
Somente os campos marcados como searchable no índice ou searchFields na consulta são usados para pontuação. Somente os campos marcados como retrievable, ou os campos especificados na select consulta, são retornados nos resultados da pesquisa, juntamente com sua pontuação de pesquisa.
Nota
A @search.score = 1 indica um conjunto de resultados não pontuado ou não classificado. A pontuação é uniforme em todos os resultados. Os resultados não pontuados ocorrem quando o formulário de consulta é uma pesquisa nebulosa, pesquisas com curingas, regex, ou uma pesquisa vazia (search=*, às vezes emparelhada com filtros, sendo o filtro o principal meio de retornar uma correspondência).
O segmento de vídeo a seguir avança rapidamente para uma explicação dos algoritmos de classificação geralmente disponíveis usados na Pesquisa de IA do Azure. Você pode assistir ao vídeo completo para mais informações.
Pontuações nos resultados de um texto
Sempre que os resultados são classificados, @search.score a propriedade contém o valor usado para ordenar os resultados.
A tabela a seguir identifica a propriedade de pontuação, o algoritmo e o intervalo.
| Método de pesquisa | Parâmetro | Algoritmo de pontuação | Alcance |
|---|---|---|---|
| Pesquisa de texto completo | @search.score |
Algoritmo BM25, utilizando os parâmetros especificados no índice. | Sem limites. |
Variação da pontuação
As pontuações de pesquisa transmitem um senso geral de relevância, refletindo a força da correspondência em relação a outros documentos no mesmo conjunto de resultados. Mas as pontuações nem sempre são consistentes de uma consulta para outra, portanto, ao trabalhar com consultas, você pode notar pequenas discrepâncias na forma como os documentos de pesquisa são ordenados. Há várias explicações para que isso possa ocorrer.
| Causa | Descrição |
|---|---|
| Pontuações idênticas | Se vários documentos tiverem a mesma pontuação, qualquer um deles pode aparecer primeiro. |
| Volatilidade de dados | O conteúdo do índice varia à medida que você adiciona, modifica ou exclui documentos. As frequências dos termos mudam à medida que as atualizações do índice são processadas ao longo do tempo, afetando as pontuações de pesquisa dos documentos correspondentes. |
| Várias réplicas | Para serviços que usam várias réplicas, as consultas são emitidas em relação a cada réplica em paralelo. As estatísticas de índice usadas para calcular uma pontuação de pesquisa são calculadas por réplica, com os resultados mesclados e ordenados na resposta da consulta. As réplicas são, na sua maioria, espelhos uns dos outros, mas as estatísticas podem diferir devido a pequenas diferenças de estado. Por exemplo, uma réplica pode ter excluído documentos que contribuem para as suas estatísticas, que foram incorporados de outras réplicas. Normalmente, as diferenças nas estatísticas por réplica são mais percetíveis em índices menores. A seção a seguir fornece mais informações sobre essa condição. |
Efeitos de compartilhamento nos resultados da consulta
Um fragmento é um pedaço de um índice. O Pesquisa de IA do Azure subdivide um índice em fragmentos para tornar o processo de adição de partições mais rápido (movendo fragmentos para novas unidades de pesquisa). Em um serviço de pesquisa, o gerenciamento de estilhaços é um detalhe de implementação e não configurável, mas saber que um índice é fragmentado ajuda a entender as anomalias ocasionais na classificação e nos comportamentos de preenchimento automático:
Anomalias de classificação: As pontuações de pesquisa são calculadas primeiro ao nível de fragmento e, em seguida, agregadas num único conjunto de resultados. Dependendo das características do conteúdo de um fragmento, as correspondências de um fragmento podem ser posicionadas mais acima do que as correspondências de outro. Se você notar classificações contraintuitivas nos resultados de pesquisa, é mais provável que seja devido aos efeitos da fragmentação, especialmente se os índices forem pequenos. Você pode evitar essas anomalias de classificação optando por calcular pontuações globalmente em todo o índice, mas isso incorrerá em uma penalidade de desempenho.
Anomalias de preenchimento automático: as consultas de preenchimento automático, em que as correspondências são feitas nos primeiros caracteres de um termo parcialmente inserido, aceitam um parâmetro difuso que perdoa pequenos desvios na ortografia. Para preenchimento automático, a correspondência difusa é restrita a termos dentro do fragmento atual. Por exemplo, se um fragmento contiver "Microsoft" e um termo parcial de "micro" for inserido, o mecanismo de pesquisa corresponderá a "Microsoft" nesse fragmento, mas não em outros fragmentos que contêm as partes restantes do índice.
O diagrama a seguir mostra a relação entre réplicas, partições, fragmentos e unidades de pesquisa. Apresenta um exemplo de como um único índice é distribuído por quatro unidades de pesquisa num serviço com duas réplicas e duas partições. Cada uma das quatro unidades de pesquisa armazena apenas metade dos fragmentos do índice. As unidades de pesquisa na coluna da esquerda armazenam a primeira metade dos fragmentos, compreendendo a primeira partição, enquanto as da coluna da direita armazenam a segunda metade dos fragmentos, compreendendo a segunda partição. Como há duas réplicas, há duas cópias de cada fragmento de índice. As unidades de pesquisa na linha superior armazenam uma cópia, compreendendo a primeira réplica, enquanto as da linha inferior armazenam outra cópia, compreendendo a segunda réplica.
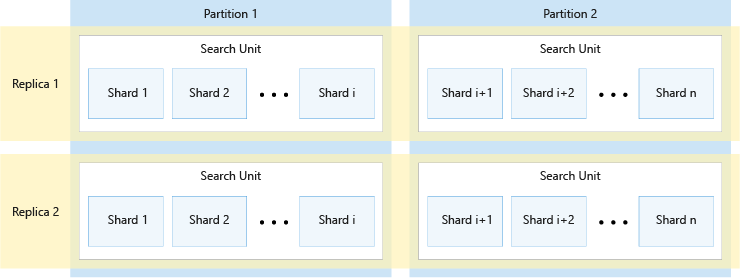
O diagrama acima é apenas um exemplo. Muitas combinações de partições e réplicas são possíveis, até um máximo de 36 unidades de pesquisa totais.
Nota
O número de réplicas e partições divide-se uniformemente em 12 (especificamente, 1, 2, 3, 4, 6, 12). O Pesquisa de IA do Azure pré-divide cada índice em 12 fragmentos para que possa ser distribuído em partes iguais em todas as partições. Por exemplo, se o serviço tiver três partições e você criar um índice, cada partição conterá quatro fragmentos do índice. Como o Pesquisa de IA do Azure fragmenta um índice é um detalhe de implementação, sujeito a alterações em versões futuras. Embora o número seja 12 hoje, você não deve esperar que esse número seja sempre 12 no futuro.
Estatísticas de pontuação e sessões adesivas
Para escalabilidade, o Pesquisa de IA do Azure distribui cada índice horizontalmente por meio de um processo de fragmentação, o que significa que partes de um índice são fisicamente separadas.
Por padrão, a pontuação de um documento é calculada com base nas propriedades estatísticas dos dados dentro de um fragmento. Essa abordagem geralmente não é um problema para um grande corpus de dados e fornece um desempenho melhor do que ter que calcular a pontuação com base em informações em todos os fragmentos. Dito isso, usar essa otimização de desempenho pode fazer com que dois documentos muito semelhantes (ou até mesmo documentos idênticos) acabem com pontuações de relevância diferentes se acabarem em fragmentos diferentes.
Se preferir calcular a pontuação com base nas propriedades estatísticas em todos os fragmentos, pode fazer isso adicionando scoringStatistics=global como um parâmetro de consulta (ou adicionando "scoringStatistics": "global" como um parâmetro de corpo da solicitação de consulta).
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "scoringStatistics": "global"
}
O uso scoringStatistics garantirá que todos os fragmentos na mesma réplica forneçam os mesmos resultados. Dito isto, réplicas diferentes podem ser ligeiramente diferentes umas das outras, uma vez que estão sempre a ser atualizadas com as alterações mais recentes ao seu índice. Em alguns cenários, talvez você queira que os usuários obtenham resultados mais consistentes durante uma "sessão de consulta". Nesses cenários, você pode fornecer um sessionId como parte de suas consultas. A sessionId é uma cadeia de caracteres exclusiva que você cria para se referir a uma sessão de usuário exclusiva.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "sessionId": "<string>"
}
Desde que o mesmo sessionId seja usado, uma tentativa de melhor esforço é feita para direcionar a mesma réplica, aumentando a consistência dos resultados que seus usuários verão.
Nota
Reutilizar os mesmos sessionId valores repetidamente pode interferir no balanceamento de carga das solicitações entre réplicas e afetar negativamente o desempenho do serviço de pesquisa. O valor usado como sessionId não pode começar com um caractere '_'.
Ajuste de relevância
No Pesquisa de IA do Azure, para pesquisa de palavra-chave e a parte de texto de uma consulta híbrida, você pode configurar parâmetros de algoritmo BM25, além de ajustar a relevância da pesquisa e aumentar as pontuações de pesquisa por meio dos seguintes mecanismos.
| Abordagem | Implementação | Descrição |
|---|---|---|
| Configuração do algoritmo BM25 | Índice de pesquisa | Configure como a duração do documento e a frequência do termo afetam a pontuação de relevância. |
| Perfis de pontuação | Índice de pesquisa | Forneça critérios para aumentar a pontuação de pesquisa de uma correspondência com base nas características do conteúdo. Por exemplo, você pode aumentar as correspondências com base em seu potencial de receita, promover itens mais novos ou talvez impulsionar itens que estão no estoque há muito tempo. Um perfil de pontuação faz parte da definição do índice, composto por campos ponderados, funções e parâmetros. Você pode atualizar um índice existente com alterações de perfil de pontuação, sem incorrer em uma reconstrução do índice. |
| Classificação semântica | Pedido de consulta | Aplica a compreensão de leitura automática aos resultados de pesquisa, promovendo resultados semanticamente mais relevantes para o topo. |
| featuresMode parâmetro | Pedido de consulta | Este parâmetro é usado principalmente para descompactar uma pontuação classificada como BM25, mas pode ser usado para um código que fornece uma solução de pontuação personalizada. |
parâmetro featuresMode (visualização)
Nota
O parâmetro featuresMode não está documentado nas APIs REST, mas pode-se usá-lo numa chamada de API REST de visualização para pesquisar documentos para pesquisa de texto (palavra-chave) classificada pelo BM25.
As solicitações de Documentos de Pesquisa (pré-visualização) suportam um featuresMode parâmetro que fornece mais detalhes sobre uma pontuação de relevância BM25 ao nível do campo. Enquanto o @searchScore é calculado para o documento completo (quão relevante é este documento no contexto desta consulta), o featuresMode revela informações sobre campos individuais, conforme expresso numa estrutura @search.features. A estrutura contém todos os campos usados na consulta (campos específicos através de searchFields em uma consulta ou todos os campos atribuídos como pesquisáveis em um índice).
Valores válidos para featuresMode:
- "nenhum" (padrão). Nenhum detalhe de pontuação ao nível da característica é retornado.
- "habilitado". Devolve discriminações detalhadas da pontuação por campo
Para cada campo, @search.features forneça os seguintes valores:
- Número de tokens exclusivos encontrados no campo
- Pontuação de similaridade, ou uma medida de quão semelhante é o conteúdo do campo, em relação ao termo de consulta
- Frequência do termo ou o número de vezes que o termo de consulta foi encontrado no campo
Esse parâmetro é especialmente útil quando você está tentando entender por que certos documentos têm uma classificação mais alta ou menor nos resultados de pesquisa. Ajuda a explicar como diferentes campos contribuem para a pontuação geral.
Para uma consulta direcionada a um campo "descrição", uma solicitação pode ter esta aparência:
POST {{baseUrl}}/indexes/hotels-sample/docs/search?api-version=2026-08-01-preview  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}

    {
        "search": "lake view",
        "select": "HotelId, HotelName, Tags, Description",
        "featuresMode": "enabled",
        "searchFields": "Description, Tags",
        "count": true
    }
Uma resposta que inclua @search.features pode se parecer com o exemplo a seguir.
  "value": [
    {
      "@search.score": 3.0860271,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 2.0,
          "similarityScore": 3.0860272,
          "termFrequency": 2.0
        }
      },
      "HotelName": "Downtown Mix Hotel",
      "Description": "Mix and mingle in the heart of the city. Shop and dine, mix and mingle in the heart of downtown, where fab lake views unite with a cheeky design.",
      "Tags": [
        "air conditioning",
        "laundry service",
        "free wifi"
      ]
    },
    {
      "@search.score": 2.7294855,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.6023184,
          "termFrequency": 1.0
        },
        "Tags": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.1271671,
          "termFrequency": 1.0
        }
      },
      "HotelName": "Ocean Water Resort & Spa",
      "Description": "New Luxury Hotel for the vacation of a lifetime. Bay views from every room, location near the pier, rooftop pool, waterfront dining & more.",
      "Tags": [
        "view",
        "pool",
        "restaurant"
      ]
    }
  ]
Você pode consumir esses pontos de dados em soluções de pontuação personalizadas ou usar as informações para depurar problemas de relevância de pesquisa.
Número de resultados classificados em uma resposta de consulta de texto completo
Por padrão, se você não estiver usando paginação, o mecanismo de pesquisa retornará as 50 correspondências mais bem posicionadas para pesquisa de texto completo. Você pode usar o top parâmetro para retornar um número menor ou maior de itens (até 1.000 em uma única resposta). Você pode usar skip e next para os resultados da página. A paginação determina o número de resultados em cada página lógica e suporta a navegação de conteúdo. Para obter mais informações, consulte Resultados da pesquisa de formas.
Se a sua consulta de texto completo fizer parte de uma consulta híbrida, pode definir maxTextRecallSize para aumentar ou diminuir o número de resultados do lado do texto da consulta.
A pesquisa de texto completo está sujeita a um limite máximo de 1.000 correspondências (consulte Limites de resposta da API). Uma vez que 1.000 correspondências são encontradas, o mecanismo de busca não procura mais.