Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Observação
Pesquisa de IA do Azure está disponível por meio do portal Azure, APIs REST e SDKs do Azure. Ele também sustenta o IQ do Foundry, a camada de conhecimento gerenciado que transforma o conteúdo da empresa em bases de conhecimento reutilizáveis e com reconhecimento de permissão para agentes no portal do Microsoft Foundry.
Ocasionalmente, os indexadores têm problemas que não produzem erros ou que ocorrem em outros serviços do Azure, como durante a autenticação ou ao se conectar. Este artigo se concentra na solução de problemas do indexador quando não há mensagens para orientá-lo. Ele também fornece solução de problemas para erros provenientes de recursos que não são de pesquisa usados durante a indexação.
Observação
Se você tiver um erro da Pesquisa de IA do Azure para investigar, em vez disso, confira Solucionar problemas de erros e avisos comuns do indexador.
Práticas recomendadas
Estas são algumas práticas recomendadas e recomendações ao trabalhar com indexadores:
Os indexadores são projetados para serem executados em um agendamento
- Para indexação confiável, configure seus indexadores para serem executados em um agendamento regular. As execuções agendadas coletam automaticamente todos os documentos perdidos em execuções anteriores devido a erros transitórios, interrupções de rede ou problemas temporários de serviço. Essa abordagem ajuda a manter a consistência de dados e minimiza a necessidade de intervenção manual.
- Para fontes de dados grandes, a enumeração inicial e a indexação podem levar horas ou até dias. Executar o indexador em um agendamento permite que o progresso continue e os erros sejam repetidos automaticamente. Evite depender apenas de execuções manuais ou de indexador sob demanda, pois essas opções não fornecem a mesma confiabilidade ou recuperação de erro transitória.
Indexadores fornecem indexação de esforço máximo ao longo do tempo
- Indexadores internos processam documentos sem erros permanentes e repetem execuções agendadas. Eles oferecem uma maneira conveniente, de baixo código ou sem código de indexar dados para cenários comuns, permitindo um desenvolvimento mais rápido e uma manutenção mais fácil. Quando um indexador executa um conjunto de habilidades, cada execução tem um limite de tempo de execução fixo. Os indexadores executados no ambiente de execução multilocatário têm um tempo de execução máximo de duas horas. Esse limite é o caso mais comum, usado quando os conjuntos de habilidades não exigem links privados compartilhados. Indexadores configurados para usar links privados compartilhados são executados em um ambiente de execução privada com um máximo de 24 horas. Para a tabela completa, consulte os limites do Indexador. Se o processamento do conjunto de competências por documento impedir que o indexador termine antes do limite de tempo, ele para e deixa de processar os documentos restantes. O processamento completo não é garantido quando o volume do documento, o tamanho do arquivo, a complexidade do conjunto de habilidades ou o ambiente de execução impedem que o indexador termine dentro de seu tempo máximo de execução. Particionar sua fonte de dados pode reduzir esse risco, mas não eliminá-lo, especialmente se posteriormente você adicionar grandes volumes de arquivos a uma partição. Esse comportamento é esperado. Para obter estratégias para gerenciar grandes conjuntos de dados e oferecer suporte à recuperação incremental, consulte Indexar grandes conjuntos de dados e Agendar indexadores. Se sua solução exigir um controle estrito sobre quando o indexador processa documentos, use a alternativa de API push neste artigo.
- Se sua solução exigir controle rigoroso sobre os prazos de indexação, utilize as APIs de push, como a API REST do índice de documentos ou o método IndexDocuments (SDK do Azure para .NET). Essas opções oferecem controle total do pipeline de indexação.
- Os indexadores podem ocasionalmente se atrasar. Embora essa condição seja incomum e existam mecanismos de recuperação automática, a recuperação pode levar tempo. Esse comportamento é esperado.
Solucionar problemas de conexões a recursos restritos
Para fontes de dados na segurança de rede do Azure, os indexadores são limitados em como fazem a conexão. Atualmente, os indexadores podem acessar fontes de dados restritas por trás de um firewall IP ou em uma rede virtual por meio de um ponto de extremidade privado usando um link privado compartilhado.
Erro ao conectar-se a um recurso do Microsoft Foundry em uma conexão privada
Se você receber o código de erro 403 com a seguinte mensagem, poderá haver um problema na forma como o endpoint do recurso está especificado em um conjunto de habilidades:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Esse erro ocorre se você configurou um link privado compartilhado para conexões com um recurso Azure Foundry e o ponto de extremidade está sem um subdomínio personalizado. Um subdomínio personalizado é a primeira parte do ponto de extremidade (por exemplo, http://my-custom-subdomain.services.ai.azure.com). Um domínio personalizado poderá estar ausente se você tiver criado o recurso no portal do Foundry em vez do portal do Azure.
Se o recurso Foundry não estiver na mesma região que o Pesquisa de IA do Azure , use uma conexão sem chave para anexar o recurso.
Erro ao usar um link privado compartilhado
Se você receber o código de erro 403 com a seguinte mensagem, o indexador poderá estar se conectando por meio do ponto de extremidade público em vez de um link privado compartilhado aprovado:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Esse erro pode ocorrer quando o indexador não está configurado para usar o ambiente de execução privada. Confirme se o link privado compartilhado foi aprovado, defina o private do indexador como e verifique se a conexão usa o ponto de extremidade do recurso correto e a executionEnvironment.
Regras de firewall
O Armazenamento do Azure, o Azure Cosmos DB e o SQL do Azure fornecem um firewall configurável. Não há nenhuma mensagem de erro específica quando o firewall bloqueia a solicitação. Normalmente, os erros de firewall são genéricos. Alguns erros comuns incluem:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Para permitir que os indexadores acessem esses recursos, use uma das seguintes opções:
Configure uma regra de entrada para o endereço IP do serviço de pesquisa e o intervalo de endereços IP da
AzureCognitiveSearchmarca deserviço. Para obter detalhes sobre como configurar restrições de intervalo de endereços IP para cada tipo de fonte de dados, consulte os seguintes links:Como último recurso ou como medida temporária, desabilite o firewall permitindo o acesso de Todas as redes.
Limitação: as restrições de intervalo de endereços IP só funcionarão se o serviço de pesquisa e sua conta de armazenamento estiverem em regiões diferentes.
Além da recuperação de dados, os indexadores também enviam solicitações de saída por meio de conjuntos de habilidades e habilidades personalizadas. Para habilidades personalizadas com base em uma função do Azure, lembre-se de que as funções do Azure também têm restrições de endereço IP. A lista de endereços IP a serem permitidos para execução de habilidades personalizadas inclui o endereço IP do serviço de pesquisa e o intervalo de endereços IP da marca de serviço AzureCognitiveSearch.
Regras do grupo de segurança de rede (NSG)
Quando um indexador acessa dados em uma instância gerenciada de SQL ou quando uma VM do Azure é usada como o URI do serviço Web para uma habilidade personalizada, o grupo de segurança de rede determina se as solicitações são permitidas.
Para recursos externos que residem em uma rede virtual, configure regras NSG de entrada para a marca de serviço AzureCognitiveSearch.
Para obter mais informações sobre como se conectar a uma máquina virtual, confira Configurar uma conexão ao SQL Server em uma VM do Azure.
Erros de rede
Normalmente, os erros de rede são genéricos. Alguns erros comuns incluem:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Quando você recebe qualquer um desses erros:
- Verifique se você pode acessar sua origem tentando se conectar diretamente a ela e não por meio do serviço de pesquisa.
- Verifique seu recurso no portal do Azure se há erros ou interrupções atuais.
- Verifique se há interrupções de rede no status do Azure.
- Verifique se você está usando um DNS público para resolução de nomes e não um Azure DNS privado.
Indexação sem servidor do Banco de Dados SQL do Azure (código de erro 40613)
Se o banco de dados SQL está em uma camada de computação sem servidor, verifique se o banco de dados está em execução (e não em pausa) quando o indexador se conecta a ele.
Se o banco de dados estiver em pausa, o primeiro logon do seu serviço de pesquisa reativa automaticamente o banco de dados, mas retorna um erro informando que o banco de dados está indisponível, com o código de erro 40613. Depois que o banco de dados estiver em execução, tente entrar novamente para estabelecer a conectividade.
Políticas de acesso condicional do Microsoft Entra
Ao criar um indexador de SharePoint, você precisa entrar no aplicativo Microsoft Entra depois de fornecer um código de dispositivo. Se você receber uma mensagem informando "Your sign-in was successful but your admin requires the device requesting access to be managed"que uma política de Acesso Condicional provavelmente está bloqueando o indexador da biblioteca de documentos SharePoint.
Para atualizar a política e permitir o acesso do indexador à biblioteca de documentos:
Abra o portal do Azure e pesquise pelo Acesso condicional do Microsoft Entra.
Selecione Políticas no menu à esquerda. Se você não tiver acesso para exibir esta página, será necessário encontrar alguém que tenha ou forneça acesso.
Determine qual política está bloqueando o indexador do SharePoint de acessar a biblioteca de documentos. A política que pode bloquear o indexador inclui a conta de usuário que você usou para autenticar durante a etapa de criação do indexador na seção Usuários e grupos . A política também pode ter Condições que:
- Restrinja as plataformas Windows.
- Restrinja Aplicativos móveis e clientes de área de trabalho.
- Defina o estado do dispositivo como Sim.
Depois de confirmar qual política está bloqueando o indexador, faça uma isenção para o indexador. Comece recuperando o endereço IP do serviço de pesquisa.
Primeiro, obtenha o nome de domínio totalmente qualificado (FQDN) do serviço de pesquisa. O FQDN parece
<your-search-service-name>.search.windows.net. Você pode encontrar o FQDN no portal do Azure.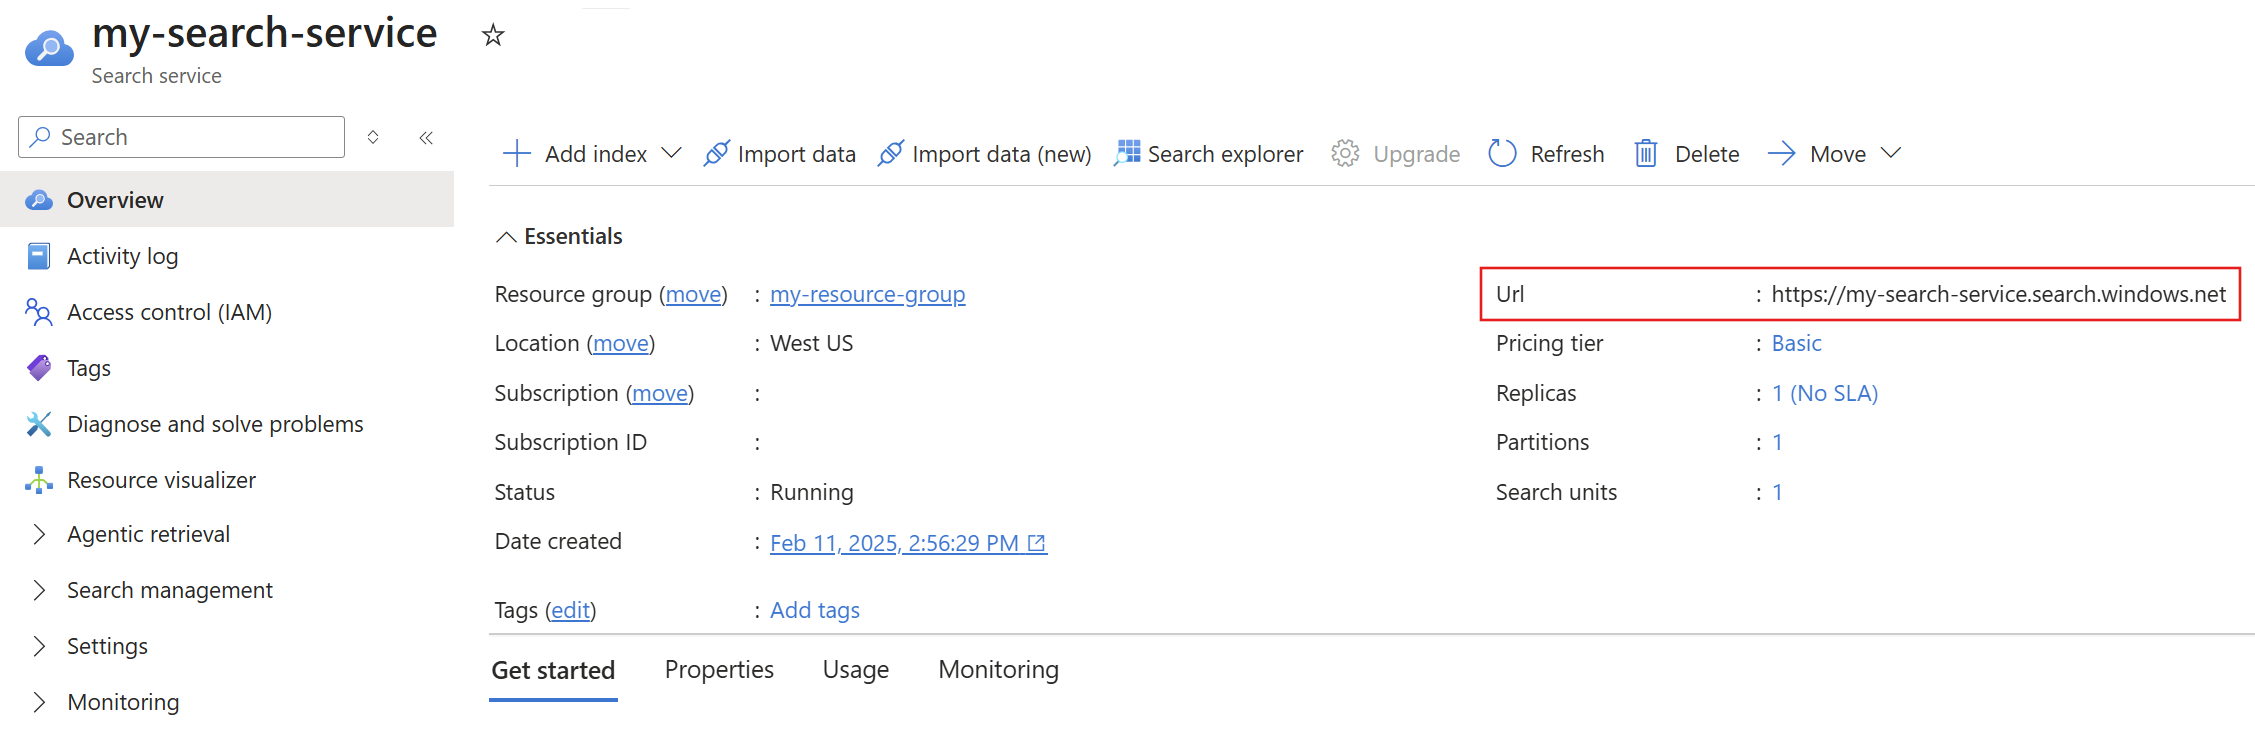
Agora que você tem o FQDN, obtenha o endereço IP do serviço de pesquisa executando um
nslookup(ou umping) do FQDN. No exemplo a seguir, você adiciona150.0.0.1a uma regra de entrada no firewall Armazenamento do Azure. Pode levar até 15 minutos depois que as configurações de firewall são atualizadas para que o indexador do serviço de pesquisa acesse a conta Armazenamento do Azure.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netObtenha os intervalos de endereços IP para o ambiente de execução do indexador para sua região.
Endereços IP extras são usados para solicitações originadas do ambiente de execução multilocatário do indexador. Você pode obter esse intervalo de endereços IP na marca de serviço.
Você pode obter os intervalos de endereços IP para a
AzureCognitiveSearchmarca de serviço por meio da API de descoberta ou do arquivo JSON para download.Para este exercício, supondo que o serviço de pesquisa seja o Azure nuvem pública, baixe o arquivo JSON público Azure.
No arquivo JSON, supondo que o serviço de pesquisa esteja no Centro-Oeste dos EUA, a lista de endereços IP para o ambiente de execução do indexador multilocatário está listada.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
De volta à página do Acesso Condicional no portal do Azure, selecione Localizações nomeadas no menu à esquerda e escolha + Localização dos intervalos de IP. Dê um nome ao seu novo local nomeado e adicione os intervalos de IP para os ambientes de execução do serviço de pesquisa e do indexador que você coletou nas duas últimas etapas. 1
- Para o endereço IP do serviço de pesquisa, talvez seja necessário adicionar "/32" ao final do endereço IP, pois ele aceita apenas intervalos de IP válidos.
- Lembre-se de que, para os intervalos de IP do ambiente de execução do indexador, você só precisa adicionar os intervalos de IP para a região em que o serviço de pesquisa está.
Exclua o novo local nomeado da política:
- Selecione Políticas no menu à esquerda.
- Selecione a política que está bloqueando o indexador.
- Selecione Condições.
- Select Localizações.
- Selecione Excluir e adicione a nova Localização nomeada.
- Salve as alterações.
Aguarde alguns minutos para que a política seja atualizada e aplique as novas regras de política.
Tente criar o indexador novamente:
- Envie uma solicitação de atualização para o objeto de fonte de dados que você criou.
- Reenvie a solicitação de criação do indexador. Use o novo código para entrar e envie outra solicitação de criação do indexador.
Indexando tipos de documentos sem suporte
Se você estiver indexando o conteúdo de Armazenamento de Blobs do Azure e o contêiner incluir blobs de um tipo de conteúdo sem suporte, o indexador ignorará esse documento. Em outros casos, pode haver problemas com documentos individuais.
Nessa situação, você pode definir opções de configuração para permitir que o processamento do indexador continue se houver problemas com documentos individuais.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Documentos ausentes
Os indexadores extraem documentos ou linhas de uma fonte de dados externa e criam documentos de pesquisa, que o serviço de pesquisa indexa. Ocasionalmente, um documento que existe na fonte de dados não aparece em um índice de pesquisa. Esse resultado inesperado pode ocorrer pelos seguintes motivos:
- Você atualizou o documento depois que o indexador foi executado. Se o indexador estiver em um agendamento, eventualmente é executado novamente e pega o documento.
- O indexador atingiu o tempo limite antes que o documento pudesse ser ingerido. Há limites máximos de tempo de processamento após os quais nenhum documento é processado. Verifique o status do indexador no portal do Azure ou chamando Obter Status do Indexador (API REST).
- Mapeamentos de campo ou enriquecimento de IA alteraram o documento e sua articulação no índice de pesquisa é diferente do esperado.
- Os valores do controle de alterações estão errados ou pré-requisitos estão ausentes. Se o valor da marca d’água superior for uma data definida em um momento futuro, o indexador ignorará todos os documentos com data anterior. Você pode determinar o estado de acompanhamento de alterações do indexador usando os campos
initialTrackingStateefinalTrackingStateno status do indexador. Os indexadores do SQL do Azure e do MySQL devem ter um índice na coluna de marca d'água alta da tabela de origem ou as consultas usadas pelo indexador podem ter o tempo esgotado.
Dica
Se os documentos estiverem ausentes, verifique a consulta que você está usando para verificar se ele não está excluindo o documento em questão. Para consultar um documento específico, use a API REST do Documento de Pesquisa.
Conteúdo ausente no Armazenamento de Blobs
O indexador de Blob localiza e extrai o texto de blobs em um contêiner. Alguns problemas com a extração de texto incluem:
O documento contém apenas imagens digitalizadas. Blobs PDF que têm conteúdo não textual, como imagens digitalizadas (JPGs), não produzem resultados em um pipeline de indexação de Blob padrão. Se você tiver conteúdo de imagem com elementos de texto, você pode usar OCR ou análise de imagem para localizar e extrair o texto.
O indexador de Blob está configurado para metadados do índice. Para extrair conteúdo, você deve configurar o indexador de blob para extrair conteúdo e metadados:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Conteúdo ausente do Azure Cosmos DB
O Pesquisa de IA do Azure tem uma dependência implícita da indexação do Azure Cosmos DB. Se você desativar a indexação automática no Azure Cosmos DB, o Pesquisa de IA do Azure retorna um estado de êxito mas não consegue indexar o conteúdo do contêiner de índice. Para obter instruções sobre como verificar as configurações e ative a indexação, consulte Gerenciar a indexação no Azure Cosmos DB.
Discrepância de contagem de documentos entre a fonte de dados e o índice
Um indexador pode mostrar uma contagem de documentos diferente da fonte de dados, do próprio índice ou da contagem em seu código. Aqui estão alguns possíveis motivos pelos quais esse comportamento pode ocorrer:
- O índice pode ter um atraso ao mostrar a contagem real de documentos, especialmente no portal do Azure.
- O indexador tem uma Política de Documento Excluída. Os documentos excluídos serão contados pelo indexador se os documentos forem indexados antes de serem excluídos.
- Se a coluna ID na fonte de dados não for exclusiva. Essa condição se aplica a fontes de dados que têm o conceito de colunas, como Azure Cosmos DB.
- Se a definição da fonte de dados tiver uma consulta diferente da que você está usando para estimar o número de registros. Por exemplo, em seu banco de dados, você está consultando a contagem de registros de banco de dados, enquanto na consulta de definição da fonte de dados, você pode estar selecionando apenas um subconjunto de registros para indexar.
- As contagens são verificadas em intervalos diferentes para cada componente do pipeline: fonte de dados, indexador e índice.
- A fonte de dados tem um arquivo mapeado para muitos documentos. Essa condição pode ocorrer quando os blobs de indexação e "parsingMode" são definidos como
jsonArrayejsonLines.
Documentos processados várias vezes
Os indexadores usam uma estratégia de buffer conservadora para garantir que todos os documentos novos e alterados na fonte de dados são coletados durante a indexação. Em determinadas situações, esses buffers podem se sobrepor, fazendo com que um indexador indexe um documento duas ou mais vezes. Como resultado, a contagem de documentos processados é maior do que o número real de documentos na fonte de dados. Esse comportamento não afeta os dados armazenados no índice, como a duplicação de documentos, apenas que pode levar mais tempo para alcançar a consistência eventual. Esta condição será especialmente predominante se qualquer um dos seguintes critérios for verdadeiro:
- As solicitações do indexador sob demanda são emitidas em rápida sucessão.
- A topologia da fonte de dados inclui várias réplicas e partições, como a topologia descrita nos níveis de consistência em Azure Cosmos DB.
- A fonte de dados é um banco de dados do SQL do Azure e a coluna escolhida como "high water mark" é do tipo
datetime2.
Os indexadores não devem ser invocados várias vezes em sucessão rápida. Se você precisar de atualizações rapidamente, a abordagem com suporte é fazer push de atualizações para o índice ao atualizar simultaneamente a fonte de dados. Para o processamento sob demanda, distribua suas solicitações em intervalos de cinco minutos ou mais e execute o indexador em uma programação.
Exemplo de processamento de documento duplicado com buffer de 30 segundos
A linha do tempo a seguir explica as condições em que um documento é processado duas vezes. Ele registra cada ação e contra-ação. A linha do tempo a seguir ilustra o problema:
| Linha do tempo (hh:mm:ss) | Evento | Marca d'água alta do indexador | Comentário |
|---|---|---|---|
| 00:01:00 | Gravar doc1 na fonte de dados com consistência eventual |
null |
O data/hora do documento é 00:01:00. |
| 00:01:05 | Gravar doc2 na fonte de dados com consistência eventual |
null |
O data/hora do documento é 00:01:05. |
| 00:01:10 | O indexador é iniciado | null |
|
| 00:01:11 | Consultas do indexador para todas as alterações antes de 00:01:10; a réplica da quais as consultas do indexador estão cientes doc2 apenas de; somentedoc2 é recuperada |
null |
O indexador solicita todas as alterações antes de iniciar o timestamp, mas, na verdade, recebe um subconjunto. Esse comportamento exige o período de buffer de retorno. |
| 00:01:12 | Processos do indexadordoc2 pela primeira vez |
null |
|
| 00:01:13 | O indexador termina | 00:01:10 | A marca d'água alta é atualizada para o início do timestamp da execução atual do indexador. |
| 00:01:20 | O indexador é iniciado | 00:01:10 | |
| 00:01:21 | Consultas do indexador para todas as alterações entre 00:00:40 e 00:01:20; a réplica da quais as consultas do indexador estão cientes de doc1 e doc2; recupera doc1 e doc2 |
00:01:10 | Solicitações do indexador para todas as alterações entre a marca d'água alta atual menos o buffer de 30 segundos e o data/hora inicial da execução atual do indexador. |
| 00:01:22 | Processos do indexadordoc1 pela primeira vez |
00:01:10 | |
| 00:01:23 | Processos do indexadordoc2 pela segunda vez |
00:01:10 | |
| 00:01:24 | O indexador termina | 00:01:20 | A marca d'água alta é atualizada para o início do timestamp da execução atual do indexador. |
| 00:01:32 | O indexador é iniciado | 00:01:20 | |
| 00:01:33 | O indexador consulta todas as alterações entre 00:00:50 e 00:01:32; Recupera doc1 e doc2 |
00:01:20 | Solicitações do indexador para todas as alterações entre a marca d'água alta atual menos o buffer de 30 segundos e o data/hora inicial da execução atual do indexador. |
| 00:01:34 | Processos do indexadordoc1 pela segunda vez |
00:01:20 | |
| 00:01:35 | Processos do indexadordoc2 pela terceira vez |
00:01:20 | |
| 00:01:36 | O indexador termina | 00:01:32 | A marca d'água alta é atualizada para o início do timestamp da execução atual do indexador. |
| 00:01:40 | O indexador é iniciado | 00:01:32 | |
| 00:01:41 | O indexador consulta todas as alterações entre 00:01:02 e 00:01:40; recupera doc2 |
00:01:32 | Solicitações do indexador para todas as alterações entre a marca d'água alta atual menos o buffer de 30 segundos e o data/hora inicial da execução atual do indexador. |
| 00:01:42 | Processos do indexadordoc2 pela quarta vez |
00:01:32 | |
| 00:01:43 | O indexador termina | 00:01:40 | Observe que essa execução do indexador iniciou mais de 30 segundos após a última gravação na fonte de dados e também processou doc2. Esse é o comportamento esperado porque se todas as execuções do indexador antes de 00:01:35 são eliminadas, isso se torna a primeira e única execução a processar doc1 e doc2. |
Na prática, esse cenário só acontece quando você invoca manualmente indexadores sob demanda em minutos um do outro, para determinadas fontes de dados. Isso pode resultar em números incompatíveis (por exemplo, o indexador processa o total de 345 documentos de acordo com as estatísticas de execução do indexador, mas há 340 documentos na fonte e índice de dados) ou potencialmente um aumento na cobrança se você estiver executando as mesmas habilidades para o mesmo documento várias vezes. Executar um indexador usando uma agenda é a recomendação preferencial.
Indexação paralela
Quando vários indexadores são executados ao mesmo tempo, alguns indexadores normalmente entram em uma fila e esperam por recursos disponíveis antes de serem iniciados. Vários fatores determinam quantos indexadores podem ser executados simultaneamente. Se os indexadores não estiverem vinculados a conjuntos de habilidades, o número de réplicas e partições no serviço de AI Search determina quantos indexadores podem ser executados em paralelo.
Se você associar um indexador a um conjunto de habilidades, ele será executado nos clusters internos da Pesquisa de IA. A complexidade do conjunto de habilidades e se outros conjuntos de habilidades são executados ao mesmo tempo determinam quantos indexadores podem ser executados simultaneamente. Os indexadores integrados extraem dados da fonte com confiabilidade, de modo que nenhum dado seja perdido se forem executados conforme uma programação. Mas, os processos do indexador para paralelização e dimensionamento precisam tempo para serem concluídos.
Indexação de documentos com rótulos de confidencialidade
Se você definir rótulos de confidencialidade em documentos, talvez não consiga indexá-los. Se você receber erros, remova os rótulos antes da indexação.