Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Uwaga
Wyszukiwanie AI platformy Azure jest dostępna za pośrednictwem portalu Azure, interfejsów API REST i Azure SDKs. Jest także podstawą Foundry IQ — zarządzanej warstwy wiedzy, która przekształca treści przedsiębiorstwa w bazy wiedzy wielokrotnego użytku z uwzględnieniem uprawnień dla agentów w portalu Microsoft Foundry.
Od czasu do czasu indeksatory napotkają problemy, które nie generują błędów lub występują w innych usługach platformy Azure, takich jak podczas uwierzytelniania lub podczas nawiązywania połączenia. Ten artykuł koncentruje się na rozwiązywaniu problemów z indeksatorem, gdy nie ma komunikatów, które cię przeprowadzą. Zapewnia również rozwiązywanie problemów z błędami pochodzącymi z zasobów innych niż wyszukiwanie używanych podczas indeksowania.
Uwaga
Jeśli masz błąd usługi Wyszukiwanie AI platformy Azure do zbadania, zobacz Rozwiązywanie typowych błędów i ostrzeżeń indeksatora .
Najlepsze rozwiązania
Oto kilka najlepszych rozwiązań i zaleceń podczas pracy z indeksatorami:
Indeksatory są przeznaczone do uruchamiania zgodnie z harmonogramem
- Aby zapewnić niezawodne indeksowanie, skonfiguruj indeksatory do uruchamiania zgodnie z regularnym harmonogramem. Automatycznie harmonogramowane sesje przechwytują wszelkie pominięte dokumenty z poprzednich uruchomień, które zostały pominięte z powodu przejściowych błędów, przerw w sieci lub tymczasowych problemów z usługą. Takie podejście pomaga zachować spójność danych i zminimalizować potrzebę ręcznej interwencji.
- W przypadku dużych źródeł danych początkowe wyliczanie i indeksowanie może potrwać kilka godzin, a nawet dni. Uruchamianie indeksatora zgodnie z harmonogramem pozwala na kontynuowanie postępu, a błędy są automatycznie ponawiane. Unikaj opierania się wyłącznie na ręcznych lub uruchamianych na żądanie uruchomieniach indeksatora, ponieważ te opcje nie zapewniają takiej samej niezawodności ani odzyskiwania po błędach przejściowych.
Indeksatory zapewniają indeksowanie z najlepszym możliwym wysiłkiem w miarę upływu czasu
- Wbudowane indeksatory przetwarzają dokumenty, w których nie występują trwałe błędy, i ponawiają przetwarzanie podczas kolejnych zaplanowanych uruchomień. Oferują one wygodny, niskokodowy lub niekodujący sposób indeksowania danych dla typowych scenariuszy, co umożliwia szybsze opracowywanie i łatwiejszą konserwację. Gdy indeksator uruchamia zestaw umiejętności, każde uruchomienie ma stały limit czasu wykonania. Indeksatory uruchamiane w wielodostępnym środowisku wykonywania mają maksymalny czas wykonywania wynoszący dwie godziny. Ten limit jest najczęściej używany, gdy zestawy umiejętności nie wymagają udostępnionych łączy prywatnych. Indeksatory skonfigurowane do korzystania z współdzielonych łączy prywatnych działają w prywatnym środowisku uruchomieniowym z maksymalnym czasem działania wynoszącym 24 godziny. Aby uzyskać pełną tabelę, zobacz Limity indeksatora. Jeśli przetwarzanie zestawu umiejętności dla poszczególnych dokumentów uniemożliwia indeksatorowi ukończenie pracy przed upływem limitu czasu, indeksator zatrzymuje się i pozostawia pozostałe dokumenty nieprzetworzone. Pełne przetwarzanie nie jest gwarantowane, gdy wolumin dokumentu, rozmiar pliku, złożoność zestawu umiejętności lub środowisko wykonywania uniemożliwiają indeksatorowi zakończenie w maksymalnym czasie wykonywania. Partycjonowanie źródła danych może zmniejszyć to ryzyko, ale nie eliminuje go, szczególnie jeśli później dodasz duże ilości plików do partycji. To zachowanie jest oczekiwane. Informacje o strategiach zarządzania dużymi zestawami danych i obsługi odzyskiwania przyrostowego zawiera sekcja Indeksowanie dużych zestawów danych oraz Planowanie indeksatorów. Jeśli Twoje rozwiązanie wymaga ścisłej kontroli nad tym, kiedy indeksator przetwarza dokumenty, skorzystaj z alternatywy w postaci interfejsu Push API opisanej w tym artykule.
- Jeśli rozwiązanie wymaga ścisłej kontroli nad harmonogramami indeksowania, użyj interfejsów API wypychania, takich jak interfejs API REST indeksu dokumentów, lub metoda IndexDocuments (Azure SDK dla .NET). Te opcje zapewniają pełną kontrolę nad potokiem indeksowania.
- Indeksatory mogą czasami wypadać z harmonogramu. Chociaż ten warunek jest nietypowy, a istnieją mechanizmy automatycznego odzyskiwania, odzyskiwanie może zająć trochę czasu. To zachowanie jest oczekiwane.
Rozwiązywanie problemów z połączeniami do zasobów z ograniczeniami
W przypadku źródeł danych w ramach zabezpieczeń sieci platformy Azure indeksatory są ograniczone w sposobie nawiązywania połączenia. Obecnie indeksatory mogą uzyskiwać dostęp do ograniczonych źródeł danych za zaporą IP lub w sieci wirtualnej za pośrednictwem prywatnego punktu końcowego przy użyciu udostępnionego łącza prywatnego.
Błąd podczas nawiązywania połączenia z zasobem usługi Microsoft Foundry w połączeniu prywatnym
Jeśli zostanie wyświetlony kod błędu 403 z następującym komunikatem, może wystąpić problem ze sposobem określenia punktu końcowego zasobu w zestawie umiejętności:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
Ten błąd występuje, jeśli skonfigurowano udostępniony link prywatny dla połączeń z zasobem Azure Foundry, a punkt końcowy nie ma niestandardowej poddomeny. Niestandardowa poddomena jest pierwszą częścią punktu końcowego (na przykład http://my-custom-subdomain.services.ai.azure.com). W przypadku utworzenia zasobu w portalu Foundry zamiast w portalu Azure, może brakować domeny niestandardowej.
Jeśli zasób Foundry nie znajduje się w tym samym regionie co Wyszukiwanie AI platformy Azure, użyj połączenia bezkluczowego, aby dołączyć zasób.
Błąd podczas korzystania z udostępnionego łącza prywatnego
Jeśli zostanie wyświetlony kod błędu 403 z następującym komunikatem, indeksator może łączyć się za pośrednictwem publicznego punktu końcowego zamiast zatwierdzonego udostępnionego łącza prywatnego:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
Ten błąd może wystąpić, gdy indeksator nie jest skonfigurowany do korzystania ze środowiska wykonywania prywatnego. Upewnij się, że udostępnione łącze prywatne jest zatwierdzone, ustaw wartość executionEnvironment indeksatora na private i sprawdź, czy połączenie używa właściwego punktu końcowego zasobu oraz identyfikatora grupy.
Reguły zapory
Usługi Azure Storage, Azure Cosmos DB i Azure SQL zapewniają konfigurowalną zaporę. Nie ma określonego komunikatu o błędzie, gdy zapora blokuje żądanie. Zazwyczaj błędy zapory są ogólne. Niektóre typowe błędy to:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Aby umożliwić indeksatorom dostęp do tych zasobów, użyj jednej z następujących opcji:
Skonfiguruj regułę ruchu przychodzącego dla adresu IP usługi wyszukiwania i zakresu adresów IP danego tagu
AzureCognitiveSearchusługi. Aby uzyskać szczegółowe informacje na temat konfigurowania ograniczeń zakresu adresów IP dla każdego typu źródła danych, zobacz następujące linki:W ostateczności lub jako środek tymczasowy wyłącz zaporę, zezwalając na dostęp ze wszystkich sieci.
Ograniczenie: Ograniczenia zakresu adresów IP działają tylko wtedy, gdy usługa wyszukiwania i konto magazynu znajdują się w różnych regionach.
Oprócz pobierania danych, indeksatory wysyłają również żądania wychodzące poprzez zestawy umiejętności i umiejętności niestandardowe. W przypadku umiejętności niestandardowych opartych na funkcji platformy Azure należy pamiętać, że funkcje platformy Azure mają również ograniczenia adresów IP. Lista adresów IP umożliwiających wykonywanie niestandardowych umiejętności obejmuje adres IP usługi wyszukiwania i zakres adresów IP tagu AzureCognitiveSearch usługi.
Reguły sieciowej grupy zabezpieczeń (NSG)
Gdy indeksator uzyskuje dostęp do danych w zarządzanym wystąpieniu SQL lub gdy maszyna wirtualna platformy Azure jest używana jako identyfikator URI usługi sieciowej dla umiejętności niestandardowej, sieciowa grupa zabezpieczeń określa, czy żądania są dozwolone.
W przypadku zasobów zewnętrznych znajdujących się w sieci wirtualnej skonfiguruj przychodzące reguły sieciowej grupy zabezpieczeń dla tagu AzureCognitiveSearch usługi.
Aby uzyskać więcej informacji na temat nawiązywania połączenia z maszyną wirtualną, zobacz Konfigurowanie połączenia z programem SQL Server na maszynie wirtualnej platformy Azure.
Błędy sieci
Zazwyczaj błędy sieci są ogólne. Niektóre typowe błędy to:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
W przypadku wystąpienia dowolnego z tych błędów:
- Upewnij się, że możesz uzyskać dostęp do źródła, próbując połączyć się z nim bezpośrednio, a nie za pośrednictwem usługi wyszukiwania.
- Sprawdź zasób w portalu Azure pod kątem bieżących błędów lub awarii.
- Sprawdź w Azure Status, czy występują awarie sieciowe.
- Sprawdź, czy używasz publicznego systemu DNS do rozpoznawania nazw, a nie Azure Prywatna strefa DNS.
Indeksowanie bezserwerowe usługi Azure SQL Database (kod błędu 40613)
Jeśli baza danych SQL znajduje się w bezserwerowej warstwie obliczeniowej, upewnij się, że baza danych jest uruchomiona (i nie jest wstrzymana), gdy indeksator łączy się z nią.
Jeśli baza danych jest wstrzymana, pierwsze logowanie z usługi wyszukiwania automatycznie wznawia bazę danych, ale zamiast tego zwraca błąd informujący, że baza danych jest niedostępna, podając kod błędu 40613. Po uruchomieniu bazy danych spróbuj ponownie zalogować się, aby nawiązać łączność.
Zasady dostępu warunkowego do usługi Microsoft Entra
Podczas tworzenia indeksatora SharePoint należy zalogować się do aplikacji Microsoft Entra po podaniu kodu urządzenia. Jeśli zostanie wyświetlony komunikat z "Your sign-in was successful but your admin requires the device requesting access to be managed"komunikatem , zasady dostępu warunkowego prawdopodobnie blokują indeksator z biblioteki dokumentów SharePoint.
Aby zaktualizować zasady i zezwolić indeksatorowi na dostęp do biblioteki dokumentów:
Otwórz Azure Portal i wyszukaj Dostęp warunkowy usługi Microsoft Entra.
Wybierz pozycję Zasady w menu po lewej stronie. Jeśli nie masz dostępu do wyświetlania tej strony, musisz znaleźć osobę, która ma dostęp lub uzyskać dostęp.
Ustal, które zasady blokują indeksatorowi programu SharePoint dostęp do biblioteki dokumentów. Zasady, które mogą blokować indeksator, obejmują konto użytkownika, które zostało użyte do uwierzytelniania w kroku tworzenia indeksatora w sekcji Użytkownicy i grupy . Polityka może również mieć Warunki, które:
- Ogranicz platformy systemu Windows .
- Ogranicz aplikacje mobilne i klientów desktopowych.
- Ustaw Stan urządzenia na Tak.
Po potwierdzeniu, które zasady blokują indeksator, utwórz wykluczenie dla indeksatora. Zacznij od pobrania adresu IP usługi wyszukiwania.
Najpierw uzyskaj w pełni kwalifikowaną nazwę domeny (FQDN) usługi wyszukiwania. Nazwa FQDN wygląda następująco:
<your-search-service-name>.search.windows.net. Nazwę FQDN można znaleźć w witrynie Azure Portal.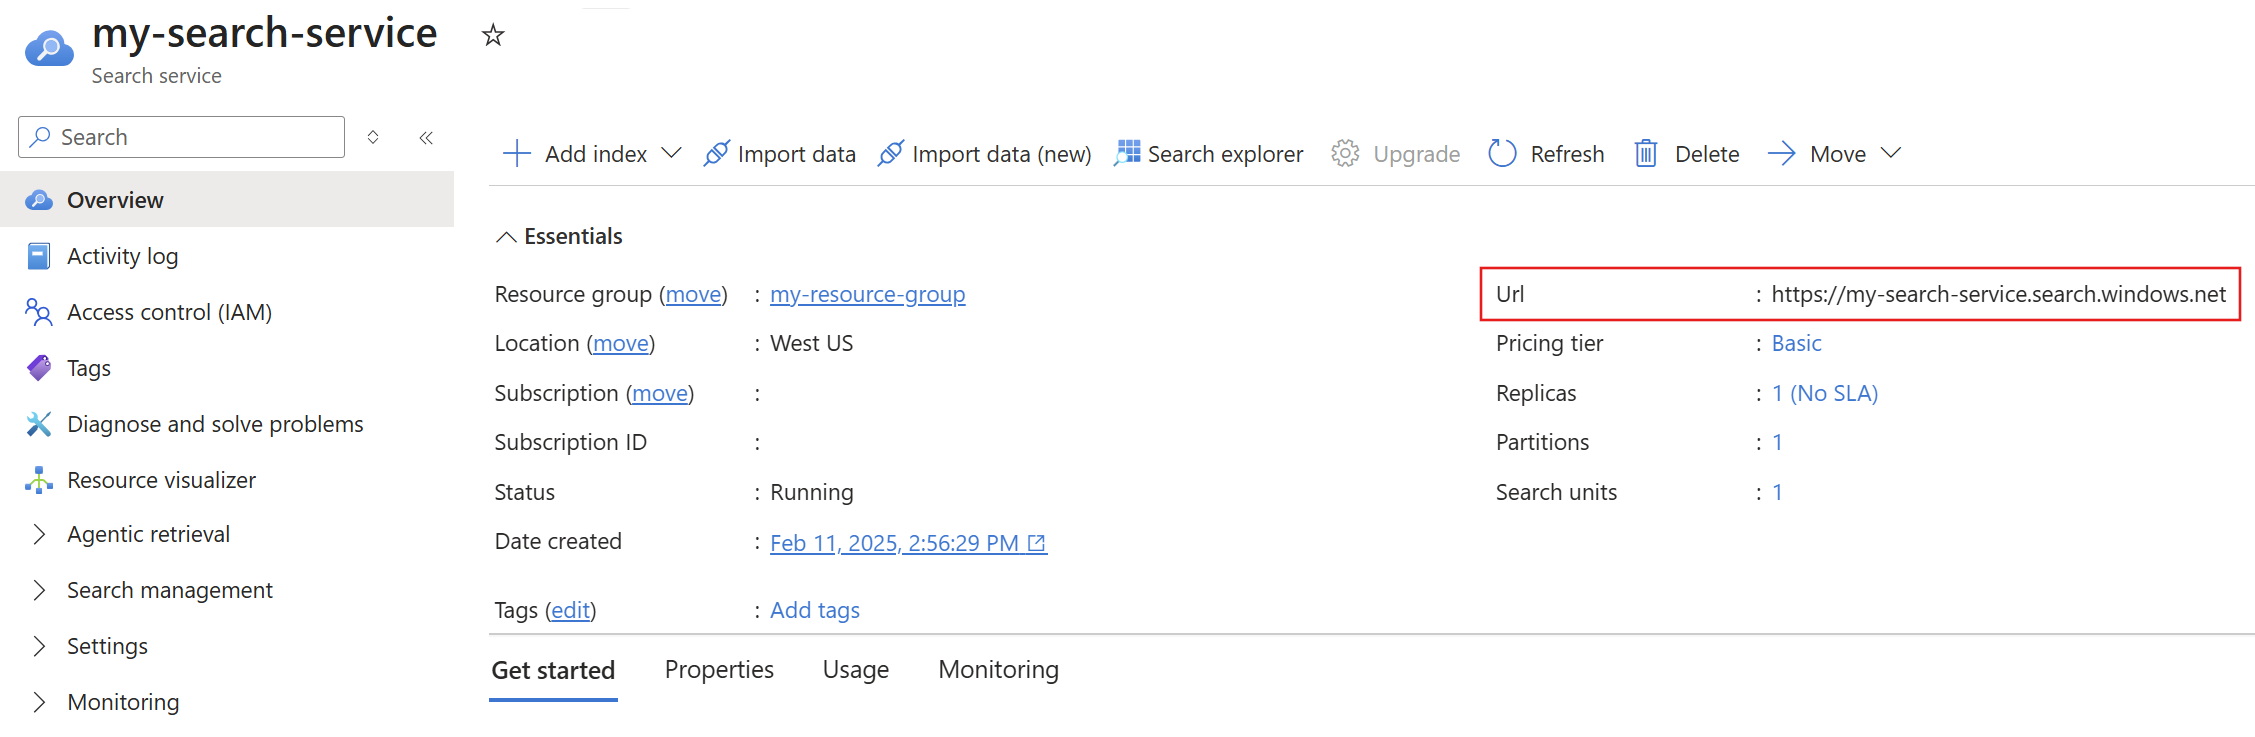
Teraz, gdy masz nazwę FQDN, pobierz adres IP usługi wyszukiwania, wykonując
nslookup(lubping) dla nazwy FQDN. W poniższym przykładzie dodajesz element150.0.0.1do reguły ruchu przychodzącego w zaporze Azure Storage. Może upłynąć do 15 minut po zaktualizowaniu ustawień zapory dla indeksatora usługi wyszukiwania w celu uzyskania dostępu do konta Azure Storage.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netPobierz zakresy adresów IP dla środowiska wykonywania indeksatora dla twojego regionu.
Dodatkowe adresy IP są używane w przypadku żądań pochodzących z wielodostępnego środowiska uruchomieniowego indeksatora. Ten zakres adresów IP można uzyskać z tagu usługi.
Zakresy adresów IP dla tagu usługi można uzyskać za pośrednictwem interfejsu
AzureCognitiveSearchAPI odnajdywania lub pliku JSON, który można pobrać.W tym ćwiczeniu, zakładając, że usługa wyszukiwania znajduje się w publicznej chmurze Azure, pobierz plik JSON platformy Azure Public.
W pliku JSON, zakładając, że usługa wyszukiwania znajduje się w regionie West Central US, podana jest lista adresów IP środowiska wykonywania indeksatora w architekturze wielodostępnej.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Po powrocie na stronę Dostęp warunkowy w Azure Portal wybierz Nazwane lokalizacje z menu po lewej stronie, a następnie wybierz + Lokalizacje zakresów IP. Nadaj nazwę nowej lokalizacji i dodaj zakresy adresów IP dla swojej usługi wyszukiwania oraz środowisk wykonywania indeksatora, które zebrałeś w dwóch ostatnich krokach. 1
- W przypadku adresu IP usługi wyszukiwania może być konieczne dodanie adresu "/32" na końcu adresu IP, ponieważ akceptuje tylko prawidłowe zakresy adresów IP.
- Należy pamiętać, że w przypadku zakresów adresów IP środowiska wykonywania indeksatora należy dodać tylko zakresy adresów IP dla regionu, w którym znajduje się usługa wyszukiwania.
Wyklucz nową nazwaną lokalizację z zasad:
- Wybierz pozycję Zasady w menu po lewej stronie.
- Wybierz zasady blokujące indeksator.
- Wybierz pozycję Warunki.
- Wybierz pozycję Lokalizacje.
- Wybierz pozycję Wyklucz , a następnie dodaj nową lokalizację nazwaną.
- Zapisz zmiany.
Poczekaj kilka minut na zaktualizowanie polityki i wymuszenie nowych reguł.
Spróbuj ponownie utworzyć indeksator:
- Wyślij żądanie aktualizacji dla utworzonego obiektu źródła danych.
- Wyślij ponownie żądanie utworzenia indeksatora. Użyj nowego kodu, aby się zalogować, a następnie wyślij kolejne żądanie utworzenia indeksatora.
Indeksowanie nieobsługiwanych typów dokumentów
Jeśli indeksujesz zawartość z Azure Blob Storage, a kontener zawiera obiekty blob nieobsługiwanego typu zawartości, indeksator pomija ten dokument. W innych przypadkach mogą występować problemy z poszczególnymi dokumentami.
W takiej sytuacji można ustawić opcje konfiguracji, aby umożliwić kontynuowanie przetwarzania indeksatora, jeśli występują problemy z poszczególnymi dokumentami.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Brakujące dokumenty
Indeksatory wyodrębniają dokumenty lub wiersze z zewnętrznego źródła danych i tworzą dokumenty wyszukiwania, które indeksy usługi wyszukiwania. Czasami dokument, który istnieje w źródle danych, nie może pojawić się w indeksie wyszukiwania. Ten nieoczekiwany wynik może wystąpić z następujących powodów:
- Dokument został zaktualizowany po uruchomieniu indeksatora. Jeśli indeksator jest na harmonogramie, w końcu ponownie uruchamia się i przetwarza dokument.
- Upłynął limit czasu indeksatora, zanim dokument będzie mógł zostać pozyskany. Istnieją maksymalne limity czasu przetwarzania, po których żadne dokumenty nie są przetwarzane. Stan indeksatora można sprawdzić w witrynie Azure Portal lub wywołując polecenie Pobierz stan indeksatora (interfejs API REST).
- Mapowania pól lub wzbogacanie sztucznej inteligencji zmieniły dokument, a jego artykulacja w indeksie wyszukiwania różni się od oczekiwanego.
- Wartości śledzenia zmian są błędne lub brakuje warunków wstępnych. Jeśli wysoka wartość limitu jest datą ustawioną na przyszły czas, indeksator pomija wszystkie dokumenty, które mają wcześniejszą datę. Możesz określić stan śledzenia zmian indeksatora przy użyciu pól
initialTrackingStateifinalTrackingStatew stanie indeksatora. Indeksatory dla usług Azure SQL i MySQL muszą mieć indeks w kolumnie wysokiego poziomu wody tabeli źródłowej, w przeciwnym razie zapytania używane przez indeksator mogą się nieukończyć w wymaganym czasie.
Wskazówka
Jeśli brakuje dokumentów, sprawdź zapytanie , którego używasz, aby upewnić się, że nie wyklucza on danego dokumentu. Aby wykonać zapytanie dotyczące określonego dokumentu, użyj interfejsu API REST o nazwie Lookup Document.
Brak zawartości z usługi Blob Storage
Indeksator obiektów blob znajduje i wyodrębnia tekst z obiektów blob w kontenerze. Niektóre problemy z wyodrębnianiem tekstu obejmują:
Dokument zawiera tylko zeskanowane obrazy. Obiekty blob PDF, które mają zawartość nietekstową, takie jak zeskanowane obrazy (JPG), nie są uwzględniane w standardowym procesie indeksowania obiektów blob. Jeśli masz zawartość obrazu z elementami tekstowymi, możesz użyć funkcji OCR lub analizy obrazów, aby znaleźć i wyodrębnić tekst.
Indeksator obiektów blob jest skonfigurowany tylko do indeksowania metadanych. Aby wyodrębnić zawartość, należy skonfigurować indeksator obiektów blob w celu wyodrębnienia zawartości i metadanych:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Brak zawartości z usługi Azure Cosmos DB
Usługa Wyszukiwanie AI platformy Azure ma niejawną zależność od indeksowania usługi Azure Cosmos DB. Jeśli wyłączysz automatyczne indeksowanie w usłudze Azure Cosmos DB, usługa Wyszukiwanie AI platformy Azure zwróci stan powodzenia, ale nie może indeksować zawartości kontenera. Aby uzyskać instrukcje dotyczące sprawdzania ustawień i włączania indeksowania, zobacz Zarządzanie indeksowaniem w usłudze Azure Cosmos DB.
Rozbieżność liczby dokumentów między źródłem danych a indeksem
Indeksator może wyświetlać inną liczbę dokumentów niż źródło danych, sam indeks lub liczba w kodzie. Oto kilka możliwych powodów, dla których takie zachowanie może wystąpić:
- Indeks może opóźnić wyświetlanie rzeczywistej liczby dokumentów, szczególnie w witrynie Azure Portal.
- Indeksator ma politykę usuniętych dokumentów. Usunięte dokumenty są liczone przez indeksator, jeśli dokumenty są indeksowane przed usunięciem.
- Jeśli kolumna ID w źródle danych nie jest unikatowa. Ten warunek dotyczy źródeł danych, które mają pojęcie kolumn, takich jak Azure Cosmos DB.
- Jeśli definicja źródła danych ma inne zapytanie niż to, którego używasz do oszacowania liczby rekordów. Na przykład w bazie danych wysyłasz zapytania dotyczące liczby rekordów bazy danych, podczas gdy w zapytaniu definicji źródła danych możesz wybrać tylko podzbiór rekordów do indeksowania.
- Liczby są sprawdzane w różnych odstępach czasu dla każdego składnika potoku: źródła danych, indeksatora i indeksu.
- Źródło danych ma plik powiązany z wieloma dokumentami. Ten warunek może wystąpić podczas indeksowania obiektów blob, gdy "parsingMode" jest ustawiony na
jsonArrayijsonLines.
Dokumenty przetwarzane wiele razy
Indeksatory używają konserwatywnej strategii buforowania, aby upewnić się, że każdy nowy i zmieniony dokument w źródle danych jest pobierany podczas indeksowania. W niektórych sytuacjach te bufory mogą nakładać się, co powoduje, że indeksator indeksuje dokument dwa razy lub więcej. W związku z tym liczba przetworzonych dokumentów jest większa niż rzeczywista liczba dokumentów w źródle danych. To zachowanie nie ma wpływu na dane przechowywane w indeksie, takie jak duplikowanie dokumentów, tylko to, że osiągnięcie spójności ostatecznej może potrwać dłużej. Ten warunek jest szczególnie powszechny, jeśli którekolwiek z następujących kryteriów są spełnione:
- Żądania indeksowania na żądanie są wysyłane w krótkich odstępach czasu.
- Topologia źródła danych obejmuje wiele replik i partycji, takich jak topologia opisana w sekcji Poziomy spójności w Azure Cosmos DB.
- Źródłem danych jest baza danych Azure SQL, a kolumna wybrana jako „znacznik wysokiego poziomu wody” ma typ
datetime2.
Indeksatory nie mają być wywoływane wielokrotnie w krótkim odstępie czasu. Jeśli potrzebujesz szybko aktualizacji, obsługiwaną metodą jest wysyłanie aktualizacji do indeksu, przy jednoczesnym aktualizowaniu źródła danych. W przypadku przetwarzania na żądanie wysyłaj żądania w odstępach co najmniej pięciu minut i uruchamiaj indeksator zgodnie z harmonogramem.
Przykład zduplikowanego przetwarzania dokumentów z buforem 30 sekund
Na poniższej osi czasu wyjaśniono warunki, w których dokument jest przetwarzany dwa razy. Odnotowuje każde działanie i przeciwdziałanie. Na poniższej osi czasu przedstawiono problem:
| Linia czasu (hh:mm:ss) | Zdarzenie | Wskaźnik wysokiej wody indeksatora | Komentarz |
|---|---|---|---|
| 00:01:00 | Zapisz doc1 w źródle danych ze spójnością ostateczną |
null |
Sygnatura czasowa dokumentu to 00:01:00. |
| 00:01:05 | Zapisz doc2 w źródle danych ze spójnością ostateczną |
null |
Sygnatura czasowa dokumentu to 00:01:05. |
| 00:01:10 | Indeksator się uruchamia | null |
|
| 00:01:11 | Indeksator wykonuje zapytania dotyczące wszystkich zmian przed 00:01:10; replika, z którą indeksator prowadzi zapytania, jest świadoma tylko doc2; pobierane jest tylko doc2 |
null |
Indeksator żąda wszystkich zmian, które zaszły przed określonym znacznikiem czasu, ale faktycznie otrzymuje tylko ich część. To zachowanie wymaga buforu czasu dla wyszukiwania wstecz. |
| 00:01:12 | Indeksator przetwarza doc2 po raz pierwszy |
null |
|
| 00:01:13 | Koniec indeksatora | 00:01:10 | Wysoki poziom wody jest aktualizowany na znacznik czasu rozpoczęcia bieżącego wykonywania indeksatora. |
| 00:01:20 | Indeksator się uruchamia | 00:01:10 | |
| 00:01:21 | Indeksator wykonuje zapytania dotyczące wszystkich zmian z zakresu od 00:00:40 do 00:01:20; replika, do której indeksator kieruje zapytania, jest świadoma zarówno doc1, jak i doc2; pobiera doc1 i doc2 |
00:01:10 | Indeksator żąda wszystkich zmian między bieżącym wysokim poziomem wody a znacznikiem czasu rozpoczęcia bieżącego wykonywania indeksatora, minus 30 sekund buforu. |
| 00:01:22 | Indeksator przetwarza doc1 po raz pierwszy |
00:01:10 | |
| 00:01:23 | Indeksator przetwarza doc2 po raz drugi |
00:01:10 | |
| 00:01:24 | Koniec indeksatora | 00:01:20 | Wysoki poziom wody jest aktualizowany na znacznik czasu rozpoczęcia bieżącego wykonywania indeksatora. |
| 00:01:32 | Indeksator się uruchamia | 00:01:20 | |
| 00:01:33 | Indeksator wykonuje zapytania dotyczące wszystkich zmian z zakresu od 00:00:50 do 00:01:32; pobiera doc1 i doc2 |
00:01:20 | Indeksator żąda wszystkich zmian między bieżącym wysokim poziomem wody a znacznikiem czasu rozpoczęcia bieżącego wykonywania indeksatora, minus 30 sekund buforu. |
| 00:01:34 | Indeksator przetwarza doc1 po raz drugi |
00:01:20 | |
| 00:01:35 | Indeksator przetwarza doc2 po raz trzeci |
00:01:20 | |
| 00:01:36 | Koniec indeksatora | 00:01:32 | Wysoki poziom wody jest aktualizowany na znacznik czasu rozpoczęcia bieżącego wykonywania indeksatora. |
| 00:01:40 | Indeksator się uruchamia | 00:01:32 | |
| 00:01:41 | Indeksator wykonuje zapytania dotyczące wszystkich zmian z zakresu od 00:01:02 do 00:01:40; Pobiera doc2 |
00:01:32 | Indeksator żąda wszystkich zmian między bieżącym wysokim poziomem wody a znacznikiem czasu rozpoczęcia bieżącego wykonywania indeksatora, minus 30 sekund buforu. |
| 00:01:42 | Indeksator przetwarza doc2 po raz czwarty |
00:01:32 | |
| 00:01:43 | Koniec indeksatora | 00:01:40 | Zwróć uwagę, że wykonanie indeksatora rozpoczęło się ponad 30 sekund po ostatnim zapisie w źródle danych i przetworzyło również doc2. Takie zachowanie jest oczekiwane, ponieważ jeśli wszystkie wykonania indeksatora przed 00:01:35 zostaną wyeliminowane, staje się ono pierwszym i jedynym wykonaniem do przetworzenia doc1 i doc2. |
W praktyce ten scenariusz występuje tylko wtedy, gdy ręcznie wywołujesz indeksatory na żądanie w ciągu kilku minut od siebie w przypadku niektórych źródeł danych. Może to spowodować niezgodność liczb (na przykład, gdy indeksator przetworzył łącznie 345 dokumentów zgodnie ze statystykami wykonania indeksatora, ale w źródle danych i indeksie znajduje się tylko 340 dokumentów), lub potencjalne zwiększenie kosztów, jeśli używasz tych samych umiejętności dla tego samego dokumentu wiele razy. Uruchamianie indeksatora przy użyciu harmonogramu jest preferowaną rekomendacją.
Indeksowanie równoległe
Gdy wiele indeksatorów jest uruchamianych w tym samym czasie, niektórzy indeksatorzy zazwyczaj wprowadzają kolejkę i czekają na dostępne zasoby przed rozpoczęciem. Kilka czynników określa liczbę indeksatorów, które mogą być uruchamiane współbieżnie. Jeśli indeksatory nie odwołują się do zestawów umiejętności, liczba replik i partycji w usłudze AI Search określa, ile indeksatorów może działać równolegle.
Jeśli powiążesz indeksator z zestawem umiejętności, zostanie on uruchomiony w klastrach wewnętrznych usługi AI Search. Złożoność zestawu umiejętności i tego, czy inne zestawy umiejętności są uruchamiane w tym samym czasie, określają liczbę indeksatorów, które mogą być uruchamiane współbieżnie. Wbudowane indeksatory niezawodnie wyodrębniają dane ze źródła, więc żadne dane nie są pomijane, jeśli są uruchamiane zgodnie z harmonogramem. Jednak procesy indeksowania związane z równolegleniem i skalowaniem poziomym potrzebują trochę czasu, aby się zakończyć.
Indeksowanie dokumentów z etykietami poufności
Jeśli ustawisz etykiety poufności na dokumentach, indeksowanie może nie być możliwe. Jeśli wystąpią błędy, usuń etykiety przed indeksowaniem.