Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Catatan
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
Pencarian teks lengkap adalah pendekatan dalam pengambilan informasi yang cocok pada teks biasa yang disimpan dalam indeks. Misalnya, dengan kueri pencarian "hotel di San Diego di pantai", mesin pencarian mencari string yang ditokenisasi berdasarkan kata-kata tersebut. Untuk membuat pemindaian lebih efisien, string kueri melalui analisis leksikal: mengubah semua istilah menjadi huruf kecil, menghapus kata berhenti seperti "the", dan mengubah istilah ke bentuk dasar primitif. Saat istilah yang cocok ditemukan, mesin pencari mengambil dokumen, memberi peringkat dalam urutan relevansi, dan mengembalikan hasil teratas.
Eksekusi kueri bisa kompleks. Artikel ini untuk pengembang yang membutuhkan pemahaman yang lebih mendalam tentang cara kerja pencarian teks lengkap di Pencarian Azure AI. Untuk kueri teks, Pencarian Azure AI memberikan hasil yang diharapkan dengan mulus dalam sebagian besar skenario, tetapi kadang-kadang, Anda mungkin mendapatkan hasil yang tampaknya "tidak sesuai" dengan cara yang tidak terduga. Dalam situasi ini, memiliki latar belakang dalam empat tahap eksekusi kueri Lucene (penguraian kueri, analisis leksikal, pencocokan dokumen, dan penilaian) dapat membantu Anda mengidentifikasi perubahan spesifik pada parameter kueri atau konfigurasi indeks yang menghasilkan hasil yang diinginkan.
Catatan
Pencarian Azure AI menggunakan Apache Lucene untuk pencarian teks lengkap, tetapi integrasi Lucene tidak lengkap. Kami secara selektif mengekspos dan memperluas fungsionalitas Lucene untuk mengaktifkan skenario yang penting untuk Pencarian Azure AI.
Gambaran umum dan diagram arsitektur
Eksekusi kueri memiliki empat tahap:
- Penguraian kueri
- Analisis leksikal
- Pengambilan dokumen
- Penilaian
Kueri pencarian teks lengkap dimulai dengan mengurai teks kueri untuk mengekstrak istilah dan operator pencarian. Ada dua pengurai sehingga Anda dapat memilih antara kecepatan dan kompleksitas. Fase analisis berikutnya, di mana istilah kueri individual terkadang dipecah dan direkonstitusi menjadi formulir baru. Langkah ini membantu memperluas cakupan terhadap apa yang dapat dianggap sebagai kecocokan potensial. Mesin pencari kemudian memindai indeks untuk menemukan dokumen dengan istilah-istilah yang cocok dan memberikan skor pada setiap kecocokan. Kumpulan hasil kemudian diurutkan menurut skor relevansi yang ditetapkan untuk setiap dokumen yang cocok. Mereka yang berada di bagian atas daftar peringkat dikembalikan ke aplikasi panggilan.
Diagram berikut mengilustrasikan komponen yang digunakan untuk memproses permintaan pencarian:
Diagram arsitektur kueri Lucene dalam Pencarian Azure AI.
| Komponen utama | Deskripsi fungsi |
|---|---|
| Pengurai kueri | Pisahkan istilah kueri dari operator kueri dan buat struktur kueri (pohon kueri) untuk dikirim ke mesin pencari. |
| Analizator | Lakukan analisis leksikal pada istilah kueri. Proses ini dapat melibatkan transformasi, penghapusan, atau perluasan istilah kueri. |
| Indeks | Struktur data efisien yang digunakan untuk menyimpan dan mengatur istilah yang dapat dicari yang diekstrak dari dokumen terindeks. |
| Mesin pencari | Mengambil dan menilai dokumen yang cocok berdasarkan konten indeks terbalik. |
Anatomi permintaan pencarian
Permintaan pencarian adalah spesifikasi lengkap tentang apa yang harus dikembalikan dalam tataan hasil. Dalam bentuk yang paling sederhana, ini adalah kueri kosong tanpa kriteria apa pun. Contoh yang lebih realistis mencakup parameter, beberapa istilah kueri, mungkin berkaitan dengan bidang tertentu, dengan mungkin ekspresi filter dan aturan urutan.
Contoh berikut adalah permintaan pencarian yang mungkin Anda kirim ke Pencarian Azure AI menggunakan REST API:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Untuk permintaan ini, mesin pencari melakukan operasi berikut:
Menemukan dokumen di mana harganya setidaknya $60 dan kurang dari $300.
Menjalankan kueri. Dalam contoh ini, kueri pencarian terdiri dari frasa dan istilah:
"Spacious, air-condition* +\"Ocean view\""(Pengguna biasanya tidak memasukkan tanda baca, tetapi dengan menyertakannya dalam contoh, kita dapat menjelaskan bagaimana penganalisis menanganinya.)Untuk kueri ini, mesin pencari memindai deskripsi dan bidang judul yang ditentukan dalam "searchFields" untuk dokumen yang berisi
"Ocean view", dan juga pada istilah"spacious", atau pada istilah yang dimulai dengan awalan"air-condition". Parameter "searchMode" digunakan untuk mencocokkan istilah apa pun (default) atau semuanya, untuk kasus di mana istilah tidak diperlukan secara eksplisit (+).Memesan set hotel yang dihasilkan berdasarkan kedekatan dengan lokasi geografi tertentu, lalu mengembalikan hasilnya ke aplikasi panggilan.
Sebagian besar artikel ini adalah tentang pemrosesan kueri pencarian: "Spacious, air-condition* +\"Ocean view\"". Pemfilteran dan pengurutan berada di luar cakupan. Untuk informasi selengkapnya, lihat dokumentasi referensi Search API.
Tahap 1: Penguraian kueri
Seperti yang disebutkan, string kueri adalah baris pertama permintaan:
"search": "Spacious, air-condition* +\"Ocean view\"",
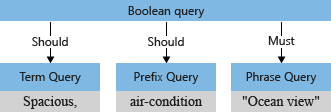
Pengurai kueri memisahkan operator (seperti * dan + dalam contoh) dari istilah pencarian dan mendekonstruksi kueri pencarian menjadi subkueri dari jenis yang didukung:
- kueri istilah untuk istilah mandiri (seperti luas)
- kueri frasa untuk istilah yang dikutip (seperti pemandangan laut)
-
kueri awalan untuk istilah yang diikuti oleh operator awalan
*(seperti air-condition)
Untuk daftar lengkap jenis kueri yang didukung, lihat Sintaks kueri Lucene.
Operator yang terkait dengan subkueri menentukan apakah kueri "harus" atau "harus" terpenuhi agar dokumen dianggap cocok. Misalnya, +"Ocean view" adalah "harus" karena operator +.
Pengurai kueri merestrukturisasi subkueri ke dalam pohon kueri (struktur internal yang mewakili kueri), yang diteruskannya ke mesin pencari. Pada tahap pertama penguraian kueri, pohon kueri terlihat seperti ini:
Jenis pengurai yang didukung: Lucene Simple dan Full
Pencarian Azure AI mengekspos dua bahasa kueri yang berbeda: simple (default) dan full. Dengan mengatur queryType parameter dengan permintaan pencarian, Anda memberi tahu pengurai kueri bahasa kueri mana yang Anda pilih sehingga tahu cara menginterpretasikan operator dan sintaks.
Bahasa kueri Sederhana intuitif dan kuat, sering kali cocok untuk menafsirkan input pengguna as-is tanpa pemrosesan sisi klien. Ini mendukung operator kueri yang sudah dikenal dari mesin pencari web.
Bahasa kueri Lucene Lengkap, yang dapat digunakan dengan menetapkan
queryType=full, memperluas bahasa kueri Sederhana default dengan menambahkan dukungan untuk lebih banyak operator dan jenis kueri seperti wildcard, fuzzy, regex, dan kueri berbasis bidang. Misalnya, ekspresi reguler yang dikirim dalam sintaks kueri Sederhana akan ditafsirkan sebagai string kueri dan bukan ekspresi. Contoh permintaan dalam artikel ini menggunakan bahasa kueri Full Lucene.
Dampak searchMode pada pengurai
Parameter permintaan pencarian lain yang memengaruhi penguraian adalah parameter "searchMode". Ini mengontrol operator default untuk kueri Boolean: apa pun (default) atau semua.
Ketika "searchMode=any", yang merupakan default, pemisah spasi antara luas dan penyejuk udara adalah OR (||), membuat teks kueri sampel setara dengan:
Spacious,||air-condition*+"Ocean view"
Operator eksplisit, seperti + dalam +"Ocean view", tidak ambigu dalam konstruksi kueri boolean (istilah harus cocok). Kurang jelas adalah cara menafsirkan istilah yang tersisa: luas dan AC. Haruskah mesin pencari menemukan kecocokan pada pemandangan laut dan ruang yang luas dan pendingin udara? Atau haruskah mencari pemandangan laut ditambah salah satu dari istilah lain yang tersisa?
Secara default ("searchMode=any"), mesin pencari mengasumsikan interpretasi yang lebih luas. Salah satu bidang harus dicocokkan, mencerminkan semantik "atau". Pohon kueri awal yang diilustrasikan sebelumnya, dengan dua operasi "harus", memperlihatkan default.
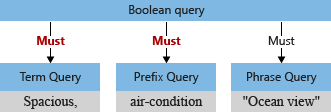
Misalkan kita sekarang mengatur "searchMode=all". Dalam hal ini, spasi ditafsirkan sebagai operasi "dan". Kedua istilah yang tersisa harus ada dalam dokumen untuk memenuhi syarat kecocokan. Kueri sampel yang dihasilkan akan ditafsirkan seperti ini:
+Spacious,+air-condition*+"Ocean view"
Pohon kueri yang dimodifikasi untuk kueri ini, di mana dokumen yang cocok adalah persimpangan ketiga subkueri, akan terlihat seperti ini:
Catatan
Memilih "searchMode=any" daripada "searchMode=all" adalah keputusan terbaik yang dibuat dengan menjalankan kueri perwakilan. Pengguna yang cenderung menyertakan operator (umum saat mencari penyimpanan dokumen) mungkin menemukan hasil yang lebih intuitif jika "searchMode=all" menginformasikan konstruksi kueri boolean. Untuk informasi selengkapnya tentang interplay antara "searchMode" dan operator, lihat Sintaks kueri sederhana.
Tahap 2: Analisis leksikal
Penganalisis leksikal memproses kueri istilah dan kueri frasa setelah pohon kueri disusun. Penganalisis menerima input teks yang diberikan oleh pengurai, memproses teks, lalu mengirim kembali istilah yang ditokenisasi untuk dimasukkan ke dalam pohon kueri.
Bentuk analisis leksikal yang paling umum adalah analisis linguistik, yang mengubah istilah kueri berdasarkan aturan khusus untuk bahasa tertentu. Ini melibatkan:
- Menyederhanakan istilah pencarian ke bentuk akar kata.
- Menghapus kata-kata yang tidak penting (stopwords, seperti "the" atau "and" dalam bahasa Inggris).
- Memecah kata komposit menjadi bagian komponen.
- Mengubah kata dari huruf besar menjadi huruf kecil.
Semua operasi ini cenderung menghapus perbedaan antara input teks yang disediakan oleh pengguna dan istilah yang disimpan dalam indeks. Operasi tersebut melampaui pemrosesan teks dan membutuhkan pengetahuan mendalam tentang bahasa itu sendiri. Untuk menambahkan lapisan kesadaran linguistik ini, Pencarian Azure AI mendukung daftar panjang penganalisis language dari Lucene dan Microsoft.
Catatan
Bergantung pada skenario Anda, persyaratan analisis dapat berkisar dari minimal hingga menguraikan. Anda dapat mengontrol kompleksitas analisis leksikal dengan memilih salah satu penganalisis yang telah ditentukan sebelumnya atau dengan membuat penganalisis kustom Anda sendiri. Penganalisis dilingkup ke bidang yang dapat dicari dan ditentukan sebagai bagian dari definisi bidang. Ini memungkinkan Anda untuk bervariasi analisis leksikal berdasarkan per bidang. Jika tidak ditentukan, analyzer Lucene standar akan digunakan.
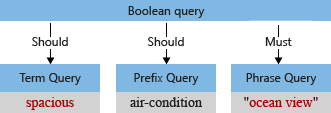
Dalam contoh kami, sebelum analisis, pohon kueri awal memiliki istilah "Luas," dengan huruf besar "S" dan koma yang ditafsirkan pengurai kueri sebagai bagian dari istilah kueri (koma tidak dianggap sebagai operator bahasa kueri).
Ketika penganalisis default memproses istilah, ia akan mengubah "pemandangan laut" dan "luas" menjadi huruf kecil serta menghapus karakter koma. Pohon kueri yang dimodifikasi terlihat seperti ini:
Menguji perilaku penganalisis
Perilaku penganalisis dapat diuji menggunakan Analyze API. Berikan teks yang ingin Anda analisis untuk melihat istilah apa yang dihasilkan penganalisis yang diberikan. Misalnya, untuk melihat bagaimana penganalisis standar akan memproses teks "AC", Anda dapat mengeluarkan permintaan berikut:
{
    "text": "air-condition",
    "analyzer": "standard"
}
Penganalisis standar memecah teks input menjadi dua token berikut, menganotasinya dengan atribut seperti offset awal dan akhir (digunakan untuk penyorotan hit) serta posisinya (digunakan untuk pencocokan frasa):
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Pengecualian untuk analisis leksikal
Analisis leksikal hanya berlaku untuk jenis kueri yang memerlukan istilah lengkap, baik kueri istilah atau kueri frasa. Ini tidak berlaku untuk jenis kueri dengan istilah yang tidak lengkap—kueri awalan, kueri wildcard, dan kueri regex—atau pada kueri fuzzy. Jenis kueri tersebut, termasuk kueri awalan dengan istilah air-condition* dalam contoh kami, ditambahkan langsung ke pohon kueri, melewati tahap analisis. Satu-satunya transformasi yang dilakukan pada istilah kueri dari jenis tersebut adalah menjadikannya huruf kecil.
Tahap 3: Pengambilan dokumen
Pengambilan dokumen mengacu pada menemukan dokumen dengan istilah yang cocok dalam indeks. Tahap ini paling baik dipahami melalui contoh. Mari kita mulai dengan indeks hotel yang memiliki skema sederhana berikut:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Asumsikan lebih lanjut bahwa indeks ini berisi empat dokumen berikut:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Cara istilah diindeks
Untuk memahami penelusuran, penting mengetahui beberapa prinsip dasar tentang pengindeksan. Unit penyimpanan adalah indeks terbalik, satu untuk setiap bidang yang dapat dicari. Dalam indeks terbalik terdapat daftar istilah yang diurutkan dari semua dokumen. Setiap istilah dihubungkan dengan daftar dokumen di mana tempat setiap istilah muncul, seperti terlihat pada contoh di bawah.
Untuk menghasilkan istilah dalam indeks terbalik, mesin pencari melakukan analisis leksikal atas konten dokumen, mirip dengan apa yang terjadi selama pemrosesan kueri:
- Input teks diteruskan ke penganalisis, diubah menjadi huruf kecil, dihilangkan tanda baca, dan lain-lain, tergantung pada konfigurasi penganalisis.
- Token adalah output dari analisis leksikal.
- Istilah telah ditambahkan ke indeks.
Ini umum, tetapi tidak diperlukan, untuk menggunakan penganalisis yang sama untuk operasi pencarian dan pengindeksan sehingga istilah kueri terlihat lebih seperti istilah di dalam indeks.
Catatan
Pencarian Azure AI memungkinkan Anda menentukan penganalisis yang berbeda untuk pengindeksan dan pencarian melalui parameter bidang indexAnalyzer dan searchAnalyzer tambahan. Jika tidak ditentukan, penganalisis yang diatur dengan properti analyzer digunakan untuk pengindeksan dan pencarian.
Indeks terbalik untuk dokumen contoh
Kembali ke contoh kami, untuk bidang judul , indeks terbalik terlihat seperti ini:
| Istilah | Daftar dokumen |
|---|---|
| Atman | 1 |
| pantai | 2 |
| Hotel | 1, 3 |
| Laut | 4 |
| Playa | 3 |
| Resort | 2 |
| Retreat | 4 |
Di bidang judul, hanya hotel yang muncul dalam dua dokumen: 1 dan 3.
Untuk bidang deskripsi , indeks terlihat seperti ini:
| Istilah | Daftar dokumen |
|---|---|
| Udara | 3 |
| Dan | 4 |
| pantai | 1 |
| Dikondisikan | 3 |
| Nyaman | 3 |
| Jarak | 1 |
| Pulau | 2 |
| kauaʻi | 2 |
| Terletak | 2 |
| Utara | 2 |
| Laut | 1, 2, 3 |
| dari | 2 |
| Pada | 2 |
| Tenang | 4 |
| Kamar | 1, 3 |
| Terpencil | 4 |
| Pantai | 2 |
| Lapang | 1 |
| Tje | 1, 2 |
| Untuk | 1 |
| tampakan | 1, 2, 3 |
| Berjalan | 1 |
| Dengan | 3 |
Mencocokkan istilah kueri terhadap istilah terindeks
Mengingat indeks terbalik di atas, mari kita kembali ke kueri sampel dan melihat bagaimana dokumen yang cocok ditemukan untuk kueri contoh kami. Ingatlah bahwa pohon kueri akhir tampil seperti ini:
Selama eksekusi kueri, kueri individual dijalankan terhadap bidang yang dapat dicari secara independen.
TermQuery, "luas", cocok dengan dokumen 1 (Hotel Atman).
PrefixQuery, "AC*", tidak cocok dengan dokumen apa pun.
Perilaku ini terkadang membingungkan pengembang. Meskipun istilah berpendingin udara ada dalam dokumen, istilah tersebut dibagi menjadi dua istilah oleh analisis default. Ingat bahwa kueri awalan, yang berisi istilah parsial, tidak dianalisis. Oleh karena itu, istilah dengan awalan "AC" dicari dalam indeks terbalik dan tidak ditemukan.
PhraseQuery, "pemandangan laut", mencari istilah "laut" dan "pemandangan" serta memeriksa kedekatan istilah tersebut dalam dokumen asli. Dokumen 1, 2, dan 3 cocok dengan kueri ini di bidang deskripsi. Perhatikan dokumen 4 memiliki istilah "lautan" dalam judul tetapi tidak dianggap cocok, karena kita mencari frasa "pemandangan laut" daripada kata-kata individual.
Catatan
Kueri pencarian dijalankan secara independen terhadap semua bidang yang dapat dicari dalam indeks Pencarian Azure AI kecuali Anda membatasi bidang yang diatur dengan parameter searchFields, seperti yang diilustrasikan dalam contoh permintaan pencarian. Dokumen yang cocok di salah satu bidang yang dipilih dikembalikan.
Secara keseluruhan, untuk kueri yang dimaksud, dokumen yang cocok adalah 1, 2, dan 3.
Tahap 4: Penilaian
Setiap dokumen dalam kumpulan hasil pencarian diberi skor relevansi. Fungsi skor relevansi adalah memberi peringkat lebih tinggi dokumen yang paling baik menjawab pertanyaan pengguna seperti yang dinyatakan oleh kueri pencarian. Skor dihitung berdasarkan properti statistik istilah yang cocok. Pada inti rumus penilaian adalah frekuensi istilah–frekuensi dokumen terbalik (TF/IDF). Dalam kueri yang berisi istilah langka dan umum, TF/IDF mempromosikan hasil yang berisi istilah langka. Misalnya, dalam indeks hipotetis dengan semua artikel Wikipedia, dari dokumen yang cocok dengan kueri ketua presiden, dokumen yang cocok pada presiden dianggap lebih relevan daripada dokumen yang hanya cocok pada the.
Contoh penilaian skor
Ingat tiga dokumen yang cocok dengan kueri contoh kami:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Dokumen 1 paling cocok dengan kueri karena istilah luas dan frasa yang diperlukan pemandangan laut terdapat di bidang deskripsi. Dua dokumen berikutnya hanya cocok dengan frasa pemandangan laut. Anda mungkin terkejut bahwa skor relevansi untuk dokumen 2 dan 3 berbeda, meskipun cocok dengan kueri dengan cara yang sama. Itu karena rumus penilaian memiliki lebih banyak komponen daripada hanya TF/IDF. Dalam hal ini, dokumen 3 diberi skor yang sedikit lebih tinggi karena deskripsinya lebih pendek. Pelajari tentang Formula Penilaian Praktis Lucene untuk memahami bagaimana panjang bidang dan faktor lain dapat memengaruhi skor relevansi.
Beberapa jenis kueri (wildcard, awalan, dan regex) selalu memberikan skor konstan terhadap skor keseluruhan dokumen. Ini memungkinkan kecocokan yang ditemukan melalui ekspansi kueri disertakan dalam hasil tanpa memengaruhi peringkat.
Contoh menggambarkan mengapa hal ini penting. Pencarian wildcard, termasuk pencarian awalan, secara definisi memang ambigu karena input berupa string parsial dengan potensi kecocokan pada sejumlah besar istilah yang berbeda. Pertimbangkan input "tour*", dengan kecocokan yang ditemukan pada "tours", "tourettes", dan "tourmaline". Mengingat sifat hasil ini, tidak ada cara untuk secara wajar menyimpulkan istilah mana yang lebih berharga daripada yang lain. Untuk alasan ini, kami mengabaikan frekuensi istilah saat menilai hasil kueri jenis wildcard, awalan, dan regex. Dalam permintaan pencarian multi-bagian yang mencakup istilah parsial dan lengkap, hasil dari input parsial dimasukkan dengan skor konstan untuk menghindari bias terhadap kecocokan yang berpotensi tidak terduga.
Penyetelan relevansi
Ada dua cara untuk menyetel skor relevansi dalam Pencarian Azure AI:
Profil penilaian mempromosikan dokumen dalam daftar peringkat hasil berdasarkan sekumpulan aturan. Dalam contoh kami, kami dapat mempertimbangkan dokumen yang cocok di bidang judul lebih relevan daripada dokumen yang cocok di bidang deskripsi. Selain itu, jika indeks kami memiliki bidang harga untuk setiap hotel, kami dapat mempromosikan dokumen dengan harga yang lebih rendah. Pelajari selengkapnya tentang menambahkan profil penilaian ke indeks pencarian.
Peningkatan istilah (hanya tersedia dalam sintaks kueri Lucene Penuh) menyediakan operator
^peningkatan yang dapat diterapkan ke bagian mana pun dari pohon kueri. Dalam contoh kami, daripada mencari pada awalan penyejuk udara* atau AC*, seseorang dapat mencari istilah yang tepat penyejuk udara atau awalan, tetapi dokumen yang cocok dengan istilah yang tepat diberi peringkat lebih tinggi dengan memberikan peningkatan pada kueri istilah: penyejuk udara^2||penyejuk udara* atau AC^2||AC*. Pelajari selengkapnya tentang peningkatan istilah dalam kueri.
Penilaian dalam indeks terdistribusi
Semua indeks dalam Pencarian Azure AI secara otomatis dibagi menjadi beberapa pecahan, memungkinkan kami untuk dengan cepat mendistribusikan indeks di antara beberapa simpul selama peningkatan atau penurunan skala layanan. Saat permintaan pencarian dikeluarkan, hal ini dilakukan terhadap setiap shard secara independen. Hasil dari setiap shard kemudian digabungkan dan diurutkan berdasarkan skor (jika tidak ada pengurutan lain yang ditentukan). Penting untuk diketahui bahwa fungsi penilaian memberikan bobot pada frekuensi istilah kueri terhadap frekuensi dokumen terbalik di semua dokumen dalam pecahan (data), bukan di semua pecahan!
Ini berarti skor relevansi bisa berbeda untuk dokumen yang identik jika berada di pecahan yang berbeda. Untungnya, perbedaan tersebut cenderung menghilang seiring bertambahnya jumlah dokumen dalam indeks karena distribusi istilah yang lebih merata. Tidak mungkin untuk mengasumsikan di shard mana dokumen tertentu akan ditempatkan. Namun, jika kunci dokumen tetap tidak berubah, maka selalu ditetapkan ke shard yang sama.
Secara umum, skor dokumen bukan atribut terbaik untuk mengurutkan dokumen jika stabilitas urutan penting. Misalnya, jika terdapat dua dokumen dengan skor identik, tidak ada jaminan bahwa salah satu dokumen akan muncul terlebih dahulu dalam eksekusi berikutnya dari kueri yang sama. Skor dokumen hanya boleh memberikan rasa umum relevansi dokumen relatif terhadap dokumen lain dalam kumpulan hasil.
Kesimpulan
Keberhasilan mesin pencari komersial telah memunculkan harapan untuk pencarian teks lengkap melalui data privat. Untuk hampir semua jenis pengalaman pencarian, kami sekarang mengharapkan mesin untuk memahami niat kami, bahkan ketika istilah salah eja atau tidak lengkap. Kita bahkan mungkin mengharapkan kecocokan berdasarkan istilah atau sinonim yang hampir setara yang tidak pernah kita tentukan.
Dari sudut pandang teknis, pencarian teks lengkap sangat kompleks, membutuhkan analisis linguistik canggih dan pendekatan sistematis untuk memproses dengan cara yang menyuling, memperluas, dan mengubah istilah kueri untuk memberikan hasil yang relevan. Mengingat kompleksitas yang melekat, ada banyak faktor yang dapat memengaruhi hasil kueri. Untuk alasan ini, menginvestasikan waktu untuk memahami mekanisme pencarian teks lengkap menawarkan manfaat nyata ketika mencoba bekerja melalui hasil yang tidak terduga.
Artikel ini menjelajahi pencarian teks lengkap dalam konteks Pencarian Azure AI. Kami berharap itu memberi Anda latar belakang yang cukup untuk mengenali potensi penyebab dan resolusi untuk mengatasi masalah kueri umum.
Langkah berikutnya
Buat indeks sampel, cobalah kueri yang berbeda, dan tinjau hasilnya. Untuk petunjuknya, lihat Membangun dan mem-query indeks di portal Azure.
Coba sintaks kueri lainnya dari bagian contoh Search Documents atau dari sintaks kueri Simple di Penjelajah pencarian di portal Azure.
Tinjau profil penilaian jika Anda ingin menyetel peringkat di aplikasi pencarian Anda.
Terapkan penganalisis leksikal khusus bahasa.
Konfigurasikan penganalisis kustom untuk pemrosesan minimal atau pemrosesan khusus pada bidang tertentu.