Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Note
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
Artikel ini menjelaskan langkah-langkah dasar untuk membuat pengindeks yang mengotomatiskan penyerapan data untuk sumber data yang didukung. Bergantung pada sumber data dan alur kerja Anda, Anda mungkin memerlukan lebih banyak konfigurasi.
Anda dapat menggunakan pengindeks untuk mengotomatiskan impor dan pengindeksan data di Pencarian Azure AI. Pengindeks adalah objek bernama pada search service yang terhubung ke sumber data Azure eksternal, membaca dan menserialisasikan data, dan meneruskannya ke mesin pencari untuk pengindeksan. Menggunakan pengindeks secara signifikan mengurangi jumlah dan kompleksitas kode yang perlu Anda tulis untuk sumber data yang didukung.
Pengindeks mendukung dua alur kerja:
Pengindeksan konten mentah (teks biasa atau vektor): Mengekstrak string dan metadata dari konten tekstual untuk skenario pencarian teks lengkap. Ini juga mengekstrak konten vektor mentah untuk pencarian vektor (misalnya, vektor dalam koleksi Azure SQL database atau Azure Cosmos DB). Dalam alur kerja ini, pengindeksan hanya terjadi melalui konten yang sudah ada yang Anda sediakan.
Pengindeksan berbasis keterampilan: Memperluas pengindeksan melalui keterampilan bawaan atau kustom yang menghasilkan konten baru yang dapat dicari. Misalnya, Anda dapat menambahkan machine learning terintegrasi untuk analisis atas gambar dan teks yang tidak terstruktur, mengekstrak atau menyimpulkan teks dan struktur. Anda juga dapat menggunakan keterampilan untuk memotong dan mem-vektorisasi konten dari teks dan gambar. Pengindeksan berbasis keterampilan menghasilkan konten baru yang tidak ada di sumber data eksternal Anda. Konten baru menjadi bagian dari indeks Anda saat Anda menambahkan bidang ke skema indeks yang menerima data masuk. Untuk mempelajari lebih lanjut, lihat pengayaan AI di Pencarian Azure AI.
Prerequisites
Sumber data yang didukung yang berisi konten yang ingin Anda serap.
Definisi sumber data yang menyiapkan koneksi ke data eksternal.
Berada di bawah batas maksimum untuk tingkat layanan Anda. Tingkatan gratis memungkinkan tiga objek dari setiap jenis dan 1-3 menit pengindeksan, atau 3-10 menit jika ada paket keterampilan.
Pola pengindeks
Saat Anda membuat pengindeks, definisi mengikuti salah satu dari dua pola: pengindeksan berbasis konten atau pengindeksan berbasis keterampilan. Polanya serupa, tetapi pengindeksan berbasis keterampilan mencakup properti tambahan.
Contoh pengindeks untuk pengindeksan berbasis konten
Pengindeksan berbasis konten untuk pencarian teks lengkap atau vektor adalah kasus penggunaan utama untuk pengindeks. Untuk alur kerja ini, pengindeks terlihat seperti contoh ini.
{
  "name": (required) String that uniquely identifies the indexer,
  "description": (optional),
  "dataSourceName": (required) String indicating which existing data source to use,
  "targetIndexName": (required) String indicating which existing index to use,
  "parameters": {
    "batchSize": null,
    "maxFailedItems": 0,
    "maxFailedItemsPerBatch": 0,
    "base64EncodeKeys": false,
    "configuration": {}
  },
  "fieldMappings": (optional) unless field discrepancies need resolution,
  "disabled": null,
  "schedule": null,
  "encryptionKey": null
}
Pengindeks memiliki persyaratan berikut:
- Properti
nameyang secara unik mengidentifikasi pengindeks dalam koleksi pengindeks - Properti
dataSourceNameyang menunjuk ke objek sumber data. Ini menentukan koneksi ke data eksternal - Properti
targetIndexNameyang menunjuk ke indeks pencarian tujuan
Parameter lain bersifat opsional dan mengubah perilaku runtime, seperti menentukan jumlah kesalahan yang dapat diterima sebelum seluruh pekerjaan dianggap gagal. Parameter yang diperlukan ditentukan di semua pengindeks dan didokumenkan dalam referensi REST API.
Pengindeks khusus sumber data untuk blob, SQL, dan Azure Cosmos DB menyediakan parameter configuration tambahan untuk perilaku khusus sumber. Misalnya, jika sumbernya Blob Storage, Anda dapat mengatur parameter untuk memfilter menurut ekstensi file, seperti:
"parameters" : { "configuration" : { "indexedFileNameExtensions" : ".pdf,.docx" } }
Jika sumber Azure SQL, Anda dapat mengatur parameter batas waktu kueri.
Pemetaan bidang digunakan untuk secara eksplisit memetakan bidang sumber-ke-tujuan jika ada perbedaan berdasarkan nama atau jenis antara bidang di sumber data dan bidang dalam indeks pencarian.
Secara default, pengindeks segera berjalan saat Anda membuatnya di search service. Jika Anda tidak ingin eksekusi pengindeks, atur disabled ke true saat membuat pengindeks.
Anda juga dapat menentukan jadwal atau mengatur kunci enkripsi untuk enkripsi tambahan definisi pengindeks.
Contoh pengindeks untuk pengindeksan berbasis keterampilan
Pengindeksan berbasis keterampilan menggunakan pengayaan AI untuk memproses konten yang tidak dapat dicari dalam bentuk mentahnya. Semua properti dan parameter sebelumnya berlaku, tetapi properti tambahan berikut khusus untuk pengayaan AI: skillsetName, , cacheoutputFieldMappings.
{
  "name": (required) String that uniquely identifies the indexer,
  "dataSourceName": (required) String, provides raw content that will be enriched,
  "targetIndexName": (required) String, name of an existing index,
  "skillsetName" : (required for AI enrichment) String, name of an existing skillset,
  "cache":  {
    "storageConnectionString" : (required if you enable the cache) Connection string to a blob container,
    "enableReprocessing": true
    },
  "parameters": { },
  "fieldMappings": (optional) Maps fields in the underlying data source to fields in an index,
  "outputFieldMappings" : (required) Maps skill outputs to fields in an index,
}
Pengayaan AI adalah area subjeknya sendiri dan berada di luar cakupan untuk artikel ini. Untuk informasi selengkapnya, mulailah dengan pengayaan AI, Kumpulan keterampilan di Pencarian Azure AI, Membuat kumpulan keterampilan, Memetakan bidang output yang diperkaya, dan Mengaktifkan cache untuk pengayaan AI (pratinjau).
Menyiapkan data eksternal
Pengindeks bekerja dengan himpunan data. Saat Anda menjalankan pengindeks, pengindeks terhubung ke sumber data Anda, mengambil data dari kontainer atau folder, secara opsional menserialisasikannya ke JSON, lalu meneruskannya ke mesin pencari untuk pengindeksan. Bagian ini menjelaskan persyaratan data masuk untuk pengindeksan berbasis teks.
| Data sumber | Tasks |
|---|---|
| Dokumen JSON | Dokumen JSON dapat berisi teks, angka, dan vektor. Pastikan struktur atau bentuk data masuk sesuai dengan skema indeks pencarian Anda. Sebagian besar indeks pencarian cukup datar, di mana kumpulan bidang terdiri dari bidang pada tingkat yang sama. Namun, struktur hierarkis atau berlapis dimungkinkan melalui bidang dan koleksi yang kompleks. |
| Relational | Berikan data sebagai kumpulan baris yang diratakan, di mana setiap baris menjadi dokumen pencarian penuh atau parsial dalam indeks. Untuk meratakan data relasional ke dalam kumpulan baris, buat tampilan SQL atau buat kueri yang mengembalikan rekaman induk dan turunan dalam baris yang sama. Misalnya, himpunan data sampel hotel bawaan adalah database SQL yang memiliki 50 rekaman (satu untuk setiap hotel), ditautkan ke rekaman kamar dalam tabel terkait. Kueri yang mengubah data kolektif ke dalam himpunan baris menyematkan semua informasi kamar dalam dokumen JSON di setiap catatan hotel. Informasi ruang yang disematkan dihasilkan oleh kueri yang menggunakan klausa FOR JSON AUTO . Anda dapat mempelajari lebih lanjut teknik ini dalam menentukan kueri yang menampilkan JSON yang disematkan. Ini hanyalah salah satu contoh; Anda dapat menggunakan pendekatan lain yang menghasilkan hasil yang sama. |
| Files | Pengindeks umumnya membuat satu dokumen pencarian untuk setiap file, di mana dokumen pencarian terdiri dari bidang untuk konten dan metadata. Bergantung pada jenis file, pengindeks kadang-kadang dapat parse satu file ke dalam beberapa dokumen pencarian. Misalnya, dalam file CSV, setiap baris dapat menjadi dokumen pencarian mandiri. |
Ingatlah bahwa Anda hanya perlu menyerap data yang dapat dicari dan dapat difilter:
- Data yang dapat dicari adalah teks atau vektor
- Data yang dapat difilter adalah teks dan angka (bidang non-vektor)
Pencarian Azure AI tidak dapat melakukan pencarian teks lengkap atas data biner dalam format apa pun, meskipun dapat mengekstrak dan menyimpulkan deskripsi teks file gambar (lihat pengayaan AI) untuk membuat konten yang dapat dicari. Demikian juga, teks besar dapat dipecah dan dianalisis oleh model bahasa alami untuk menemukan struktur atau informasi yang relevan, menghasilkan konten baru yang dapat Anda tambahkan ke dokumen pencarian. Ini juga dapat melakukan pencarian vektor atas penyematan, termasuk penyematan terkuantisasi dalam format biner.
Karena pengindeks tidak memperbaiki masalah kualitas data, Anda mungkin memerlukan langkah-langkah pembersihan atau transformasi data terpisah. Untuk informasi selengkapnya, lihat dokumentasi produk untuk produk database Azure Anda.
Menyiapkan sumber data
Pengindeks memerlukan sumber data yang menentukan jenis, kontainer, dan koneksi.
Pastikan Anda menggunakan jenis sumber data yang didukung.
Membuat definisi sumber data. Sumber data berikut adalah beberapa sumber yang lebih sering digunakan:
Jika sumber data adalah database, seperti Azure SQL atau Cosmos DB, aktifkan change tracking. Azure Storage memiliki change tracking bawaan melalui properti
LastModifiedpada setiap blob, file, dan tabel. Tautan-elemen berbagai sumber data menjelaskan metode pelacakan perubahan yang didukung oleh pengindeks.
Menyiapkan indeks
Pengindeks juga memerlukan indeks pencarian. Ingat bahwa pengindeks meneruskan data ke mesin pencari untuk pengindeksan. Sama seperti pengindeks memiliki properti yang menentukan perilaku eksekusi, skema indeks memiliki properti yang sangat memengaruhi bagaimana string diindeks (hanya bidang string yang dianalisis dan ditokenisasi).
Mulailah dengan Buat indeks pencarian.
Siapkan kumpulan bidang dan atribut bidang.
Bidang menjadi satu-satunya target untuk konten yang masuk. Bergantung pada atribut bidang dalam skema, setiap nilai bidang dianalisis, ditokenisasi, atau disimpan sebagai string verbatim untuk filter, pencarian fuzzy, dan kueri typeahead.
Pengindeks dapat secara otomatis memetakan bidang sumber ke bidang indeks target saat nama dan jenisnya setara. Jika bidang tidak dapat dipetakan secara implisit, ingatlah bahwa Anda dapat menentukan pemetaan bidang eksplisit yang memberi tahu pengindeks cara merutekan konten.
Tinjau penugasan penganalisis di setiap bidang. Penganalisis dapat mengubah string. Dengan demikian, string terindeks mungkin berbeda dari apa yang Anda masukkan. Anda dapat mengevaluasi efek penganalisis menggunakan Analyze Text (REST). Untuk informasi lebih lanjut penganalisis, lihat Penganalisis untuk pemrosesan teks.
Selama pengindeksan, pengindeks hanya memeriksa nama dan jenis bidang. Tidak ada langkah validasi yang memastikan konten masuk sudah benar untuk bidang pencarian terkait dalam indeks.
Membuat pengindeks
Saat Anda siap untuk membuat pengindeks di search service jarak jauh, Anda memerlukan klien pencarian. Klien pencarian dapat menjadi Azure portal, klien REST, atau kode aplikasi yang membuat instans klien pengindeks. Kami merekomendasikan AZURE PORTAL atau REST API untuk pengembangan awal dan pengujian bukti konsep.
Buka layanan pencarian Anda di portal Microsoft Azure.
Pilih dari opsi berikut:
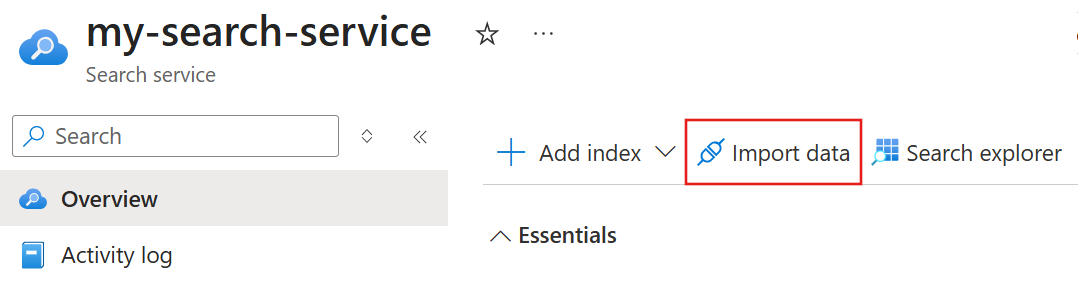
Impor data: Wizard ini membuat semua elemen yang diperlukan, termasuk pengindeks. Pendekatan lain memerlukan sumber data dan indeks yang telah ditentukan sebelumnya.
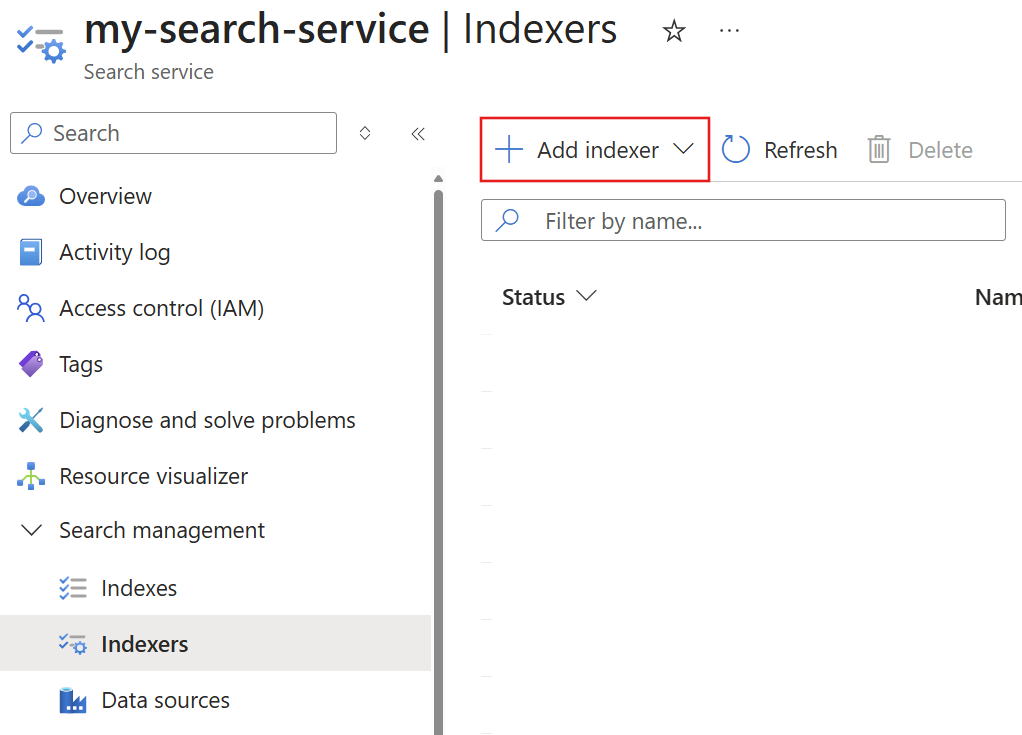
Tambahkan pengindeks: Editor visual untuk menentukan definisi pengindeks.
Jalankan pemberi indeks
Secara default, pengindeks segera berjalan saat Anda membuatnya di search service. Anda dapat mengambil alih perilaku ini dengan mengatur disabled ke true dalam definisi pengindeks. Eksekusi pengindeks adalah momen kebenaran di mana Anda mengetahui apakah ada masalah dengan koneksi, pemetaan lapangan, atau konstruksi set keterampilan.
Ada beberapa cara untuk menjalankan pengindeks:
Jalankan pada pembuatan atau pembaruan pengindeks (default).
Jalankan sesuai permintaan ketika tidak ada perubahan pada definisi, atau awali dengan reset untuk pengindeksan penuh. Untuk informasi selengkapnya, lihat Menjalankan atau mengatur ulang pengindeks.
Jadwalkan pemrosesan pengindeks untuk memanggil eksekusi secara berkala.
Eksekusi terjadwal biasanya diimplementasikan ketika Anda memiliki kebutuhan untuk pengindeksan bertahap sehingga Anda dapat mengambil perubahan terbaru. Dengan demikian, penjadwalan memiliki dependensi pada deteksi perubahan.
Pengindeks adalah salah satu dari beberapa subsistem yang melakukan panggilan keluar yang terbuka ke sumber daya Azure lainnya. Dalam peran Azure, pengindeks tidak memiliki identitas terpisah; koneksi dari mesin pencari ke sumber daya Azure lainnya dibuat menggunakan identitas terkelola yang ditetapkan sistem atau pengguna dari layanan pencarian. Jika pengindeks tersambung ke sumber daya Azure pada virtual network, Anda harus membuat shared private link untuk koneksi tersebut. Untuk informasi selengkapnya, lihat Akses aman ke data eksternal.
Memeriksa hasil
Pantau status pengindeks untuk memeriksa status eksekusi. Eksekusi yang berhasil masih dapat mencakup peringatan dan pemberitahuan. Pastikan untuk memeriksa pemberitahuan status yang berhasil dan yang gagal untuk detail tentang tugas tersebut.
Untuk verifikasi konten, jalankan kueri pada indeks yang diisi yang mengembalikan seluruh dokumen atau bidang yang dipilih.
Deteksi perubahan dan status internal
Jika sumber data Anda mendukung deteksi perubahan, pengindeks dapat mendeteksi perubahan yang mendasari data dan hanya memproses dokumen baru atau yang diperbarui pada setiap pengindeks yang dijalankan, meninggalkan konten yang tidak berubah apa adanya. Jika riwayat eksekusi pengindeks mengatakan bahwa eksekusi berhasil dengan dokumen 0/0 diproses, itu berarti bahwa pengindeks tidak menemukan baris atau blob baru atau yang diubah di sumber data yang mendasarinya.
Logika deteksi perubahan dibangun ke dalam platform data. Cara pengindeks mendukung deteksi perubahan bervariasi menurut sumber data:
Azure Storage memiliki deteksi perubahan bawaan, yang berarti pengindeks dapat mengenali dokumen baru dan yang diperbarui secara otomatis. Blob Storage, Penyimpanan Tabel Azure, dan Azure Data Lake Storage Gen2 mencap setiap pembaruan blob atau baris dengan tanggal dan waktu. Pengindeks secara otomatis menggunakan informasi ini untuk menentukan dokumen mana yang akan diperbarui dalam indeks. Untuk informasi selengkapnya tentang deteksi penghapusan, lihat Ubah dan hapus deteksi menggunakan pengindeks untuk Azure Storage.
Layanan database cloud menyediakan fitur deteksi perubahan opsional. Untuk sumber data ini, deteksi perubahan tidak otomatis. Anda perlu menentukan dalam definisi sumber data kebijakan mana yang digunakan:
Pengindeks melacak dokumen terakhir yang mereka proses dari sumber data melalui penanda pencapaian tertinggi internal. Penanda tidak pernah diekspos di API, tetapi pengindeks secara internal melacak di mana berhentinya. Saat mengindeks resume, baik melalui pengoperasian terjadwal atau pemanggilan sesuai permintaan, pengindeks mengacu pada tanda batas tertinggi agar dapat melanjutkan dari titik terakhir yang dicapai.
Jika Anda perlu menghapus batas level data untuk melakukan reindeksasi penuh, Anda dapat menggunakan Reset Indexer. Untuk pengindektan ulang yang lebih selektif, gunakan Reset Keterampilan atau Reset Dokumen. Melalui API pengaturan ulang, Anda dapat menghapus status internal dan juga membersihkan cache jika Anda mengaktifkan pengayaan bertambah bertahap. Untuk latar belakang dan perbandingan lainnya dari setiap opsi atur ulang, lihat Menjalankan atau mengatur ulang pengindeks, keterampilan, dan dokumen.