Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Catatan
Pencarian Azure AI tersedia melalui portal Azure, REST API, dan Azure SDK. Ini juga mendukung Foundry IQ, lapisan pengetahuan terkelola yang mengubah konten perusahaan menjadi pangkalan pengetahuan yang dapat digunakan kembali dan sadar izin untuk agen di portal Microsoft Foundry.
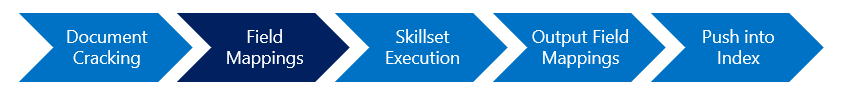
Artikel ini menjelaskan cara mengatur pemetaan bidang eksplisit yang menetapkan jalur data antara bidang sumber dalam sumber data yang didukung dan bidang target dalam indeks pencarian.
Kapan mengatur pemetaan bidang
Saat pengindeks Pencarian Azure AI memuat indeks pencarian, pengindeks menentukan jalur data menggunakan pemetaan bidang sumber ke tujuan. Pemetaan bidang implisit bersifat internal dan terjadi saat nama bidang dan jenis data kompatibel antara sumber dan tujuan. Jika input dan output tidak cocok, Anda dapat menentukan pemetaan bidang eksplisit untuk menyiapkan jalur data, seperti yang dijelaskan dalam artikel ini.
Pemetaan bidang juga dapat digunakan untuk konversi data ringan, seperti pengodean atau dekode, melalui fungsi pemetaan. Jika diperlukan lebih banyak pemrosesan, pertimbangkan Azure Data Factory untuk menjegal kesenjangan.
Pemetaan bidang berlaku untuk:
Struktur data fisik di kedua sisi jalur data. Struktur data logis yang dibuat oleh keterampilan hanya berada dalam memori. Gunakan outputFieldMappings untuk memetakan simpul dalam memori ke bidang output dalam indeks pencarian.
Indeks Pencarian AI induk saja. Untuk indeks "sekunder" dengan dokumen "turunan" atau "gugus", lihat skenario pemetaan bidang tingkat lanjut.
Bidang pencarian tingkat atas saja, di mana
targetFieldNameadalah bidang sederhana atau koleksi. Bidang target tidak boleh berupa jenis kompleks.
Skenario yang didukung
Pastikan Anda menggunakan sumber data yang didukung untuk pengindeksan yang digerakkan oleh pengindeks.
| Kasus penggunaan | Deskripsi |
|---|---|
| Perbedaan nama | Misalkan sumber data Anda memiliki bidang bernama _city. Mengingat bahwa Pencarian Azure AI tidak mengizinkan nama bidang yang dimulai dengan garis bawah, pemetaan bidang memungkinkan Anda memetakan "_city" secara efektif ke "kota". Jika persyaratan pengindeksan Anda termasuk mengambil konten dari beberapa sumber data, di mana nama bidang bervariasi di antara sumber, Anda dapat menggunakan pemetaan bidang untuk mengklarifikasi jalur. |
| Perbedaan jenis | Misalkan Anda ingin bidang bilangan bulat sumber berjenis Edm.String sehingga dapat dicari di indeks pencarian. Karena jenisnya berbeda, Anda perlu menentukan pemetaan bidang agar jalur data berhasil. Perhatikan bahwa Pencarian Azure AI memiliki sekumpulan jenis data yang didukung yang lebih kecil daripada banyak sumber data. Jika Anda mengimpor data SQL, pemetaan bidang memungkinkan Anda memetakan jenis data SQL yang Anda inginkan dalam indeks pencarian. |
| Jalur data satu ke banyak | Anda dapat mengisi beberapa bidang dalam indeks dengan konten dari bidang sumber yang sama. Misalnya, Anda mungkin ingin menerapkan penganalisis yang berbeda ke setiap bidang untuk mendukung kasus penggunaan yang berbeda di aplikasi klien Anda. |
| Pengodean dan pendekodean | Anda dapat menerapkan fungsi pemetaan untuk mendukung pengodean Base64 atau decoding data selama pengindeksan. |
| Memisahkan string atau menyusun ulang array menjadi koleksi | Anda dapat menerapkan fungsi pemetaan untuk membagi string yang menyertakan pemisah, atau untuk mengirim array JSON ke bidang pencarian jenis Collection(Edm.String). |
Catatan
Jika tidak ada pemetaan bidang, pengindeks mengasumsikan bidang sumber data harus dipetakan ke bidang indeks dengan nama yang sama. Menambahkan pemetaan bidang menggantikan pemetaan bidang default untuk bidang sumber dan target. Beberapa pengindeks, seperti pengindeks penyimpanan blob, menambahkan pemetaan bidang default untuk bidang kunci indeks secara otomatis.
Bidang kompleks tidak didukung dalam pemetaan bidang. Struktur sumber Anda (struktur berlapis atau hierarkis) harus sama persis dengan jenis kompleks dalam indeks sehingga pemetaan default berfungsi. Untuk informasi selengkapnya, lihat Tutorial: Mengindeks blob JSON berlapis misalnya. Jika Anda mendapatkan kesalahan yang mirip dengan "Field mapping specifies target field 'Address/city' that doesn't exist in the index", itu karena pemetaan bidang target tidak dapat berupa tipe kompleks.
Secara opsional, Anda mungkin hanya ingin beberapa simpul dalam struktur kompleks. Untuk mendapatkan simpul individual, Anda dapat meratakan data masuk ke dalam koleksi string (lihat outputFieldMappings untuk solusi ini).
Menentukan pemetaan bidang
Bagian ini menjelaskan langkah-langkah untuk menyiapkan pemetaan bidang.
Gunakan Buat Pengindeks atau Buat atau Perbarui Pengindeks atau metode yang setara dalam Azure SDK. Berikut adalah contoh definisi pengindeks.
{
   "name": "myindexer",
   "description": null,
   "dataSourceName": "mydatasource",
   "targetIndexName": "myindex",
   "schedule": { },
   "parameters": { },
   "fieldMappings": [],
   "disabled": false,
   "encryptionKey": { }
 }
Isi
fieldMappingsarray untuk melengkapi dan menentukan pemetaan. Pemetaan bidang terdiri dari tiga bagian."fieldMappings": [ { "sourceFieldName": "_city", "targetFieldName": "city", "mappingFunction": null } ]Properti Deskripsi sourceFieldName Diperlukan. Mewakili bidang di sumber data Anda. targetFieldName Opsional. Mewakili bidang dalam indeks pencarian Anda. Jika dihilangkan, nilai sourceFieldNamediasumsikan untuk target. Bidang target harus berupa bidang sederhana atau kumpulan tingkat atas. Ini tidak bisa menjadi jenis atau koleksi yang kompleks. Jika Anda menangani masalah jenis data, jenis data bidang ditentukan dalam definisi indeks. Pemetaan bidang hanya perlu memiliki nama bidang.fungsi pemetaan Opsional. Terdiri dari fungsi yang telah ditentukan sebelumnya yang mengubah data.
Contoh: Perbedaan nama atau jenis
Pemetaan bidang eksplisit menetapkan jalur data untuk kasus di mana nama dan jenis tidak identik.
Pencarian Azure AI menggunakan perbandingan yang tidak peka huruf besar/kecil untuk menyelesaikan nama bidang dan fungsi dalam pemetaan bidang. Ini nyaman (Anda tidak perlu mendapatkan semua casing dengan benar), tetapi itu berarti bahwa sumber data atau indeks Anda tidak dapat memiliki bidang yang berbeda hanya menurut kasus.
PUT https://[service name].search.windows.net/indexers/myindexer?api-version=[api-version]
Content-Type: application/json
api-key: [admin key]
{
    "dataSourceName" : "mydatasource",
    "targetIndexName" : "myindex",
    "fieldMappings" : [ { "sourceFieldName" : "_city", "targetFieldName" : "city" } ]
}
Contoh: Jalur data satu-ke-banyak atau cabang
Contoh ini memetakan satu bidang sumber ke beberapa bidang target (pemetaan "satu-ke-banyak"). Anda dapat melakukan "fork" pada bidang, menyalin konten bidang sumber yang sama ke dua bidang indeks yang berbeda yang akan dianalisis atau diatribusi dengan cara yang berbeda dalam indeks.
"fieldMappings" : [
    { "sourceFieldName" : "text", "targetFieldName" : "textStandardEnglishAnalyzer" },
    { "sourceFieldName" : "text", "targetFieldName" : "textSoundexAnalyzer" }
]
Anda dapat menggunakan pendekatan serupa untuk konten yang dihasilkan keterampilan.
Fungsi dan contoh pemetaan
Fungsi pemetaan bidang mengubah konten bidang sebelum disimpan dalam indeks. Fungsi pemetaan berikut saat ini didukung:
- base64Encode
- base64Decode
- extractTokenAtPosition
- fixedLengthEncode
- jsonArrayToStringCollection
- toJson
- urlEncode
- urlDecode
Perhatikan bahwa fungsi-fungsi ini didukung secara eksklusif untuk indeks induk saat ini. Mereka tidak kompatibel dengan pemetaan indeks yang dipotong, oleh karena itu, fungsi-fungsi ini tidak dapat digunakan untuk proyeksi indeks.
fungsi base64Encode
Melakukan pengodean Base64 yang aman untuk URL dari string input. Mengasumsikan bahwa input dikodekan UTF-8.
Contoh: Pengodean dasar kunci dokumen
Hanya karakter aman URL yang dapat muncul di kunci dokumen Pencarian Azure AI (sehingga Anda dapat mengakses dokumen menggunakan Lookup API). Jika bidang sumber untuk kunci Anda berisi karakter URL-tidak aman, seperti - dan \, gunakan base64Encode fungsi untuk mengonversinya pada waktu pengindeksan.
Contoh berikut ini menentukan fungsi base64Encode pada metadata_storage_name untuk menangani karakter yang tidak didukung.
PUT /indexers?api-version=2026-04-01
{
  "dataSourceName" : "my-blob-datasource ",
  "targetIndexName" : "my-search-index",
  "fieldMappings" : [
    {
        "sourceFieldName" : "metadata_storage_name",
        "targetFieldName" : "key",
        "mappingFunction" : {
            "name" : "base64Encode",
            "parameters" : { "useHttpServerUtilityUrlTokenEncode" : false }
        }
    }
  ]
}
Kunci dokumen (sebelum dan sesudah konversi) tidak boleh lebih dari 1.024 karakter. Saat Anda mengambil kunci yang dikodekan pada waktu pencarian, gunakan base64Decode fungsi untuk mendapatkan nilai kunci asli, dan gunakan itu untuk mengambil dokumen sumber.
Contoh: Membuat bidang yang dikodekan dasar "dapat dicari"
Ada kalanya Anda perlu menggunakan versi yang dikodekan dari bidang seperti metadata_storage_path sebagai kunci, namun juga membutuhkan versi yang tidak dikodekan untuk pencarian teks lengkap. Untuk mendukung kedua skenario, Anda dapat memetakan metadata_storage_path ke dua bidang: satu untuk kunci (dikodekan), dan yang kedua untuk bidang jalur yang dapat kita asumsikan dikaitkan seperti searchable dalam skema indeks.
PUT /indexers/blob-indexer?api-version=2026-04-01
{
    "dataSourceName" : " blob-datasource ",
    "targetIndexName" : "my-target-index",
    "schedule" : { "interval" : "PT2H" },
    "fieldMappings" : [
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "key", "mappingFunction" : { "name" : "base64Encode" } },
        { "sourceFieldName" : "metadata_storage_path", "targetFieldName" : "path" }
      ]
}
Contoh - mempertahankan nilai asli
Pengindeks penyimpanan blob secara otomatis menambahkan pemetaan bidang dari metadata_storage_path, URI blob, ke bidang kunci indeks jika tidak ada pemetaan bidang yang ditentukan. Nilai ini dikodekan Base64 sehingga aman digunakan sebagai kunci dokumen Pencarian Azure AI. Contoh berikut menunjukkan cara memetakan versi Base64 yang dikodekan URL-safe secara bersamaan ke bidang metadata_storage_path dan mempertahankan nilai asli dalam bidang index_key.
"fieldMappings": [
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "metadata_storage_path"
  },
  {
    "sourceFieldName": "metadata_storage_path",
    "targetFieldName": "index_key",
    "mappingFunction": {
       "name": "base64Encode"
    }
  }
]
Jika Anda tidak menyertakan properti parameter untuk fungsi pemetaan Anda, itu default ke nilai {"useHttpServerUtilityUrlTokenEncode" : true}.
Pencarian Azure AI mendukung dua pengodean Base64 yang berbeda. Anda harus menggunakan parameter yang sama saat mengodekan dan mendekode bidang yang sama. Untuk informasi selengkapnya, lihat opsi pengodean base64 untuk memutuskan parameter mana yang akan digunakan.
fungsi base64Decode
Melakukan decoding Base64 dari string masukan. Input diasumsikan sebagai string yang dikodekan Base64 url-safe .
Contoh - dekode metadata blob atau URL
Data sumber Anda mungkin berisi string yang dikodekan Base64, seperti string metadata blob atau URL web, yang ingin Anda cari sebagai teks biasa. Anda dapat menggunakan base64Decode fungsi untuk mengubah data yang dikodekan kembali menjadi string reguler saat mengisi indeks pencarian Anda.
"fieldMappings" : [
  {
    "sourceFieldName" : "Base64EncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "base64Decode",
      "parameters" : { "useHttpServerUtilityUrlTokenDecode" : false }
    }
  }
]
Jika Anda tidak menyertakan properti parameter, properti tersebut default ke nilai {"useHttpServerUtilityUrlTokenEncode" : true}.
Pencarian Azure AI mendukung dua pengodean Base64 yang berbeda. Anda harus menggunakan parameter yang sama saat mengodekan dan mendekode bidang yang sama. Untuk informasi selengkapnya, lihat opsi pengodean base64 untuk memutuskan parameter mana yang akan digunakan.
opsi pengkodean base64
Pencarian Azure AI mendukung pengodean base64 yang aman URL dan pengodean base64 normal. String yang dikodekan base64 selama pengindeksan harus didekode nanti dengan opsi pengodean yang sama, atau jika tidak, hasilnya tidak akan cocok dengan yang asli.
useHttpServerUtilityUrlTokenEncode Jika parameter atau useHttpServerUtilityUrlTokenDecode untuk pengodean dan dekode masing-masing diatur ke true, maka base64Encode berperilaku seperti HttpServerUtility.UrlTokenEncode dan base64Decode berperilaku seperti HttpServerUtility.UrlTokenDecode.
Peringatan
Jika base64Encode digunakan untuk menghasilkan nilai kunci, useHttpServerUtilityUrlTokenEncode harus diatur ke true. Hanya pengodean base64 yang aman URL yang dapat digunakan untuk nilai kunci. Lihat Aturan penamaan untuk serangkaian pembatasan lengkap pada karakter dalam nilai kunci.
Pustaka .NET di Pencarian Azure AI mengasumsikan kerangka kerja .NET lengkap, yang menyediakan pengodean bawaan. Opsi useHttpServerUtilityUrlTokenEncode dan useHttpServerUtilityUrlTokenDecode menerapkan fungsionalitas bawaan ini. Jika Anda menggunakan .NET Core atau kerangka kerja lain, sebaiknya atur opsi tersebut ke false dan memanggil fungsi pengodean dan dekode kerangka kerja Anda secara langsung.
Tabel berikut membandingkan pengodean base64 yang berbeda dari string 00>00?00. Untuk menentukan pemrosesan yang diperlukan (jika ada) untuk fungsi base64 Anda, terapkan fungsi enkode pustaka Anda pada string 00>00?00 dan bandingkan output dengan output MDA-MDA_MDAyang diharapkan .
| Encoding | Output enkode Base64 | Pemrosesan tambahan setelah penyandian pustaka | Pemrosesan ekstra sebelum dekode pustaka |
|---|---|---|---|
| Base64 dengan padding | MDA+MDA/MDA= |
Gunakan karakter URL aman dan hapus padding | Gunakan karakter base64 standar dan tambahkan padding |
| Base64 tanpa padding | MDA+MDA/MDA |
Gunakan karakter url-aman | Menggunakan karakter base64 standar |
| Base64 url aman dengan padding | MDA-MDA_MDA= |
Menghapus padding | Menambahkan padding |
| Base64 URL-safe tanpa padding | MDA-MDA_MDA |
Tidak | Tidak |
fungsi extractTokenAtPosition
Memisahkan bidang string menggunakan pemisah yang ditentukan, dan memilih token pada posisi yang ditentukan dalam pemisahan yang dihasilkan.
Fungsi ini menggunakan parameter berikut:
-
delimiter: string untuk digunakan sebagai pemisah saat memisahkan string input. -
position: posisi berbasis nol dari token bilangan bulat untuk dipilih setelah string input dipecah.
Misalnya, jika input adalah Jane Doe, delimiter adalah " "(spasi) dan position adalah 0, hasilnya adalah Jane; jika position adalah 1, hasilnya adalah Doe. Jika posisi mengacu pada token yang tidak ada, kesalahan akan ditampilkan.
Contoh - mengekstrak nama
Sumber data Anda berisi PersonName bidang, dan Anda ingin mengindeksnya sebagai dua bidang terpisah FirstName dan LastName. Anda dapat menggunakan fungsi ini untuk membagi input menggunakan karakter spasi sebagai pemisah.
"fieldMappings" : [
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "FirstName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 0 } }
  },
  {
    "sourceFieldName" : "PersonName",
    "targetFieldName" : "LastName",
    "mappingFunction" : { "name" : "extractTokenAtPosition", "parameters" : { "delimiter" : " ", "position" : 1 } }
  }]
fungsi jsonArrayToStringCollection
Mengubah string yang diformat sebagai array string JSON menjadi array string yang dapat digunakan untuk mengisi Collection(Edm.String) bidang dalam indeks.
Misalnya, jika string input adalah ["red", "white", "blue"], maka bidang target jenis Collection(Edm.String) akan diisi dengan tiga nilai red, , whitedan blue. Untuk nilai input yang tidak dapat diurai sebagai array string JSON, kesalahan dikembalikan.
Contoh - mengisi koleksi dari data relasional
Azure SQL Database tidak memiliki tipe data bawaan yang secara alami memetakan ke bidang Collection(Edm.String) di Pencarian Azure AI. Untuk mengisi bidang kumpulan string, Anda dapat melakukan praproses data sumber Anda sebagai array string JSON lalu menggunakan jsonArrayToStringCollection fungsi pemetaan.
"fieldMappings" : [
  {
    "sourceFieldName" : "tags",
    "mappingFunction" : { "name" : "jsonArrayToStringCollection" }
  }]
fungsi urlEncode
Fungsi ini dapat digunakan untuk mengodekan string sehingga "URL aman". Saat digunakan dengan string yang berisi karakter yang tidak diizinkan dalam URL, fungsi ini akan mengonversi karakter "tidak aman" tersebut menjadi karakter-entitas yang setara. Fungsi ini menggunakan format pengodean UTF-8.
Contoh - pencarian kunci dokumen
urlEncode fungsi dapat digunakan sebagai alternatif untuk base64Encode fungsi, jika hanya karakter URL yang tidak aman yang akan dikonversi, sambil menyimpan karakter lain as-is.
Katakanlah, string input adalah <hello> - maka bidang target jenis (Edm.String) akan diisi dengan nilai %3chello%3e
Saat Anda mengambil kunci yang dikodekan pada waktu pencarian, Anda kemudian dapat menggunakan urlDecode fungsi untuk mendapatkan nilai kunci asli, dan menggunakannya untuk mengambil dokumen sumber.
"fieldMappings" : [
  {
    "sourceFieldName" : "SourceKey",
    "targetFieldName" : "IndexKey",
    "mappingFunction" : {
      "name" : "urlEncode"
    }
  }
]
fungsi urlDecode
Fungsi ini mengonversi string yang dikodekan URL menjadi string yang didekodekan menggunakan format pengodean UTF-8.
Contoh - memecahkan kode metadata blob
Beberapa klien penyimpanan Azure secara otomatis mengodekan URL metadata blob jika berisi karakter non-ASCII. Namun, jika Anda ingin membuat metadata tersebut dapat dicari (sebagai teks biasa), Anda dapat menggunakan urlDecode fungsi untuk mengubah data yang dikodekan kembali menjadi string reguler saat mengisi indeks pencarian Anda.
"fieldMappings" : [
  {
    "sourceFieldName" : "UrlEncodedMetadata",
    "targetFieldName" : "SearchableMetadata",
    "mappingFunction" : {
      "name" : "urlDecode"
    }
  }
]
fungsi fixedLengthEncode
Fungsi ini mengonversi string dengan panjang apa pun menjadi string panjang tetap.
Contoh - memetakan kunci dokumen yang terlalu panjang
Ketika terjadi kesalahan yang terkait dengan panjang kunci dokumen yang melebihi 1024 karakter, fungsi ini dapat diterapkan untuk mengurangi panjang kunci dokumen.
"fieldMappings" : [
 {
   "sourceFieldName" : "metadata_storage_path",
   "targetFieldName" : "your key field",
   "mappingFunction" : {
     "name" : "fixedLengthEncode"
   }
 }
]
fungsi toJson
Fungsi ini mengonversi string menjadi objek JSON yang diformat. Ini dapat digunakan untuk skenario di mana sumber data, seperti Azure SQL, tidak secara asli mendukung jenis data senyawa atau hierarkis, lalu memetakannya ke bidang kompleks.
Contoh - memetakan konten teks ke bidang kompleks
Asumsikan ada baris SQL dengan string JSON yang perlu dipetakan ke bidang kompleks (yang ditentukan secara sesuai) dalam indeks, toJson fungsi dapat digunakan untuk mencapai ini. Misalnya, jika bidang kompleks dalam indeks perlu diisi dengan data berikut:
{
    "id": "5",
    "info": {
        "name": "Jane",
        "surname": "Smith",
        "skills": [
            "SQL",
            "C#",
            "Azure"
        ],
        "dob": "2005-11-04T12:00:00"
    }
}
Ini dapat dicapai dengan menggunakan fungsi pemetaan toJson pada kolom string JSON di baris SQL yang terlihat seperti ini: {"id": 5, "info": {"name": "Jane", "surname": "Smith", "skills": ["SQL", "C#", "Azure"]}, "dob": "2005-11-04T12:00:00"}.
Pemetaan bidang perlu ditentukan seperti yang ditunjukkan di bawah ini.
"fieldMappings" : [
  {
    "sourceFieldName" : "content",
    "targetFieldName" : "complexField",
    "mappingFunction" : {
      "name" : "toJson"
    }
  }
]
Skenario pemetaan bidang tingkat lanjut
Dalam skenario di mana Anda memiliki hubungan dokumen "satu-ke-banyak", seperti pemotongan (chunking) atau pemisahan (splitting) data, ikuti panduan ini untuk memetakan bidang dari dokumen induk ke dokumen "anak" (potongan):
1. Melewatkan pengindeksan dokumen induk
Jika Anda melewatkan pengindeksan dokumen induk (dengan mengatur projectionMode ke skipIndexingParentDocuments dalam kumpulan keterampilan indexProjections), gunakan proyeksi indeks untuk memetakan bidang dari dokumen induk ke dokumen "turunan".
2. Mengindeks dokumen induk dan "anak"
Jika Anda mengindeks dokumen induk dan dokumen "turunan":
- Gunakan pemetaan bidang untuk memetakan bidang ke dokumen induk.
- Gunakan proyeksi indeks untuk memetakan field ke dokumen turunan.
3. Memetakan nilai yang telah diubah melalui fungsi ke dokumen induk dan/atau dokumen "anak"
Jika bidang dalam dokumen induk memerlukan transformasi (menggunakan fungsi pemetaan seperti pengodean) dan perlu dipetakan ke dokumen induk dan/atau dokumen turunan:
- Terapkan transformasi menggunakan fungsi pemetaan bidang di pengindeks.
- Gunakan proyeksi indeks dalam skillset untuk memetakan bidang yang telah diubah ke dokumen "anak".