Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Fontos
Az (előzetes verzióban) megjelölt funkciókra, képességekre vagy tulajdonságokra nem vonatkozik szolgáltatási szintű szerződés, nem ajánlott éles számítási feladatokhoz, és az általános elérhetővé válásuk előtt változhatnak vagy korlátozhatók. Az Azure AI Keresés előzetes verziójú kifejezések az összes előzetes verziós funkcióra vonatkoznak, függetlenül attól, hogy önálló vagy egy általánosan elérhető funkció része.
A Azure AI Keresés egy szűrőkifejezés használatával adhat hozzá belefoglalási vagy kizárási feltételeket egy vector-lekérdezéshez. Megadhatja a szűrőt alkalmazó szűrési módot is:
- A lekérdezés végrehajtása előtt, más néven előszűrés.
- A lekérdezés végrehajtása után, más néven postfiltering.
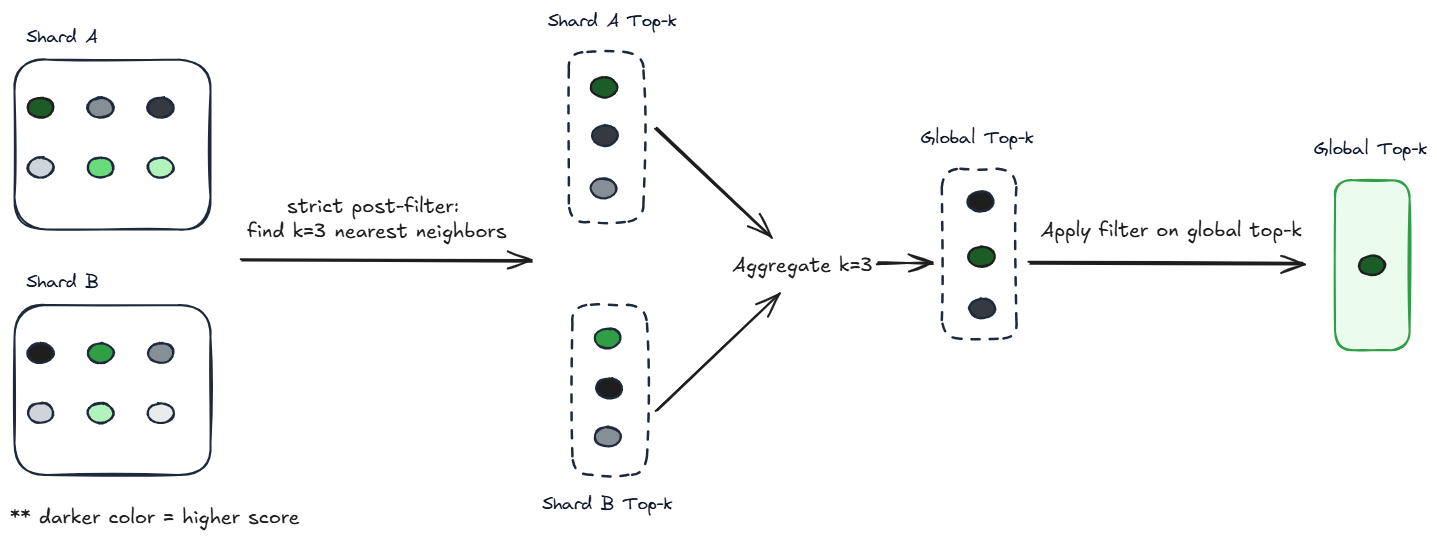
- A globális top-eredmények azonosítása után, amit előzetes verzióban szigorú szűrés utáni feldolgozás néven ismerünk.
Ez a cikk REST-et használ az ábrához. A vektoros lekérdezéseket tartalmazó más nyelvű kódmintákat és végpontok közötti megoldásokat a azure-search-vector-samples GitHub adattárban találja.
A Search Explorer is használható a Azure portálon a vektortartalom lekérdezéséhez. JSON-nézetben szűrőket adhat hozzá, és megadhatja a szűrési módot.
A szűrés működése vektoros lekérdezésekben
Azure AI Keresés a Hierarchical Navigable Small World (HNSW) algoritmust használja a közelítő szomszéd (ANN) kereséshez, és több szegmensben tárolja a HNSW-gráfokat. Minden szegmens a teljes index egy részét tartalmazza.
A szűrők szöveges vagy numerikus mezőkre filterableérvényesek, és a keresési dokumentumokat a szűrési feltételek alapján beillesztik vagy kizárják. Maguk a vektormezők nem szűrhetők, de az index más mezőinek szűrőivel szűkítheti a vektorkereséshez szükséges dokumentumokat. Ha az indexek nem rendelkeznek megfelelő szöveg- vagy numerikus mezőkkel, ellenőrizze, hogy vannak-e olyan dokumentum metaadatok, amelyek segíthetnek a szűrésben, például LastModified vagy CreatedBy tulajdonságok.
A vectorFilterMode paraméter szabályozza, hogy a keresési szakaszokban hol alkalmazzák a szűrőműveleteket, ami befolyásolja, hogy az eredmények hogyan szűrhetők az elemek egy részhalmazára (például kategória, címke vagy egyéb attribútumok szerint), és befolyásolja a késést, a visszahívást és az átviteli sebességet. Három mód van:
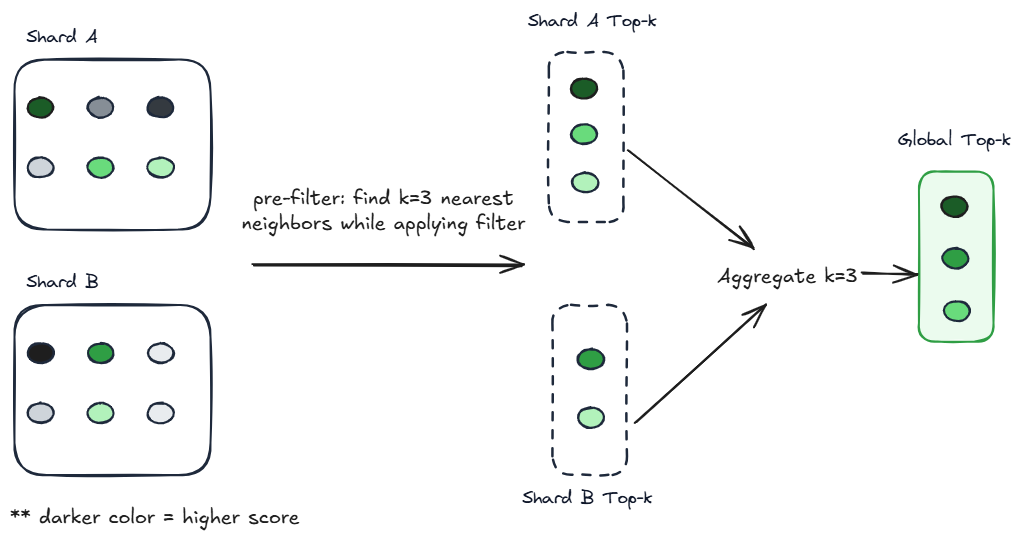
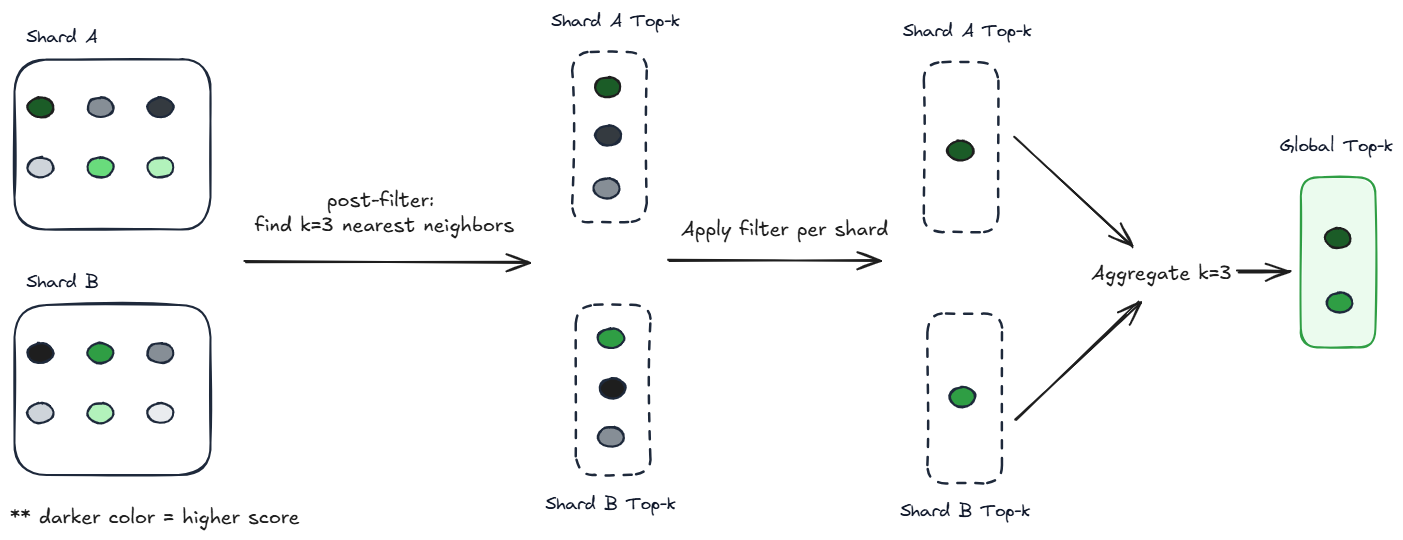
preFiltera szűrőt a HNSW-bejárás során alkalmazza az egyes shardokon. Ez a mód maximalizálja a visszahívást, de több gráfot is át tud haladni, ami növeli a processzort és a késést a nagy mértékben szelektív szűrők esetében.postFilterHNSW-bejárást és szűrést futtat az egyes szegmenseken egymástól függetlenül, a szegmens szintjén metszi az eredményeket, majd összesíti az egyes szegmensek tetejétkegy globális felső szintrek. Ez a mód hamis negatívumokat hozhat létre a nagymértékben szelektív szűrőkhöz vagy kiskértékekhez.strictPostFilter(előzetes verzió) megkeresi a szűretlen globális csúcsot, mielőtt alkalmazná a szűrőtk. Ebben a módban a legnagyobb a kockázata annak, hogy hamis negatív értékeket ad vissza a szigorúan szelektív szűrők és a kiskértékek esetében.
Ezekről a módokról további információt a Szűrő mód beállítása című témakörben talál.
Szűrő definiálása
A szűrők határozzák meg a vektoros lekérdezések hatókörét, és a Dokumentumok – Keresési bejegyzés (REST API) használatával vannak definiálva. Ha nem szeretne előzetes verziójú funkciót használni, használja a Search Service REST API-k legújabb stabil verzióját a kérés megfogalmazásához.
Ez a REST API a következőket biztosítja:
-
filterkritériumokhoz. -
vectorFilterModeannak megadásához, hogy a szűrő mikor legyen alkalmazva a vektoros lekérdezés során. A támogatott módokról a Szűrő mód beállítása című témakörben olvashat.
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
Ebben a példában a vektorbeágyazás a contentVector mezőt célozza meg, a szűrési feltételek pedig egy szűrhető szövegmezőre categoryvonatkoznak. Mivel a preFilter mód használatban van, a szűrőt a keresőmotor a lekérdezés futtatása előtt alkalmazza, így a vektorkeresés során csak a Databases kategória dokumentumait veszi figyelembe a rendszer.
A szűrési mód beállítása
A vectorFilterMode paraméter határozza meg, hogy a szűrő mikor és hogyan legyen alkalmazva a vektoros lekérdezés végrehajtásához képest. A következő módok használhatók:
-
preFilter(ajánlott) postFilter-
strictPostFilter(előzetes verzió)
Megjegyzés
preFilter a 2023. október 15. után létrehozott indexek alapértelmezett értéke. Az ezen dátum postFilter előtt létrehozott indexek esetében ez az alapértelmezett érték. A preFilter és más speciális vektorfunkciók, például a vektortömörítés használatához újból létre kell hoznia az indexet.
A kompatibilitás teszteléséhez küldjön vektoros lekérdezést a "vectorFilterMode": "preFilter" REST API-verzióval vagy újabb verzióval2023-10-01-preview. Ha a lekérdezés sikertelen, az index nem támogatja preFilter.
Az előszűrés szűrőket alkalmaz a lekérdezés végrehajtása előtt, ami csökkenti a vektorkeresési algoritmushoz beállított jelöltkészletet. Ezután a rendszer kiválasztja a felsők találatokat ebből a szűrt készletből.
Vektoros lekérdezésben az alapértelmezett mód a(z) preFilter, mert a visszahívást és a minőséget a késleltetéssel szemben részesíti előnyben.
Ez a mód hogyan működik
Minden szegmensen alkalmazza a szűrő predikátumot a HNSW bejárása során, és bővítse a gráfot, amíg meg nem találja a jelölteket
k.Hozza létre az előre szűrt helyi top-
keredményeket részletenként.A szűrt eredmények összesítése globális felső
keredményhalmazba.
A mód hatása
A bejárás kibővíti a keresési teret, hogy több szűrt jelöltet találjon, különösen akkor, ha a szűrő nagyon szelektív. Ez az összes szegmensben a leginkább hasonló csúcseredményeketk hozza létre. Minden szegmens azonosítja a k szűrő predikátumának megfelelő eredményeket.
Az előszűrés garantálja, hogy k az eredmények akkor lesznek visszaadva, ha az indexben léteznek. A nagymértékben szelektív szűrők esetében ez a gráf jelentős részét átjárhatja, ami növeli a számítási költségeket és a késést, miközben csökkenti az átviteli sebességet. Ha a szűrő nagyon szelektív (nagyon kevés egyezéssel rendelkezik), fontolja meg exhaustive: true a teljes keresés elvégzését.
Összehasonlító táblázat
| Mód | Visszahívás (szűrt eredmények) | Számítási költség | Hamis negatívok kockázata | Mikor érdemes használni? |
|---|---|---|---|---|
preFilter |
Nagyon magas | Magasabb (a szűrő szelektivitásával és összetettségével együtt nő) | Nincs kockázat |
Minden forgatókönyv esetében ajánlott az alapértelmezett beállítás, különösen akkor, ha a visszahívás kritikus (bizalmas keresési tartományok), szelektív szűrők használata vagy kis kméretűek használata esetén. |
postFilter |
Közepes és magas (szűrési szelektivitással csökken) | Hasonló a szűretlenhöz, de a szűrő összetettségével növekszik | Közepes (kihagyhatja a találatokat szegmensenként) | Lehetőség olyan szűrőkre, amelyek nem túl szelektívek és magasabbk szintű lekérdezésekhez. |
strictPostFilter |
Legalacsonyabb (a szűrési szelektivitással a leggyorsabban csökken) | Hasonló a szűretlenhöz | Legmagasabb (válogatott szűrők vagy kis értékek k esetén nulla eredményeket adhat vissza) |
Olyan arculati keresési alkalmazásokhoz használható lehetőség, ahol a szűrőalkalmazás után több találatot érhet el, ami nagyobb hatással van a felhasználói élményre, mint a hamis negatív értékek kockázata. Ne használja kis méretű k-tal. |
Az előszűrés és a postfilterezés benchmark-tesztelése
Fontos
Ez a szakasz az előszűrésre és a postfilterezésre vonatkozik, nem pedig a szigorú utólagos szűrésre.
Annak érdekében, hogy megértsük azokat a feltételeket, amelyek mellett az egyik szűrőmód a másiknál jobban teljesít, tesztsorozatot futtattunk a lekérdezési eredmények kiértékelésére kis, közepes és nagy indexeken.
- Kicsi (100 000 dokumentum, 2,5 GB-os index, 1536 dimenzió)
- Közepes (1 millió dokumentum, 25 GB-os index, 1536 dimenzió)
- Nagy (1 milliárd dokumentum, 1,9 TB index, 96 dimenzió)
A kis és közepes számítási feladatokhoz egy Standard 2 (S2) szolgáltatást használtunk egy partícióval és egy replikával. A nagy számítási feladatokhoz egy Standard 3 (S3) szolgáltatást használtunk 12 partícióval és egy replikával.
Az indexek felépítése azonos volt: egy kulcsmező, egy vektormező, egy szövegmező és egy numerikus szűrhető mező. Az alábbi index a 2023-11-01 szintaxis használatával van definiálva.
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
A lekérdezésekben azonos szűrőt használtunk az előszűrő és a postfilter műveletekhez is. Egy egyszerű szűrőt használtunk annak biztosítására, hogy a teljesítménybeli eltérések a szűrési módnak, nem pedig a szűrés összetettségének köszönhetők.
Az eredményeket másodpercenkénti lekérdezésekben (QPS) mérték.
Tanulságok
Az előszűrés szinte mindig lassabb, mint a postfilterezés, kivéve a kis indexeket, ahol a teljesítmény körülbelül egyenlő.
Nagyobb adathalmazok esetén az előszűrés nagyságrendekkel lassabb.
Miért az előszűrő az alapértelmezett, ha majdnem mindig lassabb? Az előszűrés garantálja, hogy
kaz eredmények akkor kerülnek visszaadásra, ha az indexben vannak, ahol az előny a visszakeresést és a pontosságot részesíti előnyben a sebességgel szemben.Használjon utószűrést, ha:
A sebességet részesítse előnyben a kiválasztással szemben (az utószűrés kevesebb mint
keredményt adhat vissza).Olyan szűrőket használjon, amelyek nem túl szelektívek.
Elegendő méretű indexeket kell használnia, hogy az előszűrési teljesítmény elfogadhatatlan legyen.
Részletek
Egy 100 000 vektort tartalmazó adathalmaz 1536 dimenzióban:
Az adathalmaz több mint 30% szűrésekor az előszűrés és a postfilterezés összehasonlítható volt.
Az adathalmaz 0,1-nél kisebb% szűréskor az előszűrés körülbelül 50% lassabb volt, mint a postfilterelés.
Egy 1 millió vektort tartalmazó adathalmaz 1536 dimenzióban:
Az adathalmaz több mint 30% szűrésekor az előszűrés körülbelül 30% lassabb volt.
Az adathalmaz kevesebb mint 2% szűrése esetén az előszűrés körülbelül hétszer lassabb volt.
Egy 1 milliárd vektort tartalmazó adathalmaz 96 dimenzióban:
Az adathalmaz több mint 5% szűrésekor az előszűrés körülbelül 50% lassabb volt.
Az adathalmaz kevesebb mint 10% szűrése esetén az előszűrés körülbelül hétszer lassabb volt.
Az alábbi grafikon az előszűrő relatív QPS-ét mutatja be, amelyet úgy számítanak ki, hogy az előszűrő QPS-t elosztják a szűrő utáni QPS-szel.
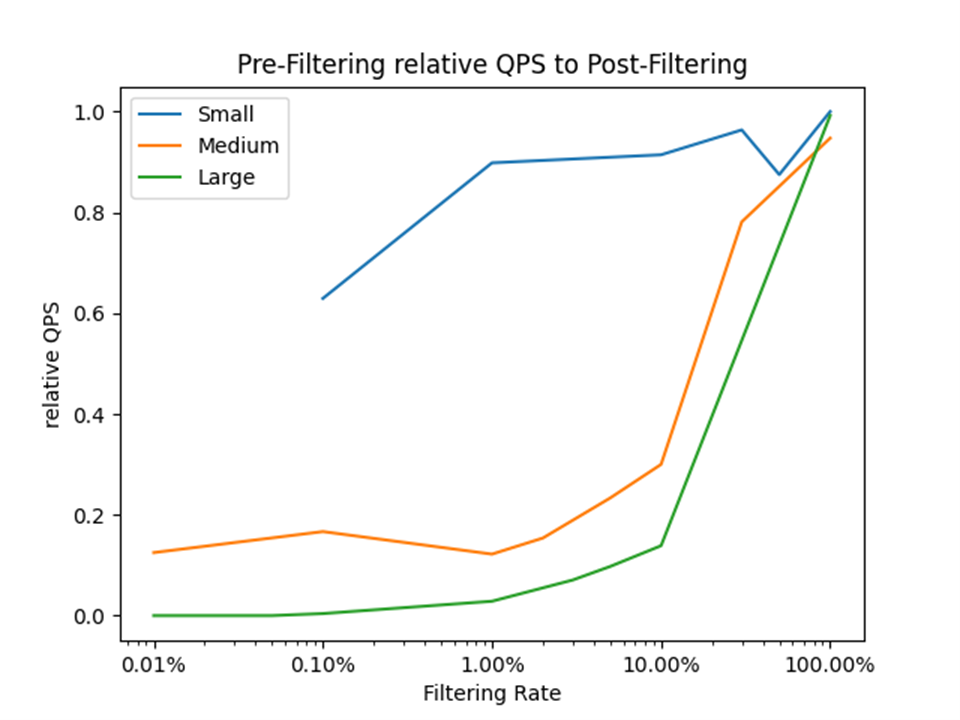
A függőleges tengely az előszűrés relatív teljesítményét jelöli a postfilteringhez képest, qPS arányban kifejezve (lekérdezések másodpercenként). Például:
-
0.0értéke azt jelenti, hogy az előszűrés 100%-kal lassabb az utószűrésnél. - Egy
0.5érték azt jelenti, hogy az előszűrés 50%-kal lassabb. - Az előszűrés és az utófeldolgozás egyenértékűek, ha értéke
1.0.
A vízszintes tengely a szűrési arányt vagy a jelölt dokumentumok százalékos arányát jelöli a szűrő alkalmazása után. Például, ha 1.00% az arány, az azt jelenti, hogy a szűrési feltételek a keresési korpusz egy százalékát választották ki.
Kapcsolódó tartalom
Vector-keresés a Azure AI Keresés - Vektorindex létrehozása
- Vektoros lekérdezés létrehozása