Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
A relevancia valódi mértéke az, hogy a lekért eredmények mennyire megfelelnekk az ügyfelek és a felhasználói adatok igényeinek. Ebben a cikkben a következő információkról olvashat:
- A releváns eredmények Azure AI Keresésben való előállításának fő stratégiái
- A relevancia mérésének mechanikája
- A relevancia javítása érdekében végrehajtandó műveletek
Stratégiák a rendkívül releváns eredményekhez
Az Azure AI Keresésben két fő stratégia jelent meg a rendkívül releváns eredmények előállításának legjobb módszereként.
- Hibrid keresés szemantikai rangsorolóval
- Ügynökalapú információlekérés LLM-alapú lekérdezés-tervezéssel (előzetes verzió) és válaszszintézissel (előzetes verzió)
A hibrid keresés (klasszikus) a kulcsszó-lekérdezések pontosságának és a vektoros lekérdezések szemantikai hasonlóságának kombinálásával biztosítja a relevanciát egy egyetlen indexet célzó keresési kérelemben. A kulcsszókeresés szó szerinti lekérdezésen keresztül működik. A vektorkeresés azonos lekérdezést futtat ugyanazon sztring vektorizált verziójával. A lekérdezések párhuzamosan futnak, pontos és szemantikailag hasonló egyezéseket keresve. Az eredmények egyesítése, rangsorolása és ismételt felvétele szemantikai rangsorolóval történik, amely a legrelevánsabb találatokat népszerűsíti. A kulcsszó- és vektorkeresés együttes használata különálló megoldásként ellensúlyozza az egyes megközelítések gyengeségeit. A szemantikai rangsoroló egy extra összetevő, amely hozzájárul a jobb eredményhez.
Az ügynöki lekérés az LLM-alapú lekérdezéstervezés (előzetes verzió), a válaszszintézis (előzetes verzió) és egy teljes keresési tartományt meghatározó tudásbázis révén biztosít relevanciát. Az LLM elemezheti és átalakíthatja a lekérdezéseket a hatékonyabb lekérés érdekében. Összetett kérdéseket képes célzott al lekérdezésekre bonteni, pontosítani a homályos kéréseket, vagy általánosítani a szűkebb kérdéseket a szélesebb hatókör érdekében. Egy tipikus ügynöki lekérési számítási feladatban az LLM az érvelési funkciójával, a csevegési előzmények kontextusával és a lekérési utasítások használatával válaszol a kérdésre, hogy azonosítsa a legjobb tartalmat, és a lehető legjobban kihasználja azt. Az LLM-alapú lekérdezéstervezés, a több forrásból álló tudásbáziskeresés és az LLM-érvelés kombinációja az, hogy az ügynöki lekérés rendkívül releváns eredményeket ad vissza.
A relevancia függ a megfelelő mennyiségű és minőségű adatoktól is. Az ügynöki lekérésben több tudásbázist is felsorolhat, hogy kiterjeszthesse a kereshető elemek hatókörét, és logikát biztosítson bizonyos források kiválasztásához.
A relevancia mérése
A tartalom lekérésének módjától függetlenül a találatok relevanciáját egy rangsorolási algoritmus határozza meg, amely kiértékeli az egyezés erősségét annak alapján, hogy a lekérdezés mennyire felel meg a keresési korpuszban lévő tartalomnak. Ha talál egyezést, az algoritmus hozzárendel egy pontszámot, az eredményeket pedig az adott pontszám rangsorolja, és a rendszer a legeredményesebb eredményeket adja vissza a válaszban.
A rangsorolás akkor történik, amikor a lekérdezés kifejezetten a dinamikus lekérésre, valamint a kulcsszó-, vektor- és hibrid lekérdezések klasszikus keresésére irányul. Nem fordul elő, ha a lekérdezés szigorú mintaegyezést hív meg, például egy csak szűrős lekérdezést vagy egy speciális lekérdezési űrlapot, például az automatikus kiegészítést, a javaslatokat, a térinformatikai keresést, a homályos keresést vagy a reguláris kifejezéskeresést. Az egységes 1,0-s keresési pontszám azt jelzi, hogy nincs rangsorolási algoritmus.
Rangsorolási szintek
Az Azure AI Keresés lekérdezési motorja támogatja a keresési eredmények rangsorolásának többszintű megközelítését, ahol az egyes lekérdezéstípusokhoz beépített rangsorolási mód van, valamint további rangsorolási képességek a kiterjesztett relevanciahangoláshoz.
Ez a szakasz a pontozási műveletek szintjét ismerteti. A közös munka módját szemléltető ábrát ebben a cikkben találja. Ebben a cikkben az összes keresési pontszámtípus és -tartomány összehasonlítását is bemutatjuk.
| Level | Description |
|---|---|
| 1. szint (L1) | Kezdeti keresési pontszám (@search.score). Az tokenizált karakterláncokon egyező szöveges lekérdezések esetében az eredmények mindig a BM25 rangsorolási algoritmus használatával kerülnek rangsorolásra. Vektoros lekérdezések esetén az eredmények rangsorolása hierarchikus navigálható kis világ (HNSW) vagy teljes K-legközelebbi szomszéd (KNN) használatával történik. A képkeresés vagy a többmodális keresések vektoros lekérdezéseken alapulnak, és az L1 vektorok rangsorolási algoritmusai alapján pontozzanak. |
| Olvasztott L1 | Több lekérdezés pontozása a kölcsönös rangsor fúziós (RRF) algoritmussal. Az RRF szöveg- és vektorösszetevőket tartalmazó hibrid lekérdezésekhez használható. Az RRF akkor is használatos, ha több vektoros lekérdezés fut párhuzamosan. Az RRF keresési pontszáma @search.score jelenik meg. |
| 2. szint (L2) |
A szemantikai rangsorolás pontszáma (@search.reRankerScore) gépi olvasási megértést alkalmaz az L1 rangsorolás által lekért szöveges tartalomra, és az L1-eredményeket a lekérdezés szemantikai szándékának jobban megfelelteti. L2 újrarangsorolja az L1 eredményeket, mert így időt és pénzt takarít meg; megengedhetetlen lenne a szemantikai rangsorolást L1 rangsorolási rendszerként használni. A szemantikai rangsorolás egy prémium funkció, amely a szemantikai rangsorolási modellek használatáért számláz. Nem kötelező szöveges lekérdezések és vektoros lekérdezések esetén, amelyek szöveget tartalmaznak, de ügynöki lekéréshez szükségesek. Bár az ügynöki lekérés több lekérdezést is küld a lekérdezési motornak, az ügynöki lekérés rangsorolási algoritmusa a szemantikai rangsoroló. |
| 3. szint (L3) | Az ügynökalapú lekérésre és a medium lekérési érvelésre (előzetes verzió) vonatkozik. Az L3-rangsor az iteratív keresésre utal, és akkor lesz meghívva, amikor az ügynöki lekérési motor és az LLM megállapodik abban, hogy egy második lekérdezési passzra van szükség egy relevánsabb eredmény visszaadásához. További információért lásd a adathordozó keresés iteratív módszerét. |
Relevanciahangolás
A relevancia finomhangolása a keresési pontszámok olyan extra feltételeken alapuló növelésének technikája, mint a súlyozott mezők, a frissesség vagy a közelség. Az Azure AI Keresésben a relevancia finomhangolási beállításai a lekérdezés típusától függően változnak:
A kulcsszó- vagy hibrid keresés szöveges és numerikus (nem jelentéskészítő) tartalmai esetében a relevancia pontozási profilokkal vagy a szemantikai rangsoroló meghívásával hangolható.
A hibrid lekérdezések vektortartalmai esetében a vektormezők súlyozásával növelheti a vektorkomponens fontosságát a hibrid lekérdezés szövegösszetevője szempontjából.
A tiszta vektoros lekérdezések esetében kísérletezhet a hierarchikus Navigable Small World (HNSW) és a teljes K-legközelebbi szomszédok (KNN) között, hogy kiderüljön, az egyik algoritmus felülmúlja-e a másikat a forgatókönyvben. Az összehasonlítási tesztelés legrugalmasabb módszere a teljes KNN-felülbírálással rendelkező HNSW-diagramkészítés. Kísérletezhet a különböző beágyazási modellekkel is, hogy lássa, melyek eredményeznek jobb minőségű eredményeket. Végül ne feledje, hogy a nem-vektoros mezőket tartalmazó dokumentumok hibrid vagy vektoros lekérdezései a relevanciahangolás hatókörébe tartoznak, így maguk a vektormezők nem vehetnek részt a relevanciahangolásban.
Egyéni kiemelési logika pontozási profilok használatával
A pontozási profilok nem kötelezőek a pontszámok további felhasználó által meghatározott feltételek alapján történő növeléséhez. A feltételek olyan súlyozott mezőket is tartalmazhatnak, amelyekben egy adott mezőben talált egyezés nagyobb súlyt kap, mint egy másik mezőben található egyezés. A feltételek a frissesség, a közelség, a nagyságrend vagy a tartomány által növelt függvényekkel is meghatározhatók. A pontozási profilokhoz nem kapcsolódnak többletköltségek. Pontozási profil használatához definiálja azt egy indexben, majd egy lekérdezésben adja meg.
A pontozási logika szövegre és numerikus nem vektortartalmakra vonatkozik. A pontozási profilokat a következőkkel használhatja:
- Szöveg (kulcsszó) keresése
- Tiszta vektoros lekérdezések
- Hibrid lekérdezések, ahol a szöveg- és vektor-részkikérdezések párhuzamosan futnak
- Szemantikailag rangsorolt lekérdezések
Önálló szöveges lekérdezések esetén a pontozási profilok a BM25 rangsorolt keresés 1000 találatát azonosítják, és a válaszban az első 50 találat szerepel.
A tiszta vektorok esetében a lekérdezés csak vektoros, de ha a k-egyező dokumentumok nem adatmegjelenítő mezőket tartalmaznak emberi olvasásra alkalmas tartalommal, akkor a rendszer pontozási profilt alkalmaz a dokumentumok nem adatmegjelenítő mezőire k .
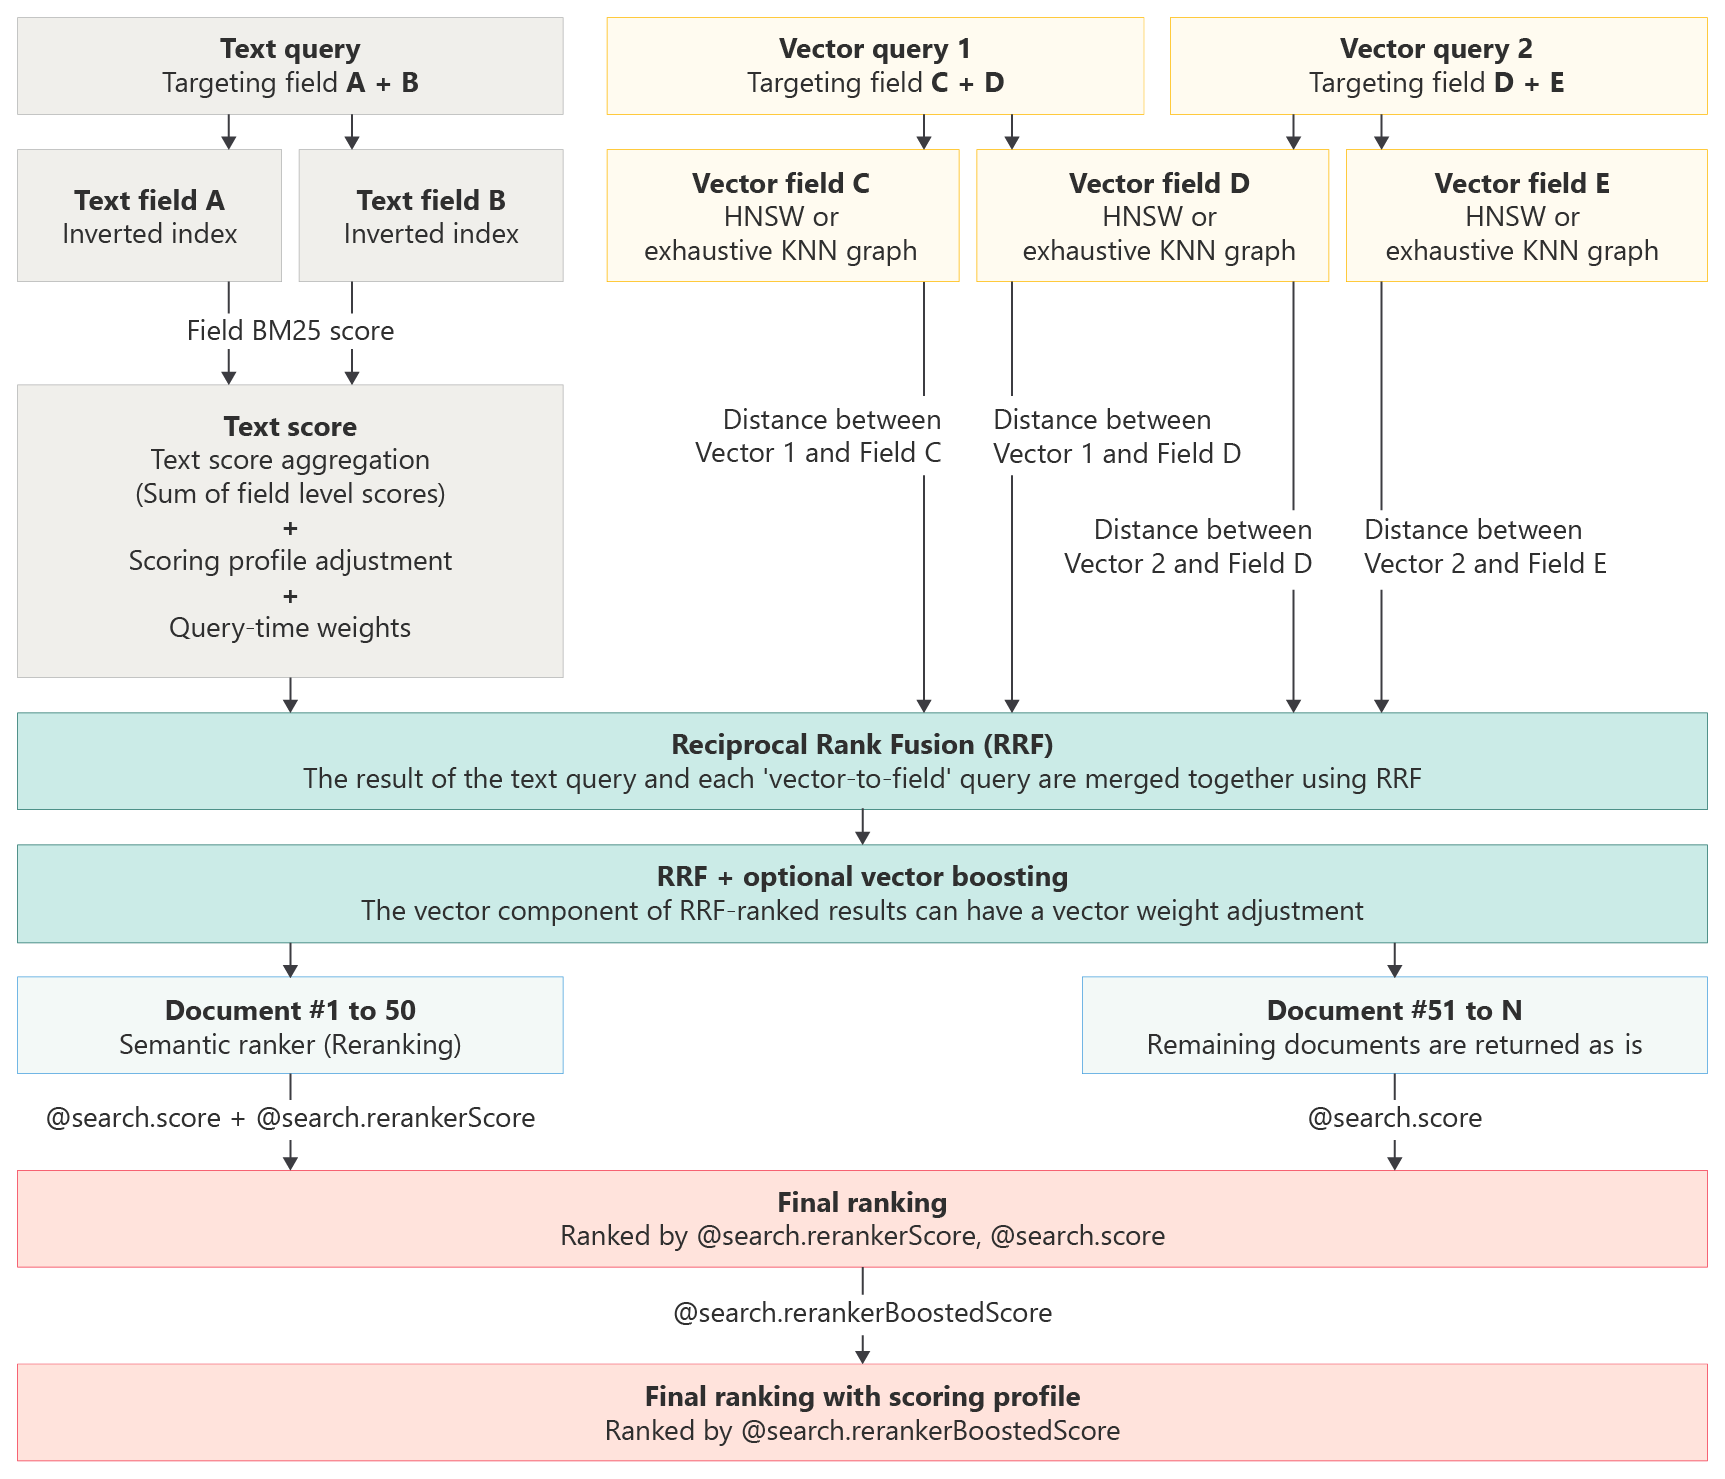
A hibrid lekérdezés szöveges komponensében a pontozási profilok azonosítják a BM25 rangsorolt keresés 1000 legjobb találatát. Az 1000 találat azonosítása után azonban a rendszer visszaállítja őket az eredeti BM25-sorrendbe, hogy a vektorok eredményeivel együtt a végső kölcsönös rangsorolási függvény (RRF) sorrendbe rendezze őket, ahol a pontozási profilt (az ábrán "végső dokumentum-növelő kiigazításként" azonosítva) az egyesített eredményekre, a vektorok súlyozásával és a szemantikai rangsorolással együtt alkalmazzák az utolsó lépésként.
Szemantikailag rangsorolt lekérdezések esetén (a diagramon nem látható), feltéve, hogy a legújabb előzetes REST API-t vagy egy előzetes verziójú Azure SDK-csomagot használ, a pontozási profilok egy L2 rangsorolt eredményhalmazon keresztül alkalmazhatók, és létrehoznak egy újat @search.rerankerBoostedScore , amely meghatározza a végső rangsorolást.
Keresési pontszámok típusai
A pontozott eredmények a lekérdezési válaszban minden egyezéshez meg vannak jelölve. Ez a táblázat felsorolja az összes keresési értéket egy társított tartománnyal. A tartomány algoritmusonként változik.
| Score | Range | Algorithm |
|---|---|---|
@search.score |
0–korlátlan | BM25 rangsorolási algoritmus szövegkereséshez |
@search.score |
0.333 - 1.00 | HNSW vagy teljes KNN-algoritmus vektorkereséshez |
@search.score |
0 a lekérdezések száma által meghatározott felső korláton keresztül | RRF-algoritmus |
@search.rerankerScore |
0.00 - 4.00 | Szemantikai rangsorolási algoritmus L2-rangsoroláshoz |
@search.rerankerBoostedScore |
0–korlátlan | Szemantikai rangsorolás a pontozási profil növelésével (a pontszámok jelentősen magasabbak lehetnek, mint 4) |
Rangsorolási algoritmusok diagramja
Az alábbi ábra bemutatja, hogyan működnek együtt a rangsorolási algoritmusok.
Note
Ha szemantikai rangsorolást használ, a rankingOrder tulajdonság határozza meg, hogy az eredmények a szemantikailag pontozott eredmények (@search.rerankerScore) vagy a pontozási profil alkalmazása után létrehozott megnövelt pontszámok ( @search.rerankerBoostedScore) lesznek-e.
Példa lekérdezés az összes rangsorolási algoritmusra
Az alábbi hibrid szemantikai lekérdezés az előző diagram rangsorolási munkafolyamatát mutatja be. A lekérdezés pontszáma RRF használatával történik (a szöveg és vektorok L1 pontszámai alapján), majd a szemantikai rangsorolás.
POST https://{{search-service-name}}.search.windows.net/indexes/{{index-name}}/docs/search?api-version=2026-08-01-preview

{
  "search": "cloud formation over water",
  "count": true,
  "vectorQueries": [
    {
      "kind": "text",
      "text": "cloud formation over water",
      "fields": "text_vector,image_vector"
    }
  ],
  "queryType": "semantic",
  "semanticConfiguration": "my-semantic-configuration",
  "select": "title,chunk",
  "top": 5
}
A hibrid szemantikai lekérdezésre adott válasz tartalmazza az eredeti RRF-et @search.score és a @search.rerankerScore.
  "value": [
    {
      "@search.score": 0.03177805617451668,
      "@search.rerankerScore": 2.6919238567352295,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n32\n\nFraming an Iceberg\nSouth Atlantic Ocean\n\nIn June 2016, the Suomi NPP satellite captured this image of various cloud formations in the South Atlantic Ocean. Note how low \n\nstratus clouds framed a hole over iceberg A-56 as it drifted across the sea. \n\nThe exact reason for the hole in the clouds is somewhat of a mystery. It could have formed by chance, although imagery from the \n\ndays before and after this date suggest something else was at work. It could be that the relatively unobstructed path of the clouds \n\nover the ocean surface was interrupted by thermal instability created by the iceberg. In other words, if an obstacle is big enough,  \n\nit can divert the low-level atmospheric flow of air around it, a phenomenon often caused by islands.",
      "title": "page-39.pdf",
    },
    {
      "@search.score": 0.030621785670518875,
      "@search.rerankerScore": 2.557225465774536,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n24\n\nMaking Tracks\nPacific Ocean\n\nShips steaming across the Pacific Ocean left this cluster of bright cloud trails lingering in the atmosphere in February 2012. The \n\nnarrow clouds, known as ship tracks, form when water vapor condenses around tiny particles of pollution from ship exhaust. The \n\ncrisscrossing clouds off the coast of California stretched for many hundreds of kilometers from end to end. The narrow ends of the \n\nclouds are youngest, while the broader, wavier ends are older.\n\nSome of the pollution particles generated by ships (especially sulfates) are soluble in water and can serve as the seeds around which \n\ncloud droplets form. Clouds infused with ship exhaust have more and smaller droplets than unpolluted clouds. As a result, light \n\nhitting the ship tracks scatters in many directions, often making them appear brighter than other types of marine clouds, which are \n\nusually seeded by larger, naturally occurring particles like sea salt.",
      "title": "page-31.pdf",
    },
    {
      "@search.score": 0.013698630034923553,
      "@search.rerankerScore": 2.515575408935547,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n16\n\nRiding the Waves\nMauritania\n\nYou cannot see it directly, but air masses from Africa and the Atlantic Ocean are colliding in this Landsat 8 image from August 2016. \n\nThe collision off the coast of Mauritania produces a wave structure in the atmosphere. \n\nCalled an undular bore or solitary wave, this cloud formation was created by the interaction between cool, dry air coming off the \n\ncontinent and running into warm, moist air over the ocean. The winds blowing out from the land push a wave of air ahead like a  \n\nbow wave moving ahead of a boat. \n\nParts of these waves are favorable for cloud formation, while other parts are not. The dust blowing out from Africa appears to be \n\nriding these waves. Dust has been known to affect cloud growth, but it probably has little to do with the cloud pattern observed here.",
      "title": "page-23.pdf",
    },
    {
      "@search.score": 0.028949543833732605,
      "@search.rerankerScore": 2.4990925788879395,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n14\n\nBering Streets\nArctic Ocean\n\nWinds from the northeast pushed sea ice southward and formed cloud streets—parallel rows of clouds—over the Bering Strait in \n\nJanuary 2010. The easternmost reaches of Russia, blanketed in snow and ice, appear in the upper left. To the east, sea ice spans \n\nthe Bering Strait. Along the southern edge of the ice, wavy tendrils of newly formed, thin sea ice predominate.\n\nThe cloud streets run in the direction of the northerly wind that helps form them. When wind blows out from a cold surface like sea \n\nice over the warmer, moister air near the open ocean, cylinders of spinning air may develop. Clouds form along the upward cycle in \n\nthe cylinders, where air is rising, and skies remain clear along the downward cycle, where air is falling. The cloud streets run toward \n\nthe southwest in this image from the Terra satellite.",
      "title": "page-21.pdf",
    },
    {
      "@search.score": 0.027637723833322525,
      "@search.rerankerScore": 2.4686081409454346,
      "chunk": "A\nT\n\nM\nO\n\nS\nP\n\nH\nE\n\nR\nE\n\nE\nA\n\nR\nT\n\nH\n\n38\n\nLofted Over Land\nMadagascar\n\nAlong the muddy Mania River, midday clouds form over the forested land but not the water. In the tropical rainforests of Madagascar, \n\nthere is ample moisture for cloud formation. Sunlight heats the land all day, warming that moist air and causing it to rise high into the \n\natmosphere until it cools and condenses into water droplets. Clouds generally form where air is ascending (over land in this case), \n\nbut not where it is descending (over the river). Landsat 8 acquired this image in January 2015.",
      "title": "page-45.pdf",
    }
  ]