Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Megjegyzés
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Fontos
Az (előzetes verzióban) megjelölt funkciókra, képességekre vagy tulajdonságokra nem vonatkozik szolgáltatási szintű szerződés, nem ajánlott éles számítási feladatokhoz, és az általános elérhetővé válásuk előtt változhatnak vagy korlátozhatók. Az Azure AI Keresés előzetes verziójú kifejezések az összes előzetes verziós funkcióra vonatkoznak, függetlenül attól, hogy önálló vagy egy általánosan elérhető funkció része.
Megtudhatja, hogyan hozhat létre egy intelligens, MCP-kompatibilis megoldást, amely integrálja az Azure AI Keresés-ot a Foundry Agent Service-szel az agentikus lekérdezéshez. Ezt az architektúrát olyan társalgási alkalmazásokhoz használhatja, amelyek összetett érvelést igényelnek nagy tudástartományokon keresztül, például ügyfélszolgálattal vagy technikai hibaelhárítással.
Ez az oktatóanyag két helyen használ előnézeti REST API-felületeket. A tudásbázis a retrieval_reasoning_effort és a output_mode (előzetes verzió) elemeket használja az extraktív kimenet és a minimális érvelés explicit megadására, bár az ezzel egyenértékű működés általában elérhető. A projektkapcsolat a(z) RemoteTool (előzetes verzió) és a projekt felügyelt identitása használatával hitelesíti magát az Azure AI Kereséshöz.
Ebben az oktatóanyagban ön:
- Szerepköralapú hozzáférés konfigurálása Azure AI Keresés és Microsoft Foundryhez
- Keresési index, tudásforrás és tudásbázis létrehozása Azure AI Keresés
- Projektkapcsolat létrehozása Azure AI Keresés és Microsoft Foundry közötti MCP-kommunikációhoz
- Ügynök létrehozása Microsoft Foundryben, amely az MCP eszközt használja a lekéréshez
- A megoldás tesztelése az ügynökkel folytatott csevegéssel
- Tippek áttekintése a megoldás optimalizálásához
Tipp
Azonnal hozzá szeretne kezdeni? Klónozza a GitHubon lévő agentic-retrieval-pipeline-example Python jegyzetfüzetet. A jegyzetfüzet az oktatóanyagból származó kódot használatra kész formátumban tartalmazza.
A bejövő és kimenő privát kapcsolódás ellenőrzésére összpontosító privát üzembe helyezési útvonalról lásd: Oktatóanyag: Ágensalapú visszakeresés privát üzembe helyezése a Foundry IQ-hoz.
Előfeltételek
Egy Azure AI Keresés szolgáltatás, amely bármely régióban ügynök-alapú lekérést biztosít.
Egy Microsoft Foundry-projekt és erőforrás. Projekt létrehozásakor az erőforrás automatikusan létrejön.
A projektben a lekérdezési idő vektorizálásához üzembe helyezett szövegbeágyazási modell. Ez a megoldás használja a
text-embedding-3-large.Az ügynök számára a projektben telepített LLM. Ez a megoldás használja a
gpt-5-mini.A GPT-4 modellcsalád modelljei kivezetésre kerültek. A Microsoft Foundryben a kivonási dátumokat és az aktuális állapotot a Modell nyugdíjazási ütemezése – Microsoft Foundry című témakörben találja.
Engedély az Azure AI Keresés és Microsoft Foundry-erőforrások eléréséhez és kezeléséhez. További információ: Hozzáférés konfigurálása.
Python 3.8 vagy újabb verzió.
Visual Studio CodePython és Jupyter kiterjesztéssel.
A Microsoft Entra ID-vel történő kulcs nélküli hitelesítéshez használt Azure CLI.
Fontos
Ha letiltja a keresési szolgáltatás nyilvános hálózati hozzáférését, és ügynöki eszközként használja azt egy hálózatelkülönített Microsoft Foundry-erőforrással, az ügynökök létrehozásához a Microsoft Foundry (új) portált, az SDK-t vagy a CLI-t kell használnia. A Microsoft Foundry (klasszikus) portál nem támogatja ezt a forgatókönyvet. További információ: Ügynökeszközök hálózatelkülönítéssel.
A megoldás ismertetése
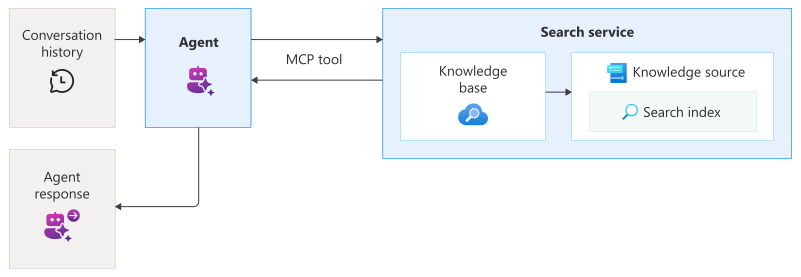
Ez a megoldás egyesíti a Azure AI Keresés és a Microsoft Foundryt egy végpontok közötti lekérési folyamat létrehozásához:
Azure AI Keresés üzemelteti a tudásbázist, amely kezeli a lekérdezések tervezését, a lekérdezések végrehajtását és az eredmények szintézisét. Létrehoz egy keresési indexet a tartalom tárolásához, egy olyan tudásbázist, amely hivatkozik az indexre, és egy tudásbázist, amely hibrid lekérést végez a tudásbázisból.
Microsoft Foundry üzemelteti Azure OpenAI-modell üzembe helyezését, projektkapcsolatát és ügynökét. Létre kell hoznia egy projektkapcsolatot, amely a tudásbázis MCP-végpontjára mutat, majd létrehoz egy ügynököt, amely az MCP eszközt használja a tudásbázis eléréséhez.
A felhasználó egy ügyfélalkalmazás, például egy csevegőrobot használatával kezdeményezi a lekérdezések feldolgozását, amely meghívja az ügynököt. Az ügynök az MCP eszközzel koordinálja a kéréseket a tudásbázishoz, és szintetizálja a válaszokat. Amikor a csevegőrobot meghívja az ügynököt, az MCP eszköz meghívja a tudásbázist Azure AI Keresés, és elküldi a választ az ügynöknek és a csevegőrobotnak.
Hozzáférés konfigurálása
Mielőtt hozzákezdene, győződjön meg arról, hogy rendelkezik a tartalomhoz és a műveletekhez való hozzáféréshez szükséges engedélyekkel. Javasoljuk a Microsoft Entra ID használatát hitelesítéshez és az engedélyezéshez szerepköralapú hozzáférés alapján. Szerepkörök hozzárendeléséhez tulajdonosnak vagy felhasználói hozzáférés-rendszergazdának kell lennie. Ha a szerepkörök nem megvalósíthatók, használja inkább a kulcsalapú hitelesítést .
A megoldáshoz való hozzáférés konfigurálása:
Jelentkezzen be a Azure portálra.
Engedélyezze a rendszer által hozzárendelt felügyelt identitást mind a keresési szolgáltatás, mind a projekt számára. Ezt az egyes erőforrások Identitás lapján teheti meg.
A keresési szolgáltatásban engedélyezze a szerepköralapú hozzáférést , és rendelje hozzá a következő szerepköröket.
Szerepet Jogosult Célja Keresési szolgáltatás közreműködője Az Ön felhasználói fiókja Objektumok létrehozása Keresési index adatszolgáltatója Az Ön felhasználói fiókja Adatok betöltése Keresési indexadat-olvasó A felhasználói fiók és a projekt által felügyelt identitás Indexelt tartalom olvasása A projekt szülőerőforrásában rendelje hozzá a következő szerepköröket.
Szerepet Jogosult Célja Öntödei felhasználó Az Ön felhasználói fiókja Modelltelepítések elérése és ügynökök létrehozása Foundry projektmenedzser Az Ön felhasználói fiókja Projektkapcsolat létrehozása és MCP-eszköz használata ügynökökben Cognitive Services-felhasználó Keresési szolgáltatás által felügyelt identitás Tudásbázis elérése
Fontos
Az Foundry RBAC-szerepköröket nemrég átnevezték. Foundry user, Foundry Owner, Foundry-fióktulajdonos és Foundry Project Manager korábban Azure AI-felhasználónak, Azure AI-tulajdonosnak, Azure AI-fióktulajdonosnak és Azure AI-Project-kezelőnek hívták. Előfordulhat, hogy egyes helyeken továbbra is a korábbi elnevezések jelennek meg, amíg az átnevezés fokozatosan bevezetésre kerül. A szerepkör-azonosítók és az alapvető jogosultságok az átnevezés ellenére változatlanok maradnak.
A környezet beállítása
Hozzon létre egy mappát
tutorial-agentic-retrievala helyi rendszeren.Nyissa meg a mappát a Visual Studio Code-ban.
Válassza a View>Command Palette lehetőséget, majd válassza a Python: Környezet létrehozása lehetőséget. Kövesse az utasításokat egy virtuális környezet létrehozásához.
Válassza a Terminál>Új terminál lehetőséget.
Telepítse a szükséges csomagokat.
pip install azure-ai-projects==2.0.0b1 azure-mgmt-cognitiveservices azure-identity ipykernel python-dotenv azure-search-documents==11.7.0b2 requests openaiHozzon létre egy fájlt
.envatutorial-agentic-retrievalmappában.Adja hozzá a következő változókat a
.envfájlhoz, és cserélje le a helyőrző értékeket a sajátjára.AZURE_SEARCH_ENDPOINT = https://{your-service-name}.search.windows.net PROJECT_ENDPOINT = https://{your-resource-name}.services.ai.azure.com/api/projects/{your-project-name} PROJECT_RESOURCE_ID = /subscriptions/{subscription-id}/resourceGroups/{resource-group-name}/providers/Microsoft.CognitiveServices/accounts/{account-name}/projects/{project-name} AZURE_OPENAI_ENDPOINT = https://{your-resource-name}.openai.azure.com AZURE_OPENAI_EMBEDDING_DEPLOYMENT = text-embedding-3-large AGENT_MODEL = gpt-5-miniA végpontokat és az erőforrás-azonosítót a Azure portálon találja:
AZURE_SEARCH_ENDPOINTa keresési szolgáltatás Áttekintés lapján található.PROJECT_ENDPOINTa projekt Végpontok lapján található.PROJECT_RESOURCE_IDa projekt Tulajdonságok lapján található.AZURE_OPENAI_ENDPOINTa projekt szülőerőforrásának Végpontok lapján található.
Ha kulcs nélküli hitelesítést szeretne a Microsoft Entra ID-vel, jelentkezzen be az Azure-fiókjába. Ha több előfizetéssel rendelkezik, válassza ki azt, amely tartalmazza a Azure AI Keresés és Microsoft Foundry-erőforrásokat.
az loginHozzon létre egy fájlt
tutorial.ipynbatutorial-agentic-retrievalmappában. Ehhez a fájlhoz a következő szakaszban adhatja hozzá a kódcellát.
A megoldás létrehozása
Ebben a szakaszban létrehozza az agentikus lekérési megoldás összetevőit. Adja hozzá az egyes kódrészleteket a tutorial.ipynb jegyzetfüzet egy külön kódcellájához, és futtassa a cellákat egymás után.
A szakasz lépései a következők:
- Kapcsolatok betöltése
- Keresési index létrehozása
- Dokumentumok feltöltése az indexbe
- Tudásbázis létrehozása
- Tudásbázis létrehozása
- Projektügyfél beállítása
- Projektkapcsolat létrehozása
- Ügynök létrehozása az MCP eszközzel
- Csevegés az ügynökkel
- Erőforrások törlése
Kapcsolatok betöltése
Az alábbi kód betölti a környezeti változókat a .env fájlból, és kapcsolatot létesít Azure AI Keresés és Microsoft Foundry-vel.
import os

from azure.identity import DefaultAzureCredential
from azure.mgmt.core.tools import parse_resource_id
from dotenv import load_dotenv

load_dotenv(override=True) # Take environment variables from .env

project_endpoint = os.environ["PROJECT_ENDPOINT"]
project_resource_id = os.environ["PROJECT_RESOURCE_ID"]
project_connection_name = os.getenv("PROJECT_CONNECTION_NAME", "earthknowledgeconnection")
agent_model = os.getenv("AGENT_MODEL", "gpt-5-mini")
agent_name = os.getenv("AGENT_NAME", "earth-knowledge-agent")
endpoint = os.environ["AZURE_SEARCH_ENDPOINT"]
credential = DefaultAzureCredential()
knowledge_source_name = os.getenv("AZURE_SEARCH_KNOWLEDGE_SOURCE_NAME", "earth-knowledge-source")
index_name = os.getenv("AZURE_SEARCH_INDEX", "earth-at-night")
azure_openai_endpoint = os.environ["AZURE_OPENAI_ENDPOINT"]
azure_openai_embedding_deployment = os.getenv("AZURE_OPENAI_EMBEDDING_DEPLOYMENT", "text-embedding-3-large")
azure_openai_embedding_model = os.getenv("AZURE_OPENAI_EMBEDDING_MODEL", "text-embedding-3-large")
base_name = os.getenv("AZURE_SEARCH_AGENT_NAME", "earth-knowledge-base")

# Parse the resource ID to extract subscription and other components
parsed_resource_id = parse_resource_id(project_resource_id)
subscription_id = parsed_resource_id['subscription']
resource_group = parsed_resource_id['resource_group']
account_name = parsed_resource_id['name']
project_name = parsed_resource_id['child_name_1']
Keresési index létrehozása
Az Azure AI Keresés-ben az index egy strukturált adatgyűjtemény. Az alábbi kód létrehoz egy indexet a tudásbázis kereshető tartalmának tárolásához.
Az indexséma mezőket tartalmaz a dokumentumazonosításhoz és az oldaltartalomhoz, a beágyazásokhoz és a számokhoz. A séma magában foglalja a szemantikai rangsorolás és a vektorkeresés konfigurációit is, amelyek a text-embedding-3-large üzembe helyezését használják arra, hogy vektorizálják a szöveget, és szemantikai hasonlóság alapján párosítsák a dokumentumokat.
A lépésről további információt a A Azure AI Keresés ügynöki lekérés indexének létrehozása című témakörben talál.
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import (
    AzureOpenAIVectorizer, AzureOpenAIVectorizerParameters,
    HnswAlgorithmConfiguration, SearchField, SearchIndex,
    SemanticConfiguration, SemanticField, SemanticPrioritizedFields,
    SemanticSearch, VectorSearch, VectorSearchProfile
)

index = SearchIndex(
    name=index_name,
    fields=[
        SearchField(name="id", type="Edm.String", key=True, filterable=True, sortable=True, facetable=True),
        SearchField(name="page_chunk", type="Edm.String", filterable=False, sortable=False, facetable=False),
        SearchField(name="page_embedding_text_3_large", type="Collection(Edm.Single)", stored=False, vector_search_dimensions=3072, vector_search_profile_name="hnsw_text_3_large"),
        SearchField(name="page_number", type="Edm.Int32", filterable=True, sortable=True, facetable=True)
    ],
    vector_search=VectorSearch(
        profiles=[VectorSearchProfile(name="hnsw_text_3_large", algorithm_configuration_name="alg", vectorizer_name="azure_openai_text_3_large")],
        algorithms=[HnswAlgorithmConfiguration(name="alg")],
        vectorizers=[
            AzureOpenAIVectorizer(
                vectorizer_name="azure_openai_text_3_large",
                parameters=AzureOpenAIVectorizerParameters(
                    resource_url=azure_openai_endpoint,
                    deployment_name=azure_openai_embedding_deployment,
                    model_name=azure_openai_embedding_model
                )
            )
        ]
    ),
    semantic_search=SemanticSearch(
        default_configuration_name="semantic_config",
        configurations=[
            SemanticConfiguration(
                name="semantic_config",
                prioritized_fields=SemanticPrioritizedFields(
                    content_fields=[
                        SemanticField(field_name="page_chunk")
                    ]
                )
            )
        ]
    )
)

index_client = SearchIndexClient(endpoint=endpoint, credential=credential)
index_client.create_or_update_index(index)
print(f"Index '{index_name}' created or updated successfully")
Dokumentumok feltöltése az indexbe
Az index jelenleg üres. Az alábbi kód JSON-dokumentumokkal tölti fel az indexet NASA Earth at Night e-book. A Azure AI Keresés előírásainak megfelelően minden dokumentum megfelel az indexsémában definiált mezőknek és adattípusoknak.
Erről a lépésről további információt az adatok indexbe való leküldése című témakörben talál.
import requests
from azure.search.documents import SearchIndexingBufferedSender

url = "https://raw.githubusercontent.com/Azure-Samples/azure-search-sample-data/refs/heads/main/nasa-e-book/earth-at-night-json/documents.json"
documents = requests.get(url).json()

with SearchIndexingBufferedSender(endpoint=endpoint, index_name=index_name, credential=credential) as client:
    client.upload_documents(documents=documents)

print(f"Documents uploaded to index '{index_name}'")
Tudásbázis létrehozása
A tudásbázis a forrásadatok újrafelhasználható hivatkozása. Az alábbi kód létrehoz egy tudásbázist, amely a korábban létrehozott indexet célozza.
source_data_fields megadja, hogy mely indexmezők szerepelnek az idézethivatkozásokban. Ez a példa csak az ember által olvasható mezőket tartalmazza, hogy elkerülje a hosszadalmas, értelmezhetetlen beágyazásokat a válaszokba.
Erről a lépésről további információt a keresési index tudásbázisának létrehozása című témakörben talál.
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import (
    SearchIndexFieldReference, SearchIndexKnowledgeSource,
    SearchIndexKnowledgeSourceParameters
)

ks = SearchIndexKnowledgeSource(
    name=knowledge_source_name,
    description="Knowledge source for Earth at night data",
    search_index_parameters=SearchIndexKnowledgeSourceParameters(
        search_index_name=index_name,
        semantic_configuration_name="semantic_config",
        source_data_fields=[
            SearchIndexFieldReference(name="id"),
            SearchIndexFieldReference(name="page_chunk"),
            SearchIndexFieldReference(name="page_number")
        ]
    ),
)

index_client = SearchIndexClient(endpoint=endpoint, credential=credential)
index_client.create_or_update_knowledge_source(knowledge_source=ks)
print(f"Knowledge source '{knowledge_source_name}' created or updated successfully.")
Tudásbázis létrehozása
Az alábbi kód létrehoz egy tudásbázist, amely a lekérési folyamatot irányítja a tudásforrásból. A kód a tudásbázis MCP-végpontját is tárolja, amelyet az ügynök a tudásbázis eléréséhez fog használni.
Az Foundry Agent Service-vel való integrációhoz a tudásbázis a következő paraméterekkel van konfigurálva:
output_mode(előzetes verzió) kivonatoló adatokra van állítva, amely szó szerinti, feldolgozatlan tartalmat biztosít az ügynök számára a megalapozáshoz és a következtetéshez. Az alternatív mód, a válaszszintézis előre generált válaszokat ad vissza, amelyek korlátozzák az ügynök érvelési képességét a forrástartalommal szemben.retrieval_reasoning_effortAz (előzetes verzió) minimális erőfeszítésre van beállítva, amely túllépi az LLM-alapú lekérdezéstervezést a költségek és a késés csökkentése érdekében. Más érvelési erőfeszítések esetén a tudásbázis egy LLM-et használ a felhasználói lekérdezések újraformálására a lekérés előtt.
További információ erről a lépésről: Tudásbázis létrehozása Azure AI Keresés.
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import KnowledgeBase, KnowledgeSourceReference
from azure.search.documents.knowledgebases.models import KnowledgeRetrievalMinimalReasoningEffort

knowledge_base = KnowledgeBase(
    name=base_name,
    knowledge_sources=[
        KnowledgeSourceReference(
            name=knowledge_source_name
        )
    ],
    output_mode="extractiveData",
    retrieval_reasoning_effort=KnowledgeRetrievalMinimalReasoningEffort()
)


index_client = SearchIndexClient(endpoint=endpoint, credential=credential)
index_client.create_or_update_knowledge_base(knowledge_base=knowledge_base)
print(f"Knowledge base '{base_name}' created or updated successfully")

mcp_endpoint = f"{endpoint.rstrip('/')}/knowledgebases/{base_name}/mcp?api-version=2026-08-01-preview"
Projektügyfél beállítása
A AIProjectClient használatával hozzon létre ügyfélkapcsolatot a Microsoft Foundry-projekthez. Előfordulhat, hogy a projekt még nem tartalmaz ügynököket, de ha már elvégezte ezt az oktatóanyagot, az ügynök itt látható.
from azure.ai.projects import AIProjectClient

project_client = AIProjectClient(endpoint=project_endpoint, credential=credential)

list(project_client.agents.list())
Projektkapcsolat létrehozása
Az alábbi kód létrehoz egy projektkapcsolatot RemoteTool (előzetes verzió) Microsoft Foundryben, amely a tudásbázis MCP-végpontjára mutat. Ez a kapcsolat az Ön projekt által felügyelt identitását használja az Azure AI Keresés hitelesítésére.
import requests
from azure.identity import get_bearer_token_provider

bearer_token_provider = get_bearer_token_provider(credential, "https://management.azure.com/.default")
headers = {
    "Authorization": f"Bearer {bearer_token_provider()}",
}

response = requests.put(
    f"https://management.azure.com{project_resource_id}/connections/{project_connection_name}?api-version=2025-10-01-preview",
    headers=headers,
    json={
        "name": project_connection_name,
        "type": "Microsoft.MachineLearningServices/workspaces/connections",
        "properties": {
            "authType": "ProjectManagedIdentity",
            "category": "RemoteTool",
            "target": mcp_endpoint,
            "isSharedToAll": True,
            "audience": "https://search.azure.com/",
            "metadata": { "ApiType": "Azure" }
        }
    }
)

response.raise_for_status()
print(f"Connection '{project_connection_name}' created or updated successfully.")
Ügynök létrehozása az MCP eszközzel
Warning
Az MCP-implementációk érzékenyek a kockázatokra, például a támadásokra, a kaszkádolt hibákra és az emberi felügyelet elvesztésére. Ezeket a kockázatokat az MCP-kiszolgálók biztonsági és megbízhatósági vizsgálatával, Microsoft ajánlott eljárásainak és adustry ajánlott eljárásainak követésével, valamint jóváhagyási mechanizmusok implementálásával és a kaszkádolt viselkedések monitorozásával csökkentheti.
Az alábbi kód létrehoz egy, az MCP eszközzel konfigurált ügynököt. Amikor az ügynök felhasználói lekérdezést kap, meghívhatja a tudásbázist az MCP eszközzel, hogy lekérje a válasz alapjául szolgáló megfelelő tartalmakat.
Az ügynökdefiníció olyan utasításokat tartalmaz, amelyek meghatározzák annak viselkedését és a korábban létrehozott projektkapcsolatot. Kísérleteink alapján ezek az utasítások hatékonyan maximalizálják a tudásbázis-meghívások pontosságát, és biztosítják a megfelelő idézetformázást.
A lépéssel kapcsolatos további információkért tekintse meg a rövid útmutatót: Új ügynök létrehozása.
from azure.ai.projects.models import PromptAgentDefinition, MCPTool

instructions = """
You are a helpful assistant that must use the knowledge base to answer all the questions from user. You must never answer from your own knowledge under any circumstances.
Every answer must always provide annotations for using the MCP knowledge base tool and render them as: `【message_idx:search_idx†source_name】`
If you cannot find the answer in the provided knowledge base you must respond with "I don't know".
"""

mcp_kb_tool = MCPTool(
    server_label="knowledge-base",
    server_url=mcp_endpoint,
    require_approval="never",
    allowed_tools=["knowledge_base_retrieve"],
    project_connection_id=project_connection_name
)

agent = project_client.agents.create_version(
    agent_name=agent_name,
    definition=PromptAgentDefinition(
        model=agent_model,
        instructions=instructions,
        tools=[mcp_kb_tool]
    )
)

print(f"AI agent '{agent_name}' created or updated successfully")
(Nem kötelező) Engedélyek kényszerítése kérelemenkénti fejlécekkel
Ha bármelyik tudásbázisa engedélyekkel védett tartalmat tartalmaz, a lekérési motor képes szűrni az eredményeket, hogy minden felhasználó csak a hozzáférésre jogosult dokumentumokat lássa. A szűrés engedélyezéséhez továbbítsa a bejelentkezett felhasználó identitásjogkivonatát az x-ms-query-source-authorization MCP eszközkapcsolat fejlécében. A token nélkül az engedélykezelést támogató források szűretlen eredményeket adnak vissza. További információ: Engedélyek kényszerítése lekérdezéskor (előzetes verzió).
Ha kérésenként eltérő MCP-fejléceket szeretne használni, például egy másik felhasználó jogkivonatát továbbítani minden híváshoz, deklaráljon egy strukturált bemenetet az ügynökdefinícióban, és hivatkozzon rá {{placeholder}} az eszközben headers. A hívó minden hívásnál megadja az értéket. Ez a megközelítés a projektkapcsolathoz kötött MCP-eszközök esetében működik.
Az MCP-kiszolgáló felhasználónkénti engedélyezéséhez használhatja az OAuth-identitásátadást is.
Az alábbi kód frissíti az ügynököt az előző lépésben, így az MCP-eszköz beolvassa annak engedélyezési fejlécét egy strukturált bemenetből.
from azure.ai.projects.models import StructuredInputDefinition

# Reference the token as a placeholder in the header
mcp_kb_tool = MCPTool(
    server_label="knowledge-base",
    server_url=mcp_endpoint,
    require_approval="never",
    allowed_tools=["knowledge_base_retrieve"],
    project_connection_id=project_connection_name,
    headers={
        "x-ms-query-source-authorization": "{{search_auth_token}}"
    }
)

# Declare the structured input so the caller can supply the token per request
agent = project_client.agents.create_version(
    agent_name=agent_name,
    definition=PromptAgentDefinition(
        model=agent_model,
        instructions=instructions,
        tools=[mcp_kb_tool],
        structured_inputs={
            "search_auth_token": StructuredInputDefinition(
                description="Per-user Azure AI Search bearer token",
                required=True,
                schema={"type": "string"},
            )
        }
    )
)

print(f"AI agent '{agent_name}' created or updated successfully")
Az ügynök meghívásakor adjon meg egy Azure AI Keresés-tokent a(z) structured_inputs helyen. Ez a példa felold egy tokent az aktuális credential-ból. Többfelhasználós alkalmazás esetén ehelyett minden bejelentkezett felhasználó tokenjét adja át. Használjon például egy meghatalmazásos (on-behalf-of) folyamat során beszerzett tokent, hogy a visszakereső motor szűrhesse az adott felhasználóhoz tartozó eredményeket.
# Resolve an Azure AI Search token from the current credential (use a per-user token in production)
from azure.identity import get_bearer_token_provider

search_token = get_bearer_token_provider(credential, "https://search.azure.com/.default")()

openai_client = project_client.get_openai_client(agent_name=agent.name)
conversation = openai_client.conversations.create()

response = openai_client.responses.create(
    conversation=conversation.id,
    tool_choice="required",
    input="{user_query}",
    extra_body={
        "structured_inputs": {"search_auth_token": search_token},
    },
)

print(f"Response: {response.output_text}")
Csevegés az ügynökkel
Az ügyfélalkalmazás a Beszélgetések és Responses API-kat használja az Azure OpenAI-ból az ügynökkel való interakcióhoz.
Az alábbi kód létrehoz egy beszélgetést, és átadja a felhasználói üzeneteket az ügynöknek, egy tipikus csevegési élményhez hasonlóan. Az ügynök meghatározza, hogy mikor hívja meg a tudásbázist az MCP-eszközzel, és egy természetes nyelvű választ ad vissza hivatkozásokkal. A beállítás tool_choice="required" biztosítja, hogy az ügynök mindig a tudásbázis eszközt használja a lekérdezések feldolgozásakor.
# Get the OpenAI client for responses and conversations
openai_client = project_client.get_openai_client(agent_name=agent.name)

conversation = openai_client.conversations.create()

# Send initial request that will trigger the MCP tool
response = openai_client.responses.create(
    conversation=conversation.id,
    tool_choice="required",
    input="""
        Why do suburban belts display larger December brightening than urban cores even though absolute light levels are higher downtown?
        Why is the Phoenix nighttime street grid is so sharply visible from space, whereas large stretches of the interstate between midwestern cities remain comparatively dim?
    """,
)

print(f"Response: {response.output_text}")
A válasznak az alábbi példához hasonlónak kell lennie.
Response: Here are evidence-based explanations to your questions:

---

**1. Why do suburban belts display larger December brightening than urban cores, even though absolute light levels are higher downtown?**

- Suburban belts show a *larger percentage increase* in night brightness during December compared to urban cores, largely because suburban residential areas feature more single-family homes and larger yards, which are typically decorated with holiday lights. These areas start from a lower baseline (less bright overall at night compared to dense urban centers), so the relative change (brightening) is much more noticeable.

- In contrast, the downtown core is already very bright at night due to dense commercial lighting and streetlights. While it also sees a December increase (often 20–30% brighter), the *absolute* change is less striking because it begins at a much higher base of illumination.

- This pattern is observed across U.S. cities, with the phenomenon driven by widespread cultural practices and the suburban landscape’s suitability for holiday lighting displays. The effect is visible in satellite data and was quantified at 20–50% brighter in December, especially in suburbs and city outskirts.

---

**2. Why is the Phoenix nighttime street grid so sharply visible from space, whereas large stretches of the interstate between midwestern cities remain comparatively dim?**

- Phoenix’s sharply visible nighttime street grid from space is a result of its urban layout: the city (like many western U.S. cities) was developed using a regular grid system, with extensive and uniform street lighting and strong urban sprawl. The grid pattern, and the dense network of intersecting surface streets, is brightly illuminated, particularly at intersections, commercial areas, and major thoroughfares.

- The interstate highways between midwestern cities, though significant in length and crucial to national infrastructure, traverse sparsely populated rural areas. These stretches typically have very little artificial lighting (due to low traffic volumes at night and cost considerations), making them much less visible in nighttime satellite imagery. Only nodes (cities and towns) along the route show as bright "pearls" in the darkness, while the "strings" (highways) connecting them remain faint or invisible.

- In summary:
  - Urban areas like Phoenix stand out with strong, connected patterns of light due to dense development and extensive lighting.
  - Rural interstates are sparsely lit, and only their endpoints—cities and large towns—generate notable light visible from space.

---

**References**:
- [Holiday Lights increase most dramatically in suburbs, not downtowns: earth_at_night_508_page_176_verbalized, page 160](4:5)
- [Lighting paths and urban grids are visible from space, while rural highways remain dim: earth_at_night_508_page_124_verbalized, page 108](4:3)
- [Phoenix’s grid and surrounding urban structure: earth_at_night_508_page_104_verbalized, page 88](4:1)
A válasz vizsgálata
Az ügynök mögöttes válasza metaadatokat tartalmaz a tudásbázisnak küldött lekérdezésekről és a talált idézetekről. A metaadatokat megvizsgálva megtudhatja, hogyan dolgozza fel az ügynök a felhasználói bemenetet.
response.to_dict()
Erőforrások törlése
Ha a saját előfizetésében dolgozik, érdemes befejezni egy projektet a már nem szükséges erőforrások eltávolításával. Az otthagyott futó erőforrások pénzbe kerülhetnek.
Az Azure portálon válassza a Minden erőforrás vagy Erőforráscsoportok lehetőséget a bal oldali panelen az erőforrások megkereséséhez és kezeléséhez. Az erőforrásokat egyenként törölheti, vagy törölheti az erőforráscsoportot az összes erőforrás egyidejű eltávolításához.
Az egyes objektumok törléséhez a következő kódot is futtathatja:
# Delete the agent
project_client.agents.delete_version(agent.name, agent.version)
print(f"AI agent '{agent.name}' version '{agent.version}' deleted successfully")

# Delete the knowledge base
index_client.delete_knowledge_base(base_name)
print(f"Knowledge base '{base_name}' deleted successfully")

# Delete the knowledge source
index_client.delete_knowledge_source(knowledge_source=knowledge_source_name)
print(f"Knowledge source '{knowledge_source_name}' deleted successfully.")

# Delete the search index
index_client.delete_index(index_name)
print(f"Index '{index_name}' deleted successfully")
Az adatminőség javítása
Alapértelmezés szerint a tudásbázisokból származó keresési eredmények egy nagy, egységes karakterlánccá vannak összesítve, amelyet az ügynököknek kontextusba helyezéshez adhat át. Azure AI Keresés a következő indexelési és relevancia-finomhangolási funkciókat nyújtja, amelyekkel kiváló minőségű eredményeket hozhat létre. Ezeket a funkciókat a keresési indexben implementálhatja, és a keresési relevancia javulása nyilvánvaló a lekéréses válaszok minőségében.
A pontozási profilok beépített növelő feltételeket biztosítanak. Az indexnek meg kell adnia egy alapértelmezett pontozási profilt, amelyet a lekérési motor használ, amikor a lekérdezések az adott profilhoz társított mezőket tartalmaznak.
Szemantikai konfigurációra van szükség, de Ön határozza meg, hogy mely mezők részesüljenek előnyben és kerüljenek rangsorolásra.
Egyszerű szöveges tartalom esetén elemzőkkel szabályozhatja a tokenizálást az indexelés során.
Multimodális vagy képtartalmak esetén használhat képi verbalizációt a képek LLM által generált leírásaihoz, illetve klasszikus OCR-t és képelemzést skillseteken keresztül az indexelés során.
Az al lekérdezések számának szabályozása
Az allekérdezések számát úgy szabályozhatja, hogy beállítja a beolvasási érvelési erőfeszítést (előzetes verzió) a tudásbázisban. Az érvelési munka meghatározza az LLM-feldolgozás szintjét a lekérdezéstervezéshez, a minimálistól (LLM-feldolgozás nélkül) a közepesig (mélyebb keresési és követő iterációkig).
A nem minimális érvelési erőfeszítések esetében az LLM az alábbi tényezők alapján határozza meg az albekérdezések számát:
- Felhasználói lekérdezés
- Csevegési előzmények
- Szemantikai rangsoroló bemeneti korlátozásai
Az ügynöknek küldött kontextus szabályozása
A Responses API szabályozza, hogy mit küld a rendszer az ügynöknek és a tudásbázisnak. A teljesítmény és a relevancia optimalizálásához módosítsa az ügynök utasításait a csevegési előzmények összegzéséhez vagy szűréséhez, mielőtt elküldené azt az MCP-eszköznek.
Költségek szabályozása és műveletek korlátozása
A lekérdezési tervbe való betekintéshez tekintse meg a tudásbázis-válaszok tevékenységtömbjében található kimeneti jogkivonatokat.
A teljesítmény javítása
A teljesítmény optimalizálása és a késés csökkentése érdekében vegye figyelembe a következő stratégiákat:
Üzenetszálak összegzése.
Használjon
gpt-5-minivagy kisebb, gyorsabb teljesítményt nyújtó modellt.Állítsa be
maxOutputSizea lekérési műveletet a válasz méretének vagymaxRuntimeInSecondsaz időhöz kötött feldolgozásnak a szabályozásához.A nagyméretű dokumentumokat az indexelés előtt kisebb darabokra bontja. A kimeneti költségvetést meghaladó dokumentumok nem hagyhatók ki a megalapozott eredményekből.