Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Remarque
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Une application multilocataire est une application qui fournit les mêmes services et fonctionnalités à plusieurs locataires qui ne peuvent pas voir ni partager les données d’un autre locataire. Cet article aborde les stratégies d’isolation des locataires pour les applications multi-locataires conçues avec Azure Cognitive Search.
Concepts de la recherche Azure AI
En tant que solution SaaS (logiciel en tant que service), la recherche Azure AI permet aux développeurs d’ajouter des expériences de recherche enrichies dans les applications sans avoir à gérer d’infrastructure, ni devenir un expert en matière de récupération d’informations. Les données sont téléchargées vers le service, puis stockées dans le cloud. À l’aide de requêtes simples dans l’API de recherche Azure AI, les données peuvent ensuite être modifiées et faire l’objet de recherches.
Rechercher des services, des index, des champs et des documents
Avant d’aborder les modèles de conception, il est important de comprendre certains concepts de base.
Un service Recherche Azure AI contient un ou plusieurs index. Chaque index est une structure de données pouvant faire l’objet d’une recherche indépendante avec son propre schéma. Le schéma d’index définit les champs et les comportements de recherche pour le contenu. Vous chargez des données dans un index en tant que documents conformes au schéma de l’index.
L’indexation et les opérations de requête ciblent un index unique. Lorsqu’une application envoie une requête, Recherche Azure AI recherche l’index sélectionné et retourne des documents correspondants. Le schéma utilise les types de données de champ pris en charge par Recherche Azure AI. Lorsque les locataires partagent un index, leurs documents doivent correspondre au même schéma.
Mise à l’échelle et partitionnement géré par le service
Dans le modèle de tarification Dédié, un service Recherche Azure AI s’adapte en deux dimensions :
- Ajoutez des partitions pour augmenter la capacité de stockage et d’indexation.
- Ajoutez réplicas pour augmenter le débit des requêtes et la disponibilité.
Recherche Azure AI distribue les documents de chaque index sur les partitions du service. Les partitions de service sont des unités de capacité, et non des frontières d’isolation des locataires. Vous ne fournissez pas de clé de partition personnalisée ni ne contrôlez l’emplacement des documents sur les partitions de service. Lorsque vous ajoutez des partitions ou des réplicas, vous modifiez la capacité du service entier, qui est partagée par tous les index de ce service.
Choisissez un niveau tarifaire et une capacité en fonction des volumes prévisionnels globaux et par locataire en matière de stockage, d’indexation et de requêtes. Le niveau tarifaire définit les limites du service, des index, des documents et du stockage. Pour plus d’informations, consultez Estimer et gérer la capacité et Limites du service dans Recherche Azure AI.
Pour qu’un service dédié soit éligible au contrat SLA de disponibilité, configurez au moins deux réplicas pour les charges de travail de requête uniquement ou trois réplicas pour les charges de travail qui incluent l’indexation. Les partitions n’affectent pas l’éligibilité au SLA.
Remarque
Les conseils de partition et de réplica de cet article s’appliquent au modèle tarifaire dédié. Le niveau Développeur serverless est en préversion et gère automatiquement la capacité. Il ne fournit pas de contrat SLA et n’est pas recommandé pour les charges de travail de production.
Limites du service et de l’index dans la recherche Azure AI
Recherche Azure AI offre plusieurs niveaux tarifaires, avec différentes limites et quotas. Certaines limites s’appliquent au service, tandis que d’autres s’appliquent aux index ou aux partitions.
S3 haute densité
Standard 3 High Density (S3 HD) est un mode d’hébergement adapté aux scénarios multilocataires qui nécessitent de nombreux petits index dans un service de recherche. Elle peut réduire le coût par tenant et la surcharge opérationnelle lorsqu’un modèle d’index par tenant sert un grand nombre de tenants plus petits.
S3 HD prend en charge beaucoup plus d’index que les autres tiers Dedicated. L’ajout de partitions augmente le nombre d’index que le service peut héberger, mais chaque index a une taille maximale fixe. Avant de sélectionner ce mode, consultez les limites actuelles de S3 HD concernant les index, les fonctionnalités et les indexeurs. Pour plus d’informations, consultez les limites de service dans Recherche Azure AI.
Considérations relatives aux applications multitenant
Les applications mutualisées doivent distribuer efficacement les ressources entre les clients tout en conservant un certain niveau de confidentialité entre les différents clients. Il existe quelques considérations à prendre en compte lors de la conception de l’architecture pour ce type d’application :
Isolation des clients : les développeurs d’applications doivent prendre les mesures appropriées pour s’assurer qu’aucun client ne bénéficie d’un accès non autorisé ou non désiré aux données d’autres clients. Au-delà de la confidentialité des données, les stratégies d’isolation des clients nécessitent une gestion efficace des ressources partagées et la protection contre les voisins bruyants.
Coût des ressources cloud : comme pour toute autre application, les solutions logicielles doivent rester compétitives au niveau du coût en tant que composant d’une application mutualisée.
Facilité des opérations : lors du développement d’une architecture mutualisée, l’impact sur les opérations et la complexité de l’application est un facteur important. La recherche Azure AI bénéficie d’un Contrat de niveau de service de 99,9 %.
Empreinte globale : les applications multitenants doivent souvent servir des tenants répartis dans le monde entier. Planifiez la manière dont le placement régional, la synchronisation des données et le routage des requêtes influent sur chaque modèle multilocataire. Pour plus d’informations, consultez Déploiements multirégions dans Recherche IA Azure.
Évolutivité : les développeurs d’applications doivent trouver l’équilibre entre le fait de maintenir un niveau de complexité des applications suffisamment faible et la conception de l’application de façon à ce qu’elle évolue avec le nombre de clients, ainsi que la taille des données et la charge de travail des clients.
La recherche Azure AI propose quelques limites qui peuvent être utilisées pour isoler les données et la charge de travail des locataires.
Modélisation de la multi-location avec Recherche Azure AI
Dans le cas d’un scénario multilocataire, le développeur de l’application consomme un ou plusieurs services de recherche et répartit leurs locataires entre les services, les index ou les deux. La recherche Azure AI offre quelques modèles courants pour la modélisation d’un scénario multi-locataires :
Un index par locataire : chaque locataire a son propre index dans un service de recherche qui est partagé avec d’autres locataires.
Un service par locataire : chaque locataire possède son propre service de recherche Azure AI dédié, pour un niveau de séparation maximal entre les données et la charge de travail.
Combinaison des deux : les clients les plus volumineux et actifs se voient attribuer des services dédiés, tandis que les clients plus petits se voient attribuer des index individuels au sein de services partagés.
Un index pour plusieurs locataires : Plusieurs locataires partagent un index et chaque document inclut un identificateur de locataire que l’application utilise pour filtrer les résultats.
Modèle 1 : Un index par locataire
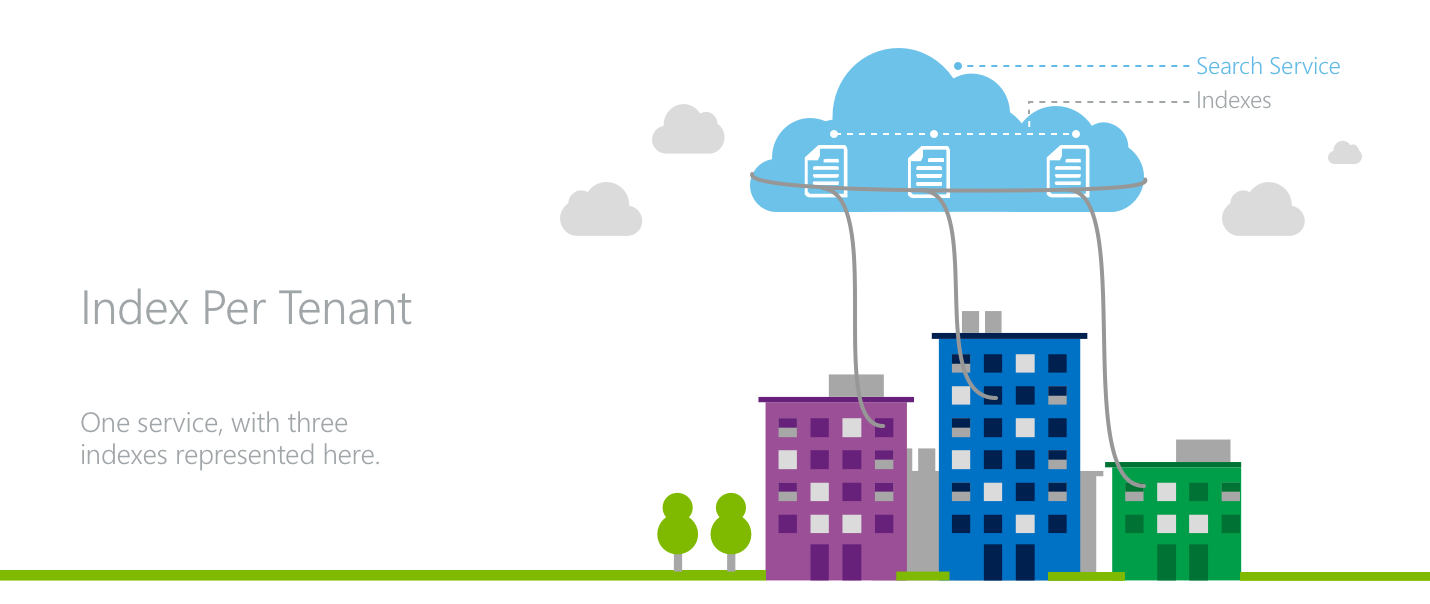
Le diagramme est intitulé « Index par locataire ». Trois bâtiments représentant des locataires apparaissent dans la moitié inférieure de l’image. Un service de recherche partagée apparaît au-dessus de ces derniers et contient trois index. Un connecteur distinct relie chaque index à un bâtiment représentant un locataire : l’index de gauche est relié au locataire de gauche, l’index central au locataire du centre et l’index de droite au locataire de droite. Une légende située dans l’angle supérieur droit identifie le nuage extérieur comme étant le service de recherche et les trois symboles de document à l’intérieur comme étant des index.
Dans un modèle d’index par locataire, plusieurs locataires occupent un seul service de recherche Azure AI où chaque locataire a son propre index.
Toutes les requêtes de recherche et les opérations sur les documents s’appliquent à un index. Toutefois, le nom d’index dans une requête n’est pas une frontière d’autorisation. Si les locataires se connectent directement à Recherche Azure AI, utilisez des rôles d’étendue d’index pour restreindre chaque locataire à son propre index. Sinon, routez les demandes via une couche Application approuvée qui dérive l’index du locataire du contexte authentifié et empêche les appelants de sélectionner l’index d’un autre locataire. Ne fournissez pas aux locataires de clés API pour un service partagé, car les clés API accordent un accès au niveau du service.
Un attribut clé du modèle d’index par client est la possibilité pour le développeur d’applications d’augmenter la capacité d’un service de recherche pour les clients de l’application. Si la répartition de la charge de travail est inégale entre les clients, la combinaison optimale des clients peut être distribuée entre les index d’un service de recherche pour prendre en charge un nombre de clients très actifs, gourmands en ressources, tout en gérant simultanément une longue file de clients moins actifs. Le compromis réside dans l’incapacité du modèle à gérer les situations où chaque client est simultanément très actif.
Le modèle d’index par locataire sert de base à un modèle de coût variable, où un service Recherche Azure AI entier est acheté en amont, puis rempli avec des locataires. Cela permet d’attribuer la capacité inutilisée aux essais et aux comptes gratuits.
Pour les applications ayant une empreinte globale, le modèle d’index par tenant n’est peut-être pas le plus efficace. Si les locataires d’une application sont répartis dans le monde entier, vous devrez peut-être disposer d’un service partagé distinct dans chaque région, ce qui entraîne une duplication de la capacité et une complexité opérationnelle accrue. Pour plus d’informations, consultez Déploiements multirégions dans Recherche IA Azure.
La recherche Azure AI permet de mettre à l’échelle les index individuels et d’augmenter le nombre total d’index. Si un niveau tarifaire approprié est choisi, des réplicas et des partitions peuvent être ajoutés au service de recherche entier lorsqu’un index individuel au sein du service devient trop important en termes de stockage ou de trafic.
Si le nombre total d’index devient trop important pour un seul service, un autre service doit être configuré pour prendre en charge les nouveaux clients. Si les index doivent être déplacés entre les services de recherche quand de nouveaux services sont ajoutés, les données de l’index doivent être copiées manuellement d’un index vers l’autre car le déplacement d’un index n’est pas autorisé dans la recherche Azure AI.
Modèle 2 : un service par locataire
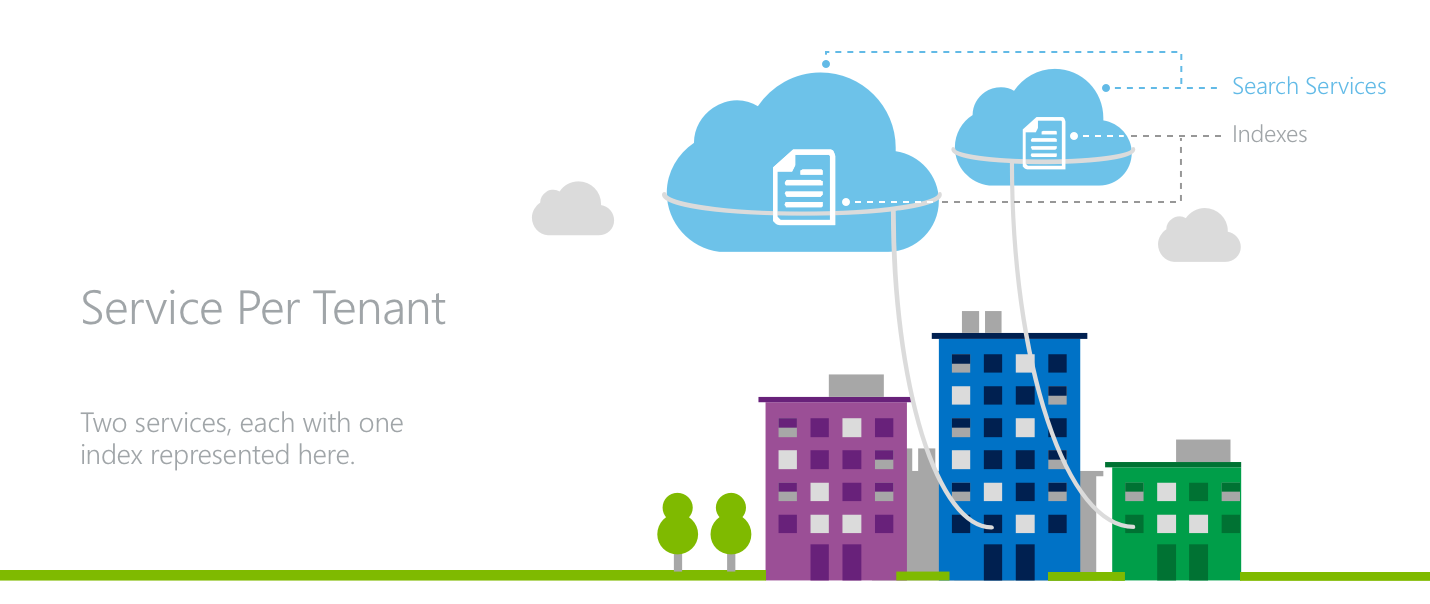
Le diagramme est intitulé « Service par locataire ». Trois bâtiments représentant des locataires apparaissent dans la moitié inférieure de l’image. Deux services de recherche apparaissent au-dessus d’eux, et chaque service contient un index. Un connecteur relie le service de recherche de gauche au bâtiment représentant le locataire de gauche. Deux connecteurs partent du service de recherche de droite : l’un vers le bâtiment représentant le locataire du centre et l’autre vers celui du locataire de droite. Une légende située dans l’angle supérieur droit identifie les nuages comme étant des services de recherche et les symboles de document à l’intérieur comme étant des index.
Dans une architecture de service par client, chaque client possède son propre service de recherche.
Dans ce modèle, l’application atteint le niveau maximal d’isolation pour ses clients. Chaque service bénéficie d’un débit et d’un stockage dédiés pour gérer les requêtes de recherche. Utilisez l’authentification avec Microsoft Entra et le contrôle d’accès en fonction du rôle pour autoriser les composants et les opérateurs d’application. Si les utilisateurs du locataire accèdent à la recherche via une couche applicative, conservez les informations d’identification du service dans cette couche et y appliquez le routage du locataire vers le service. Les clés API fournissent un accès au niveau du service et ne constituent pas des frontières d’autorisation tenant compte des locataires.
Chaque service de recherche est comptabilisé dans la limite de services applicable à son niveau tarifaire, à son abonnement et à sa région. Avant d’adopter ce modèle à grande échelle, estimez le nombre requis de services et planifiez les augmentations de quota, la distribution régionale ou plusieurs abonnements Azure.
Pour les applications où chaque locataire a une grande envergure ou si la charge de travail varie peu d’un locataire à l’autre, le modèle de service par locataire constitue un choix efficace car les ressources ne sont pas partagées entre les charges de travail de différents locataires.
Un modèle de service par client offre également l’avantage d’un modèle à coût prévisible et fixe. Il n’existe aucun investissement initial pour un service de recherche entier jusqu’à ce qu’il y ait un locataire pour le remplir. Cependant, le coût par locataire est supérieur au modèle d’index par locataire.
Le modèle de service par locataire peut prendre en charge les applications avec une empreinte globale, car le service de chaque locataire peut être placé dans une région appropriée à ce locataire. Un service de recherche est une ressource à une seule région. Utilisez donc des déploiements régionaux distincts si vous avez également besoin d’une résilience à une panne régionale. Pour plus d’informations, consultez Déploiements multirégions dans Recherche IA Azure.
Les défis liés à la mise à l’échelle de ce modèle se présentent lorsque la croissance des clients individuels surpasse celle de leur service. Les services existants peuvent basculer entre les niveaux De base et Standard S1, S2 et S3 si la configuration actuelle correspond aux limites du niveau cible et que la région a une capacité. Pour passer à un autre niveau de service, créez un nouveau service et rechargez ou copiez le contenu de l’index. Pour plus d’informations, consultez Modifier votre niveau tarifaire.
Modèle 3 : Hybride
Un autre modèle pour la modélisation mutualisée est de combiner les stratégies d’index par client et de service par client.
En mélangeant les deux modèles, les clients les plus volumineux d’une application peuvent occuper des services dédiés, tandis que la longue file de clients moins actifs et plus petits peut occuper des index dans un service partagé. Ce modèle garantit que les clients les plus volumineux bénéficient toujours de performances élevées du service tout en protégeant les clients plus petits des voisins bruyants.
Cependant, l’implémentation de cette stratégie repose sur la capacité à prévoir quels locataires nécessiteront un service dédié au lieu d’un index dans un service partagé. La complexité de l’application augmente avec la nécessité de gérer les deux modèles d’architecture mutualisée.
Conservez un catalogue de placement de locataire qui mappe chaque locataire à son service de recherche et à son index. Utilisez le catalogue pour acheminer les demandes et automatiser le provisionnement de service et d’index. Lorsque vous déplacez un tenant, coordonnez la synchronisation des données et les mises à jour de routage, et planifiez comment gérer les mappages obsolètes, les basculements ayant échoué et le retour arrière.
Modèle 4 : un index pour plusieurs tenants
Dans un modèle d’index partagé, les documents de plusieurs locataires utilisent le même index et le même schéma. Ce modèle fournit la densité de tenant la plus élevée, mais il offre moins d’isolation des données et des performances que les autres modèles. Tous les locataires partagent la capacité de l’index, son schéma et son comportement de calcul de pertinence.
Pour isoler les locataires au sein d’un même index, ajoutez un champ filtrable qui identifie le locataire propriétaire de chaque document. Une couche applicative approuvée doit déduire l’identifiant du locataire du contexte authentifié et appliquer le filtre correspondant à chaque requête. N’acceptez pas d’identifiant de locataire fourni par un client non fiable. Pour les téléversements, mises à jour et suppressions de documents, vérifiez que l’opération est autorisée pour le locataire du document. Pour plus d’informations, consultez Filtres de sécurité pour réduire les résultats.
Utilisez ce modèle lorsque la densité de locataires et l’efficacité des coûts sont plus importantes que les schémas propres à chaque locataire ou qu’une isolation stricte des charges de travail, et lorsque l’application peut appliquer de manière fiable les filtres des locataires à chaque opération.
Remarque
Lorsque plusieurs locataires partagent un index, les documents d’autres locataires peuvent affecter les scores de pertinence, car les statistiques de scoring ne sont pas limitées au locataire. Pour plus d’informations, consultez Pertinence dans la recherche de mots clés.
Étapes suivantes
La recherche Azure AI est un choix irrésistible pour de nombreuses applications. Lorsque vous évaluez les différents modèles de conception pour les applications multi-locataires, consultez les différents niveaux tarifaires et les limites de service respectives pour mieux adapter la recherche Azure AI aux architectures et aux charges de travail de toutes tailles.
Lisez cet article avec des approches architecturales pour le stockage et les données dans des solutions mutualisées, qui décrivent des considérations générales et des approches qui s’appliquent à tous les services de données.