Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
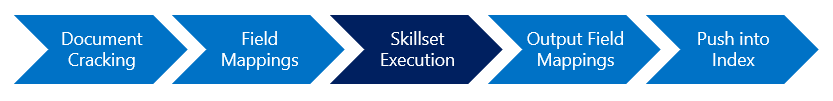
Un ensemble de compétences définit des opérations qui génèrent du contenu vectoriel et textuel et une structure à partir de documents qui contiennent des images ou du contenu brut. Par exemple, les compétences de segmentation, les compétences d’incorporation (vectorisation), la verbalisation d’image et d’autres processus tels que la reconnaissance optique de caractères (OCR) pour les images, la reconnaissance d’entité pour le texte non différentiel et la traduction de texte. Un ensemble de compétences s’exécute une fois que le contenu brut est extrait d’une source de données externe et après le traitement des mappages de champs .
Cet article explique comment créer un ensemble de compétences à l’aide des API REST, mais les mêmes concepts et étapes s’appliquent à d’autres langages de programmation.
Les règles de définition des ensembles de compétences sont les suivantes :
- Doit avoir un nom unique dans la collection d’ensembles de compétences. Un ensemble de compétences est une ressource de niveau supérieur que n’importe quel indexeur peut utiliser.
- Vous devez avoir au moins une compétence. Trois à cinq compétences sont typiques. Le maximum est de 30 compétences.
- Un ensemble de compétences peut répéter des compétences du même type. Par exemple, un ensemble de compétences peut avoir plusieurs compétences Shaper.
- Un ensemble de compétences prend en charge les opérations chaînées, le bouclage et la création de branches.
Attachez un ensemble de compétences à un indexeur. Pour utiliser l’ensemble de compétences, référencez-le dans un indexeur , puis exécutez l’indexeur pour importer des données, appeler le traitement des compétences et envoyer la sortie à un index. Un ensemble de compétences est une ressource de haut niveau, mais elle est opérationnelle uniquement au sein du traitement de l’indexeur. En tant que ressource de haut niveau, vous pouvez la référencer dans plusieurs indexeurs.
Tip
Activez la mise en cache d’enrichissement (préversion) pour réutiliser le contenu que vous avez déjà traité et réduire le coût du développement.
Ajouter une définition d’ensemble de compétences
Lorsque vous créez un ensemble de compétences, vous l’ajoutez à votre service de recherche. Lorsque vous mettez à jour un ensemble de compétences, vous remplacez entièrement un ensemble de compétences existant avec le contenu de la charge utile de la requête. Pour mettre à jour un ensemble de compétences, récupérez la définition de l’ensemble de compétences à l’aide de GET, modifiez-la, puis mettez-la à jour à l’aide de PUT.
Note
Lorsque vous récupérez un ensemble de compétences à l’aide de GET, le service retourne <redacted> toutes les valeurs dans les compétences personnalisées et httpHeaders pour n’importe ?code=<redacted> quel ?code= paramètre de requête dans le uri. Pour mettre à jour l’ensemble de compétences sans modifier ces valeurs, définissez ces champs <unchanged> dans le corps de la requête PUT. Pour plus d’informations, consultez la compétence API Web personnalisée : paramètres de compétence.
Commencez par la structure de base. Dans l’API REST Create Skillset, créez le corps de la requête au format JSON. Elle comporte les sections suivantes :
{
   "name":"skillset-template",
   "description":"A description makes the skillset self-documenting (comments aren't allowed in JSON itself)",
   "skills":[

   ],
   "cognitiveServices":{
      "@odata.type":"#Microsoft.Azure.Search.CognitiveServicesByKey",
      "description":"A Microsoft Foundry resource in the same region as Azure AI Search",
      "key":"<Your-Microsoft-Foundry-Resource-Key>"
   },
   "knowledgeStore":{
      "storageConnectionString":"<Your-Azure-Storage-Connection-String>",
      "projections":[
         {
            "tables":[ ],
            "objects":[ ],
            "files":[ ]
         }
      ]
    },
    "encryptionKey":{ }
}
Après le nom et la description, un ensemble de compétences a quatre propriétés principales :
tableau
skills, une collection de compétences non ordonnée. Les compétences sont soit autonomes, soit chaînées par le biais d'associations d'entrée-sortie, où la sortie d'une transformation devient l'entrée d'une autre. Les compétences peuvent être utilitaires (comme le fractionnement de texte), transformationnelles (basées sur l’IA à partir d’Azure OpenAI ou de Foundry Tools) ou des compétences personnalisées que vous fournissez. Vous trouverez un exemple de tableau de compétences dans la section suivante.cognitiveServicesest utilisé pour les compétences facturables qui appellent les API Foundry Tools. Supprimez cette section si vous n’utilisez pas de compétences facturables ou de recherche d’entité personnalisée. Si vous êtes dans cette situation, attachez une ressource Foundry.knowledgeStore, (facultatif) spécifie un compte Stockage Azure et les paramètres pour la projection de la sortie de l’ensemble de compétences dans des tables, des objets blob et des fichiers dans Stockage Azure. Supprimez cette section si vous n’en avez pas besoin. Sinon, spécifiez une base de connaissances.encryptionKey(facultatif) spécifie un coffre de clés Azure et des clés gérées par le client utilisées pour chiffrer le contenu sensible (descriptions, chaînes de connexion, clés) dans la définition d’un ensemble de compétences. Supprimez cette propriété si vous n’utilisez pas le chiffrement géré par le client.
Ajouter des compétences
Dans la définition d’un ensemble de compétences, le tableau de compétences spécifie les compétences à exécuter. Trois à cinq compétences sont courantes, mais vous pouvez ajouter autant de compétences que nécessaire, sous réserve des limites de service.
Le résultat final d’un pipeline d’enrichissement est un contenu textuel soit dans un index de recherche, soit dans une base de connaissances. Pour cette raison, la plupart des compétences créent du texte à partir d’images (texte OCR, légendes, balises) ou analysent le texte existant pour créer de nouvelles informations (entités, expressions clés, sentiments). Les compétences qui fonctionnent indépendamment sont traitées en parallèle. Les compétences qui dépendent les unes des autres spécifient la sortie d’une compétence (comme les expressions clés) comme l’entrée d’une deuxième compétence (telle que la traduction de texte). Le service de recherche détermine l’ordre d’exécution des compétences et l’environnement d’exécution.
Toutes les compétences ont un type, un contexte, des entrées et des sorties. Une compétence peut éventuellement avoir un nom et une description. L’exemple suivant montre deux compétences intégrées non liées afin de pouvoir comparer la structure de base.
"skills": [
    {
        "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
        "name": "#1",
        "description": "This skill detects organizations in the source content",
        "context": "/document",
        "categories": [
            "Organization"
        ],
        "inputs": [
            {
                "name": "text",
                "source": "/document/content"
            }
        ],
        "outputs": [
            {
                "name": "organizations",
                "targetName": "orgs"
            }
        ]
    },
    {
        "name": "#2",
        "description": "This skill detects corporate logos in the source files",
        "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
        "context": "/document/normalized_images/*",
        "visualFeatures": [
            "brands"
        ],
        "inputs": [
            {
                "name": "image",
                "source": "/document/normalized_images/*"
            }
        ],
        "outputs": [
            {
                "name": "brands"
            }
        ]
    }
]
Chaque compétence est unique du point de vue de ses valeurs d’entrée et des paramètres qu’elle prend. La documentation de référence d’une compétence décrit tous les paramètres et les propriétés de cette compétence. Même s’il y a des différences, la plupart des compétences partagent un ensemble commun et sont modélisées de la même façon.
Note
Vous pouvez créer des ensembles de compétences complexes, avec des boucles et des branches, à l’aide de la compétence cognitive conditionnelle pour créer des expressions. La syntaxe se base sur la notation du pointeur JSON pour les chemins, légèrement modifiée afin d’identifier les nœuds dans l’arborescence d’enrichissements. Un "/" fait passer à un niveau inférieur dans l’arborescence et "*" est utilisé comme opérateur for-each dans le contexte. De nombreux exemples de cet article illustrent la syntaxe.
Définir le contexte d’une compétence
Chaque compétence possède une propriété de contexte qui détermine le niveau auquel les opérations ont lieu. Si la propriété context n’est pas définie explicitement, la valeur par défaut est "/document", où le contexte est l’ensemble du document (la compétence est appelée une fois par document).
"skills":[
  {
    "@odata.type": "#Microsoft.Skills.Text.V3.EntityRecognitionSkill",
    "context": "/document",
    "inputs": [],
    "outputs": []
  },
  {
      "@odata.type": "#Microsoft.Skills.Vision.ImageAnalysisSkill",
      "context": "/document/normalized_images/*",
      "visualFeatures": [],
      "inputs": [],
      "outputs": []
  }
]
Définissez la context propriété sur l’un des exemples suivants :
| Exemple de contexte | Description |
|---|---|
context : /document |
(Par défaut) Les entrées et les sorties sont au niveau du document. |
context : /document/pages/* |
Certaines compétences comme l’analyse des sentiments offrent de meilleures performances sur de plus petits segments de texte. Si vous fractionnez un grand champ de contenu en pages ou en phrases, le contexte doit porter sur chaque composant. |
context : /document/normalized_images/* |
Pour le contenu d’une image, il y a une entrée et une sortie par image dans le document parent. |
Le contexte détermine également où les sorties sont produites dans l’arborescence d’enrichissement. Par exemple, la compétence Reconnaissance d’entité retourne une propriété appelée organizations, capturée comme orgs. Si le contexte est "/document", un nœud organizations est ajouté en tant qu’enfant de "/document". Si vous souhaitez ensuite référencer ce nœud dans les compétences en aval, le chemin d’accès est "/document/orgs".
Définir des entrées
Compétences en lecture et écriture dans un document enrichi. Les entrées de compétence spécifient l’origine des données entrantes. Il s’agit souvent du nœud racine du document enrichi. Pour les objets blob, une entrée de compétence classique est la propriété de contenu du document.
La documentation de référence de compétence de chaque compétence décrit les entrées qu’elle peut utiliser. Chaque entrée comporte un name qui identifie une entrée spécifique, et une source qui spécifie l'emplacement des données dans le document enrichi. L’exemple suivant provient de la compétence Reconnaissance d’entité :
"inputs": [
    {
        "name": "text",
        "source": "/document/content"
    },
    {
        "name": "languageCode",
        "source": "/document/language"
    }
]
Les compétences peuvent avoir plusieurs entrées. Le
nameest l’entrée spécifique. Pour la Reconnaissance d’entité, les entrées spécifiques sont text et languageCode.La propriété
sourcespécifie le champ ou la ligne qui fournit le contenu à traiter. Pour les compétences basées sur du texte, la source est un champ dans le document ou la ligne qui fournit du texte. Pour les compétences basées sur une image, le nœud qui fournit l’entrée est une image normalisée.Exemple de source Description source:/documentPour un jeu de données tabulaire, un document correspond à une ligne. source:/document/contentPour les objets blob, la source est généralement la propriété de contenu de l’objet blob. source:/document/some-named-fieldPour les compétences basées sur du texte, telles que la reconnaissance d’entités ou l’extraction d’expressions clés, l’origine doit être un champ qui contient suffisamment de texte à analyser, par exemple une description ou une synthèse. source:/document/normalized_images/*Pour le contenu d’image, la source est une image qui a été normalisée lors du craquage de document.
Si la compétence effectue une itération sur un tableau, le contexte et la source d’entrée doivent inclure /* dans les positions appropriées. Pour plus d’informations sur la syntaxe complète, consultez contexte de compétence et langage d’annotation d’entrée.
Définir des sorties
Chaque compétence est conçue pour émettre des types de sortie spécifiques, auxquels l’ensemble de compétences fait référence par nom. Une sortie de compétence a un name et un targetName facultatif.
La documentation de référence sur les compétences pour chaque compétence décrit les sorties qu’elle peut produire. L’exemple suivant provient de la compétence Reconnaissance d’entité :
"outputs": [
    {
        "name": "persons",
        "targetName": "people"
    },
    {
        "name": "organizations",
        "targetName": "orgs"
    },
    {
        "name": "locations",
        "targetName": "places"
    }
]
Les compétences peuvent avoir plusieurs sorties. La propriété
nameidentifie une sortie spécifique. Par exemple, pour la Reconnaissance d’entité, la sortie peut être des personnes, des emplacements, des organisations, entre autres.La
targetNamepropriété spécifie le nom que vous souhaitez que ce nœud ait dans le document enrichi. Cette propriété est utile si les sorties de compétence ont le même nom. Si plusieurs compétences retournent la même sortie, utiliseztargetNamepour la désambiguïsation des noms dans les chemins des nœuds d’enrichissement. Si vous ne spécifiez pas le nom cible, la propriété name est utilisée pour les deux.
Certaines situations demandent de référencer chaque élément d’un tableau séparément. Par exemple, vous souhaitez transmettre chaque élément de "/document/orgs" séparément à une autre compétence. Pour ce faire, ajoutez un astérisque au chemin : "/document/orgs/*".
La sortie de compétence est écrite dans le document enrichi en tant que nouveau nœud dans l’arborescence d’enrichissement. Il peut s’agir d’une valeur simple, telle qu’un score de sentiment ou un code de langage. Il peut également s’agir d’une collection, telle qu’une liste d’organisations, de personnes ou d’emplacements. La sortie des compétences peut également être une structure complexe, comme c’est le cas avec la compétence Shaper. Les entrées de la compétence déterminent la composition de la forme, mais la sortie est l’objet nommé, qui peut être référencé dans un index de recherche, une projection de magasin de connaissances ou une autre compétence par son nom.
Ajouter une compétence personnalisée
Cette section comprend un exemple de compétence personnalisée. L’URI pointe vers une fonction Azure, qui à son tour appelle le modèle ou la transformation que vous fournissez. Pour plus d’informations, consultez Ajouter une compétence personnalisée à un pipeline d’enrichissement Recherche Azure AI.
Même si la compétence personnalisée exécute du code qui est externe au pipeline. Dans un tableau de compétences, il s’agit simplement d’une autre compétence. Comme les compétences intégrées, elle a un type, un contexte, des entrées et des sorties. De plus, elle lit et écrit dans une arborescence d’enrichissement, tout comme les compétences intégrées. Notez que le champ context contient la valeur "/document/orgs/*" avec un astérisque, ce qui signifie que l’étape d’enrichissement est appelée pour chaque organisation sous "/document/orgs".
Une sortie, comme la description de l’entreprise dans cet exemple, est générée pour chaque organisation identifiée. Lorsque vous faites référence au nœud dans une étape en aval (par exemple, dans l’extraction d’expressions clés), utilisez le chemin d’accès "/document/orgs/*/companyDescription" pour le faire.
{
  "@odata.type": "#Microsoft.Skills.Custom.WebApiSkill",
  "description": "This skill calls an Azure function, which in turn calls custom code",
  "uri": "https://indexer-e2e-webskill.azurewebsites.net/api/InvokeCode?code=<YOUR-FUNCTION-KEY>",
  "httpHeaders": {
      "Ocp-Apim-Subscription-Key": "<YOUR-APIM-KEY>"
  },
  "context": "/document/orgs/*",
  "inputs": [
    {
      "name": "query",
      "source": "/document/orgs/*"
    }
  ],
  "outputs": [
    {
      "name": "description",
      "targetName": "companyDescription"
    }
  ]
}
Envoyer la sortie à une destination
Bien que vous puissiez éventuellement mettre en cache la sortie des compétences pour la réutilisation, elle est généralement temporaire et existe uniquement pendant que l’exécution des compétences est en cours.
Pour envoyer la sortie à un champ dans un index de recherche, créez un mappage de champs de sortie dans un indexeur.
Pour envoyer la sortie à une base de connaissances, créez une projection.
Pour envoyer la sortie à une compétence en aval, référencez la sortie par son nom de nœud, par exemple
"/document/organization", dans la propriété source d’entrée de la compétence en aval. Pour obtenir des exemples, consultez Référencer une annotation.
Conseils pour un premier ensemble de compétences
Essayez l’Assistant Importation de données.
L'assistant automatise plusieurs étapes qui peuvent être délicates lors de la première utilisation. Il définit l’ensemble de compétences, l’index et l’indexeur, y compris les mappages de champs et les mappages de champs de sortie. Il définit également des projections dans une base de connaissances si vous utilisez une. Pour certaines compétences, comme la reconnaissance optique de caractères ou l’analyse d’image, l’Assistant ajoute des compétences utilitaires qui fusionnent les contenus des images et du texte qui ont séparés lors du craquage des documents.
Une fois l’Assistant exécuté, vous pouvez ouvrir chaque objet dans le portail Azure pour afficher sa définition JSON.
Essayez de déboguer des sessions pour appeler l’exécution d’un ensemble de compétences sur un document cible et inspecter le document enrichi créé par l’ensemble de compétences. Vous pouvez afficher et modifier les paramètres et valeurs d’entrée et de sortie. Ce tutoriel est un bon point de départ : Tutoriel : Déboguer un ensemble de compétences à l’aide de sessions de débogage.
Étape suivante
Les champs de source d’entrée et de contexte sont des chemins de nœuds dans une arborescence d’enrichissement. Dans l’étape suivante, vous allez découvrir la syntaxe des chemins des nœuds dans une arborescence d’enrichissement.