Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
Important
Les fonctionnalités, capacités ou propriétés marquées (préversion) ne sont pas couvertes par un accord de niveau de service, ne sont pas recommandées pour les workloads de production et peuvent être modifiées ou faire l’objet de restrictions avant leur mise à disposition générale. Les Recherche Azure AI termes de la préversion s'appliquent à toutes les fonctionnalités d'aperçu, qu'il s'agisse d'une fonctionnalité autonome ou d'une partie d'une fonctionnalité généralement disponible.
Cet article explique comment ajouter la mise en cache à un pipeline d’ensemble de compétences afin de pouvoir modifier les étapes d’enrichissement en aval sans que cela suppose à chaque fois une reconstruction complète. La mise en cache de l’enrichissement (préversion) nécessite une API REST en préversion. Par défaut, un ensemble de compétences n'a pas d'état, et toute modification de sa composition nécessite une réexécution complète de l'indexeur. Avec un cache d’enrichissement, l’indexeur détermine quelles parties de l’arborescence de documents doivent être actualisées en fonction des modifications apportées à l’ensemble de compétences ou à la définition de l’indexeur. L’indexeur conserve et réutilise la sortie traitée existante si possible.
Vous placez du contenu mis en cache dans stockage Azure à l’aide d’un chaîne de connexion que vous fournissez. L’indexeur crée ces objets lorsqu’il s’exécute. Tenez compte du cache d’enrichissement d’un composant interne géré par votre service de recherche que vous ne devez pas modifier.
Important
Un cache d’enrichissement n’est pas une sauvegarde des sorties d’ensemble de compétences, de l’état de l’indexeur ou des documents indexés. Il ne suit pas les documents dont le traitement est terminé. Pour les sources de données volumineuses, consultez la section Limitations avant d’activer la mise en cache.
- Un conteneur nommé
ms-az-search-indexercache-<alpha-numeric-string> - Tables nommées
MsAzSearchIndexerCacheIndex<alpha-numeric-string>
Conditions préalables
stockage Azure pour stocker des enrichissements mis en cache. Le compte de stockage doit être universel v2.
Pour l’indexation d’objets blob uniquement, si vous avez besoin d’une suppression de document synchronisée du cache et de l’index lorsque les objets blob sont supprimés de votre source de données, activez une stratégie de suppression dans l’indexeur. Sans cette stratégie, la suppression de documents du cache n’est pas prise en charge.
Vous devez être familiarisé avec la configuration des indexeurs et des ensembles de compétences. Commencez par une vue d’ensemble de l’indexeur , puis passez aux ensembles de compétences pour en savoir plus sur les pipelines d’enrichissement.
Limitations
Attention
Si vous utilisez l'indexeur SharePoint (préversion), évitez l'enrichissement incrémentiel. Dans certaines circonstances, le cache n’est plus valide. Pour le recharger, effectuez une réinitialisation de l’indexeur et une reconstruction complète.
Les sources de données volumineuses présentent une limitation supplémentaire du cache.
Attention
Pour les sources de données volumineuses, un cache d’enrichissement peut accroître le volume total de retraitement lorsque des compétences dont l’exécution est longue, des interruptions répétées ou des échecs fréquents des compétences se produisent. L’indexeur privilégie l’exactitude plutôt que la minimisation du retraitement, de sorte qu’une accumulation dans le cache due à des interruptions répétées accentue le mécanisme de nouvelle tentative. Ce comportement est attendu, pas un bogue.
Pour effectuer une récupération à partir d’un backlog de cache croissant, partitionnez la source de données en conteneurs ou dossiers virtuels plus petits. Utilisez ensuite des indexeurs parallèles pointant vers le même index. Pour dissocier le cache, définissez la propriété cache sur null dans l’indexeur. Consultez Indexer de grands jeux de données pour obtenir des conseils sur le modèle de partitionnement.
Autorisations
Une identité Recherche Azure AI a besoin d’un accès en écriture à stockage Azure :
- Contributeur aux données Blob de stockage
- Contributeur de données de Storage Table
La syntaxe chaîne de connexion détermine si une identité affectée par le système ou affectée par l’utilisateur est utilisée. Pour plus d’informations, consultez Connect to stockage Azure using a managed identity.
Définir la propriété du cache
Utilisez cette procédure pour les indexeurs nouveaux et existants.
Dans la définition de l’indexeur, définissez cache avec :
- (Obligatoire)
storageConnectionStringdéfini sur un stockage Azure chaîne de connexion. - (Facultatif)
enableReprocessing(truepar défaut). Réglez-le surfalsepour suspendre temporairement l'enrichissement incrémentiel, puis basculez de nouveau surtrueensuite.
Sur la gauche, sélectionnez Indexeurs.
Sélectionnez Ajouter un indexeur pour créer un indexeur ou ouvrir un indexeur existant en mode d’édition JSON.
Activez l’enrichissement incrémentiel, définissez le compte de stockage du cache d’enrichissement et enregistrez l’indexeur.
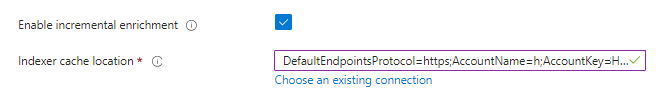
Réinitialisez l’indexeur s’il existe déjà.
Exécutez l’indexeur. Cette reconstruction complète unique initialise le cache. Une fois le chargement effectué, la réutilisation incrémentielle s’applique aux exécutions suivantes.