Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Note
Recherche Azure AI est disponible via le portail Azure, les API REST et les SDK Azure. Il sous-tend également Foundry IQ, la couche de connaissances managée qui transforme le contenu d’entreprise en bases de connaissances réutilisables et prenant en charge les autorisations pour les agents dans le portail Microsoft Foundry.
La fonctionnalité Sessions de débogage est un éditeur visuel qui fonctionne avec un ensemble de compétences existant dans le Portail Azure, en exposant la structure et le contenu d’un seul document enrichi, car il est produit par un indexeur et un ensemble de compétences pendant la durée de la session. Étant donné que vous travaillez avec un document en direct, la session est interactive. Vous pouvez identifier des erreurs, modifier et appeler l’exécution d’une compétence, et valider les résultats en temps réel. Si vos modifications résolvent le problème, vous pouvez les valider dans un ensemble de compétences publié pour appliquer les correctifs globalement.
Cet article explique les scénarios pris en charge et la façon dont l’éditeur est organisé. Les sections et les onglets de l’éditeur décompressent diverses couches de l’ensemble de compétences afin que vous puissiez examiner la structure, le flux et le contenu généré par l’ensemble de compétences au moment de l’exécution.
Scénarios pris en charge
Utilisez des sessions de débogage pour examiner et résoudre les problèmes liés aux éléments suivants :
Compétences intégrées utilisées pour l’enrichissement par IA, notamment la reconnaissance optique de caractères (OCR), l’analyse d’images, la reconnaissance d’entités et l’extraction de mots clés.
Compétences intégrées utilisées pour la vectorisation intégrée, avec segmentation des données via le fractionnement de texte et vectorisation via une compétence d’incorporation.
Compétences personnalisées utilisées pour intégrer le traitement externe que vous fournissez.
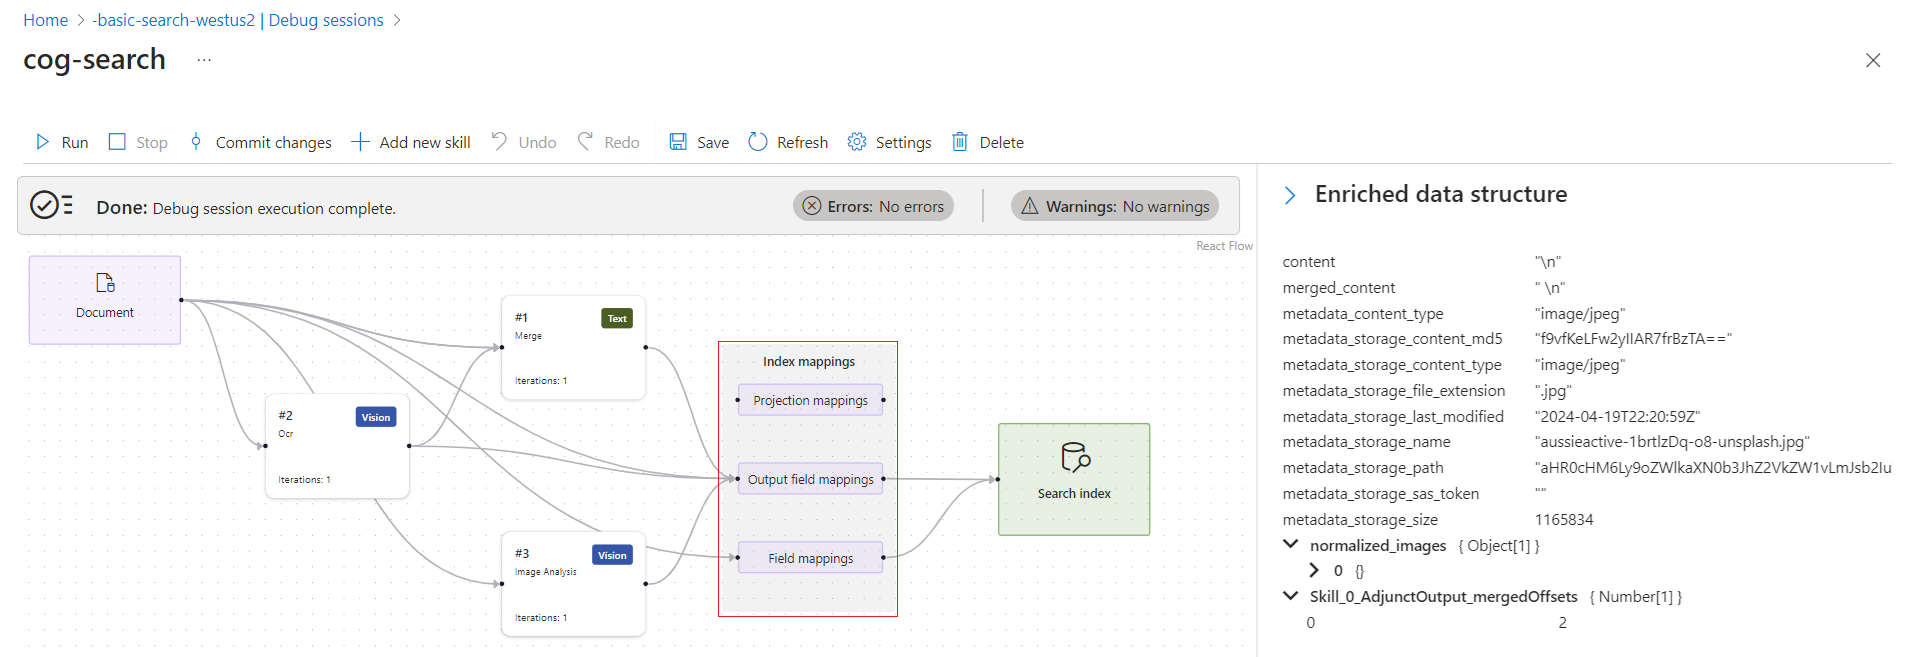
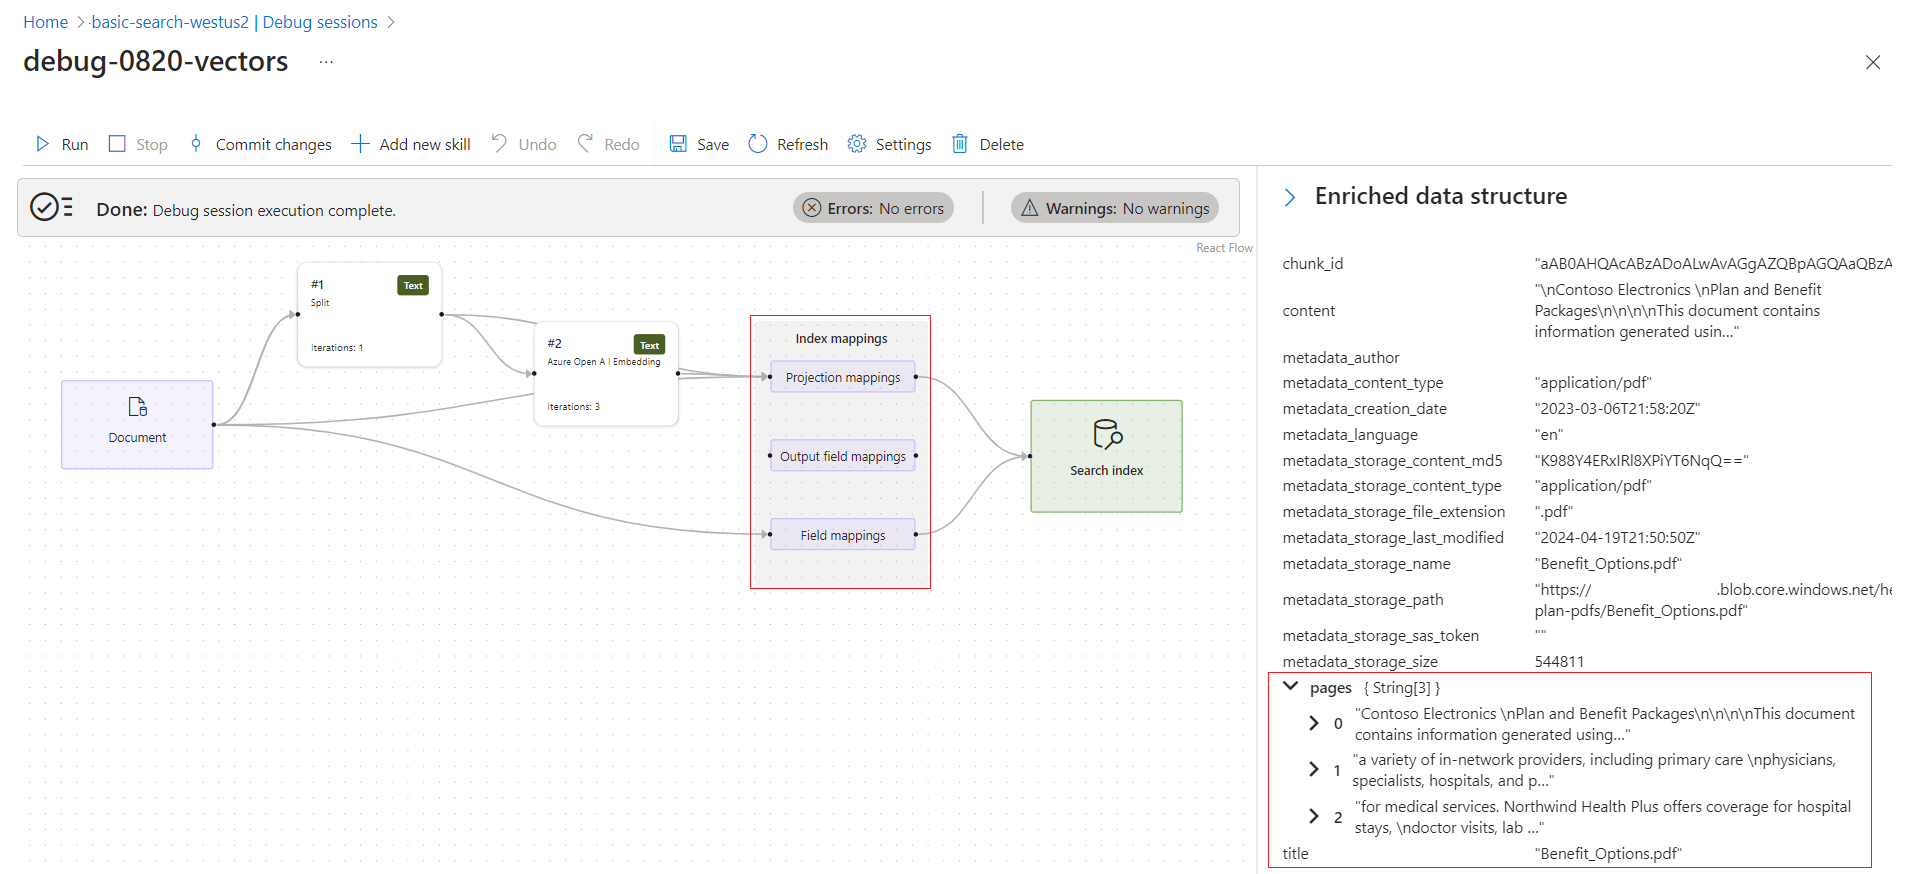
Comparez les images de session de débogage suivantes pour les deux premiers scénarios. Pour les deux scénarios, la surface montre la progression des compétences qui génèrent ou transforment du contenu du document source vers l’index de recherche. Le flux inclut des options de mappage d’index, et vous pouvez tracer les flèches pour suivre la piste de traitement. Le volet d’informations à droite tient compte du contexte. Il affiche une représentation du document enrichi créé par le pipeline, ou les détails d’une compétence ou d’un mappage.
La première image montre un modèle pour l’enrichissement par IA appliqué (aucun vecteur). Les compétences peuvent s’exécuter séquentiellement ou en parallèle en l’absence de dépendances. Les mappages d’index montrent comment le contenu enrichi ou généré passe des structures de données en mémoire aux champs d’un index. Le document enrichi affiche la structure de données créée par l’ensemble de compétences.
La deuxième image montre un modèle standard pour la vectorisation intégrée. Les compétences pour la vectorisation intégrée incluent généralement une compétence de fractionnement de texte et une compétence d’incorporation. Une compétence de fractionnement de texte divise un document en blocs. Une compétence d’incorporation appelle une API d’incorporation pour vectoriser ces blocs. Cet ensemble de compétences particulier segmente le contenu dans un tableau de « pages ». Pour la vectorisation intégrée, les mappages de projection contrôlent la façon dont les blocs sont mappés aux champs de l’index.
Limites
Les sessions de débogage fonctionnent avec toutes les sources de données d’indexeur en disponibilité générale et la plupart des sources de données en préversion, avec les exceptions suivantes :
Indexeur SharePoint.
Indexeur Azure Cosmos DB pour MongoDB.
Pour Azure Cosmos DB for NoSQL, si une ligne échoue pendant l’index et qu’il n’y a pas de métadonnées correspondantes, la session de débogage risque de ne pas choisir la ligne correcte.
Pour l’API SQL d’Azure Cosmos DB, si une collection partitionnée n’était pas partitionnée auparavant, la session de débogage ne trouvera pas le document.
Pour les compétences personnalisées, une identité managée attribuée par l’utilisateur n’est pas prise en charge pour une connexion de session de débogage au stockage Azure. Comme indiqué dans les conditions préalables, vous pouvez utiliser une identité gérée par le système ou spécifier une chaîne de connexion à accès complet qui inclut une clé. Pour plus d’informations, consultez Connecter un service de recherche à d’autres ressources Azure à l’aide d’une identité managée.
Sources de données avec chiffrement activé via des clés gérées par le client (CMK).
Les liaisons privées partagées ne sont pas prises en charge. Si votre service de recherche utilise la connectivité de point de terminaison privé pour atteindre des sources de données ou d’autres ressources, les sessions de débogage ne peuvent pas accéder à ces ressources. Pour obtenir une solution de contournement, consultez Les sessions de débogage et la connectivité privée.
Actuellement, la possibilité de sélectionner le document à déboguer n’est pas disponible. Cette limitation n’est pas permanente et devrait bientôt être levée. À ce stade, les sessions de débogage sélectionnent le premier document dans le conteneur ou le dossier de données source.
Fonctionnement d’une session de débogage
Lorsque vous démarrez une session, le service de recherche crée une copie de l’ensemble de compétences, un indexeur et une source de données contenant un document unique utilisé pour tester l’ensemble de compétences. Le service Recherche Azure AI enregistre tout l’état de session dans un nouveau conteneur d’objets blob qu’il crée dans un compte stockage Azure que vous fournissez. Le nom du conteneur généré a un préfixe de ms-az-cognitive-search-debugsession. Ce préfixe réduit le risque d’exportation accidentelle des données de session vers un autre conteneur de votre compte.
Si vous configurez la connexion du compte de stockage à l’aide d’une identité managée, attribuez le Storage Blob Data Contributor rôle à votre identité de service de recherche sur le compte de stockage. Dans votre compte de stockage, activez les services approuvés pour autoriser l’accès en écriture à partir de Recherche Azure AI.
Une copie mise en cache du document enrichi et de l’ensemble de compétences est chargée dans l’éditeur visuel pour vous permettre d’inspecter le contenu et les métadonnées du document enrichi, avec la possibilité de vérifier chaque nœud de document et de modifier tout aspect de la définition de l’ensemble de compétences. Toutes les modifications apportées au sein de la session sont mises en cache. Ces modifications n’affectent pas l’ensemble de compétences publié, sauf si vous les validez. La validation des modifications remplacera l’ensemble de compétences de production.
Si le pipeline d’enrichissement ne contient aucune erreur, une session de débogage peut être utilisée pour enrichir un document de façon incrémentielle, tester et valider chaque modification avant sa validation.
Les sessions de débogage permettent d’identifier la cause première des erreurs ou des avertissements en analysant les données, les entrées et sorties des compétences, ainsi que les mappages de champs. Utilisez le volet détails des compétences pour inspecter ce que chaque compétence reçoit en tant qu’entrée et produit en tant que sortie. Cette inspection permet de vérifier que les définitions de compétence, les expressions et les mappages de champs sont correctement formés. Si l’indexeur rencontre des problèmes de configuration, comme une configuration réseau incorrecte ou des erreurs d’accès liées aux autorisations, passez en revue le message d’erreur spécifique et la documentation liée. Pour obtenir des conseils sur la résolution des problèmes, consultez Erreurs et avertissements courants de l’indexeur.
Sessions de débogage et connectivité privée
Les sessions de débogage ne prennent pas en charge les liens privés partagés. Si votre service de recherche de production utilise une connectivité de point de terminaison privé pour accéder aux sources de données ou à d’autres ressources, les sessions de débogage ne peuvent pas s’exécuter sur ce service.
Solution de contournement : utiliser un service de recherche de test
Pour déboguer votre ensemble de compétences, créez un service de Recherche Azure AI distinct sans restrictions de connectivité privée. Pour conserver les données de production et les détails du schéma hors d’un environnement non privé, générez votre configuration de test avec des documents synthétiques :
- Créez des documents de test qui correspondent aux types de champs et à la structure de vos données de production, mais utilisez des noms de champs génériques (par exemple,
content, ,titlecategory) et des valeurs d’espace réservé au lieu de données réelles. La logique d’ensemble de compétences dépend des types de contenu et de la structure, et non des noms de champs spécifiques. - Copiez le JSON du jeu de compétences depuis votre service de production. Si les entrées de compétence référencent les noms de champs de production, mettez à jour ces références pour qu’elles correspondent à vos noms de champs de test génériques. Utilisez les correspondances de champs dans l’indexeur de test pour faire correspondre les noms des champs de test aux entrées de l’ensemble de compétences.
- Configurez un indexeur pour qu’il s’exécute sur la source de données de test.
Exécutez la session de débogage sur le service de test pour inspecter les entrées et sorties des compétences, valider les expressions de compétence et les mappages de champs et identifier les erreurs. Lorsque vos modifications sont validées, restaurez les références d’origine aux noms de champs de production dans le JSON du jeu de compétences, puis appliquez-le de nouveau à votre service de production.
Disposition de la session de débogage
La surface dans laquelle l’éditeur visuel est organisé montre la progression des opérations, en commençant par le craquage de document, suivi des compétences, des mappages et d’un index.
Sélectionnez une compétence ou un mappage pour ouvrir un volet latéral présentant des informations pertinentes.
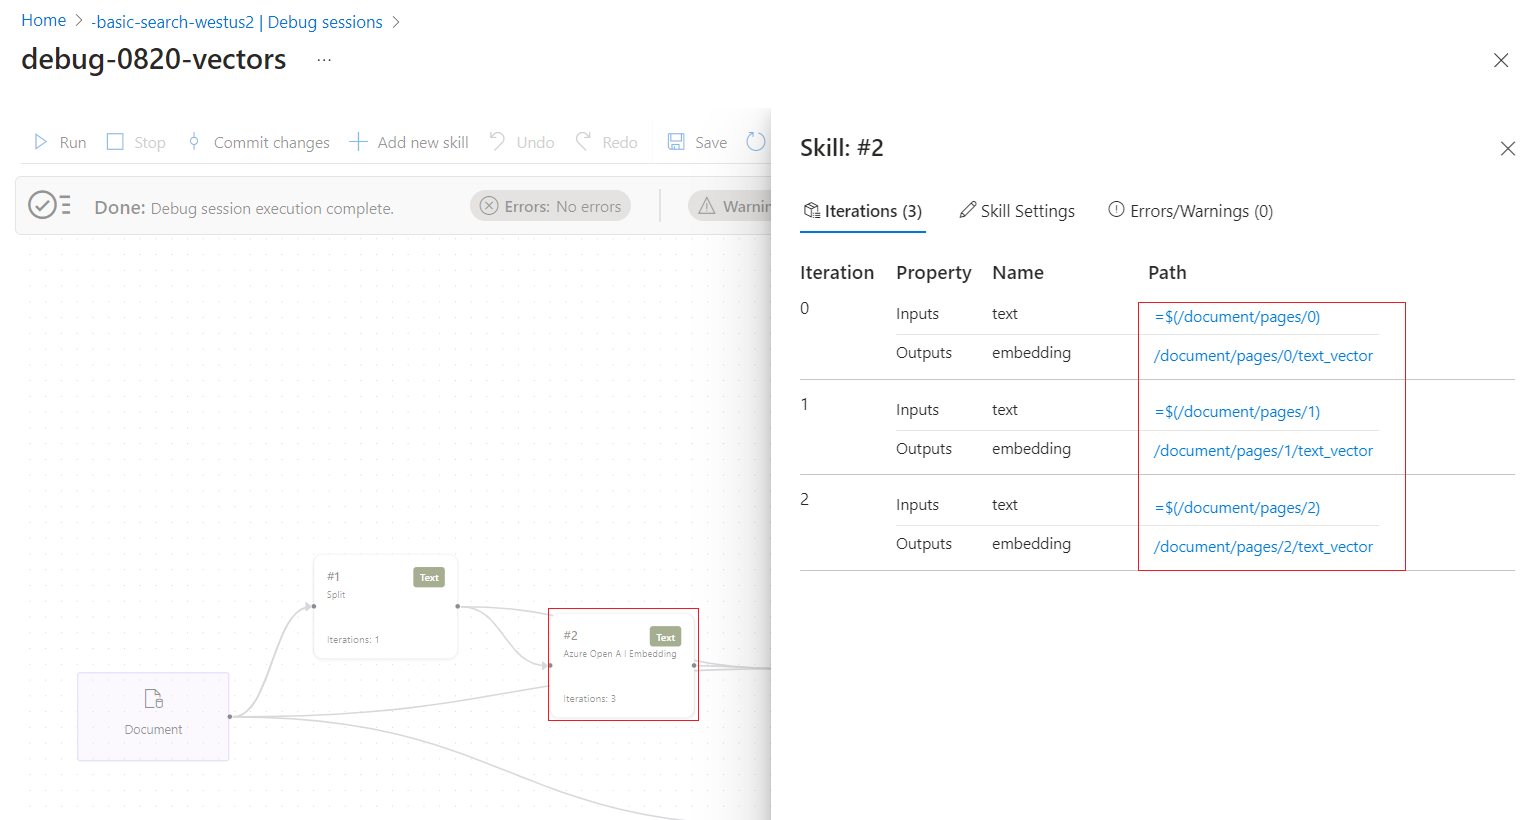
Suivez les liens pour explorer davantage le traitement des compétences. Par exemple, la capture d’écran suivante montre la sortie de la première itération de la compétence Fractionnement de texte.
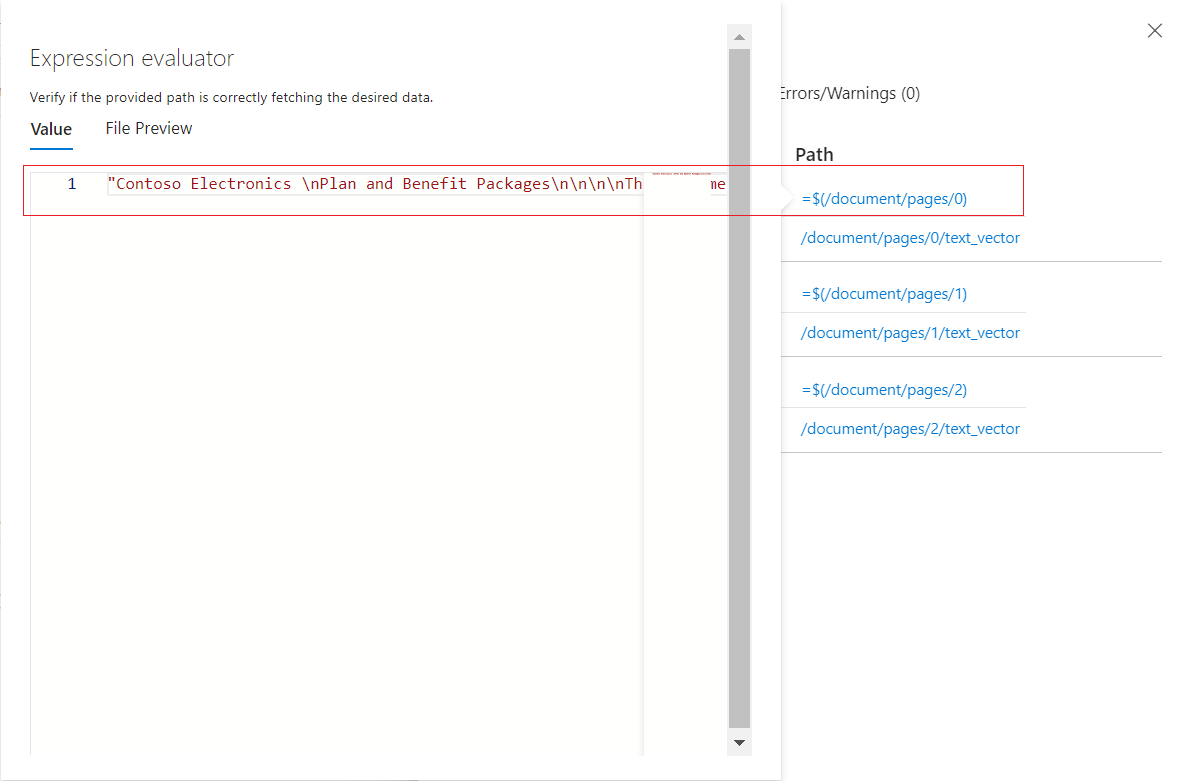
Volet d’informations sur la compétence
Le volet Détails de la compétence comprend les sections suivantes :
- Itérations : indique le nombre de fois qu’une compétence s’exécute. Vous pouvez vérifier les entrées et sorties de chacune.
- Paramètres de compétence : affichez ou modifiez la définition de l’ensemble de compétences JSON.
- Erreurs et avertissements : affiche les erreurs ou avertissements propres à cette compétence.
Volet Structure de données enrichie
Le volet Structure de données enrichie glisse sur le côté lorsque vous sélectionnez la flèche bleue Afficher ou Masquer. Il s’agit d’une représentation lisible par l’utilisateur de ce que contient le document enrichi. Les captures d’écran précédentes de cet article montrent des exemples de la structure de données enrichie.
Étapes suivantes
À présent que vous comprenez les éléments des sessions de débogage, démarrez votre première session de débogage sur un ensemble de compétences existant.