Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Note
Búsqueda de Azure AI está disponible a través del portal de Azure, las API REST y los SDK de Azure. También respalda Foundry IQ, la capa de conocimiento administrada que transforma el contenido empresarial en bases de conocimiento reutilizables y compatibles con permisos para agentes en el portal de Microsoft Foundry.
Búsqueda de Azure AI admite dos modelos de precios, cada uno diseñado para diferentes patrones de carga de trabajo:
Dedicado: Precios fijos medidos por unidades de búsqueda (SU). Seleccione un nivel de servicio y se le facturará cada hora en función de las unidades aprovisionadas.
Sin servidor (versión preliminar): precios basados en el consumo medidos por unidades de proceso por hora (CU/hr) y por GB/mes para el almacenamiento indexado.
Importante
El nivel Desarrollador sin servidor está actualmente en versión preliminar. Esta versión preliminar se ofrece sin contrato de nivel de servicio y no es aconsejable usarla en las cargas de trabajo de producción. Es posible que algunas características no se admitan o que tengan funcionalidades restringidas. Para más información, consulte Términos de uso complementarios para las versiones preliminares de Microsoft Azure.
La facturación del plan Serverless Developer comenzó el 13 de septiembre de 2026. Los cargos por el uso en o después de esa fecha aparecen en la factura de Azure. No se le cobrará por el uso antes del 13 de septiembre de 2026.
El nivel Desarrollador sin servidor no admite la migración a ni desde otros planes de tarifa y algunas características disponibles en otros niveles no se admiten durante la versión preliminar pública. Los límites de servicio, las características admitidas y los detalles de precios pueden cambiar antes de la disponibilidad general.
Durante la versión preliminar, el modelo de precios sin servidor solo se admite en regiones específicas.
Para obtener más información sobre las diferencias entre el modelo de precios y el nivel de servicio, consulte Elegir un modelo de precios y un plan de servicio.
Cómo se determina el costo en el modelo sin servidor
Los modelos de precios dedicado y sin servidor contabilizan de forma diferente el trabajo dentro del servicio de búsqueda. Los servicios dedicados ejecutan consultas, indexación y procesamiento de resultados en la capacidad aprovisionada que ya adquirió. Los servicios sin servidor miden el proceso, la memoria y la E/S de disco que consumen estas operaciones y convierten ese uso en unidades de proceso (RU). Como resultado, la optimización del rendimiento afecta directamente al costo sin servidor.
Los costos sin servidor están vinculados a la ejecución de la carga de trabajo:
- Las consultas y la indexación consumen proceso, medidos en unidades de proceso por hora (CU/h).
- Los índices activos consumen capacidad de cómputo según su consumo de recursos y el tiempo que permanecen activos.
- Un índice permanece activo durante 10 minutos después de su última consulta o solicitud de indexación antes de pasar a estar inactivo.
- Los índices inactivos no tienen ningún cargo mínimo ni reservado por recursos de proceso. El uso de cómputo de los índices inactivos se reduce a cero. No hay ningún cargo de proceso mínimo cuando un índice está inactivo.
- El almacenamiento se factura por separado en función del tamaño del índice en el disco y continúa si un índice está en uso o no.
- La recuperación agéntica consume recursos de proceso para las consultas de búsqueda y la orquestación realizadas dentro del servicio de búsqueda.
Los cargos de almacenamiento solo se detienen cuando se elimina el índice.
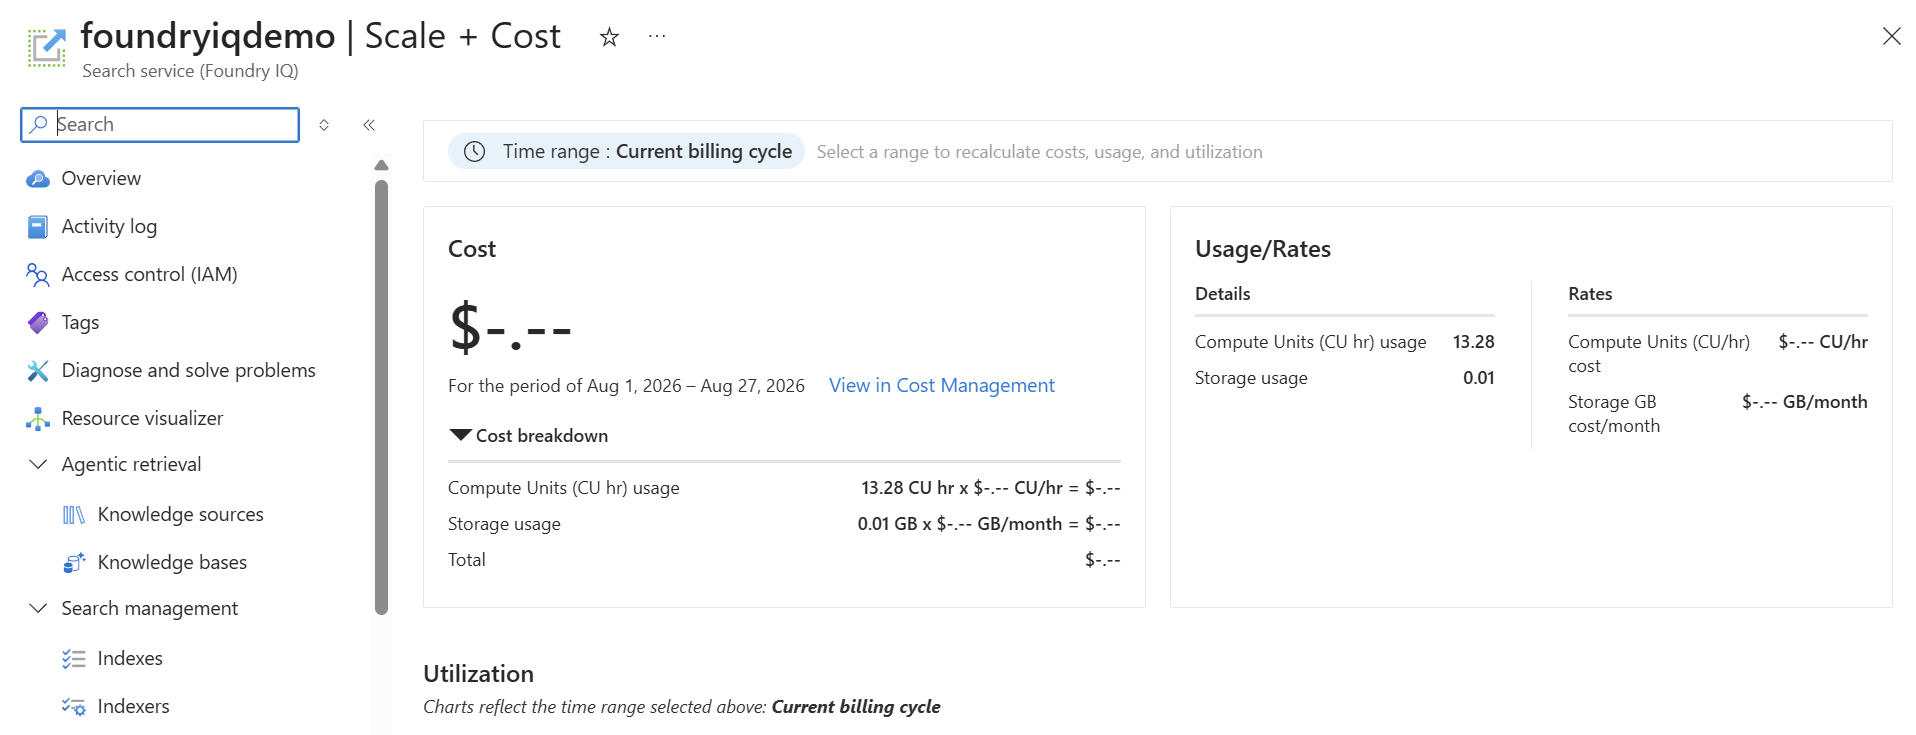
Para ver el desglose de costos y las tasas de uso del ciclo de facturación actual, consulte la pestaña Escalar y costo en el portal de Azure.
Cómo afecta el tamaño del índice al uso de cómputo
Mientras un índice está activo, Búsqueda de Azure AI evalúa dos recursos finitos para determinar su uso de proceso:
- Tamaño total del índice: el espacio total que ocupa el índice en el disco, incluidos el texto, los metadatos y los vectores.
- Tamaño del índice vectorial: la memoria usada por el índice vectorial. La memoria requiere más recursos que el disco, por lo que el tamaño del índice vectorial tiene más peso cuando se convierte a CU.
Búsqueda de Azure AI no agrega los dos importes de CU resultantes juntos. El uso de recursos de proceso se basa en la cantidad que sea mayor. Por ejemplo, el tamaño del índice vectorial puede determinar el uso de proceso incluso cuando el tamaño total del índice en el disco es relativamente pequeño.
Para reducir el uso de cómputo del índice activo, identifique qué recurso genera la mayor cantidad de CU. A continuación, reduzca el tamaño total del índice, el tamaño del índice vectorial o ambos. El almacenamiento indexado sigue siendo un cargo independiente por GB/mes.
El modelo de precios sin servidor es más rentable para las cargas de trabajo con tráfico variable, intermitente o impredecible, donde la capacidad aprovisionada estaría infrautilizada.
Importante
Los cargos por unidades de proceso (CU) sin servidor cubren el trabajo realizado dentro del servicio de búsqueda, incluidas las consultas, la indexación, el procesamiento de resultados y la coordinación de la recuperación mediante agentes. Las llamadas al modelo y otras tareas realizadas fuera del servicio de búsqueda siguen utilizando sus medidores de facturación existentes. Algunos ejemplos son la clasificación por relevancia semántica, la reescritura de consultas mediante agentes, la extracción de imágenes y la ejecución de habilidades.
Comprender las unidades de cómputo (CU)
Una unidad de proceso (CU) representa los recursos del sistema medidos necesarios para realizar operaciones de búsqueda e indexación en el modelo sin servidor. El coste de la CU viene determinado principalmente por la utilización de CPU, memoria y E/S y, en segundo lugar, por el tamaño del índice y el tamaño de la carga útil del documento; el uso se factura en unidades de cómputo por hora (CU/h).
Escalas de coste de proceso con:
- Complejidad de las consultas
- Tamaño de índice (GB) y estructura
- Tamaño de carga del documento (KB)
- Número de campos y resultados recuperados
Las distintas operaciones tienen perfiles de costo diferentes:
- Consulta: de bajo coste. Recuperar un único documento por su identificador es la operación más eficaz.
- Búsqueda de palabras clave: bajo costo. La búsqueda de texto usa índices invertidos, que están optimizados para velocidad y bajo uso de proceso.
- Búsqueda de vectores: alto costo. Las consultas vectoriales son costosas de cálculo porque requieren cálculos de similitud en incrustaciones de alta dimensión. En comparación con la búsqueda por palabras clave, consumen significativamente más capacidad de cómputo.
- Búsqueda híbrida: combina el coste de la búsqueda por palabras clave y de vectores, ya que ambos procesos se ejecutan para cada consulta, además de una pequeña sobrecarga adicional de la fusión recíproca de rangos (RRF) para combinar los resultados.
Supervisar el uso de cómputo
La supervisión del consumo de proceso le ayuda a identificar operaciones costosas, optimizar los patrones de consulta y calcular los costos. El costo de unidad de proceso (CU) de cada solicitud se devuelve en el x-ms-azs-compute-units-consumed encabezado de respuesta HTTP como un número de punto flotante. Use este encabezado para identificar operaciones costosas y optimizar los patrones de consulta. Puede realizar un seguimiento del costo de CU de cada solicitud inspeccionando los encabezados de respuesta HTTP y los eventos de operación en Azure Monitor. Para obtener más información sobre los tipos de datos de supervisión disponibles y los métodos para analizarlos, consulte Supervisar Búsqueda de Azure AI.
-
Encabezado:
x-ms-azs-compute-units-consumed: <value> - Valor: Un número de coma flotante que representa las CU consumidas.
Ejemplo:
Status: 200 OK
Content-Type: application/json
x-ms-azs-compute-units-consumed: 12.45
En este ejemplo, la solicitud consumió 12.45 unidades de proceso. Puede usar este valor para identificar operaciones de alto costo y comparar el costo relativo de diferentes patrones de consulta.
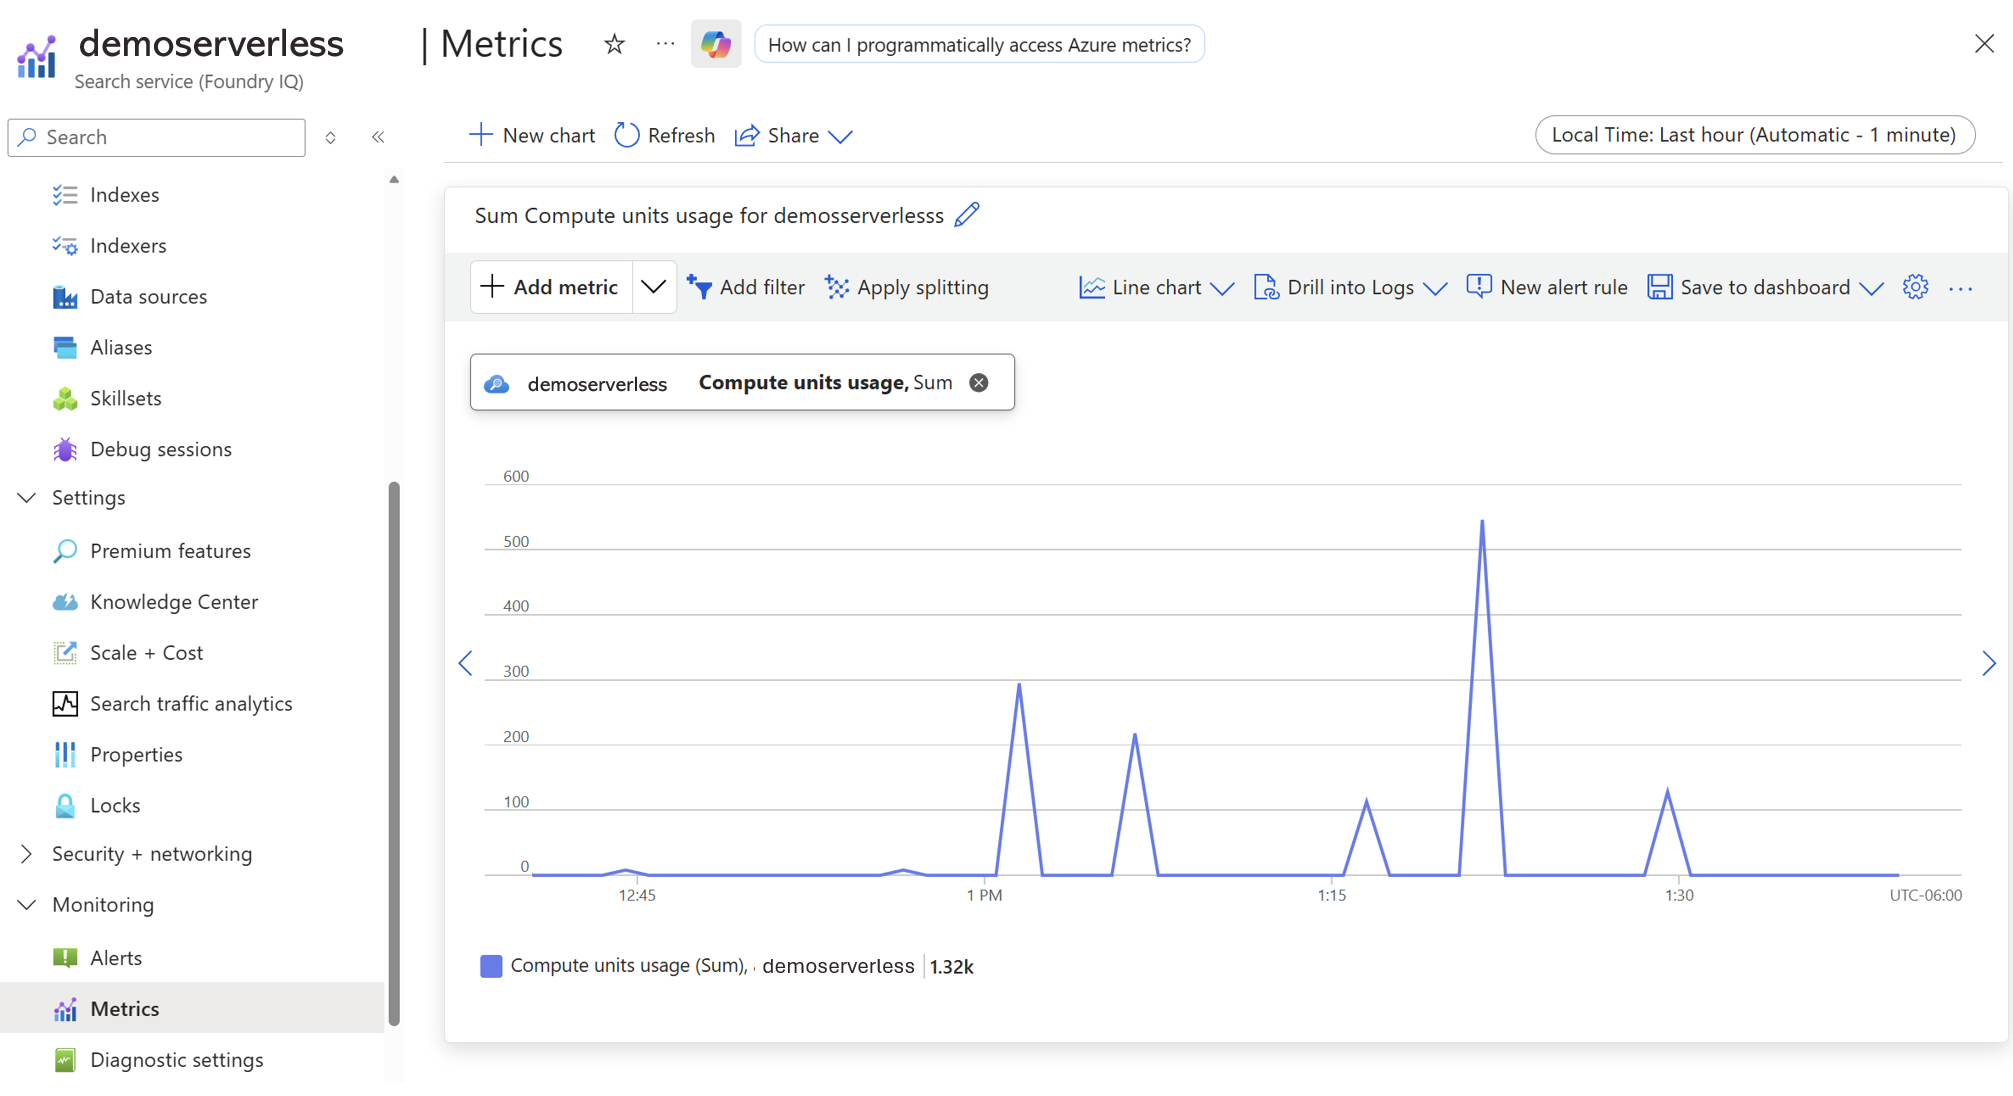
Para revisar el consumo de proceso histórico de un servicio de búsqueda sin servidor, use las métricas de Azure Monitor en el portal de Azure:
- Vaya al servicio de búsqueda.
- Seleccione Métricas.
- Seleccione + Agregar métrica.
- En la lista de métricas, seleccione Uso de unidades de proceso.
- Use el gráfico para analizar las tendencias de uso e identificar períodos de mayor consumo de proceso.
La supervisión del uso agregado le ayuda a comprender los costos generales del servicio e identificar las cargas de trabajo que consumen la mayoría de los recursos de proceso. Para obtener descripciones de las métricas de supervisión disponibles, consulte Referencia de datos de supervisión. Puede utilizar los registros de Azure Monitor para realizar un seguimiento del uso total de CU a lo largo del tiempo y correlacionarlo con el volumen de consultas y los cambios en la carga de trabajo.
Configura alertas para el uso de computación
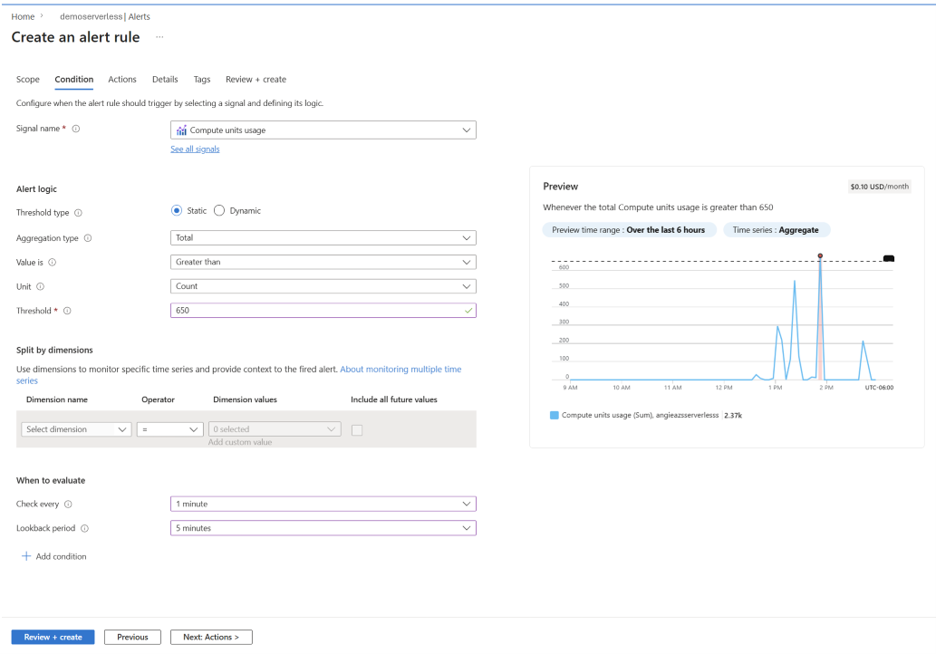
Puede crear una regla de alerta para recibir una notificación cuando el consumo de proceso alcance un umbral especificado en el portal de Azure.
- Vaya a Alertas en el servicio de búsqueda.
- Seleccione + Crear regla de alertas.
- En Condición, seleccione Uso de unidades de proceso como la señal.
- Defina la lógica de alertas. Por ejemplo, se desencadena cuando el uso total es mayor que un valor especificado.
- Configurar Acciones, como notificaciones por correo electrónico, SMS o webhook.
- Complete los pasos restantes y seleccione Revisar y crear.
Las alertas le ayudan a responder proactivamente a picos de uso inesperados y a administrar los costos.
Cálculo de los costos sin servidor
La calculadora de precios de Azure y la guía de planificación de capacidad basada en unidades de búsqueda (SU) no se aplican a los servicios que usan el modelo de precios sin servidor.
Para calcular los costos sin servidor:
- Datos de ejemplo representativos del índice.
- Ejecute cargas de trabajo típicas de indexación y consulta.
- Registre el
x-ms-azs-compute-units-consumedvalor devuelto para cada operación. - Use las métricas de Azure Monitor para medir el uso agregado a lo largo del tiempo.
- Extrapolar los costos en función del tráfico de producción esperado.
Use la pestaña Escalar y costo en el portal de Azure para ver el uso actual y calcular los costos.
Dado que la misma solicitud ejecutada con los mismos datos generalmente genera un consumo de proceso similar, las cargas de trabajo representativas pueden proporcionar una base confiable para la estimación de costos.
El uso sin servidor se mide continuamente y se agrega para la facturación. Se hace un seguimiento del consumo de cómputo durante cada minuto y solo se registra cuando se utilizan recursos de cómputo.
Al calcular los costos, use los valores de cargo de solicitud para comprender el costo de las operaciones individuales y las métricas de Azure Monitor para comprender los patrones generales de consumo de servicios.
Use ambos orígenes de datos juntos para comprender los costos: los datos de cargo por solicitud le ayudan a evaluar las operaciones individuales, mientras que las métricas de Azure Monitor ayudan a comprender el consumo agregado de servicios a lo largo del tiempo. Para obtener una imagen de costo completa, tenga en cuenta también las características que se facturan por separado de las unidades de proceso.
La facturación se basa en el uso de proceso agregado en lugar de en solicitudes individuales. El uso se mide en intervalos de un minuto y se redondea hasta los 0,25 CU más cercanos por minuto. Estos intervalos de uso de un minuto se acumulan durante una hora para determinar la cantidad facturable de CU/hora. Internamente, el uso se agrega desde milisegundos de unidades de cómputo (mCU) hasta unidades de cómputo (CU) y se convierte en el uso por hora que se comunica a efectos de facturación.
Diferentes operaciones consumen distintas cantidades de capacidad de cómputo. En general:
- Las búsquedas de palabras clave suelen usar los recursos de proceso mínimos.
- Las búsquedas vectoriales suelen usar más recursos de proceso que las búsquedas de palabras clave.
- Las búsquedas híbridas combinan la ejecución de palabra clave y búsqueda vectorial, por lo que suelen usar más recursos de proceso que cualquier técnica por sí sola.
El consumo de proceso real depende de factores como la complejidad de las consultas, el tamaño del índice, el volumen de datos, la configuración de vectores y el número de resultados devueltos. La supervisión de los cargos de solicitud y las métricas de uso agregado pueden ayudarle a identificar las oportunidades de optimización y predecir mejor los costos de producción.
Reducción de los costos de proceso a través de la optimización
Las consultas eficaces y el diseño de índices reducen el consumo de proceso y reducen los costos.
Optimización del esquema
El esquema del índice determina los costes básicos de cómputo y almacenamiento:
- Limite los atributos del campo: habilite solo los atributos (de búsqueda, filtrables, de facetas y ordenables) cuando sea necesario. Cada atributo aumenta el tamaño del índice y el costo de indexación.
- Simplificar tipos complejos: Asigne estructuras JSON anidadas a campos o colecciones sencillos siempre que sea posible.
-
Establezca retrievable=false para los campos usados solo para filtrar o solo para ordenar: si un campo se usa para filtrar u ordenar, pero no es necesario devolverlo en los resultados, manténgalo indexado y establezca
retrievable=falsepara reducir el almacenamiento en disco y el coste de almacenamiento por GB al mes. - Use campos solo recuperables siempre que sea posible: por ejemplo, los campos usados solo para mostrar (como direcciones URL de imagen) no deben ser buscables.
- Reducir dimensiones vectoriales: los vectores dimensionales superiores aumentan el costo de almacenamiento y consulta. Use modelos de inserción o cuantificación más pequeños cuando corresponda.
- Minimizar el tamaño de carga del documento antes de la indexación: los documentos más grandes cuestan más para indexar. Quite campos innecesarios, recorte texto largo y seccione HTML antes de enviar documentos al índice.
Optimización de solicitudes de indexación
La forma de enviar datos al índice afecta tanto al costo como al rendimiento:
Use lotes más grandes cuando sea posible: la indexación por lotes reduce la sobrecarga por solicitud mediante la amortización de los costos de red y procesamiento en más documentos. En general, los lotes de hasta ~1000 documentos o ~16 MB son más eficientes en cuanto a CU que muchas solicitudes pequeñas. Sin embargo, el tamaño óptimo del lote depende de la carga de trabajo. Pruebe a equilibrar el rendimiento, la latencia y la confiabilidad.
Indexar solo datos nuevos o modificados: evite la reindexación completa cuando sea posible. El envío de solo adiciones y actualizaciones reduce el número de documentos procesados, lo que reduce el costo de proceso y mejora la velocidad de ingesta.
Omitir la extracción de imágenes a menos que lo necesite: la extracción de imágenes agrega un trabajo de procesamiento adicional y puede convertirse en un controlador de costos independiente. Encienda solo para documentos o flujos de trabajo que realmente necesiten contenido de imagen.
Tenga en cuenta el crecimiento del tamaño del índice: siempre que sea posible, cree índices más pequeños. A medida que crece un índice, los costos de indexación aumentan porque se deben almacenar y mantener más datos, y las operaciones requieren más proceso. Para conjuntos de datos muy grandes, considere la posibilidad de crear particiones de datos entre varios índices para ayudar a administrar el rendimiento y los costos. Aunque los costos aumentan con el tamaño del índice, el aumento es sublineal. Los índices más grandes cuestan más por operación, pero no proporcionalmente más.
Para obtener más instrucciones, consulte Tips para mejorar el rendimiento en Búsqueda de Azure AI.
Optimización de las operaciones del indexador
El uso de capacidad de proceso del indexador sin servidor depende del trabajo realizado durante cada ejecución del indexador. En el caso de los orígenes orientados a filas, use el número de documentos procesados como indicador del volumen de carga de trabajo. Para orígenes basados en archivos, como Azure Blob Storage y Azure Data Lake Storage Gen2, supervise la cantidad de datos de origen procesados. El uso real de recursos de proceso también depende del contenido de los documentos, de la estructura del índice, del enriquecimiento y de otras operaciones de procesamiento realizadas durante la ejecución.
Para reducir el uso de recursos de procesamiento del indexador:
Usar la detección de cambios y la indexación incremental: procese solo datos nuevos o modificados en lugar de indexar repetidamente el origen de datos completo.
Ajuste adecuadamente los horarios del indexador: elija un horario que cumpla los requisitos de actualización de los datos. Utilice la telemetría de Compute Unit para evaluar el efecto de la frecuencia de programación.
Reducir el contenido innecesario del documento: quite el contenido que no es necesario indexar y excluya archivos o tipos de archivo que no sean necesarios.
Delimite cuidadosamente el alcance de las habilidades de enriquecimiento: ejecute las habilidades solo en los campos y documentos que requieran enriquecimiento, y evite generar resultados que no se utilicen posteriormente. Las habilidades facturables pueden conllevar cargos por transacción por separado.
Supervisar ejecuciones fallidas y repetidas: un indexador puede consumir recursos de proceso por el trabajo completado antes de que se produzca el fallo. Revise el historial de ejecución y el uso de la unidad de proceso para identificar errores recurrentes y patrones de reintento.
Optimización de las consultas
El diseño de consultas es un controlador principal del costo variable:
Utiliza
$selectpara limitar los campos devueltos: Esto reduce el tamaño de la carga útil y los recursos de procesamiento necesarios para la serialización.GET /docs?search=test&$select=id,title,urlUse
searchFieldspara limitar dónde se busca el texto: limite la coincidencia en tiempo de consulta a los campos que importan para el escenario. Cada campo adicional habilitado para búsqueda aumenta la carga de consulta y puede aumentar las CU/h.Utilice de manera preferente consultas de coincidencia exactas o palabras clave simples: las consultas aproximadas, con comodín, regex y de prefijo pueden forzar análisis de índice amplios y consumir significativamente más CU/h. Úselos solo cuando necesite un comportamiento de coincidencia parcial y elija consultas exactas de coincidencias o palabras clave más sencillas siempre que sea posible.
Utiliza consultas por identificador en lugar de búsquedas cuando sea posible: recuperar un documento por ID es más eficiente que ejecutar una consulta de búsqueda. Si conoce el identificador del documento, realice una consulta por identificador en lugar de una consulta de búsqueda. Las búsquedas son más eficaces porque recuperan un documento directamente mediante clave, mientras que las consultas de búsqueda invocan la canalización de consulta completa (análisis, recorrido de índice, puntuación y clasificación), lo que aumenta el costo de proceso.
Evite la paginación profunda (
$skip):los valores grandes$skipaumentan el proceso porque el motor debe procesar, puntuar y clasificar los resultados que preceden a la página solicitada. Por ejemplo,$skip=5000requiere que el motor procese al menos 5000 resultados que no se devuelven. Esta opción consume unidades de proceso adicionales (RU) y puede aumentar el costo. En su lugar, use filtros para restringir el resultadosety$toplimitar el número de resultados devueltos. Ajusta el tamaño de$toppara tu aplicación o interfaz de usuario. Aunque$topno cambia el número de documentos coincidentes que se puntuan, un valor menor reduce el número de resultados que se deben recopilar, ordenar y serializar. Solicite solo tantos resultados como necesite la aplicación y evite patrones de paginación que requieran que el motor procese un gran número de resultados sin usar.Minimizar el recuento de facetas y el ámbito de faceta: solicite solo las facetas que se muestran en la interfaz de usuario y mantenga cada valor de faceta
counttan bajo como práctico. Las facetas requieren agregaciones por consulta y los recuentos elevados aumentan el costo de proceso.Uso
search.inpara el filtrado: al filtrar por una lista de identificadores o valores, use lasearch.infunción en lugar de variasorcondiciones (por ejemplo,id eq '1' or id eq '2'). Este enfoque es más eficaz y reduce la sobrecarga de proceso. También debe evitar marcar campos de cardinalidad alta (aquellos con un gran número de valores únicos, como identificadores únicos o descripciones de texto libre) como filtrables o facetables, a menos que sea necesario, ya que esto aumenta el tamaño del índice y el costo de la consulta.
Optimización de las solicitudes administrativas
Además de las operaciones de consulta e indexación, Búsqueda de Azure AI incluye operaciones administrativas de nivel de objeto y de nivel de servicio (como recuperar esquemas de índice o estadísticas de servicio). Estas solicitudes tienen un costo plano por solicitud. Aunque cada solicitud tiene un coste bajo, las llamadas repetidas o innecesarias pueden acumularse con el tiempo y aumentar el uso total de recursos de cómputo.
- Evite las solicitudes administrativas excesivas: almacene en caché los metadatos, como los esquemas de índice, en el cliente en lugar de recuperarlos repetidamente. Por ejemplo, capturar el esquema de índice antes de que cada operación de escritura introduzca costos innecesarios. En el modelo sin servidor, este patrón aumenta directamente los cargos de proceso, mientras que en los servicios dedicados, el impacto suele ocultarse mediante la facturación por hora fija.
Optimiza los costes de vectores
Las cargas de trabajo vectoriales suelen ser el componente de mayor costo en la búsqueda del modelo de precios sin servidor porque afectan tanto a las unidades de proceso (consultas e indexación) como al almacenamiento (tamaño de vector en disco). Para reducir el costo, optimice cómo se almacenan los vectores y cómo se consultan.
Optimización del almacenamiento de vectores y el esquema
Los campos vectoriales pueden aumentar significativamente el tamaño del índice y el costo de indexación. Use las técnicas siguientes para reducir la sobrecarga de almacenamiento:
Usar compresión para reducir el tamaño del vector: aplique la cuantificación para reducir la superficie de almacenamiento con un impacto mínimo de relevancia. Por ejemplo, la cuantificación escalar puede reducir el almacenamiento de vectores hasta 4× con un impacto mínimo en la calidad de la búsqueda.
Deshabilite el almacenamiento de vectores cuando no sea necesario: establezca stored=false en los campos vectoriales si solo necesita vectores para la búsqueda, no para la recuperación. Esto evita almacenar los vectores originales en el índice, lo que reduce el costo de almacenamiento sin afectar al comportamiento de las consultas.
Use dimensiones de inserción más pequeñas cuando sea posible: los vectores dimensionales superiores aumentan el costo de almacenamiento y consulta. Para cargas de trabajo no críticas, use modelos de inserción más pequeños (por ejemplo, 384 o 768 dimensiones en lugar de 1536) para reducir el costo.
Optimización de la ejecución de consultas vectoriales
Las consultas vectoriales consumen muchos procesos porque requieren cálculos de similitud en estructuras de datos de alta dimensión.
Use la búsqueda híbrida de forma selectiva: las consultas híbridas ejecutan tanto la palabra clave como la recuperación de vectores. Use solo cuando sea necesario para la relevancia.
Reducir maxTextRecallSize para consultas híbridas: La configuración
hybridSearch.maxTextRecallSizecontrola cuántos resultados clasificados por BM25 se usan como entrada para Reciprocal Rank Fusion. El valor predeterminado es 1000 (entre 1 y 10 000). El consumo de proceso se escala aproximadamente linealmente con este valor, por lo que reducirlo es una de las palancas de costos más directas para cargas de trabajo híbridas.Los valores en torno a 500 suelen reducir significativamente el cómputo con poca pérdida de relevancia.
Reducirlo más puede hacer que se pierdan coincidencias de palabras clave que la búsqueda vectorial no detecta, como términos exactos, ID y acrónimos.
Controlar candidatos de vector por separado con k en cada consulta vectorial.
Pruebe consultas representativas y compare la relevancia, la latencia y el encabezado
x-ms-azs-compute-units-consumedantes de decidirse por un valor.Aplicar filtros antes de las consultas vectoriales: restrinja el conjunto candidato antes de la búsqueda vectorial para reducir la cantidad de datos procesados. Consulte Funcionamiento del filtrado en consultas vectoriales.
Reducir los costos al minimizar el uso
El modelo sin servidor solo cobra por los recursos consumidos. Cuando no hay solicitudes, el uso de cómputo disminuye en consecuencia.
Para minimizar los costos de uso:
- Ejecute consultas solo cuando sea necesario.
- Evite solicitudes redundantes o excesivamente frecuentes.
- Supervise el uso y ajuste las cargas de trabajo en función de la demanda.
Tip
La misma consulta puede tener diferentes perfiles de latencia y de CU según si el servicio está caliente o frío. Después de un período sin tráfico de lectura o escritura, el uso de proceso en el modelo de precios sin servidor cae a cero. La siguiente solicitud podría tener una latencia mayor y consumir más CU mientras las rutas de datos se estabilizan. Los índices más grandes suelen tardar más en calentarse que los índices más pequeños, por lo que los efectos del arranque en frío suelen ser más evidentes en los servicios de mayor tamaño.
Optimización de los costos de almacenamiento
El almacenamiento se factura por GB/mes en función del tamaño del índice en disco, que puede superar el tamaño de los datos sin procesar. Para reducir los costos de almacenamiento:
- Quite los índices sin usar.
- Minimice los campos almacenados.
- Diseñe esquemas teniendo en cuenta la sobrecarga de almacenamiento.
- Use proveedores de sugerencias de forma selectiva porque pueden aumentar drásticamente el tamaño del almacenamiento.
Para conocer las técnicas específicas de vectores (compresión, eliminación y configuración de almacenamiento), consulte Optimización para el almacenamiento y el procesamiento de vectores.
Para obtener más instrucciones sobre los inconvenientes de rendimiento de almacenamiento y consultas, consulte Tips para mejorar el rendimiento en Búsqueda de Azure AI.