Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Eine mehrinstanzenfähige Anwendung bietet an eine beliebige Anzahl von Mandanten dieselben Dienste und Funktionen, wobei diese die Daten der anderen Mandanten nicht anzeigen oder gemeinsam nutzen können. In diesem Artikel werden Mandantenisolationsstrategien für multiinstanzenfähige Anwendungen erläutert, die mit Foundry IQ (Azure KI-Suche) erstellt wurden.
Foundry IQ-Konzepte
Als Such-as-a-Service-Lösung ermöglicht Foundry IQ Entwicklern, Anwendungen umfangreiche Suchfunktionen hinzuzufügen, ohne irgendeine Infrastruktur verwalten zu müssen oder ein Experte für Information Retrieval zu werden. Daten werden in den Dienst hochgeladen und dann in der Cloud gespeichert. Mithilfe einfacher Anfragen an die Foundry IQ-API können die Daten dann geändert und durchsucht werden.
Foundry IQ-Dienste, Indizes, Felder und Dokumente
Bevor wir näher auf Entwurfsmuster eingehen, müssen Sie einige grundlegende Konzepte kennen und verstehen.
Ein Foundry IQ-Dienst enthält einen oder mehrere Indizes. Jeder Index ist eine unabhängige durchsuchbare Datenstruktur mit einem eigenen Schema. Das Indexschema definiert die Felder und Suchverhalten für den Inhalt. Sie laden Daten als Dokumente , die dem Schema des Indexes entsprechen, in einen Index.
Indizierungs- und Abfragevorgänge zielen auf einen einzelnen Index ab. Wenn eine Anwendung eine Abfrage sendet, durchsucht Foundry IQ den ausgewählten Index und gibt übereinstimmende Dokumente zurück. Das Schema verwendet die felddatentypen, die von Foundry IQ unterstützt werden. Wenn Mandanten einen Index gemeinsam nutzen, müssen ihre Dokumente demselben Schema entsprechen.
Skalierbarkeit und dienstverwaltete Partitionierung
Im Dedizierten Preismodell skaliert ein Foundry IQ Service in zwei Dimensionen:
- Fügen Sie Partitionen hinzu, um die Speicher- und Indizierungskapazität zu erhöhen.
- Fügen Sie Replikate hinzu, um den Abfragedurchsatz und die Verfügbarkeit zu erhöhen.
Foundry IQ verteilt die Dokumente in jedem Index über Dienstpartitionen. Dienstpartitionen sind Kapazitätseinheiten und keine Mandantenisolationsgrenzen. Sie stellen keinen benutzerdefinierten Partitionsschlüssel bereit oder steuern die Platzierung von Dokumenten auf Dienstpartitionen. Wenn Sie Partitionen oder Replikate hinzufügen, ändern Sie die Kapazität des gesamten Diensts, der von allen Indizes in diesem Dienst gemeinsam genutzt wird.
Wählen Sie eine Preisstufe und eine Kapazität basierend auf projiziertem aggregiertem und mandantenbezogenem Speicher, Indizierung und Abfrageworkloads aus. Die Ebene legt Dienst-, Index-, Dokument- und Speichergrenzwerte fest. Weitere Informationen finden Sie unter Kapazität schätzen und verwalten und Servicegrenzwerte in Foundry IQ.
Damit ein dedizierter Dienst die Voraussetzungen für die Verfügbarkeits-SLA erfüllt, konfigurieren Sie mindestens zwei Replikate für Nur-Abfrage-Workloads oder drei Replikate für Workloads, die die Indizierung enthalten. Partitionen wirken sich nicht auf die SLA-Berechtigung aus. Jeder Serverless-Dienst verfügt für seine gesamte Lebensdauer über eine Lese-/Schreib-SLA.
Hinweis
Die Partitions- und Replikatanleitungen in diesem Artikel gelten für das dedizierte Preismodell. Serverless verwaltet die Kapazität für Sie.
Dienst- und Indexgrenzwerte in Foundry IQ
Foundry IQ bietet mehrere Preisstufen mit unterschiedlichen Grenzwerten und Quoten. Einige Grenzwerte gelten für den Dienst, während andere für Indizes oder Partitionen gelten.
S3 Hohe Dichte
Standard 3 High Density (S3 HD) ist ein Hostingmodus, der für Multitenant-Szenarien geeignet ist, die viele kleine Indizes in einem Foundry IQ-Dienst erfordern. Sie kann die Kosten pro Mandant und den Betriebsaufwand reduzieren, wenn ein Index-pro-Mandant-Modell eine große Anzahl kleinerer Mandanten bedient.
S3 HD unterstützt wesentlich mehr Indizes als andere dedizierte Stufen. Das Hinzufügen von Partitionen erhöht die Anzahl der Indizes, die der Dienst hosten kann, aber jeder Index hat eine feste maximale Größe. Überprüfen Sie die aktuellen S3 HD-Index-, Feature- und Indexerbeschränkungen, bevor Sie diesen Modus auswählen. Weitere Informationen finden Sie unter Servicegrenzwerte in Foundry IQ.
Berücksichtigungen für mehrinstanzenfähige Anwendungen
Mehrinstanzenfähige Anwendungen müssen Ressourcen gleichmäßig den Mandanten zuteilen und für ein Maß an Datenschutz zwischen diesen sorgen. Beim Entwerfen der Architektur einer solchen Anwendung sind verschiedene Aspekte zu beachten:
Mandantenisolation: Anwendungsentwickler müssen geeignete Maßnahmen ergreifen, um sicherzustellen, dass keine Mandanten nicht autorisierten oder unerwünschten Zugriff auf die Daten anderer Mandanten haben. Abgesehen vom Datenschutz erfordern Mandantenisolierungsstrategien eine effektive Verwaltung gemeinsam genutzter Ressourcen und Schutz vor lauten Nachbarn.
Kosten für Cloudressourcen: Wie bei jeder anderen Anwendung müssen Softwarelösungen als Komponente einer mehrinstanzenfähigen Anwendung wettbewerbsfähig bleiben.
Einfacher Betrieb: Bei der Entwicklung einer Multitenant-Architektur ist die Auswirkung auf die Vorgänge und Komplexität der Anwendung ein wichtiger Aspekt. Foundry IQ hat ein SLA von 99,9 %.
Globale Präsenz: Mandantenfähige Anwendungen müssen häufig Mandanten bedienen, die auf der ganzen Welt verteilt sind. Planen Sie, wie sich regionale Platzierung, Datensynchronisierung und Anforderungsrouting auf jedes Mandantenmodell auswirken. Weitere Informationen finden Sie unter Multi-Region-Bereitstellungen in Foundry IQ.
Skalierbarkeit: Anwendungsentwickler müssen überlegen, wie sie ein Gleichgewicht finden zwischen der Aufrechterhaltung einer ausreichend geringen Anwendungskomplexität und dem Entwerfen der Anwendung so, dass sie mit der Anzahl der Mandanten und der Größe der Daten und Arbeitsauslastung von Mandanten skaliert.
Foundry IQ bietet einige Abgrenzungen, die zum Isolieren von Daten und Workload von Mandanten verwendet werden können.
Modellierung der Mandantenfähigkeit mit Foundry IQ
Im Falle eines mandantenfähigen Szenarios nutzt der Anwendungsentwickler einen oder mehrere Foundry IQ-Dienste und teilt seine Mandanten zwischen Diensten, Indizes oder beiden auf. Foundry IQ hat einige häufige Muster beim Modellieren eines Mehrinstanzenszenarios:
Ein Index pro Mandant: Jeder Mandant verfügt über einen eigenen Index in einem Foundry IQ-Dienst, der für andere Mandanten freigegeben wird.
Ein Dienst pro Mandant: Jeder Mandant verfügt über einen eigenen dedizierten Foundry IQ-Dienst, der das höchste Maß an Daten- und Workload-Trennung bietet.
Mischung aus beiden: Größere, aktivere Mandanten werden dedizierte Dienste zugewiesen, während kleineren Mandanten einzelne Indizes in gemeinsamen Diensten zugewiesen werden.
Ein Index für mehrere Mandanten: Mehrere Mandanten teilen einen Index, und jedes Dokument enthält einen Mandantenbezeichner, den die Anwendung zum Filtern von Ergebnissen verwendet.
Modell 1: Ein Index pro Mandant
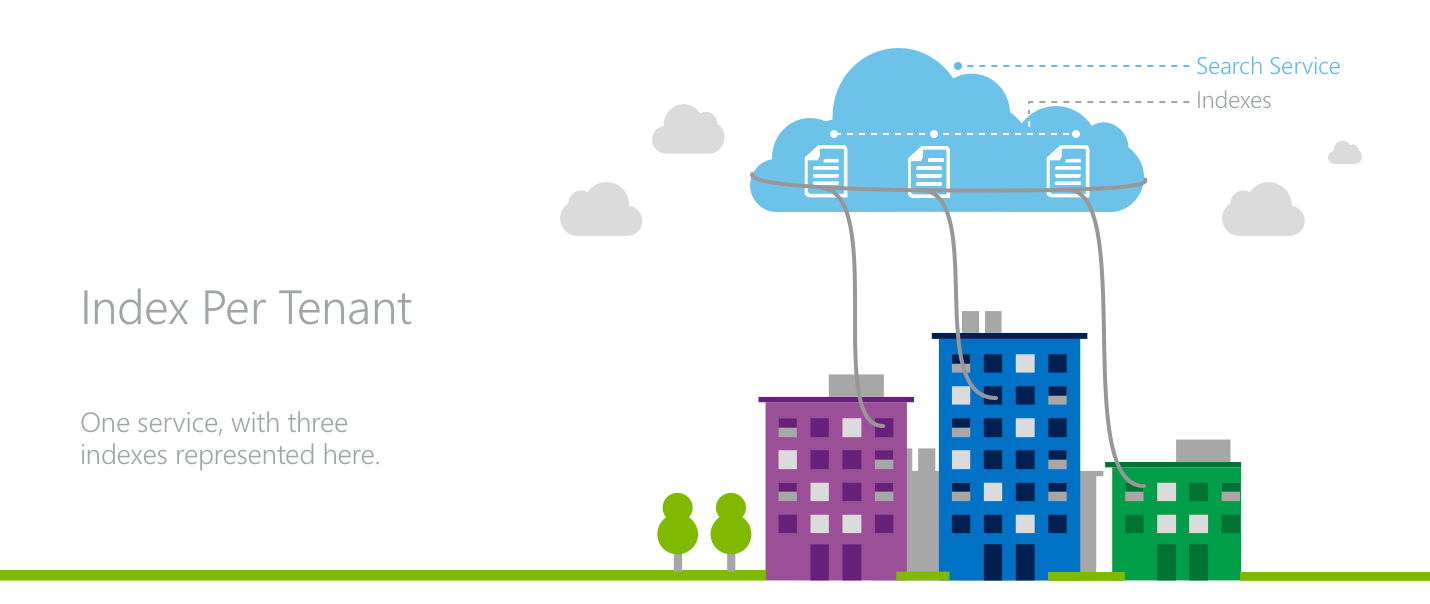
Das Diagramm ist mit „Index pro Mandant“ beschriftet. Drei Mietshäuser werden in der unteren Hälfte des Bilds angezeigt. Über ihnen erscheint ein gemeinsam genutzter Foundry IQ-Dienst, der drei Indizes enthält. Ein separater Connector erstreckt sich von jedem Index auf ein Mandantengebäude: Der linke Index stellt eine Verbindung mit dem linken Mandanten her, der Centerindex verbindet sich mit dem mittleren Mandanten, und der rechte Index stellt eine Verbindung mit dem rechten Mandanten her. Eine Legende oben rechts identifiziert die äußere Cloud als Findry IQ-Dienst und die drei Dokumentsymbole darin als Indizes.
In einem Index-pro-Mandanten-Modell belegen mehrere Mandanten einen einzigen Foundry IQ-Dienst, bei dem jeder Mandant über einen eigenen Index verfügt.
Alle Suchanforderungen und Dokumentvorgänge zielen auf einen Index ab. Der Indexname in einer Anfrage ist jedoch keine Autorisierungsgrenze. Wenn Mandanten eine direkte Verbindung mit Foundry IQ herstellen, verwenden Sie indexbezogene Rollen, um jeden Mandanten auf seinen eigenen Index zu beschränken. Andernfalls leiten Sie Anforderungen über eine vertrauenswürdige Anwendungsebene weiter, die den Index des Mandanten vom authentifizierten Kontext ableitet und verhindert, dass Anrufer den Index eines anderen Mandanten auswählen. Stellen Sie Tenants keine API-Schlüssel für einen gemeinsamen Dienst bereit, da API-Schlüssel Zugriff auf Dienstebene gewähren.
Ein wichtiges Attribut des Index-pro-Mandanten-Modells ist die Möglichkeit, dass der Anwendungsentwickler die Kapazität eines Foundry IQ-Diensts unter den Mandanten der Anwendung überschreiben kann. Wenn die Mandanten über eine ungleiche Workloadverteilung verfügen, kann die optimale Kombination von Mandanten über die Indizes eines Foundry IQ-Diensts verteilt werden, um eine Reihe von hochaktiven, ressourcenintensiven Mandanten aufzunehmen und gleichzeitig einen langen Teil weniger aktiver Mandanten zu bedienen. Der Nachteil ist die Unfähigkeit des Modells, mit Situationen klar zu kommen, bei denen alle Mandanten gleichzeitig sehr aktiv sind.
Das Index-pro-Mandant-Modell stellt die Basis für ein variables Kostenmodell bereit, bei dem ein kompletter Foundry IQ-Dienst im Voraus gekauft und anschließend mit Mandanten gefüllt wird. Dies ermöglicht, dass freie Kapazität für Tests und kostenlose Konten zur Verfügung gestellt wird.
Für Anwendungen mit globaler Verteilung ist das Index-pro-Mandant-Modell u.U. nicht das effizienteste. Wenn die Mandanten einer Anwendung auf der ganzen Welt verteilt sind, benötigen Sie möglicherweise einen separaten gemeinsamen Dienst in jeder Region, der die Kapazität dupliziert und die Betriebskomplexität erhöht. Weitere Informationen finden Sie unter Multi-Region-Bereitstellungen in Foundry IQ.
Foundry IQ ermöglicht, dass sowohl die einzelnen Indizes als auch die Gesamtanzahl der Indizes wachsen können. Wenn ein geeignetes Preisniveau ausgewählt wird, können Partitionen und Replikate dem gesamten Foundry IQ-Dienst hinzugefügt werden, wenn ein einzelner Index innerhalb des Diensts zu groß in Bezug auf Speicher oder Datenverkehr wächst.
Wenn die Gesamtanzahl der Indizes für einen einzelnen Dienst zu groß wird, muss ein anderer Dienst bereitgestellt werden, um die neuen Mandanten zu unterstützen. Wenn Indizes zwischen Foundry IQ-Diensten verschoben werden müssen, da neue Dienste hinzugefügt werden, müssen die Daten aus dem Index manuell aus einem Index in den anderen kopiert werden, da Foundry IQ nicht erlaubt, dass ein Index verschoben werden kann.
Modell 2: Ein Dienst pro Mandant
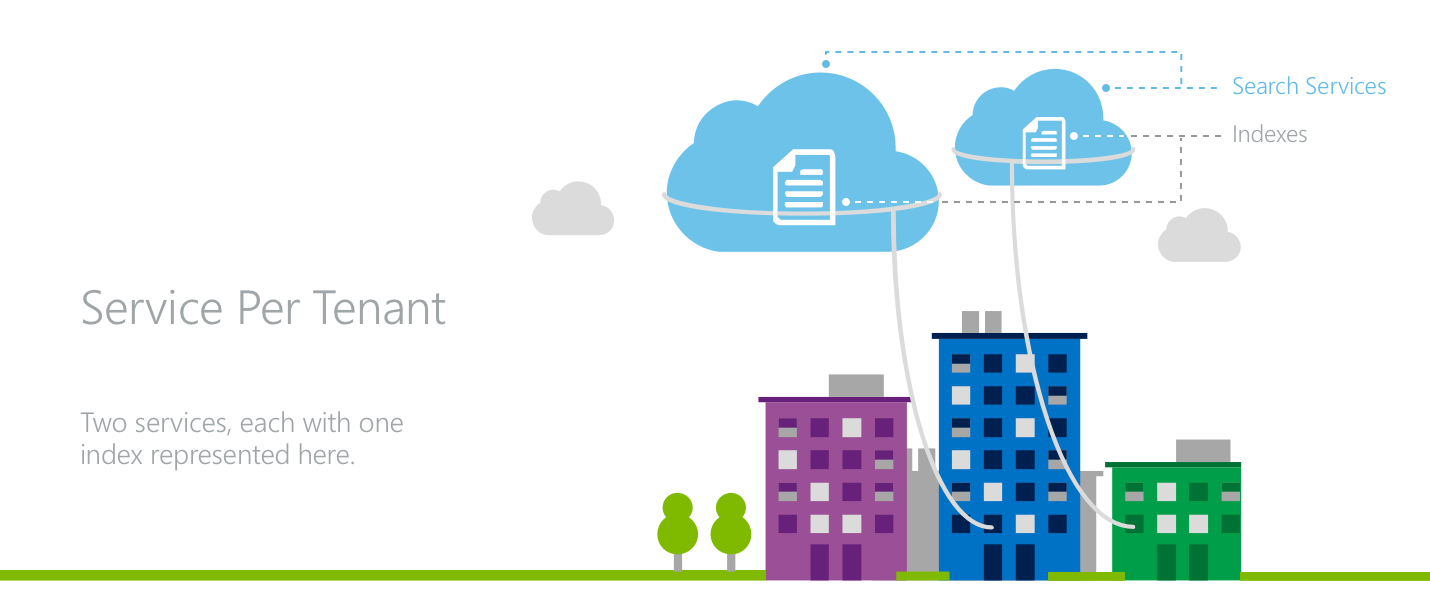
Das Diagramm ist mit „Service pro Mandant“ beschriftet. Drei Mietshäuser werden in der unteren Hälfte des Bilds angezeigt. Zwei Foundry IQ-Dienste werden darüber angezeigt, und jeder Dienst enthält einen Index. Eine Verbindung verläuft vom linken Foundry IQ-Dienst zum linken Mandantengebäude. Zwei Konnektoren reichen vom rechten Foundry IQ-Dienst aus: eines zum zentralen Mandantengebäude und eins zum rechten Mandantengebäude. Eine Legende oben rechts identifiziert die Wolken als Foundry IQ-Dienste und die Darin enthaltenen Dokumentsymbole als Indizes.
In einer Mandantenarchitektur verfügt jeder Mandant über einen eigenen Foundry IQ-Dienst.
Bei diesem Modell erzielt die Anwendung den Maximalgrad an Isolierung für die Mandanten. Jeder Dienst erhält dedizierten Speicher und Durchsatz für die Bewältigung von Suchanfragen. Verwenden Sie Microsoft Entra Authentifizierung und rollenbasierte Zugriffssteuerung, um Anwendungskomponenten und Operatoren zu autorisieren. Wenn Mandantenbenutzer über eine Anwendungsebene auf die Suche zugreifen, speichern Sie die Dienstanmeldeinformationen auf dieser Ebene und erzwingen Sie dort das Mandanten-zu-Dienst-Routing. API-Schlüssel bieten Zugriff auf Dienstebene und sind keine mandantenbezogenen Autorisierungsgrenzen.
Jeder Foundry IQ-Dienst wird auf das Dienstlimit für die Stufe, das Abonnement und die Region angerechnet. Bevor Sie dieses Modell in großem Maßstab einsetzen, schätzen Sie die erforderliche Anzahl von Diensten und planen Sie Kontingenterhöhungen, regionale Verteilung oder mehrere Azure-Abonnements.
Für Anwendungen, bei denen Mandanten weltweit verteilt sind oder sich die Workload von Mandant zu Mandant nur geringfügig unterscheidet, ist das Dienst-pro-Mandant-Modell eine geeignete Wahl, da Ressourcen zur Bewältigung der Workloads der verschiedenen Mandanten nicht gemeinsam genutzt werden.
Ein Dienst-pro-Mandant-Modell bietet außerdem den Vorteil eines vorhersagbaren, festen Kostenmodells. Es ist keine Vorabinvestition in einen gesamten Foundry IQ-Dienst erforderlich, bis es einen Mandanten gibt, der ihn auslastet. Die Kosten pro Mandant sind jedoch höher als bei einem Modell mit einem Index pro Mandant.
Das Dienst-pro-Mandant-Modell kann Anwendungen mit einem globalen Fußabdruck unterstützen, da der Dienst jedes Mandanten in einer Region platziert werden kann, die für diesen Mandanten geeignet ist. Ein Foundry IQ-Dienst ist eine Einzelregionsressource. Verwenden Sie daher separate regionale Bereitstellungen, wenn Sie auch Resilienz für einen regionalen Ausfall benötigen. Weitere Informationen finden Sie unter Multi-Region-Bereitstellungen in Foundry IQ.
Die Herausforderung bei der Skalierung dieses Musters entstehen, wenn einzelne Mandanten die Kapazitätsgrenzen ihres Diensts erreichen. Vorhandene Dienste können zwischen den Stufen Basic und Standard S1, S2 und S3 wechseln, wenn die aktuelle Konfiguration in die Grenzwerte der Zielstufe passt und in der Region Kapazität verfügbar ist. Um zu einer anderen Dienstebene zu wechseln, erstellen Sie einen neuen Service und laden Sie den Indexinhalt neu oder kopieren Sie ihn. Weitere Informationen finden Sie unter Ändern Ihres Preisniveaus.
Modell 3: Hybrid
Ein weiteres Muster für die Modellierung von Mehrinstanzenfähigkeit ist das Kombinieren des Index-pro-Mandant- und Dienst-pro-Mandant-Modells.
Durch Kombinieren der beiden Modelle können die größten Mandanten einer Anwendung dedizierte Dienste in Anspruch nehmen, während dem großen Rest weniger aktiver, kleinerer Mandanten die Indizes in einem gemeinsam genutzten Dienst zur Verfügung stehen. Dieses Modell stellt sicher, dass der Dienst den größten Mandanten stets eine hohe Leistung bietet, während zugleich die kleineren Mandaten vor einer Beeinträchtigung durch diese meist sehr aktiven Mandaten geschützt werden.
Allerdings erfordert das Umsetzen dieser Strategie Weitsicht bei der Vorhersage, welche Mandanten einen dedizierten Dienst und welche einen Index in einem gemeinsam genutzten Dienst benötigen. Die Komplexität der Anwendung erhöht sich, da zwei mehrinstanzenfähige Modelle verwaltet werden müssen.
Verwalten Sie einen Mandantenplatzierungskatalog, der jedem Mandanten seinen Foundry IQ-Dienst und -Index zuordnet. Verwenden Sie den Katalog, um Anforderungen weiterzuleiten und die Bereitstellung von Diensten und Indexen zu automatisieren. Wenn Sie einen Mandanten verschieben, müssen Sie Datensynchronisierungs- und Routingupdates koordinieren und planen, wie veraltete Zuordnungen, fehlgeschlagene Übernahmen und Rollback behandelt werden.
Modell 4: Ein Index für mehrere Mandanten
In einem gemeinsam genutzten Indexmodell verwenden Dokumente aus mehreren Mandanten denselben Index und dasselbe Schema. Dieses Modell bietet die höchste Mandantendichte, bietet jedoch weniger Daten- und Leistungsisolation als die anderen Modelle. Alle Mandanten teilen die Indexkapazität, das Schema und das Relevanzbewertungsverhalten.
Um Mandanten in einem Index zu isolieren, fügen Sie ein filterbares Feld hinzu, das den Mandanten identifiziert, der jedes Dokument besitzt. Eine vertrauenswürdige Anwendungsschicht muss den Mandantenbezeichner aus dem authentifizierten Kontext ableiten und den entsprechenden Filter auf jede Abfrage anwenden. Akzeptieren Sie keinen Mandantenbezeichner, der von einem nicht vertrauenswürdigen Client bereitgestellt wird. Überprüfen Sie bei Dokumentuploads, Aktualisierungen und Löschungen, ob der Vorgang für den Mandanten des Dokuments autorisiert ist. Weitere Informationen finden Sie unter Sicherheitsfilter zum Kürzen von Ergebnissen.
Verwenden Sie dieses Modell, wenn Mandantendichte und Kosteneffizienz wichtiger sind als mandantenspezifische Schemas oder eine starke Workloadisolation, und wenn die Anwendung Mandantenfilter für jeden Vorgang zuverlässig erzwingen kann.
Hinweis
Wenn mehrere Mandanten einen Index freigeben, können Dokumente aus anderen Mandanten Relevanzbewertungen beeinflussen, da Bewertungsstatistiken nicht mandantenbereichsbezogen sind. Weitere Informationen finden Sie unter Relevanz in der Schlüsselwortsuche.
Nächste Schritte
Foundry IQ ist eine überzeugende Wahl für viele Anwendungen. Berücksichtigen Sie bei der Auswertung der verschiedenen Entwurfsmuster für Multitenant-Anwendungen die verschiedenen Preisstufen und die jeweiligen Servicegrenzwerte, um Foundry IQ optimal auf Anwendungsworkloads und Architekturen aller Größen abzustimmen.
Lesen Sie diesen Artikel zusammen mit Architekturansätzen für Speicher und Daten in mehrinstanzenfähigen Lösungen; dort werden allgemeine Überlegungen und Ansätze beschrieben, die für verschiedene Datendienste gleichermaßen gelten.