Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Hinweis
Foundry IQ (Azure KI-Suche) bietet direkte Indizierungs- und Abfrage-APIs zusammen mit Wissensquellen- und Knowledge Base-APIs auf höherer Ebene für den verwalteten Abruf. Verwenden Sie das Azure Portal, REST-APIs oder Azure SDKs, um diese Funktionen zu konfigurieren, oder verbinden Sie Agents mit Wissensdatenbanken im Microsoft Foundry-Portal.
Die Suche über die Vielzahl von Inhaltstypen, die in Azure Blob Storage gespeichert sind, kann ein schwieriges Problem sein, aber Foundry IQ (Azure KI-Suche) bietet eine tiefe Integration auf der Inhaltsebene, das Extrahieren und Ableiten von Textinformationen, die dann in einem Suchindex abgefragt werden können.
Lesen Sie in diesem Artikel den grundlegenden Workflow zum Extrahieren von Inhalten und Metadaten aus Blobs und zum Senden dieser an einen Suchindex in Foundry IQ. Der resultierende Index kann über die Volltextsuche oder Vektorsuche abgefragt werden. Optional können Sie verarbeitete Blobinhalte für Nicht-Suchszenarien an einen Wissensspeicher senden.
Hinweis
Sie sind bereits mit dem Workflow und der Struktur vertraut? Einen BLOB-Indexer konfigurieren ist Ihr nächster Schritt.
Hinzufügen des Durchsuchens von Blobdaten
Foundry IQ ist ein eigenständiger Dienst, der Indizierungs- und Abfrageworkloads über benutzerdefinierte Indizes unterstützt, die Ihre privaten durchsuchbaren Inhalte enthalten, die in der Cloud gehostet werden. Die Zusammenstellung Ihrer durchsuchbaren Inhalte mit dem Abfragemodul in der Cloud ist aus Leistungsgründen erforderlich, damit Ergebnisse mit einer Geschwindigkeit zurückgegeben werden, die Benutzer von Suchabfragen erwarten.
Foundry IQ ist auf der Indizierungsebene in Azure Blob Storage integriert und importiert Ihren BLOB-Inhalt als Suchdokumente, die in invertierte Indizes und andere Abfragestrukturen indiziert werden, die Freiformtextabfragen, Vektorabfragen und Filterausdrücke unterstützen. Da Ihr BLOB-Inhalt in einen Suchindex indiziert wird, können Sie den vollständigen Bereich von Abfragefunktionen in Foundry IQ verwenden, um Informationen in Ihrem BLOB-Inhalt zu finden.
Als Eingaben fungieren Ihre Blobs in einem einzelnen Container in Azure Blob Storage. Blobs können aus nahezu beliebigen Arten von Textdaten bestehen. Wenn Ihre Blobs Bilder enthalten, können Sie KI-Anreicherung hinzufügen, um Text und Merkmale aus Bildern zu erstellen und zu extrahieren.
Ausgabe ist immer ein Foundry IQ Index, der für schnelle Textsuche, Abruf und Exploration in Clientanwendungen verwendet wird. Dazwischen befindet sich die Architektur der Indizierungspipeline selbst. Die Pipeline basiert auf der Indexer-Funktion, die im weiteren Verlauf dieses Artikels erläutert wird.
Nach Erstellen und Auffüllen des Indexes existiert er unabhängig von Ihrem Blobcontainer. Sie können jedoch Indizierungsvorgänge noch einmal ausführen, um Ihren Index auf Grundlage von geänderten Dokumenten zu aktualisieren. Zeitstempelinformationen zu einzelnen Blobs werden zur Erkennung von Änderungen verwendet. Sie können sich entweder für die geplante Ausführung oder die bedarfsgesteuerte Indizierung als Aktualisierungsmechanismus entscheiden.
In einer Blobsuchlösung verwendete Ressourcen
Sie benötigen Foundry IQ, Azure Blob Storage und einen Client. Foundry IQ ist in der Regel eine von mehreren Komponenten in einer Lösung, in der Ihr Anwendungscode API-Abfragen sendet und die Antwort verarbeitet. Sie können auch Anwendungscode schreiben, um die Indizierung zu verarbeiten, obgleich es für Proof of Concept-Tests und Ad-hoc-Aufgaben üblich ist, das Azure-Portal als Suchclient zu verwenden.
In Blob Storage benötigen Sie einen Container, der Quellinhalte bereitstellt. Sie können Dateieinschluss- und Ausschlusskriterien festlegen und angeben, welche Teile eines Blobs in Foundry IQ indiziert werden.
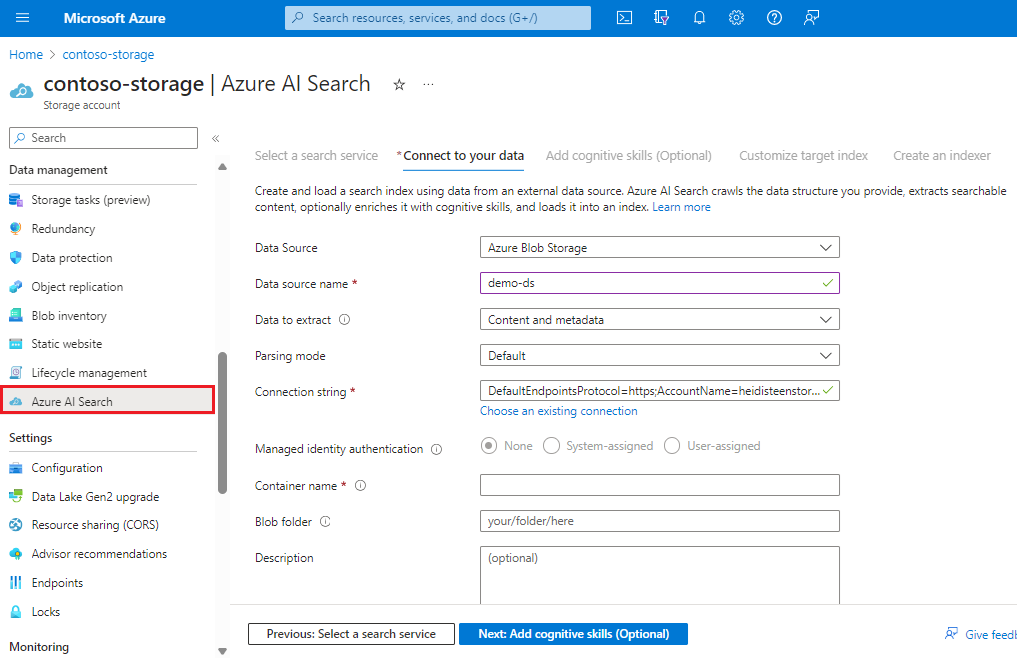
Sie können direkt auf der Portalseite des Speicherkontos beginnen.
Wählen Sie auf der linken Navigationsseite unter Datenverwaltung die Option Foundry IQ aus, um einen Foundry IQ-Dienst auszuwählen oder zu erstellen.
Verwenden Sie einen Import-Assistenten , um durchsuchbare Inhalte aus Ihren Blobs zu extrahieren und optional zu erstellen. Der Workflow erstellt einen Indexer, eine Datenquelle, einen Index und ein optionales Skillset für Ihren Foundry IQ-Dienst.
Verwenden Sie den Such-Explorer auf der Seite des Suchportals, um Ihre Inhalte abzufragen.
Der Assistent ist der beste Ausgangspunkt, aber Sie werden flexiblere Optionen entdecken, wenn Sie einen Blobindexer selbst konfigurieren. Sie können einen REST-Clientverwenden. Tutorial: Indizieren und Durchsuchen halbstrukturierter Daten (JSON-Blobs) führt Sie durch die Schritte zum Aufrufen der REST-API.
Indizieren von Blobs
Standardmäßig werden die meisten Blobs als einzelnes Suchdokument im Index indiziert, einschließlich Blobs mit strukturiertem Inhalt wie JSON oder CSV, die als einzelner Textabschnitt indiziert werden. Wenn die JSON- oder CSV-Dokumente eine interne Struktur (Trennzeichen) haben, können Sie Analysemodi so zuweisen, dass für jede Zeile oder jedes Element einzelne Suchdokumente generiert werden:
- Indizieren von JSON-Blobs
- Indizieren von CSV-Blobs
- Indizieren von Markdown-Blobs
- Indizieren von Nur-Text-Blobs
Ein Verbunddokument oder eingebettetes Dokument (z. B. ein ZIP-Archiv, ein Word-Dokument mit eingebetteter Outlook-E-Mail mit Anlagen oder eine MSG-Datei mit Anlagen) wird ebenfalls als einzelnes Dokument indiziert. So werden beispielsweise alle Bilder, die aus den Anlagen einer MSG-Datei extrahiert wurden, im Feld „normalized_images“ zurückgegeben. Wenn Sie über Bilder verfügen, sollten Sie eine KI-Anreicherung hinzufügen, um mehr Suchhilfe aus diesen Inhalten zu erhalten.
Der Textinhalt eines Dokuments wird in ein Zeichenfolgefeld mit dem Namen „content“ extrahiert. Sie können auch Standard- sowie benutzerdefinierte Metadaten extrahieren.
Hinweis
Foundry IQ legt Indexergrenzen dafür fest, wie viel Text je nach Preisniveau extrahiert wird. In der Indexerstatusantwort wird eine Warnung angezeigt, wenn Dokumente gekürzt werden.
Verwenden eines Blobindexers für die Inhaltsextraktion
Ein Indexer ist ein Datenquellen-fähiger Unterdienst in Foundry IQ, ausgestattet mit interner Logik zum Sampling von Daten, Lesen und Abrufen von Daten und Metadaten sowie Serialisieren von Daten aus systemeigenen Formaten in JSON-Dokumente für den nachfolgenden Import.
Blobs in Azure Storage werden mithilfe des Blobindexers indiziert. Sie können diesen Indexer aufrufen, indem Sie den Befehl Foundry IQ in Azure Storage, import data wizard in the Azure portal, REST API oder .NET SDK verwenden. Im Code verwenden Sie diesen Indexer, indem Sie den Typ festlegen und Verbindungsinformationen bereitstellen, die ein Azure-Speicherkonto zusammen mit einem Blobcontainer enthalten. Sie können Ihre Blobs unterteilen, indem Sie ein virtuelles Verzeichnis erstellen, das Sie dann als Parameter übergeben können, oder indem Sie nach einer Dateityperweiterung filtern.
Ein Indexer „entschlüsselt das Dokument“ und öffnet ein Blob, um den Inhalt zu untersuchen. Nach dem Herstellen einer Verbindung mit der Datenquelle ist dies der erste Schritt in der Pipeline. Bei Blobdaten werden an dieser Stelle PDF-Dateien, Office-Dokumente und andere Inhaltstypen erkannt. Die Dokumententschlüsselung mit Textextraktion erfolgt gebührenfrei. Wenn Ihre Blobs Bildinhalte enthalten, werden Bilder ignoriert, es sei denn, Sie fügen KI-Erweiterungen hinzu. Die Standardindizierung gilt nur für Textinhalte.
Der Azure-Blobindexer verfügt über Konfigurationsparameter und unterstützt die Nachverfolgung von Änderungen, wenn die zugrunde liegenden Daten genügend Informationen liefern. Weitere Informationen zur Kernfunktionalität finden Sie unter Indizieren von Daten von Azure Blob Storage.
Unterstützte Zugriffsebenen
Die Blob Storage-Zugriffsebenen lauten „Heiß“, „Kühl“, „Kalt“ und „Archiv“. Indexer können Blobs auf heißen, kühlen und kalten Zugriffsebenen abrufen.
Unterstützte Inhaltstypen
Indem Sie einen Blobindexer auf einen Container anwenden, können Sie mit einer einzigen Abfrage aus den folgenden Inhaltstypen Text und Metadaten extrahieren:
- CSV (siehe Indizierung von CSV-Blobs)
- EML
- EPUB
- GZ
- HTML
- JSON (Siehe Indizierung von JSON-Blobs)
- KML (XML für geografische Darstellungen)
- Markdown
- Microsoft Office-Formate: DOCX/DOC/DOCM, XLSX/XLS/XLSM, PPTX/PPT/PPTM, MSG (Outlook-E-Mails), XML (WORD XML 2003 und 2006)
- Öffnen von Dokumentformaten: ODT, ODS, ODP
- Textdateien (Siehe auch Indizierung von Nur-Text)
- RTF
- XML
- ZIP
Steuern, welche Blobs indiziert werden
Sie können steuern, welche Blobs indiziert und welche übersprungen werden, indem Sie den Dateityp des Blobs festlegen oder Eigenschaften für den Blob selbst so festlegen, dass der Indexer sie überspringt.
Schließen Sie bestimmte Dateierweiterungen ein, indem Sie für "indexedFileNameExtensions" eine durch Komma getrennte Liste von Dateierweiterungen (mit einem führenden Punkt) festlegen. Schließen Sie bestimmte Dateierweiterungen aus, indem Sie für "excludedFileNameExtensions" die Erweiterungen festlegen, die übersprungen werden sollen. Wenn die gleiche Erweiterung in beiden Listen vorhanden ist, wird sie von der Indizierung ausgeschlossen.
PUT /indexers/[indexer name]?api-version=2026-10-01
{
    "parameters" : {
        "configuration" : {
            "indexedFileNameExtensions" : ".pdf, .docx",
            "excludedFileNameExtensions" : ".png, .jpeg"
        }
    }
}
Hinzufügen von Metadaten zum Überspringen des Blobs
Die Konfigurationsparameter des Indexers gelten für alle Blobs im Container oder Ordner. Mitunter möchten Sie möglicherweise steuern, wie einzelne Blobs indiziert werden.
Dazu können Sie Blobs in Blob Storage die folgenden Metadateneigenschaften und -werte hinzufügen. Wenn der Indexer auf diese Eigenschaft stößt, überspringt er den Blob oder dessen Inhalt bei der Indizierungsausführung.
| Eigenschaftenname | Eigenschaftswert | Erklärung |
|---|---|---|
| „AzureSearch_Skip“ | "true" |
Weist den Blobindexer an, das Blob vollständig zu überspringen. Weder die Metadaten- noch die Inhaltsextraktion werden versucht. Dies ist nützlich, wenn ein bestimmtes Blob wiederholt fehlschlägt und den Indizierungsprozess unterbricht. |
| „AzureSearch_SkipContent“ | "true" |
Dies entspricht der "dataToExtract": "allMetadata"hier beschriebenen Einstellung, gilt aber nur für ein bestimmtes Blob. |
Indizieren der Metadaten von Blobs
Das Indizieren von benutzerdefinierten Metadaten sowie von Systemeigenschaften für jedes Blob ist ein häufig auftretendes Szenario, in dem Sie Blobs jedes Inhaltstyps unkompliziert durchsehen können. Auf diese Weise werden Informationen für alle Blobs unabhängig vom Dokumenttyp indiziert und in einem Index in Ihrem Foundry IQ-Dienst gespeichert. Mit dem neuen Index können Sie dann den gesamten Blob Storage-Inhalt sortieren und filtern sowie Facetten bilden.
Hinweis
Blobindextags werden vom Blob Storage-Dienst nativ indiziert und für Abfragen verfügbar gemacht. Wenn die Schlüssel-Wert-Attribute des Blobs Indizierungs- und Filterungsfunktionen erfordern, sollten Blobindextags anstelle von Metadaten genutzt werden.
Weitere Informationen über den Blobindex finden Sie unter Verwalten und Suchen von Daten in Azure Blob Storage mit dem Blobindex.
Durchsuchen von Blobinhalten in einem Suchindex
Die Ausgabe einer Indizierung ist ein Suchindex, der für die interaktive Untersuchung mithilfe von Freitextabfragen und gefilterten Abfragen in einer Client-App verwendet wird. Für die erste Erkundung und Überprüfung von Inhalten wird empfohlen, im Such-Explorer im Azure-Portal die Dokumentstruktur zu untersuchen. Im Such-Explorer können Sie Folgendes verwenden:
Eine dauerhaftere Lösung besteht darin, Abfrageeingaben zu sammeln und die Antwort als Suchergebnisse in einer Clientanwendung darzustellen.