Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Indexery občas narazí na problémy, které negenerují chyby nebo se vyskytují v jiných službách Azure, například při ověřování nebo při připojování. Tento článek se zaměřuje na řešení potíží s indexerem v případě, že neexistují žádné zprávy, které by vás provedou. Poskytuje také postupy řešení chyb, které pocházejí ze zdrojů jiných než vyhledávání, uplatněných během indexace.
Poznámka:
Pokud máte chybu služby Azure AI Vyhledávač, která se má prošetřit, přečtěte si téma Řešení běžných chyb a upozornění indexeru .
Osvědčené postupy
Toto jsou některé osvědčené postupy a doporučení při práci s indexery:
Indexery jsou navržené tak, aby běžely podle plánu.
- Pro spolehlivé indexování nakonfigurujte indexery tak, aby běžely podle běžného plánu. Naplánovaná spuštění automaticky vyzvednou všechny dokumenty zmeškané v předchozích spuštěních kvůli přechodným chybám, přerušením sítě nebo dočasným výpadkům služeb. Tento přístup pomáhá udržovat konzistenci dat a minimalizovat potřebu ručního zásahu.
- U velkých zdrojů dat může počáteční výčet a indexování trvat hodiny nebo dokonce dny. Spuštění indexeru podle plánu zajišťuje, že průběh pokračuje a chyby jsou automaticky opraveny. Nespoléhejte se pouze na ruční spuštění indexeru nebo jeho spouštění na vyžádání, protože tyto možnosti neposkytují stejnou úroveň spolehlivosti ani obnovu po přechodných chybách.
Indexery poskytují indexování s maximální snahou v průběhu času.
- Integrované indexery zpracovávají dokumenty bez trvalých chyb a opakují pokusy při plánovaných spuštěních. Nabízejí pohodlný, nízkokódový nebo žádný způsob indexování dat pro běžné scénáře, což umožňuje rychlejší vývoj a snadnější údržbu. Když indexer spustí sadu dovedností, každé spuštění má pevný časový limit spuštění. Indexery spuštěné v prostředí s více tenanty mají dvouhodinovou maximální dobu běhu. Tento limit je nejběžnějším případem, kdy sady dovedností nevyžadují sdílené privátní propojení. Indexery nakonfigurované pro použití sdílených privátních odkazů běží v privátním spouštěcím prostředí s maximální dobou běhu 24 hodin. Úplnou tabulku najdete v tématu Omezení indexeru. Pokud zpracování sady dovedností pro jednotlivé dokumenty zabrání indexeru dokončit před časovým limitem, zastaví se a ponechá zbývající dokumenty nezpracované. Úplné zpracování není zaručeno, když svazek dokumentu, velikost souboru, složitost sady dovedností nebo spouštěcí prostředí zabrání indexeru dokončit během maximální doby běhu. Dělení zdroje dat může toto riziko snížit, ale neodstraní ho, zejména pokud později do oddílu přidáte velké objemy souborů. Toto chování je očekávané. Strategie pro správu velkých datových sad a podporu přírůstkové obnovy najdete v tématech Indexování velkých datových sad a Plánování indexerů. Pokud vaše řešení vyžaduje přísnou kontrolu nad tím, kdy indexer zpracovává dokumenty, použijte alternativu rozhraní PUSH API v tomto článku.
- Pokud vaše řešení vyžaduje striktní kontrolu nad časováním indexování, použijte místo toho Push API, například rozhraní API pro index dokumentů REST nebo metodu IndexDocuments (Azure SDK pro .NET). Tyto možnosti poskytují úplnou kontrolu nad kanálem indexování.
- Indexy můžou občas vypadnout z plánu. I když je tato podmínka neobvyklá a existují mechanismy automatického obnovení, obnovení může nějakou dobu trvat. Toto chování je očekávané.
Řešení problémů s připojením k omezeným zdrojům
U zdrojů dat v rámci zabezpečení sítě Azure jsou indexery omezené tím, jak se připojení vytváří. Indexery v současné době můžou přistupovat k omezeným zdrojům dat za bránou firewall protokolu IP nebo ve virtuální síti prostřednictvím privátního koncového bodu pomocí sdíleného privátního propojení.
Chyba při připojování k prostředku Microsoft Foundry v privátním připojení
Pokud se zobrazí kód chyby 403 s následující zprávou, může být problém s tím, jak je koncový bod prostředku zadaný v sadě dovedností:
"A Virtual Network is configured for this resource. Please use the correct endpoint for making requests. Check https://aka.ms/cogsvc-vnet for more details."
K této chybě dochází v případě, že jste nakonfigurovali sdílené privátní propojení pro připojení k prostředku Azure Foundry a v koncovém bodu chybí vlastní subdoména. Vlastní subdoména je první částí koncového bodu (například http://my-custom-subdomain.services.ai.azure.com). Pokud jste prostředek vytvořili na portálu Foundry místo webu Azure Portal, může chybět vlastní doména.
Pokud prostředek Foundry není ve stejné oblasti jako Azure AI Vyhledávač, použijte připojení bez nutnosti zadání klíče pro připojení prostředku.
Chyba při používání sdíleného privátního propojení
Pokud se zobrazí kód chyby 403 s následující zprávou, může se indexer připojit přes veřejný koncový bod místo schváleného sdíleného privátního propojení:
Unexpected error validating provided resource. {"error":{"code":"403","message":"Public access is disabled. Please configure private endpoint."}}
K této chybě může dojít v případě, že indexer není nakonfigurovaný tak, aby používal prostředí privátního spouštění. Ověřte, že je sdílené privátní propojení schválené, nastavte indexer executionEnvironment na privatea ověřte, že připojení používá správný koncový bod prostředku a ID skupiny.
Pravidla brány firewall
Azure Storage, Azure Cosmos DB, a Azure SQL poskytují konfigurovatelný firewall. Pokud brána firewall zablokuje požadavek, neexistuje žádná konkrétní chybová zpráva. Chyby u firewallu jsou obvykle obecné. Mezi běžné chyby patří:
The remote server returned an error: (403) ForbiddenThis request is not authorized to perform this operationCredentials provided in the connection string are invalid or have expired
Pokud chcete indexerům povolit přístup k těmto prostředkům, použijte jednu z následujících možností:
Nakonfigurujte příchozí pravidlo pro IP adresu vaší vyhledávací služby a rozsah IP adres
AzureCognitiveSearchznačky služby. Podrobnosti o konfiguraci omezení rozsahu IP adres pro každý typ zdroje dat najdete na následujících odkazech:Jako poslední možnost nebo dočasné opatření zakažte bránu firewall povolením přístupu ze Všech Sítí.
Omezení: Omezení rozsahu IP adres fungují jenom v případě, že vaše vyhledávací služba a váš účet úložiště jsou v různých oblastech.
Kromě načítání dat indexery také odesílají žádosti skrze sady dovedností a vlastní dovednosti. Pro vlastní dovednosti založené na funkci Azure mějte na paměti, že Azure Functions mají také omezení IP adres. Seznam IP adres, které mají být povoleny pro spuštění vlastních dovedností, zahrnuje IP adresu vaší vyhledávací služby a rozsah IP adres služby zastoupené značkou AzureCognitiveSearch.
Pravidla skupin zabezpečení sítě (NSG)
Když indexer přistupuje k datům ve spravované instanci SQL nebo když se virtuální počítač Azure používá jako identifikátor URI webové služby pro vlastní dovednosti, skupina zabezpečení sítě určuje, jestli jsou požadavky povolené.
U externích prostředků umístěných ve virtuální síti nakonfigurujte příchozí pravidla NSG pro AzureCognitiveSearch značku služby.
Další informace o připojení k virtuálnímu počítači najdete v tématu Konfigurace připojení k SQL Serveru na virtuálním počítači Azure.
Chyby sítě
Obvykle jsou chyby sítě obecné. Mezi běžné chyby patří:
A network-related or instance-specific error occurred while establishing a connection to the serverThe server was not found or was not accessibleVerify that the instance name is correct and that the source is configured to allow remote connections
Když se zobrazí některé z těchto chyb:
- Ujistěte se, že máte přístup ke zdroji tak, že se k němu pokusíte připojit přímo, a ne prostřednictvím vyhledávací služby.
- Zkontrolujte v portálu Azure, jestli se u vašeho prostředku nevyskytují nějaké aktuální chyby nebo výpadky.
- Zkontrolujte případné výpadky sítě ve stavu Azure.
- Ověřte, že používáte veřejný DNS pro překlad názvů, a ne Azure Privátní DNS.
Bezserverové indexování azure SQL Database (kód chyby 40613)
Pokud je vaše databáze SQL na bezserverové výpočetní úrovni, ujistěte se, že je databáze spuštěná (a není pozastavená), když se k ní indexer připojí.
Pokud je databáze pozastavená, první přihlášení z vyhledávací služby automaticky obnoví databázi, ale místo toho vrátí chybu s informací, že databáze není k dispozici a zobrazí kód chyby 40613. Po spuštění databáze zkuste znovu přihlásit a navázat připojení.
Zásady podmíněného přístupu Microsoft Entra
Když vytvoříte indexer SharePoint, musíte se po zadání kódu zařízení přihlásit ke své Microsoft Entra aplikaci. Pokud obdržíte zprávu s textem "Your sign-in was successful but your admin requires the device requesting access to be managed", přístup indexeru ke knihovně dokumentů SharePointu pravděpodobně blokuje zásada podmíněného přístupu.
Aktualizace zásad a povolení přístupu indexeru ke knihovně dokumentů:
Otevřete web Azure Portal a vyhledejte podmíněný přístup Microsoft Entra.
V nabídce vlevo vyberte Zásady . Pokud nemáte přístup k zobrazení této stránky, musíte najít někoho, kdo má přístup, nebo získat přístup.
Určete, které zásady blokují indexer SharePointu v přístupu ke knihovně dokumentů. Zásady, které mohou blokovat indexer, zahrnují uživatelský účet, který jste použili k ověření během kroku vytvoření indexeru v části Uživatelé a skupiny . Zásady také můžou mít podmínky, které:
- Omezení platforem Windows
- Omezit mobilní aplikace a desktopové klienty
- Nastavte stav zařízení na Ano.
Jakmile potvrdíte, které zásady blokují indexátor, vytvořte pro něj výjimku. Začněte načtením IP adresy vyhledávací služby.
Nejprve získejte plně kvalifikovaný název domény (FQDN) vaší vyhledávací služby. Plně kvalifikovaný název domény vypadá takto
<your-search-service-name>.search.windows.net. Plně kvalifikovaný název domény najdete v Azure portálu.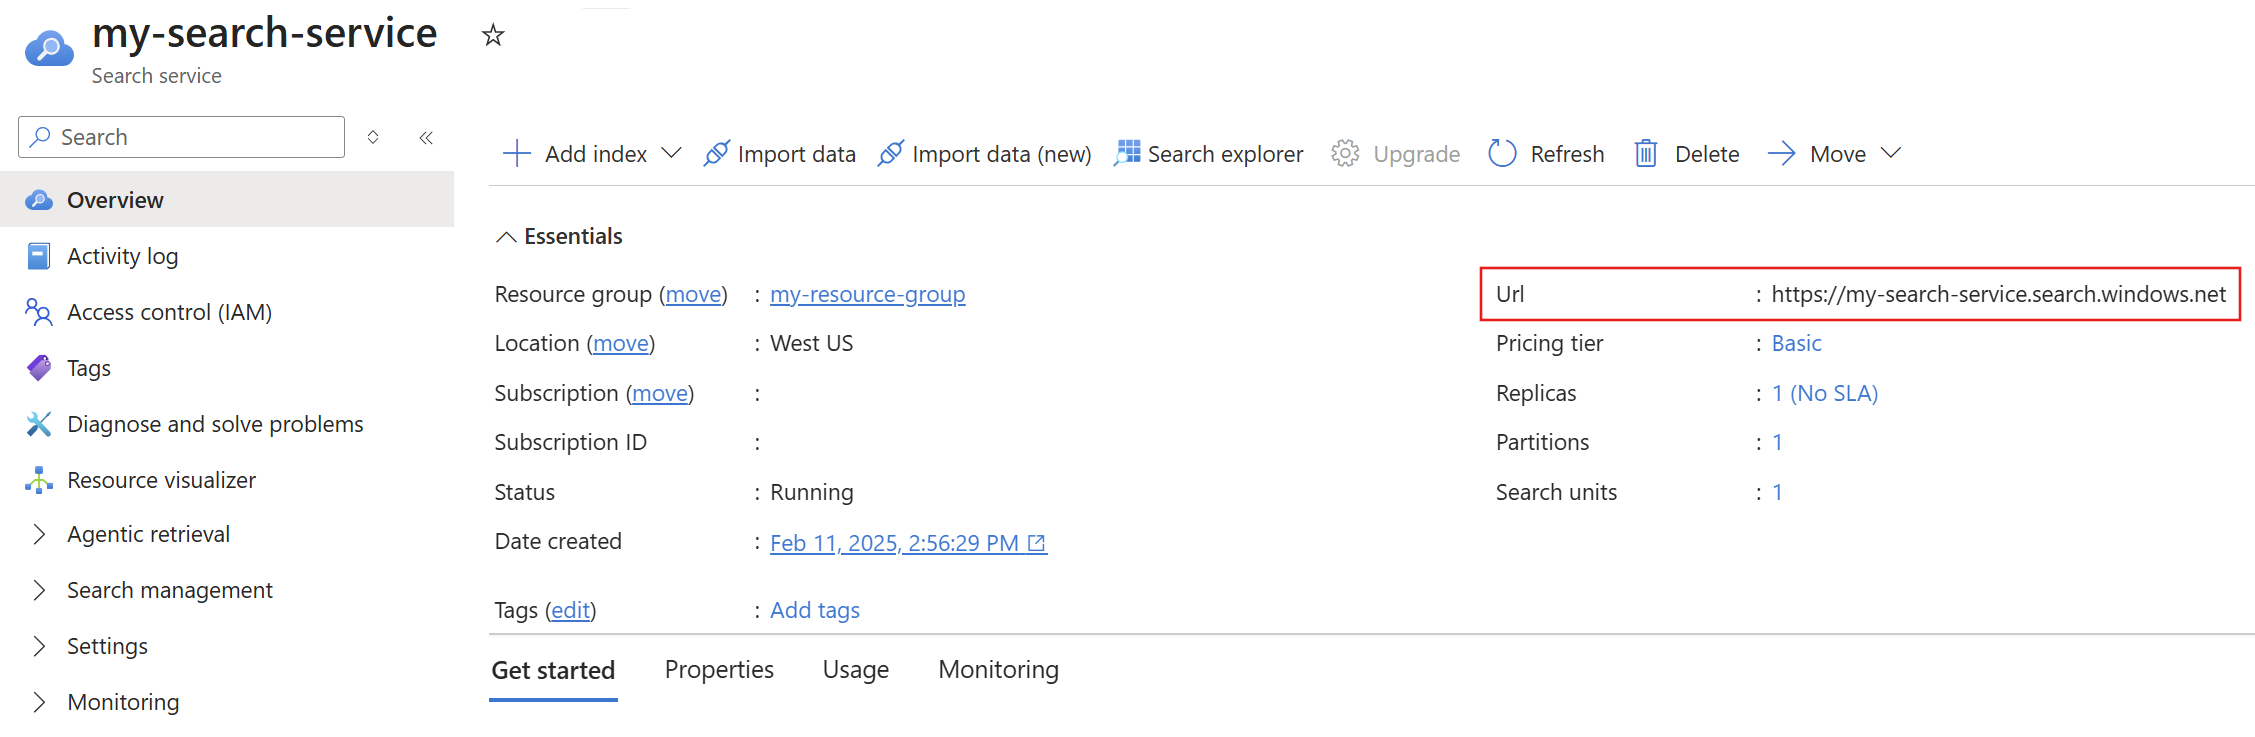
Teď, když máte plně kvalifikovaný název domény (FQDN), získejte IP adresu vyhledávací služby provedením příkazu
nslookup(neboping) pro plně kvalifikovaný název domény. V následujícím příkladu přidáte150.0.0.1do příchozího pravidla v bráně firewall Azure Storage. Po aktualizaci nastavení brány firewall pro indexer vyhledávací služby může přístup k účtu Azure Storage trvat až 15 minut.nslookup contoso.search.windows.net Server: server.example.org Address: 10.50.10.50 Non-authoritative answer: Name: <name> Address: 150.0.0.1 Aliases: contoso.search.windows.netZískejte rozsahy IP adres pro spouštěcí prostředí indexeru pro vaši oblast.
Další IP adresy se používají pro požadavky, které pocházejí z multitenantního spouštěcího prostředí indexeru. Tento rozsah IP adres můžete získat ze značky služby.
Rozsahy IP adres pro
AzureCognitiveSearchznačku služby můžete získat prostřednictvím rozhraní API pro zjišťování nebo souboru JSON ke stažení.V tomto cvičení, za předpokladu, že je službou vyhledávání Azure Public cloud, stáhněte si soubor Azure Public JSON.
V souboru JSON se za předpokladu, že vyhledávací služba je v oblasti USA – středozápad, zobrazí se seznam IP adres pro spouštěcí prostředí indexeru s více tenanty.
    {
      "name": "AzureCognitiveSearch.WestCentralUS",
      "id": "AzureCognitiveSearch.WestCentralUS",
      "properties": {
        "changeNumber": 1,
        "region": "westcentralus",
        "platform": "Azure",
        "systemService": "AzureCognitiveSearch",
        "addressPrefixes": [
          "52.150.139.0/26",
          "52.253.133.74/32"
        ]
      }
    }
Zpět na stránce Podmíněný přístup v Azure portálu vyberte v nabídce na levé straně Pojmenovaná umístění a poté vyberte Přidat umístění rozsahu IP. Pojmenujte nové pojmenované umístění a přidejte rozsahy IP adres pro prostředí pro spouštění vyhledávací služby a indexeru, které jste shromáždili v posledních dvou krocích. 1
- Pro IP adresu vyhledávací služby možná budete muset na konec IP adresy přidat /32, protože přijímá jenom platné rozsahy IP adres.
- Mějte na paměti, že pro rozsahy IP adres prostředí spouštění indexeru stačí přidat pouze rozsahy IP adres pro oblast, ve které je vaše vyhledávací služba.
Vylučte nové pojmenované umístění ze zásad:
- V nabídce vlevo vyberte Zásady .
- Vyberte zásadu, která blokuje indexer.
- Vyberte podmínky.
- Vyberte umístění.
- Vyberte Vyloučit, a přidejte nové pojmenované umístění.
- Uložte změny.
Počkejte několik minut, než se zásada aktualizuje a vynutí nová pravidla zásad.
Zkuste znovu vytvořit indexer:
- Odešlete žádost o aktualizaci objektu zdroje dat, který jste vytvořili.
- Znovu odešlete požadavek na vytvoření indexeru. Pomocí nového kódu se přihlaste a odešlete další požadavek na vytvoření indexeru.
Indexování nepodporovaných typů dokumentů
Pokud indexujete obsah z Azure Blob Storage a kontejner obsahuje objekty blob nepodporovaného typu obsahu, indexer tento dokument přeskočí. V jiných případech můžou nastat problémy s jednotlivými dokumenty.
V této situaci můžete nastavit možnosti konfigurace, které umožní zpracování indexeru pokračovat, pokud dojde k problémům s jednotlivými dokumenty.
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "failOnUnsupportedContentType" : false, "failOnUnprocessableDocument" : false } }
}
Chybějící dokumenty
Indexery extrahují dokumenty nebo řádky z externího zdroje dat a vytvářejí vyhledávací dokumenty, které vyhledávací služba indexuje. Někdy se dokument, který existuje ve zdroji dat, nezobrazí v indexu vyhledávání. K tomuto neočekávanému výsledku může dojít z následujících důvodů:
- Dokument jste aktualizovali po spuštění indexeru. Pokud je indexer na rozvrhu, automaticky se znovu spustí a zachytí dokument.
- Časový limit indexeru vypršel, než se dokument mohl ingestovat. Existují maximální časové limity zpracování, po kterých se nezpracovávají žádné dokumenty. Stav indexeru můžete zkontrolovat na webu Azure Portal nebo voláním get Indexer Status (REST API).
- Mapování polí nebo rozšiřování AI změnilo dokument a jeho artikulaci v indexu vyhledávání se liší od toho, co očekáváte.
- Hodnoty sledování změn jsou chybné nebo chybí požadavky. Pokud je hodnota horní meze nastavená na budoucí čas, indexer přeskočí všechny dokumenty, které mají dřívější datum. Stav sledování změn indexeru můžete určit pomocí
initialTrackingStatefinalTrackingStatepolí ve stavu indexeru. Indexy pro Azure SQL a MySQL musí mít index ve sloupci s vysokou hodnotou zdrojové tabulky, jinak dotazy používané indexerem může vypršet časový limit.
Návod
Pokud dokumenty chybí, zkontrolujte dotaz , který používáte, a ujistěte se, že dokument nevyloučíte. Pokud chcete zadat dotaz na konkrétní dokument, použijte rozhraní REST API pro vyhledávání dokumentů.
Chybějící obsah ze služby Blob Storage
Indexer objektů blob najde a extrahuje text z objektů blob v kontejneru. Mezi problémy s extrahováním textu patří:
Dokument obsahuje jenom naskenované obrázky. Objekty blob PDF, které mají netextový obsah, jako jsou naskenované obrázky (JPG), negenerují výsledky ve standardním kanálu indexování objektů blob. Pokud máte obsah obrázku s textovými prvky, můžete text najít a extrahovat pomocí analýzy OCR nebo obrázku.
Indexer objektů blob je nakonfigurovaný tak, aby indexoval pouze metadata. Pokud chcete extrahovat obsah, musíte nakonfigurovat indexer objektů blob tak, aby extrahovali obsah i metadata:
PUT https://[service name].search.windows.net/indexers/[indexer name]?api-version=2026-04-01
Content-Type: application/json
api-key: [admin key]

{
  ... other parts of indexer definition
  "parameters" : { "configuration" : { "dataToExtract" : "contentAndMetadata" } }
}
Chybějící obsah ve službě Azure Cosmos DB
Azure AI Vyhledávač má implicitní závislost na indexování služby Azure Cosmos DB. Pokud automatické indexování ve službě Azure Cosmos DB vypnete, Azure AI Vyhledávač vrátí úspěšný stav, ale nepodaří se mu indexovat obsah kontejneru. Pokyny ke kontrole nastavení a zapnutí indexování najdete v tématu Správa indexování ve službě Azure Cosmos DB.
Nesrovnalost v počtu dokumentů mezi zdrojem dat a indexem
Indexer může zobrazit jiný počet dokumentů než zdroj dat, samotný index nebo počet v kódu. Tady je několik možných důvodů, proč k tomuto chování může dojít:
- Index může zpožďovat zobrazení skutečného počtu dokumentů, zejména na webu Azure Portal.
- Indexer má zásadu pro odstraněné dokumenty. Odstraněné dokumenty se počítají indexerem, pokud jsou dokumenty indexovány před odstraněním.
- Pokud sloupec ID ve zdroji dat není jedinečný. Tato podmínka platí pro zdroje dat, které mají koncept sloupců, například Azure Cosmos DB.
- Pokud má definice zdroje dat jiný dotaz než ten, který používáte k odhadu počtu záznamů. V databázi například dotazujete počet záznamů databáze, zatímco v dotazu definice zdroje dat můžete vybrat jenom podmnožinu záznamů, které se mají indexovat.
- Počty se kontrolují v různých intervalech pro každou komponentu kanálu: zdroj dat, indexer a index.
- Zdroj dat obsahuje soubor, který je přiřazený k mnoha dokumentům. K této podmínce může dojít při indexování objektů blob a "parsingMode" je nastavena na
jsonArrayajsonLines.
Dokumenty zpracovávané několikrát
Indexery používají konzervativní strategii ukládání do vyrovnávací paměti, aby se zajistilo, že se během indexování vyzvedne každý nový a změněný dokument ve zdroji dat. V některých situacích se tyto vyrovnávací paměti můžou překrývat, což může způsobit, že indexer indexuje dokument dvakrát či vícekrát. Výsledkem je, že počet zpracovaných dokumentů je větší než skutečný počet dokumentů ve zdroji dat. Toto chování nemá vliv na data uložená v indexu, například duplikování dokumentů, ale může trvat déle, než dosáhne konečné konzistence. Tato podmínka je obzvláště rozšířená, pokud platí některá z následujících kritérií:
- Požadavky na indexer na vyžádání jsou odesílány rychle po sobě.
- Topologie zdroje dat zahrnuje více replik a oddílů, například topologii popsanou v úrovních konzistence v Azure Cosmos DB.
- Zdroj dat je databáze Azure SQL a sloupec zvolený jako "horní značka" je typu
datetime2.
Indexery nejsou určené k vícenásobnému vyvolání v rychlém sledu. Pokud potřebujete aktualizace rychle, podporovaným přístupem je nabízení aktualizací do indexu při souběžné aktualizaci zdroje dat. Pro zpracování na vyžádání rozložte požadavky do pětiminutových nebo delších intervalů a spouštějte indexer podle plánu.
Příklad zpracování duplicitního dokumentu s 30sekundovou vyrovnávací pamětí
Následující časová osa vysvětluje podmínky, za kterých se dokument zpracovává dvakrát. Zaznamenává každou akci i protiakci. Tento problém znázorňuje následující časová osa:
| Časová osa (hh:mm:ss) | Událost | Horní mezní hodnota indexeru | Komentář |
|---|---|---|---|
| 00:01:00 | Zápis doc1 do zdroje dat s konečnou konzistencí |
null |
Časové razítko dokumentu je 00:01:00. |
| 00:01:05 | Zápis doc2 do zdroje dat s konečnou konzistencí |
null |
Časové razítko dokumentu je 00:01:05. |
| 00:01:10 | Spustí se indexer. | null |
|
| 00:01:11 | Indexer se dotazuje na všechny změny před 00:01:10; replika, kterou indexer dotazuje, je si vědoma pouze doc2; je načten pouze doc2. |
null |
Indexer vyžaduje všechny změny, které nastaly před časovým razítkem, ale skutečně obdrží pouze podmnožinu. Toto chování vyžaduje období vyrovnávací paměti. |
| 00:01:12 | Indexer zpracovává doc2 poprvé |
null |
|
| 00:01:13 | Indexer končí | 00:01:10 | Horní mez se aktualizuje na počáteční časové razítko aktuálního spuštění indexeru. |
| 00:01:20 | Spustí se indexer. | 00:01:10 | |
| 00:01:21 | Indexer dotazuje na všechny změny mezi 00:00:40 a 00:01:20; replika, kterou indexer dotazuje, náhodou ví o doc1 i doc2; načítá doc1 a doc2 |
00:01:10 | Indexer požaduje všechny změny od aktuálního bodu vysoké úrovně vody minus 30sekundové vyrovnávací paměti až po počáteční časové razítko současného zpracování indexeru. |
| 00:01:22 | Indexer zpracovává doc1 poprvé |
00:01:10 | |
| 00:01:23 | Indexer zpracovává doc2 podruhé |
00:01:10 | |
| 00:01:24 | Indexer končí | 00:01:20 | Horní mez se aktualizuje na počáteční časové razítko aktuálního spuštění indexeru. |
| 00:01:32 | Spustí se indexer. | 00:01:20 | |
| 00:01:33 | Dotazy indexeru pro všechny změny mezi 00:00:50 a 00:01:32; načítá doc1 a doc2 |
00:01:20 | Indexer požaduje všechny změny od aktuálního bodu vysoké úrovně vody minus 30sekundové vyrovnávací paměti až po počáteční časové razítko současného zpracování indexeru. |
| 00:01:34 | Indexer zpracovává doc1 podruhé |
00:01:20 | |
| 00:01:35 | Indexer zpracovává doc2 potřetí |
00:01:20 | |
| 00:01:36 | Indexer končí | 00:01:32 | Horní mez se aktualizuje na počáteční časové razítko aktuálního spuštění indexeru. |
| 00:01:40 | Spustí se indexer. | 00:01:32 | |
| 00:01:41 | Indexer se dotazuje na všechny změny mezi 00:01:02 a 00:01:40; vyhledává doc2 |
00:01:32 | Indexer požaduje všechny změny od aktuálního bodu vysoké úrovně vody minus 30sekundové vyrovnávací paměti až po počáteční časové razítko současného zpracování indexeru. |
| 00:01:42 | Indexer zpracovává doc2 čtvrtý čas. |
00:01:32 | |
| 00:01:43 | Indexer končí | 00:01:40 | Všimněte si, že spuštění indexeru začalo více než 30 sekund po posledním zápisu do zdroje dat a také zpracovával doc2. Toto je očekávané chování, protože pokud jsou všechny spuštění indexeru před 00:01:35 eliminovány, stane se to první a jediné spuštění pro zpracování doc1 a doc2. |
V praxi k tomuto scénáři dochází pouze v případě, že ručně vyvoláte indexery na vyžádání během několika minut od sebe pro určité zdroje dat. Může mít za následek neshodná čísla (například indexer zpracoval celkem 345 dokumentů podle statistik provádění indexeru, ale ve zdroji dat a indexu je 340 dokumentů) nebo se může zvýšit fakturace, pokud používáte stejné dovednosti pro stejný dokument vícekrát. Upřednostňovaným doporučením je spuštění indexeru s využitím plánu.
Paralelní indexování
Když je současně spuštěno více indexerů, některé se obvykle zařadí do fronty a čekají na dostupné prostředky, než se budou moci spustit. Počet indexerů, které mohou běžet souběžně, určuje několik faktorů. Pokud indexery neodkazují na sady dovedností, počet replik a oddílů ve službě AI Search určuje, kolik indexerů může běžet souběžně.
Pokud indexer přidružíte k sadě dovedností, spustí se v interních clusterech AI Search. Složitost sady dovedností a to, jestli se ostatní sady dovedností spouští současně, určují, kolik indexerů může běžet současně. Integrované indexery spolehlivě extrahují data ze zdroje, takže při spuštění podle plánu se žádná data nezmešká. Indexační procesy pro paralelizaci a horizontální škálování však potřebují určitý čas na dokončení.
Indexování dokumentů pomocí popisků citlivosti
Pokud u dokumentů nastavíte popisky citlivosti, možná je nebudete moct indexovat. Pokud dojde k chybám, odeberte popisky před indexováním.