Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Tento článek vysvětluje algoritmus vyhodnocování relevance BM25, který se používá k výpočtu skóre hledání pro fulltextové vyhledávání. Relevance BM25 se vztahuje pouze na fulltextové vyhledávání. Dotazy na filtrování, automatické dokončování, navrhované dotazy, vyhledávání se zástupnými znaky a přibližné vyhledávací dotazy nejsou hodnoceny ani řazeny podle relevance.
Algoritmy bodování používané při fulltextové vyhledávání
Azure AI Vyhledávač poskytuje následující algoritmy bodování pro fulltextové vyhledávání:
| Algoritmus | Využití | Dosah |
|---|---|---|
BM25Similarity |
Pevný algoritmus pro všechny vyhledávací služby vytvořené po červenci 2020 Tento algoritmus můžete nakonfigurovat, ale nemůžete přepnout na starší (klasický). | Neomezený. |
ClassicSimilarity |
Výchozí nastavení starších vyhledávacích služeb, které předchází červenci 2020. Ve starších službách se můžete přihlásit k BM25 a zvolit algoritmus BM25 pro jednotlivé indexy. | 0 < 1,00 |
BM25 i Classic jsou funkce načítání podobné TF-IDF, které používají frekvenci termínů (TF) a inverzní frekvenci dokumentů (IDF) jako proměnné k výpočtu skóre relevance pro každou dvojici dotazů dokumentu, která se pak používá pro výsledky řazení. I když se koncepčně podobá klasickému modelu, BM25 je kořenem v pravděpodobnostním načítání informací, které vytváří intuitivnější shody měřené výzkumem uživatelů.
BM25 nabízí pokročilé možnosti přizpůsobení, například umožňuje, aby se uživatel mohl rozhodnout, jak se skóre relevance mění s frekvencí jeho odpovídajících termínů.
Jak funguje hodnocení BM25
Bodování relevance odkazuje na výpočet skóre hledání (@search.score), které slouží jako indikátor relevance položky v kontextu aktuálního dotazu. Rozsah není nevázaný. Čím vyšší je ale skóre, tím relevantnější položka.
Skóre vyhledávání se vypočítá na základě statistických vlastností vstupního řetězce a samotného dotazu. Azure AI Vyhledávač najde dokumenty, které odpovídají hledanému výrazu (některé nebo všechny v závislosti na modulu searchMode), a upřednostňuje dokumenty, které obsahují mnoho instancí hledaného termínu. Skóre hledání je ještě vyšší, pokud je termín v indexu dat vzácný, ale společný v dokumentu. Základem tohoto přístupu k výpočtu relevance je známa jako TF-IDF nebo frekvence termínu-inverzní frekvence dokumentu.
Skóre hledání je možné opakovat v celé sadě výsledků. Pokud má více přístupů stejné skóre hledání, pořadí stejných shodnocených položek není definováno a není stabilní. Spusťte dotaz znovu, a můžete zaznamenat změnu pozice položek, zejména pokud používáte bezplatnou službu nebo placenou službu s více replikami. Vzhledem k dvěma položkám s identickým skóre neexistuje žádná záruka, že se jedna zobrazí jako první.
Chcete-li přerušit vazby mezi opakujícími se skóre, můžete přidat klauzuli $orderby k prvnímu pořadí podle skóre a pak pořadí podle jiného seřazeného pole (například$orderby=search.score() desc,Rating desc).
K bodování se používají pouze pole označená jako searchable v indexu nebo searchFields v dotazu. Ve výsledcích hledání se vrátí pouze pole označená jako retrievablepole nebo pole zadaná v select dotazu spolu s jejich skóre hledání.
Poznámka:
A @search.score = 1 označuje nehodnocenou nebo neseřazenou sadu výsledků. Skóre je jednotné pro všechny výsledky. Nehodnocené výsledky se zobrazí, když je formulář dotazu neurčité hledání, zástupné znaky nebo dotazy regulárního výrazu, nebo prázdné hledání (search=*, někdy ve spojení s filtry, kde filtr představuje hlavní prostředek pro vrácení shody).
Následující video segment rychle předává vysvětlení obecně dostupných algoritmů řazení používaných ve službě Azure AI Vyhledávač. Můžete se podívat na celé video pro více informací na pozadí.
Skóre ve výsledcích textu
Pokaždé, když jsou výsledky seřazené, @search.score vlastnost obsahuje hodnotu použitou k seřazení výsledků.
Následující tabulka identifikuje vlastnost bodování, algoritmus a rozsah.
| Metoda vyhledávání | Parametr | Algoritmus bodování | Dosah |
|---|---|---|---|
| Fulltextové vyhledávání | @search.score |
Algoritmus BM25 používající parametry zadané v indexu. | Neomezený. |
Varianta skóre
Skóre hledání vyjadřuje obecný smysl pro relevanci a odráží sílu shody vzhledem k ostatním dokumentům ve stejné sadě výsledků. Skóre ale nejsou vždy konzistentní z jednoho dotazu na další, takže při práci s dotazy si můžete všimnout malých nesrovnalostí v tom, jak jsou hledané dokumenty seřazené. Existuje několik vysvětlení, proč k tomu může dojít.
| Příčina | Popis |
|---|---|
| Identické skóre | Pokud má více dokumentů stejné skóre, může se některý z nich objevit jako první. |
| Volatilita dat | Obsah indexu se při přidávání, úpravách nebo odstraňování dokumentů liší. Frekvence termínů se změní, protože aktualizace indexu se zpracovávají v průběhu času, což má vliv na skóre hledání odpovídajících dokumentů. |
| Více replik | U služeb používajících více replik se dotazy vydávají na každou repliku paralelně. Statistiky indexu použité k výpočtu skóre hledání se počítají na základě jednotlivých replik s výsledky sloučenými a seřazenými v odpovědi dotazu. Repliky jsou převážně zrcadlovými obrazy, ale statistiky mohou být různé v důsledku malých rozdílů ve stavu. Jedna replika může například odstranit dokumenty, které přispívají do statistiky, které byly sloučeny z jiných replik. Rozdíly ve statistikách jednotlivých replik jsou obvykle výraznější v menších indexech. Následující část obsahuje další informace o této podmínce. |
Vliv shardování na výsledky dotazů
Shard je kus indexu. Azure AI Vyhledávač rozdělí index do horizontálních oddílů, aby se proces přidávání oddílů zrychlil (přesunutím horizontálních oddílů do nových jednotek vyhledávání). Ve vyhledávací službě je správa fragmentů podrobnost implementace a nekonfigurovatelná, ale znalost fragmentace indexu pomáhá pochopit občasné anomálie v hodnocení a chování automatického doplňování.
Anomálie řazení: Skóre hledání se nejprve počítají na úrovni shardů a pak se agregují do jedné sady výsledků. V závislosti na vlastnostech obsahu shardů mohou být shody z jednoho shardu hodnoceny výše než shody v jiném. Pokud si všimnete kontraintuitivního řazení ve výsledcích hledání, je to s největší pravděpodobností způsobeno vlivem shardingu, zejména když jsou indexy malé. Těmto anomáliím řazení se můžete vyhnout tím, že se rozhodnete vypočítat skóre globálně v celém indexu, ale tím dojde k penalizaci výkonu.
Anomálie při automatickém dokončování: Dotazy na automatické dokončování, kde jsou odpovídající shody nalezeny na prvních několika znacích částečně zadaného výrazu, přijímají parametr tolerance, který umožňuje malé odchylky v pravopisu. U automatického dokončování je přibližné porovnávání omezené na termíny v rámci aktuálního fragmentu. Pokud například horizontální oddíl obsahuje "Microsoft" a zadá se částečný termín "mikro", bude vyhledávací modul v tomto horizontálním oddílu odpovídat hodnotě Microsoft, ale ne v jiných horizontálních oddílech, které obsahují zbývající části indexu.
Následující diagram znázorňuje vztah mezi replikami, partice, shardy a jednotkami vyhledávání. Ukazuje příklad, jak se jeden index rozděluje do čtyř jednotek hledání ve službě se dvěma replikami a dvěma oddíly. Každá ze čtyř vyhledávacích jednotek ukládá pouze polovinu shardů indexu. Vyhledávací jednotky v levém sloupci ukládají první polovinu horizontálních oddílů, které tvoří první oddíl, zatímco ty v pravém sloupci ukládají druhou polovinu horizontálních oddílů, které tvoří druhý oddíl. Vzhledem k tomu, že existují dvě repliky, existují dvě kopie každého shardu indexu. Jednotky vyhledávání v horním řádku ukládají jednu kopii, která tvoří první repliku, zatímco ty v dolním řádku ukládají další kopii, která tvoří druhou repliku.
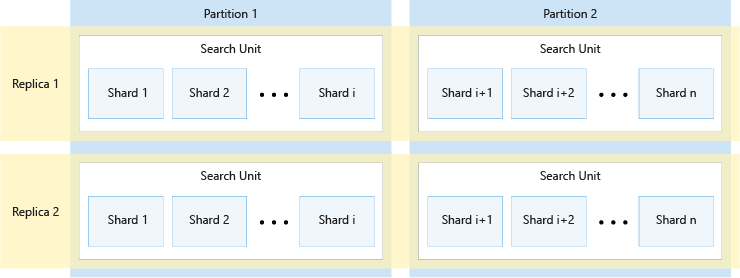
Výše uvedený diagram je pouze jedním příkladem. Je možné použít mnoho kombinací oddílů a replik, maximálně 36 celkového počtu jednotek vyhledávání.
Poznámka:
Počet replik a oddílů se rovnoměrně dělí na 12 (konkrétně 1, 2, 3, 4, 6, 12). Azure AI Vyhledávač předem rozdělí každý index na 12 shardů, aby se mohl rozdělit do stejných částí napříč všemi particemi. Pokud má například vaše služba tři partice a vytvoříte index, každá partice bude obsahovat čtyři shardy indexu. Způsob horizontálního dělení indexu ve službě Azure AI Vyhledávač představuje podrobnosti implementace, které se můžou v budoucích verzích změnit. I když je číslo dnes 12, neměli byste očekávat, že by toto číslo v budoucnu vždy bylo 12.
Statistiky vyhodnocování a rychlé relace
Kvůli škálovatelnosti azure AI Search distribuuje každý index horizontálně prostřednictvím procesu horizontálního dělení, což znamená, že části indexu jsou fyzicky oddělené.
Ve výchozím nastavení se skóre dokumentu počítá na základě statistických vlastností dat v rámci shardu. Tento přístup obecně není problémem u velkého korpusu dat a poskytuje lepší výkon než výpočet skóre na základě informací napříč všemi shardy. Použití této optimalizace výkonu může způsobit, že dva velmi podobné dokumenty (nebo dokonce stejné dokumenty) skončí s různými skóre relevance, pokud se dostanou do různých shardů.
Pokud dáváte přednost výpočtu skóre na základě statistických vlastností napříč všemi shardami, můžete tak učinit tím, že přidáte scoringStatistics=global jako parametr dotazu (nebo "scoringStatistics": "global" přidejte jako tělový parametr dotazového požadavku).
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "scoringStatistics": "global"
}
Použití scoringStatistics zajistí, aby všechny úlomky ve stejné replice poskytovaly shodné výsledky. To znamená, že různé repliky se můžou mírně lišit od sebe, protože se neustále aktualizují o nejnovější změny indexu. V některých scénářích můžete chtít, aby uživatelé získali konzistentnější výsledky během "dotazovací relace". V takových scénářích můžete zadat sessionId jako součást dotazů. Jedinečný řetězec sessionId, který vytvoříte, odkazuje na jedinečnou uživatelskou relaci.
POST https://[service name].search.windows.net/indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "<query string>",
    "sessionId": "<string>"
}
Pokud se použije stejný sessionId, provede se pokus o dosažení stejné repliky s maximálním úsilím, což zvýší konzistenci výsledků, které uvidí vaši uživatelé.
Poznámka:
Opakované použití stejných sessionId hodnot může narušit vyrovnávání zatížení požadavků napříč replikami a nepříznivě ovlivnit výkon vyhledávací služby. Hodnota použitá jako sessionId nemůže začínat znakem _.
Naladění relevance
Ve službě Azure AI Vyhledávač můžete pro vyhledávání klíčových slov a textovou část hybridního dotazu nakonfigurovat parametry algoritmu BM25 a ladit relevanci vyhledávání a zvýšit skóre hledání pomocí následujících mechanismů.
| Přístup | Implementace | Popis |
|---|---|---|
| Konfigurace algoritmu BM25 | Index vyhledávání | Nakonfigurujte, jak délka dokumentu a frekvence období ovlivňují skóre relevance. |
| Profily skórování | Index vyhledávání | Zadejte kritéria pro zvýšení skóre hledání shody na základě charakteristik obsahu. Můžete například posílit relevanci shod na základě jejich potenciálních výnosů, zvýhodnit novější položky nebo upozornit na položky, které byly v inventáři příliš dlouho. Bodovací profil je součástí definice indexu, která se skládá z vážených polí, funkcí a parametrů. Existující index můžete aktualizovat o změny hodnoticího profilu bez nutnosti opětovného sestavení indexu. |
| Sémantické řazení | Žádost o dotaz | Aplikuje strojové porozumění čtení na výsledky vyhledávání, zvýhodňuje více sémanticky relevantní výsledky na začátek. |
| featuresMode – parametr | Žádost o dotaz | Tento parametr se většinou používá k dekomprimaci skóre seřazeného podle BM25, ale lze jej použít v kódu, který poskytuje vlastní bodovací řešení. |
featuresMode – parametr (Preview)
Poznámka:
Tento featuresMode parametr není zdokumentovaný v rozhraních REST API, ale můžete ho použít ve volání rozhraní REST API v režimu Preview pro vyhledávání v dokumentech na základě textu (klíčové slovo), které je seřazené podle BM25.
Žádosti o vyhledávání dokumentů (náhled) podporují featuresMode parametr, který poskytuje podrobnější informace o skóre relevance BM25 na úrovni jednotlivých polí. Zatímco se @searchScore vypočítává pro celý dokument (jak je tento dokument relevantní v kontextu tohoto dotazu), funkceMode odhalí informace o jednotlivých polích, jak je vyjádřeno ve @search.features struktuře. Struktura obsahuje všechna pole použitá v dotazu (buď konkrétní pole prostřednictvím vyhledávacích polí v dotazu, nebo všechna pole, která jsou přiřazená jako prohledávatelná v indexu).
Platné hodnoty pro featuresMode:
- „žádné“ (výchozí) Nevrací se žádné podrobnosti bodování na úrovni funkce.
- "povoleno" Vrátí podrobné bodovací rozpisy pro každé pole.
Pro každé pole @search.features zadejte následující hodnoty:
- Počet jedinečných tokenů nalezených v poli
- Skóre podobnosti nebo míra toho, jak je obsah pole podobný, vzhledem k termínu dotazu
- Frekvence termínů nebo počet nalezených termínů v poli
Tento parametr je užitečný hlavně v případě, že se snažíte pochopit, proč se určité dokumenty ve výsledcích hledání řadí na vyšší nebo nižší. Pomáhá vysvětlit, jak různá pole přispívají k celkovému skóre.
V případě dotazu, který cílí na pole popis, může požadavek vypadat takto:
POST {{baseUrl}}/indexes/hotels-sample/docs/search?api-version=2026-08-01-preview  HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{accessToken}}

    {
        "search": "lake view",
        "select": "HotelId, HotelName, Tags, Description",
        "featuresMode": "enabled",
        "searchFields": "Description, Tags",
        "count": true
    }
Odpověď, která zahrnuje @search.features , může vypadat jako v následujícím příkladu.
  "value": [
    {
      "@search.score": 3.0860271,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 2.0,
          "similarityScore": 3.0860272,
          "termFrequency": 2.0
        }
      },
      "HotelName": "Downtown Mix Hotel",
      "Description": "Mix and mingle in the heart of the city. Shop and dine, mix and mingle in the heart of downtown, where fab lake views unite with a cheeky design.",
      "Tags": [
        "air conditioning",
        "laundry service",
        "free wifi"
      ]
    },
    {
      "@search.score": 2.7294855,
      "@search.features": {
        "Description": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.6023184,
          "termFrequency": 1.0
        },
        "Tags": {
          "uniqueTokenMatches": 1.0,
          "similarityScore": 1.1271671,
          "termFrequency": 1.0
        }
      },
      "HotelName": "Ocean Water Resort & Spa",
      "Description": "New Luxury Hotel for the vacation of a lifetime. Bay views from every room, location near the pier, rooftop pool, waterfront dining & more.",
      "Tags": [
        "view",
        "pool",
        "restaurant"
      ]
    }
  ]
Tyto datové body můžete využívat ve vlastních řešeních bodování nebo pomocí informací ladit problémy s relevantností vyhledávání.
Počet seřazených výsledků v odpovědi na fulltextový dotaz
Pokud ve výchozím nastavení nepoužíváte stránkování, vrátí vyhledávací web prvních 50 nejlepších shod pro fulltextové vyhledávání. Pomocí parametru top můžete vrátit menší nebo větší počet položek (až 1 000 v jedné odpovědi). Můžete použít skip a next pro stránkování výsledků. Stránkování určuje počet výsledků na každé logické stránce a podporuje navigaci v obsahu. Pro více informací se podívejte na Výsledky vyhledávání obrazců.
Pokud je fulltextový dotaz součástí hybridního dotazu, můžete nastavit maxTextRecallSize zvýšení nebo snížení počtu výsledků z textové strany dotazu.
Fulltextové vyhledávání podléhá maximálnímu limitu 1 000 shod (viz limity odpovědí rozhraní API). Jakmile se najde 1 000 shod, vyhledávací web už nebude hledat víc.