Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Poznámka:
Azure AI Vyhledávač je k dispozici prostřednictvím portálu Azure, rozhraní REST API a Sady Azure SDK. Podporuje také Foundry IQ, spravovanou znalostní vrstvu, která transformuje podnikový obsah na opakovaně použitelné znalostní báze s podporou oprávnění pro agenty na portálu Microsoft Foundry.
Fulltextové vyhledávání je přístup při načítání informací, který odpovídá prostému textu uloženému v indexu. Například vzhledem k řetězci dotazu "hotely v San Diegu na pláži", vyhledávač vyhledá tokenizované řetězce na základě těchto termínů. Aby bylo skenování efektivnější, řetězce dotazů procházejí lexikální analýzou: všechna slova se převedou na malá písmena, odstraňují se zastavovací slova, např. 'the', a redukují se na jejich kořenové formy. Při hledání shodných termínů vyhledávací web načte dokumenty, řadí je v pořadí podle relevance a vrací nejlepší výsledky.
Provádění dotazů může být složité. Tento článek je určený pro vývojáře, kteří potřebují hlubší porozumění fungování fulltextového vyhledávání ve službě Azure AI Vyhledávač. U textových dotazů služba Azure AI Vyhledávač bezproblémově poskytuje očekávané výsledky ve většině scénářů, ale občas se může zobrazit výsledek, který se zdá být nějak vypnutý. V těchto situacích může pomoci mít znalosti o čtyřech fázích provádění dotazů v Lucene (parsování dotazů, lexikální analýza, porovnávání dokumentů a hodnocení), abyste mohli identifikovat konkrétní změny parametrů dotazu nebo konfigurace indexu, které vedou k požadovanému výsledku.
Poznámka:
Azure AI Vyhledávač používá Apache Lucene k fulltextovém vyhledávání, ale integrace Lucene není vyčerpávající. Selektivně zveřejňujeme a rozšiřujeme funkce Lucene, abychom umožnili scénáře důležité pro Azure AI Vyhledávač.
Přehled architektury a diagram
Provádění dotazů má čtyři fáze:
- Analýza dotazů
- Lexikální analýza
- Načtení dokumentu
- Vyhodnocování
Fulltextový vyhledávací dotaz začíná parsováním textu dotazu za účelem extrakce hledaných termínů a operátorů. Existují dva analyzátory, abyste si mohli vybrat mezi rychlostí a složitostí. Dále je fáze analýzy, ve které jsou jednotlivé termíny dotazů někdy rozděleny a rekonstituovány do nových forem. Tento krok pomáhá rozšířit možnosti toho, co lze považovat za potenciální shodu. Vyhledávač pak prohledá index a vyhledá dokumenty s odpovídajícími termíny a ohodnotí každou shodu. Sada výsledků se pak seřadí podle skóre relevance přiřazeného jednotlivým odpovídajícím dokumentům. Ty v horní části seřazeného seznamu se vrátí do volající aplikace.
Následující diagram znázorňuje komponenty používané ke zpracování žádosti o vyhledávání:
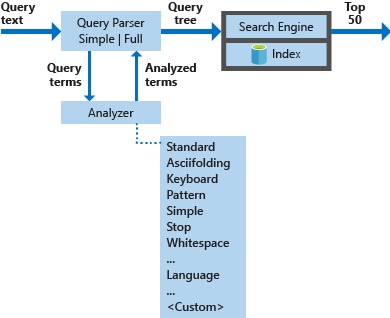
| Klíčové komponenty | Funkční popis |
|---|---|
| Analyzátory dotazů | Oddělte termíny dotazu od operátorů dotazu a vytvořte strukturu dotazu (strom dotazu), která se má odeslat do vyhledávacího webu. |
| Analyzátory | Proveďte lexikální analýzu termínů dotazů. Tento proces může zahrnovat transformaci, odebrání nebo rozšíření termínů dotazu. |
| Index | Efektivní datová struktura používaná k ukládání a uspořádání hledaných termínů extrahovaných z indexovaných dokumentů. |
| Vyhledávač | Načte a vyhodnotuje odpovídající dokumenty na základě obsahu invertovaného indexu. |
Anatomie požadavku hledání
Požadavek hledání je úplná specifikace toho, co by se mělo vrátit v sadě výsledků. V nejjednodušší podobě je to prázdný dotaz bez kritérií jakéhokoli druhu. Realističtější příklad zahrnuje parametry, několik termínů dotazu, které jsou možná vymezeny na určitá pole, s možná výrazem filtru a pravidly řazení.
Následující příklad je žádost o vyhledávání, kterou můžete odeslat do služby Azure AI Vyhledávač pomocí rozhraní REST API:
POST /indexes/hotels/docs/search?api-version=2026-04-01
{
    "search": "Spacious, air-condition* +\"Ocean view\"",
    "searchFields": "description, title",
    "searchMode": "any",
    "filter": "price ge 60 and price lt 300",
    "orderby": "geo.distance(location, geography'POINT(-159.476235 22.227659)')",
    "queryType": "full"
}
Pro tento požadavek vyhledávací web provede následující operace:
Najde dokumenty, ve kterých je cena alespoň 60 Kč a menší než 300 Kč.
Spustí dotaz. V tomto příkladu se vyhledávací dotaz skládá z frází a termínů:
"Spacious, air-condition* +\"Ocean view\""(Uživatelé obvykle nezadávají interpunkci, ale zahrnutím do něj v tomto příkladu můžeme vysvětlit, jak ho analyzátory zpracovávají.)Pro tento dotaz prohledá vyhledávací web pole popisu a názvu zadané v "searchFields" pro dokumenty, které obsahují
"Ocean view", a dále termín"spacious", nebo termíny, které začínají předponou"air-condition". Parametr "searchMode" se používá pro shodu s libovolným termínem (výchozí) nebo se všemi, pokud termín není explicitně vyžadován (+).Objedná výslednou sadu hotelů podle blízkosti daného zeměpisného umístění a poté vrátí výsledky volající aplikaci.
Většina tohoto článku se zabývá zpracováním vyhledávacího dotazu: "Spacious, air-condition* +\"Ocean view\"". Filtrování a řazení je mimo rozsah. Další informace najdete v referenční dokumentaci k rozhraní API služby Search.
Fáze 1: Analýza dotazů
Jak je uvedeno, řetězec dotazu je prvním řádkem požadavku:
"search": "Spacious, air-condition* +\"Ocean view\"",
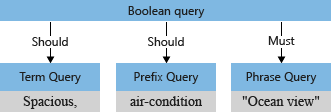
Analyzátor dotazů odděluje operátory (například * a + v příkladu) od hledaných termínů a dekonstruuje vyhledávací dotaz do poddotazů podporovaného typu:
- dotaz na výrazy pro samostatné výrazy (například prostorné)
- dotaz na frázi pro citované termíny (například výhled na oceán)
- předponový dotaz pro termíny s operátorem předpony následovaným (jako například klimatizace)
Úplný seznam podporovaných typů dotazů najdete v tématu Syntaxe dotazů Lucene.
Operátory přidružené k poddotazům určují, jestli má být dotaz "musí" nebo "být" splněn, aby byl dokument považován za shodu. Například +"Ocean view" je "povinný" z důvodu operátoru +.
Analyzátor dotazů restrukturalizuje poddotazy do stromu dotazu (interní struktura představující dotaz), kterou předá vyhledávacímu webu. V první fázi analýzy dotazu vypadá strom dotazu takto:
Podporované analyzátory: Simple a Full Lucene
Azure AI Vyhledávač zveřejňuje dva různé dotazovací jazyky: simple (výchozí) a full. Nastavením parametru queryType pomocí požadavku vyhledávání sdělíte analyzátoru dotazů, který dotazovací jazyk zvolíte, aby věděl, jak interpretovat operátory a syntaxi.
Jednoduchý dotazovací jazyk je intuitivní a robustní, často vhodný pro interpretaci uživatelského vstupu as-is bez zpracování na straně klienta. Podporuje operátory dotazů známé z webových vyhledávačů.
Úplný dotazovací jazyk Lucene, který získáte nastavením
queryType=full, rozšiřuje výchozí jednoduchý dotazovací jazyk přidáním podpory pro další operátory a typy dotazů, jako jsou zástupné znaky, fuzzy, regex a dotazy zaměřené na pole. Například regulární výraz odeslaný v syntaxi jednoduchého dotazu by se interpretoval jako řetězec dotazu, nikoli jako výraz. Příklad požadavku v tomto článku používá úplný dotazovací jazyk Lucene.
Dopad searchMode na analyzátor
Dalším parametrem požadavku vyhledávání, který ovlivňuje parsování, je parametr searchMode. Řídí výchozí operátor pro logické dotazy: libovolný (výchozí) nebo všechny z nich.
Když "searchMode=any", což je výchozí, oddělovač mezery mezi prostorným a klimatizací je OR (||), takže ukázkový text dotazu odpovídá:
Spacious,||air-condition*+"Ocean view"
Explicitní operátory, například + v +"Ocean view", jsou jednoznačné v logické konstrukci dotazu (termín se musí shodovat). Méně zřejmé je, jak interpretovat zbývající termíny: prostorné a klimatizované. Měl by vyhledávač najít shody na výhled na oceán a prostorný a klimatizace? Nebo by měl najít výhled na oceán a jeden z zbývajících podmínek?
Ve výchozím nastavení ("searchMode=any") vyhledávací modul předpokládá širší interpretaci. Pole by se mělo shodovat sémantikou "nebo". Počáteční strom dotazu, který je znázorněn dříve, se dvěma operacemi "should" zobrazuje výchozí nastavení.
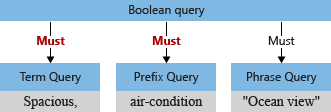
Předpokládejme, že teď nastavíme "searchMode=all". V tomto případě se prostor interpretuje jako operace "and". Oba zbývající termíny musí být v dokumentu, aby mohly být považovány za shodu. Výsledný ukázkový dotaz by se interpretoval takto:
+Spacious,+air-condition*+"Ocean view"
Upravený strom dotazu pro tento dotaz, kde odpovídající dokument je průsečíkem všech tří poddotazů, by vypadal takto:
Poznámka:
Volba mezi "searchMode=any" a "searchMode=all" je nejlépe provedena spuštěním reprezentativních dotazů. Uživatelé, kteří budou pravděpodobně zahrnovat operátory (běžné při prohledávání úložišť dokumentů), můžou najít výsledky intuitivnější, pokud "searchMode=all" informuje logické konstrukty dotazů. Další informace o interakci mezi "searchMode" a operátory viz Jednoduchá syntaxe dotazu.
Fáze 2: Lexikální analýza
Lexikální analyzátory zpracovávají dotazy termínů a frází po strukturování stromu dotazů. Analyzátor přijme textové vstupy zadané analyzátorem, zpracuje text a pak odešle zpět tokenizované termíny, které se mají začlenit do stromu dotazu.
Nejběžnější formou lexikální analýzy je lingvistická analýza, která transformuje termíny dotazů na základě pravidel specifických pro daný jazyk. To zahrnuje:
- Zmenšení termínu dotazu na kořenovou formu slova
- Odebírání nepodstatných slov (stopwords, například "the" nebo "and" v angličtině).
- Rozdělení složeného slova na části součástí
- Převod velkého slova na malá písmena.
Všechny tyto operace mají tendenci mazat rozdíly mezi textovým vstupem poskytnutým uživatelem a termíny uloženými v indexu. Tyto operace přesahují zpracování textu a vyžadují podrobné znalosti samotného jazyka. Pokud chcete přidat tuto vrstvu lingvistického povědomí, Azure AI Vyhledávač podporuje dlouhý seznam analyzátorů jazyka od Lucene i Microsoftu.
Poznámka:
V závislosti na vašem scénáři můžou požadavky na analýzu být v rozsahu od minimálního po propracované. Složitost lexikální analýzy můžete řídit výběrem některého z předdefinovaných analyzátorů nebo vytvořením vlastního analyzátoru. Analyzátory jsou vymezeny na prohledávatelná pole a jsou určeny jako součást definice pole. To umožňuje měnit lexikální analýzu na základě jednotlivých polí. Pokud není zadaný, použije se standardní analyzátor Lucene.
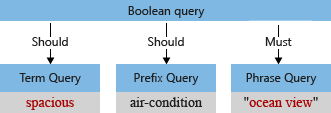
V našem příkladu má před analýzou počáteční strom dotazu termín "Prostorná" s velkými písmeny "S" a čárkou, kterou analyzátor dotazu interpretuje jako součást termínu dotazu (čárka se nepovažuje za operátor dotazovacího jazyka).
Když výchozí analyzátor zpracuje termín, převede "výhled na oceán" a "prostorný" na malá písmena a odebere znak čárky. Upravený strom dotazu vypadá takto:
Testování chování analyzátoru
Chování analyzátoru je možné testovat pomocí rozhraní API pro analýzu. Zadejte text, který chcete analyzovat, abyste zjistili, jaké termíny daný analyzátor generuje. Pokud například chcete zjistit, jak standardní analyzátor zpracuje text "klimatizace", můžete vydat následující požadavek:
{
    "text": "air-condition",
    "analyzer": "standard"
}
Standardní analyzátor rozdělí vstupní text na následující dva tokeny. Tyto tokeny jsou označeny atributy, jako jsou počáteční a koncové posuny, které se používají pro zvýraznění klíčových částí, a jejich pozice, která se využívá pro porovnání frází.
{
  "tokens": [
    {
      "token": "air",
      "startOffset": 0,
      "endOffset": 3,
      "position": 0
    },
    {
      "token": "condition",
      "startOffset": 4,
      "endOffset": 13,
      "position": 1
    }
  ]
}
Výjimky z lexikální analýzy
Lexikální analýza se vztahuje pouze na typy dotazů, které vyžadují úplné termíny, dotaz na termín nebo dotaz frází. Nevztahuje se na typy dotazů s neúplnými termíny – dotaz na předponu, dotaz s pomocnými znaky, dotaz regulárního výrazu – nebo na přibližný dotaz. Tyto typy dotazů, včetně dotazu předpony s termínem air-condition* v našem příkladu, se přidají přímo do stromu dotazu a obcházejí fázi analýzy. Jedinou transformací prováděnou na dotazové termíny tohoto typu je konverze na malá písmena.
Fáze 3: Načtení dokumentu
Načítání dokumentů odkazuje na hledání dokumentů s odpovídajícími termíny v indexu. Tato fáze je nejlépe srozumitelná v příkladu. Začněme indexem hotelů, který má následující jednoduché schéma:
{
    "name": "hotels",
    "fields": [
        { "name": "id", "type": "Edm.String", "key": true, "searchable": false },
        { "name": "title", "type": "Edm.String", "searchable": true },
        { "name": "description", "type": "Edm.String", "searchable": true }
    ]
}
Dále předpokládejme, že tento index obsahuje následující čtyři dokumenty:
{
    "value": [
        {
            "id": "1",
            "title": "Hotel Atman",
            "description": "Spacious rooms, ocean view, walking distance to the beach."
        },
        {
            "id": "2",
            "title": "Beach Resort",
            "description": "Located on the north shore of the island of Kauaʻi. Ocean view."
        },
        {
            "id": "3",
            "title": "Playa Hotel",
            "description": "Comfortable, air-conditioned rooms with ocean view."
        },
        {
            "id": "4",
            "title": "Ocean Retreat",
            "description": "Quiet and secluded"
        }
    ]
}
Jak se termíny indexují
Abyste pochopili načítání, pomůže vám to znát několik základních informací o indexování. Jednotka úložiště je invertovaný index, jeden pro každé prohledávatelné pole. V invertovaném indexu je seřazený seznam všech termínů ze všech dokumentů. Každý termín se mapuje na seznam dokumentů, ve kterých se vyskytuje, jak je patrné z následujícího příkladu.
Aby se výrazy v invertovaného indexu vytvořily, vyhledávací web provádí lexikální analýzu obsahu dokumentů podobně jako při zpracování dotazů:
- Textové vstupy se předávají analyzátoru, který je v závislosti na své konfiguraci převede na malá písmena a odstraní interpunkci a tak dále.
- Tokeny jsou výstupem lexikální analýzy.
- Termíny se přidají do indexu.
Je běžné, ale není nutné používat stejné analyzátory pro operace vyhledávání a indexování, aby termíny dotazů vypadaly podobně jako termíny uvnitř indexu.
Poznámka:
Azure AI Vyhledávač umožňuje zadat různé analyzátory pro indexování a vyhledávání prostřednictvím dalších indexAnalyzer parametrů a searchAnalyzer parametrů polí. Pokud není specifikováno jinak, sada analyzátoru nastavená s vlastností analyzer se používá jak pro indexování, tak i pro vyhledávání.
Inverzní index na příkladu dokumentů
Když se vrátíme k našemu příkladu pro pole názvu , invertovaný index vypadá takto:
| Termín | Seznam dokumentů |
|---|---|
| Atman | 1 |
| pláž | 2 |
| hotel | 1, 3 |
| oceán | 4 |
| playa | 3 |
| letovisko | 2 |
| ústup | 4 |
V poli název se zobrazí pouze hotel ve dvou dokumentech: 1 a 3.
Pro pole popisu index vypadá takto:
| Termín | Seznam dokumentů |
|---|---|
| vzduch | 3 |
| a | 4 |
| pláž | 1 |
| podmíněný | 3 |
| pohodlný | 3 |
| vzdálenost | 1 |
| ostrov | 2 |
| kauaʻi | 2 |
| umístěn | 2 |
| sever | 2 |
| oceán | 1, 2, 3 |
| z | 2 |
| on | 2 |
| tichý | 4 |
| místnosti | 1, 3 |
| odlehlý | 4 |
| břeh | 2 |
| prostorný | 1 |
| prostředek | 1, 2 |
| na | 1 |
| pohled | 1, 2, 3 |
| chůze | 1 |
| with | 3 |
Porovnávání termínů dotazů s indexovanými termíny
Vzhledem k výše uvedeným invertovaným indexům se vraťme do ukázkového dotazu a podívejme se, jak se pro náš ukázkový dotaz najdou odpovídající dokumenty. Vzpomeňte si, že konečný strom dotazu vypadá takto:
Během provádění dotazu se jednotlivé dotazy provádějí nezávisle na jednotlivých prohledávatelných polích.
TermQuery "spacious" odpovídá dokumentu 1 (Hotel Atman).
Předponový dotaz "air-condition*" se neshoduje s žádným dokumentem.
Toto chování někdy zaměňuje vývojáře. I když termín klimatizace v dokumentu existuje, je rozdělený do dvou termínů ve výchozím analyzátoru. Vzpomeňte si, že dotazy předpon, které obsahují částečné termíny, nejsou analyzovány. Pojmy s předponou "klimatizace" se proto vyhledají v invertovaném indexu a nenajdou se.
PhraseQuery, "ocean view", vyhledá termíny "oceán" a "view" a zkontroluje blízkost termínů v původním dokumentu. Dokumenty 1, 2 a 3 odpovídají tomuto dotazu v poli popisu. Všimněte si, že dokument 4 má v názvu slovo "oceán", ale nepovažujeme to za shodu, protože hledáme frázi "výhled na oceán" místo jednotlivých slov.
Poznámka:
Vyhledávací dotaz se spouští nezávisle na všech prohledávatelných polích v indexu Azure AI Vyhledávač, pokud neomešíte pole nastavená parametrem searchFields , jak je znázorněno v ukázkovém požadavku hledání. Vrátí se dokumenty, které odpovídají některému z vybraných polí.
V celém případě pro příslušný dotaz jsou dokumenty, které odpovídají 1, 2 a 3.
Fáze 4: Bodování
Každému dokumentu v sadě výsledků hledání se přiřadí skóre relevance. Funkce skóre relevance je lepší pořadí těch dokumentů, které nejlépe odpovídají na uživatelskou otázku vyjádřenou vyhledávacím dotazem. Skóre se vypočítá na základě statistických vlastností termínů, které odpovídají. Jádrem vzorce bodování je vážená frekvence termínu a inverzní frekvence dokumentu (TF/IDF). V dotazech obsahujících vzácné a běžné termíny tf/IDF podporuje výsledky obsahující vzácný termín. Například v hypotetickém indexu obsahujícím všechny články Wikipedie, z dokumentů, které odpovídaly dotazu prezidenta, jsou dokumenty odpovídající prezidenta považovány za relevantnější než dokumenty odpovídající na the.
Příklad bodování
Připomeňme si tři dokumenty, které odpovídají našemu ukázkovém dotazu:
search=Spacious, air-condition* +"Ocean view"
{
  "value": [
    {
      "@search.score": 0.25610128,
      "id": "1",
      "title": "Hotel Atman",
      "description": "Spacious rooms, ocean view, walking distance to the beach."
    },
    {
      "@search.score": 0.08951007,
      "id": "3",
      "title": "Playa Hotel",
      "description": "Comfortable, air-conditioned rooms with ocean view."
    },
    {
      "@search.score": 0.05967338,
      "id": "2",
      "title": "Ocean Resort",
      "description": "Located on a cliff on the north shore of the island of Kauai. Ocean view."
    }
  ]
}
Dokument 1 nejlépe odpovídal dotazu, protože termín prostorný i požadovaný pohled na oceán se vyskytuje v poli popisu. Následující dva dokumenty se shodují pouze s frází ocean view. Možná vás překvapilo, že se skóre relevance pro dokumenty 2 a 3 liší, i když odpovídají dotazu stejným způsobem. Je to proto, že bodovací vzorec má více součástí než jen TF/IDF. V tomto případě byl dokument 3 přiřazen o něco vyšší skóre, protože jeho popis je kratší. Přečtěte si o praktickém bodovacím vzorci Lucene, abyste pochopili, jak může délka pole a další faktory ovlivnit skóre relevance.
Některé typy dotazů (zástupné znaky, předpony a regulární výrazy) vždy přispívají k celkovému skóre dokumentu konstantním skóre. To umožňuje zahrnout do výsledků shody nalezené prostřednictvím rozšíření dotazu, aniž by to ovlivnilo pořadí.
Příklad ukazuje, proč je to důležité. Vyhledávání se zástupnými znaky, včetně vyhledávání s předponou, jsou nejednoznačná, protože vstup je částečným řetězcem s potenciálními shodami u velmi velkého počtu různorodých termínů. Představte si vstup "tour*", kde jsou nalezeny shody na "tours", "Tourettes" a "tourmaline". Vzhledem k povaze těchto výsledků neexistuje způsob, jak rozumně odvodit, které termíny jsou cennější než jiné. Z tohoto důvodu ignorujeme četnosti termínů při vyhodnocování výsledků dotazů typu zástupný znak, předpona a regulární výraz. Ve vícedílné žádosti o hledání, která obsahuje částečné a úplné termíny, jsou výsledky z částečného vstupu začleněny s konstantním skóre, aby nedocházelo k předsudkům vůči potenciálně neočekávaným shodám.
Naladění relevance
Skóre relevance ve službě Azure AI Vyhledávač můžete ladit dvěma způsoby:
Bodovací profily zvýhodňují dokumenty v seřazeném seznamu výsledků na základě sady pravidel. V našem příkladu bychom mohli uvažovat o dokumentech, které odpovídají poli názvu, relevantnější než dokumenty, které odpovídají poli popisu. Kromě toho, pokud náš index měl pole ceny pro každý hotel, mohli bychom propagovat dokumenty s nižšími cenami. Přečtěte si další informace o přidávání profilů bodování do indexu vyhledávání.
Zesílení termínu (k dispozici pouze v plné syntaxi dotazů Lucene) poskytuje operátor
^zesílení, který lze aplikovat na libovolnou část stromu dotazu. V našem příkladu byste místo vyhledávání podle předpony klimatizace * mohli vyhledat přesný termín klimatizaci nebo předponu, ale dokumenty, které se shodují s přesným termínem, jsou seřazeny výš, protože na dotaz na termín aplikujete zvýšení: klimatizace^2||klimatizace*. Přečtěte si další informace o zvýšení termínu v dotazu.
Bodování v distribuovaném indexu
Všechny indexy ve službě Azure AI Vyhledávač se automaticky rozdělí do několika horizontálních oddílů, což nám umožňuje rychle distribuovat index mezi více uzlů během vertikálního navýšení nebo snížení kapacity služby. Když je podána žádost o vyhledávání, je vydána nezávisle vůči každému shardu. Výsledky z každého fragmentu se pak sloučí a seřadí podle skóre (pokud není definováno jiné uspořádání). Je důležité vědět, že funkce bodování váží frekvenci termínů dotazu proti jejich inverzní frekvenci dokumentů ve všech dokumentech v rámci shardu, ne napříč všemi shardy!
To znamená, že může být skóre relevance u stejných dokumentů různé, pokud se nacházejí na různých shardech. Tyto rozdíly naštěstí obvykle zmizí, protože počet dokumentů v indexu roste kvůli rovnoměrnějšímu rozdělení termínů. Není možné předpokládat, na který shard se umístí jakýkoliv daný dokument. Pokud se ale klíč dokumentu nezmění, vždy se přiřadí stejnému shardu.
Obecně platí, že skóre dokumentu není nejlepším atributem pro řazení dokumentů, pokud je důležitá stabilita objednávek. Například vzhledem k dvěma dokumentům s identickým skóre není zaručeno, že se jeden v následných spuštěních stejného dotazu zobrazí jako první. Skóre dokumentu by mělo dávat obecný pocit relevance dokumentu vzhledem k ostatním dokumentům v sadě výsledků.
Závěr
Úspěch komerčních vyhledávacích webů vyvolal očekávání pro fulltextové vyhledávání nad soukromými daty. U téměř jakéhokoli druhu vyhledávání teď očekáváme, že modul pochopí náš záměr, i když jsou termíny chybně napsané nebo neúplné. Můžeme dokonce očekávat shody na základě téměř ekvivalentních termínů nebo synonym, které jsme nikdy nezadáli.
Z technického hlediska je fulltextové vyhledávání velmi složité a vyžaduje sofistikovanou jazykovou analýzu a systematický přístup ke zpracování způsoby, které výrazy dotazů destilují, rozbalují a transformují, aby poskytovaly relevantní výsledek. Vzhledem k vnitřní složitosti existuje mnoho faktorů, které můžou ovlivnit výsledek dotazu. Z tohoto důvodu investice času na pochopení mechaniky fulltextového vyhledávání nabízí hmatatelné výhody při pokusu o práci s neočekávanými výsledky.
Tento článek prozkoumal fulltextové vyhledávání v kontextu služby Azure AI Vyhledávač. Doufáme, že vám poskytne dostatečné pozadí k rozpoznání potenciálních příčin a řešení běžných problémů s dotazy.
Další kroky
Sestavte ukázkový index, vyzkoušejte různé dotazy a zkontrolujte výsledky. Pokyny najdete v tématu Sestavení a dotazování indexu na webu Azure Portal.
Vyzkoušejte jinou syntaxi dotazu z ukázkové části Prohledat dokumenty nebo jednoduchou syntaxi dotazu v Průzkumníku služby Search na webu Azure Portal.
Pokud chcete vyladit pořadí ve vyhledávací aplikaci, zkontrolujte profily hodnocení.
Nakonfigurujte vlastní analyzátory pro minimální zpracování nebo specializované zpracování v konkrétních polích.