註
Azure AI 搜尋服務 可透過 Azure 入口網站、REST API 及 Azure SDK 取得。 它同時也是 Foundry IQ 的基礎,這是一個管理式知識層,能將企業內容轉化為可重複使用、權限感知的知識庫,供 Microsoft Foundry 入口網站中的代理使用。
重要
標記(預覽)的功能、能力或屬性不受服務等級協議涵蓋,也不建議用於生產工作負載,且在正式上架前可能會有所變動或受限。 Azure AI 搜尋服務 預覽條款適用於所有預覽功能,無論是獨立功能還是正式推出功能的一部分。
在Azure AI 搜尋服務中,您可以使用 filter expression 來為 向量查詢 加入包含或排除條件。 你也可以指定一個過濾模式來套用這個篩選:
- 在查詢執行前,也就是所謂 的預過濾。
- 在查詢執行後,稱為 後過濾。
- 當識別出全球最佳結果後,它被稱為
k(預覽)。
本文使用 REST 作為說明。 如需其他語言的程式碼範例及包含向量查詢的端對端解決方案,請參見 azure-search-vector-samples GitHub 資料庫。
你也可以在Azure入口中使用 Search Explorer來查詢向量內容。 在 JSON 檢視中,你可以新增篩選條件並指定篩選模式。
向量查詢中的篩選機制
Azure AI 搜尋服務 採用階層式可導航小世界(HNSW)演算法進行近似最近鄰(ANN)搜尋,將 HNSW 圖儲存在多個分片中。 每個分片包含整個索引的一部分。
篩選器適用於 filterable非向量 欄位,無論是字串或數字欄位,用以根據篩選條件包含或排除搜尋文件。 向量欄位本身無法篩選,但你可以用同一索引中其他欄位的篩選器來縮小考慮的向量搜尋文件範圍。 如果你的索引缺少合適的文字或數字欄位,請檢查文件中繼資料是否有幫助篩選,例如 LastModified 屬性 CreatedBy 。
參數 vectorFilterMode 控制搜尋階段中篩選操作的適用位置,影響結果如何篩選成部分項目(如類別、標籤或其他屬性),並影響延遲、召回率及吞吐量。 共有三種模式:
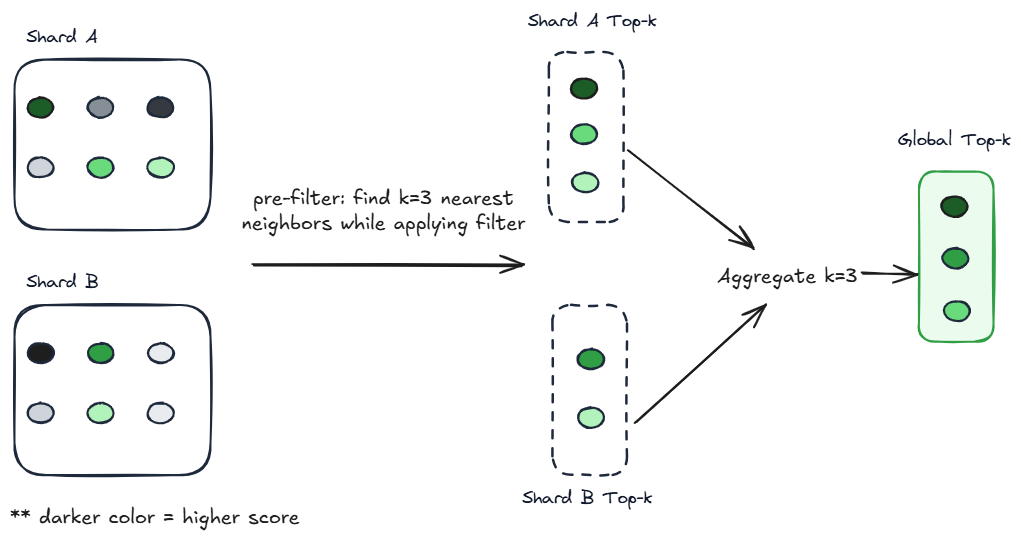
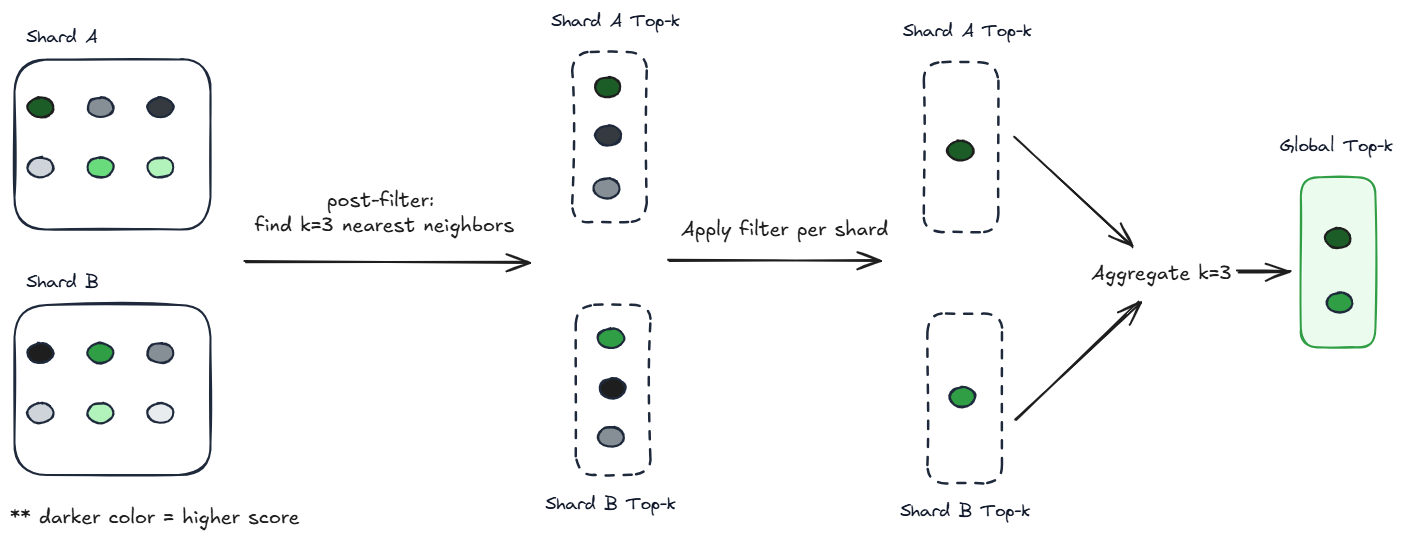
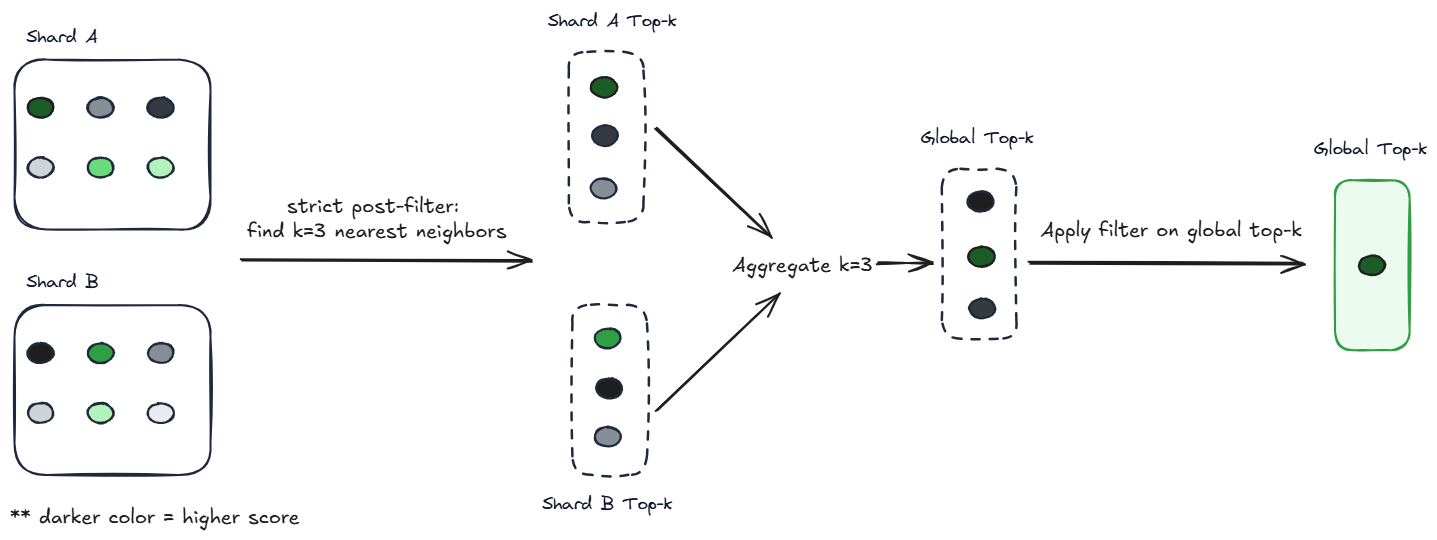
preFilter在 HNSW 遍歷時對每個分片施加過濾器。 此模式最大化召回率,但可以遍歷更多圖形的區域,從而增加 CPU 使用率並提高高度選擇性濾波器的延遲。postFilter會在每個分區上獨立執行 HNSW 周遊和篩選,在分區層級交集結果,然後將每個分區的前k個結果彙總成全域前k個結果。 此模式可能因高度選擇性濾波或小k數值而產生假陰性。strictPostFilter(預覽版) 在套用篩選器k先找到未篩選的全域前 項。 此模式在高度選擇性濾波器及小k值下,最有可能回傳假陰性。
欲了解更多這些模式資訊,請參見 設定濾波器模式。
定義一個濾波器
篩選器決定向量查詢的範圍,並透過 文件-搜尋貼文(REST API)定義。 除非你想使用預覽功能,否則請使用最新穩定版 的搜尋服務 REST API 來表達請求。
此 REST API 提供:
-
filter做為準則。 -
vectorFilterMode指定在向量查詢中何時套用濾波器。 關於支援的模式,請參見 設定濾波器模式。
POST https://{search-endpoint}/indexes/{index-name}/docs/search?api-version={api-version}
Content-Type: application/json
api-key: {admin-api-key}

{
    "count": true,
    "select": "title, content, category",
    "filter": "category eq 'Databases'",
    "vectorFilterMode": "preFilter",
    "vectorQueries": [
        {
            "kind": "vector",
            "vector": [
                -0.009154141,
                0.018708462,
                . . . // Trimmed for readability
                -0.02178128,
                -0.00086512347
            ],
            "fields": "contentVector",
            "k": 50
        }
    ]
}
在此範例中,向量嵌入針對 contentVector 該欄位,而篩選條件則適用於 category可篩選的文字欄位。 由於使用該 preFilter 模式,篩選器會在搜尋引擎執行查詢前套用,因此在向量搜尋中只考慮該 Databases 類別的文件。
設定濾波器模式
參數 vectorFilterMode 決定過濾器相對於向量查詢執行的時間和方式。 您可以使用以下模式:
-
preFilter(推薦) postFilter-
strictPostFilter(預告)
註
preFilter 是約在2023年10月15日之後建立的索引的預設值。 對於在此日期之前建立的索引, postFilter 預設為 。 要使用 preFilter 其他進階向量功能,例如向量壓縮,你必須重新建立索引。
你可以透過對"vectorFilterMode": "preFilter"2023-10-01-preview版本或更高版本的 REST API 發送向量查詢來測試相容性。 如果查詢失敗,表示你的索引不支援 preFilter。
預過濾會在查詢執行前套用篩選器,從而減少向量搜尋演算法的候選集合。 接著從篩選過的集合中選出排名最高的k 結果。
在向量查詢中, preFilter 是預設模式,因為它偏重回憶和品質而非延遲。
此模式運作方式
在每個分區上,於 HNSW 周遊期間套用篩選述詞,不斷擴展圖表,直到找到
k個候選人為止。產生每個分區預先篩選的本機前
k個結果。將篩選結果彙整成全域頂尖
k結果集。
此模式的影響
遍歷會擴展搜尋面以尋找更多篩選後的候選,尤其是當篩選具有選擇性時。 這會在所有分區中產生最相似的前 k 個結果。 每個分區都會識別滿足篩選述詞的 k 個結果。
預過濾保證 k 如果結果存在於索引中,結果會被回傳。 對於高度選擇性的濾波器,這可能導致圖中相當大的一部分被遍歷,增加計算成本與延遲,同時降低吞吐量。 如果你的過濾器選擇性很高(匹配非常少),可以考慮用exhaustive: true功能來進行窮舉搜尋。
比較表
| 模式 | 召回(篩選結果) | 計算成本 | 假陰性的風險 | 何時使用 |
|---|---|---|---|---|
preFilter |
非常高 | 更高(隨著濾波器選擇性和複雜度增加) | 沒有風險 |
所有案例的建議預設值,特別是召回很重要時 (敏感搜尋網域)、使用選擇性篩選器時,或使用小型 k 時。 |
postFilter |
中至高(隨著濾波器選擇性的變強而降低) | 類似於未經濾鏡,但隨著濾鏡的複雜度增加,效果也增加。 | 中等 (每個分區可能會配對錯誤) | 適合不那麼嚴格的篩選條件或要求更高的查詢的一個選項k。 |
strictPostFilter |
最低 (隨著篩選器選擇性增加而最快降低) | 類似於無過濾 | 最高(對於選擇性過濾或小型 k 可能傳回零結果) |
針對多面向搜尋應用程式的一種選項,其中在套用篩選器後顯示更多結果對使用者體驗的影響高於出現誤判的風險。 請勿與小型的 k 一起使用。 |
預濾波與後濾波的基準測試
重要
本節適用於預過濾與後過濾,不包括嚴格的後過濾。
為了了解在哪些條件下某一種過濾模式表現優於另一種,我們進行了一系列測試,以評估在小型、中型及大型索引上的查詢結果。
- 小型(100,000 份文件,2.5 GB 索引,1,536 維度)
- 中等(100萬份文件,25 GB 索引,1,536 維度)
- 大型(10億份文件,1.9 TB 索引,96 維度)
對於小型和中型工作負載,我們使用標準 2(S2)服務,只有一個分割區和一個副本。 對於大型工作負載,我們使用了 Standard 3(S3)服務,包含 12 個分割區和一個副本。
索引的結構相同:一個鍵欄位、一個向量欄位、一個文字欄位,以及一個數值可篩選欄位。 以下索引是根據 2023-11-01 語法定義的。
def get_index_schema(self, index_name, dimensions):
    return {
        "name": index_name,
        "fields": [
            {"name": "id", "type": "Edm.String", "key": True, "searchable": True},
            {"name": "content_vector", "type": "Collection(Edm.Single)", "dimensions": dimensions,
              "searchable": True, "retrievable": True, "filterable": False, "facetable": False, "sortable": False,
              "vectorSearchProfile": "defaulthnsw"},
            {"name": "text", "type": "Edm.String", "searchable": True, "filterable": False, "retrievable": True,
              "sortable": False, "facetable": False},
            {"name": "score", "type": "Edm.Double", "searchable": False, "filterable": True,
              "retrievable": True, "sortable": True, "facetable": True}
        ],
      "vectorSearch": {
        "algorithms": [
            {
              "name": "defaulthnsw",
              "kind": "hnsw",
              "hnswParameters": { "metric": "euclidean" }
            }
          ],
          "profiles": [
            {
              "name": "defaulthnsw",
              "algorithm": "defaulthnsw"
            }
        ]
      }
    }
在查詢中,我們對預過濾和後過濾操作都使用相同的過濾器。 我們使用簡單的濾波器,確保效能的差異是由於濾波模式,而非濾波器複雜度所致。
結果以每秒查詢次數(QPS)衡量。
重點摘要
前置篩選幾乎一律比後置篩選慢,但小型索引除外,因為其效能大致相同。
在較大的資料集中,預濾波速度慢好幾個數量級。
為什麼預設是預過濾,但幾乎總是比較慢? 預先篩選可保證如果結果存在於索引中,會傳回
k結果,當中偏差偏好重新叫用率和精確度勝過於速度。如果您需要使用後過濾,請這樣做:
重視速度而非選擇(後過濾可能回傳的結果少於
k個)。使用不要過度挑剔的篩選器。
有大小充分的索引,以至於預先篩選效能變得不可接受。
詳情
給定一個包含10萬個向量、維度為1,536的資料集:
當篩選超過 30% 的資料集時,預過濾與後過濾的效果相當。
當篩選資料集少於 0.1% 時,預過濾速度比後過濾慢約 50%。
給定一個包含100萬個向量、維度為1,536個的資料集:
當篩選超過 30% 的資料集時,預過濾速度約慢 30%。
當篩選資料集少於2%時,預過濾的速度大約是七倍之慢。
給定一個擁有 10 億個向量、且維度為 96 維的資料集:
當篩選超過 5% 的資料集時,預過濾速度約慢 50%。
當篩選資料集少於10%時,預過濾速度大約慢了七倍。
下圖展示了預濾波器相對於後濾波器的 QPS,相對 QPS 的計算為預濾波器的 QPS 除以後濾波器的 QPS。
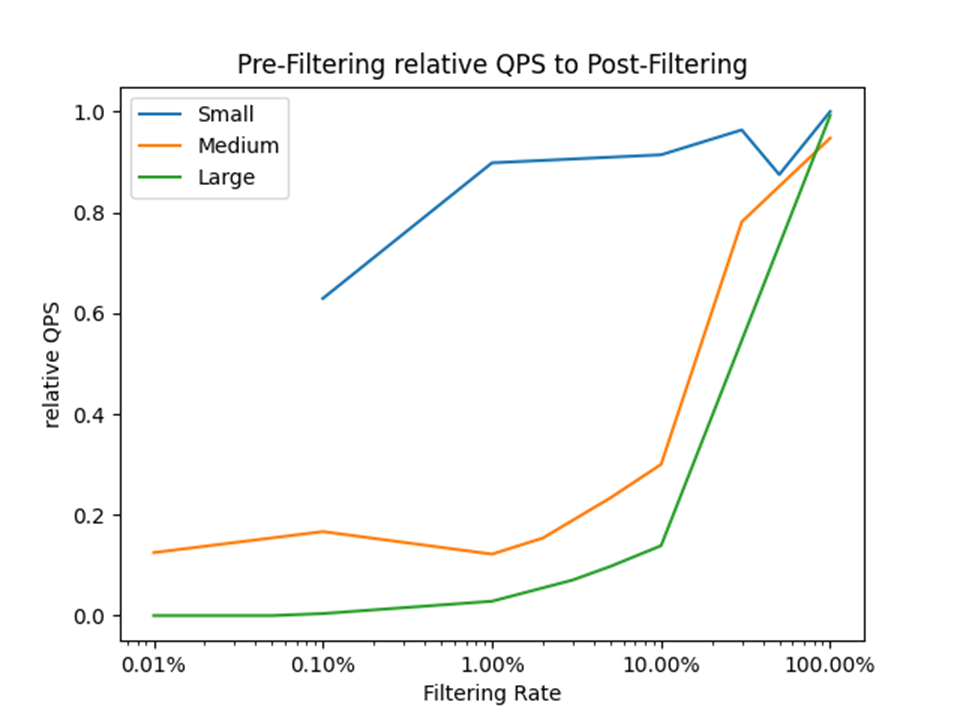
垂直軸表示預濾波相較於後濾波的相對效能,表示為 QPS(每秒查詢數)的比率。 例如:
-
0.0的值意味著預濾波比後濾波慢兩倍。 -
0.5的值表示預濾波速度減慢了50%。 -
1.0表示預濾波和後濾波是等價的。
橫軸代表篩選率,或是應用篩選後候選文件的百分比。 例如,率 1.00% 表示篩選條件選取了搜尋語料庫的百分之一。